
スリランカの研究者のためのAIペ⾲マニュアライザー(Humanizer):英語で書くために
スリランカの研究者向けのAIペ⾲マニュアライザー。シンハラ語・タミル語の影響を受けた英語における誤ったAI検出フラグを減らし、意味と引用(citation)を保ちながら、正直に開示する。

スリランカはNature Indexで98位に位置し、国内には17の国立大学、6,064人の研究者がおり、国境内にあるのはSCIEインデックス付きの学術誌がたった1誌しかありません。つまり、昇進に実際に効く論文のほぼすべてが、どこか別の場所にあるジャーナルの「英語の言語要件」をクリアしなければならないのです。スリランカの研究者向けのAIペ⾲マニュアライザーが存在する理由は、ただひとつの現実にあります、丁寧で正確な第二言語の英語が、機械文(machine writing)として誤読されるようになり、それが現実の人々の現実の掲載機会を奪ってしまうからです。
問題をシンプルに言うとこうです。スリランカの総合EF English Proficiency Indexスコアは486で、「Low Proficiency」の範囲にしっかり収まっています。国の人口の約10%が英語に流暢です。シンハラ語話者が英語の学術文書を書こうとする際の誤り率は54%です。タミル語話者も同様に不利で、当該言語に共通するパターンのせいで状況は改善しません。多くの場合、それは健全な科学です。英語のほうが投稿をつまずかせてしまうのです。
そこにAI検出器の負荷が加わります。第二言語の書き手が狙うよう訓練される、素朴で標準的・予測可能な英語で書くと、検出器が「本当に人間が書いた」段落を機械生成としてフラグを立ててしまうことがあります。本ガイドでは、その理由、シンハラ語・タミル語との関係、そして何も隠さずにAI支援下の原稿を“humanize”する方法を説明します。
ශ්රී ලාංකික පර්යේෂකයන් සඳහා AI පෙළ මානවකරණය
AI පෙළ මානවකරණය ශ්රී ලාංකික පර්යේෂකයන්ට තම පර්යේෂණ ඉංග්රීසියෙන් ප්රකාශයට පත් කිරීමට උපකාර කරයි.
In plain English: 私たちの text humanizer は、スリランカ全域の研究者が、シンハラ語・タミル語の影響を受けた注意深い学術文(academic prose)を、自然な英語へと変換するのを支援します。あなたの調査結果(findings)や用語、引用(citations)は一切変更しません。リズムや語彙の選び方を調整することで、非母語の丁寧な文章が「機械の出力」として誤って読まれにくくなります。
これは、タミル語教育(Tamil-medium)の研究者にも同じように重要です。特にジャフナ大学では、タミル語から英語の出版へと移行する必要があります。両コミュニティは同じ壁に直面しており、どちらも同じワークフローから恩恵を受けます。書く→校正する→自分自身の下書きをhumanizeする→そして開示する。
シンハラ語またはタミル語で下書きしますか? humanizer がそれを検出し処理します
すべての下書きが英語から始まるわけではなく、humanizer も英語である必要はありません。シンハラ語のテキストを貼り付けると、ProofreaderPro が文字体系を自動的に認識し、その後、言語を理解するモデルを通して、用語と引用(citations)をあなたが書いたとおりに厳密に保持します。AI පෙළ මානවකරණය は、あなたのシンハラ語の文章をそのまま書き換えるため、翻訳の後ではなく翻訳の前に humanize できます。同様の検出は60以上の言語を対象としているため、タミル語の下書きでも同じように認識され、humanize されます。
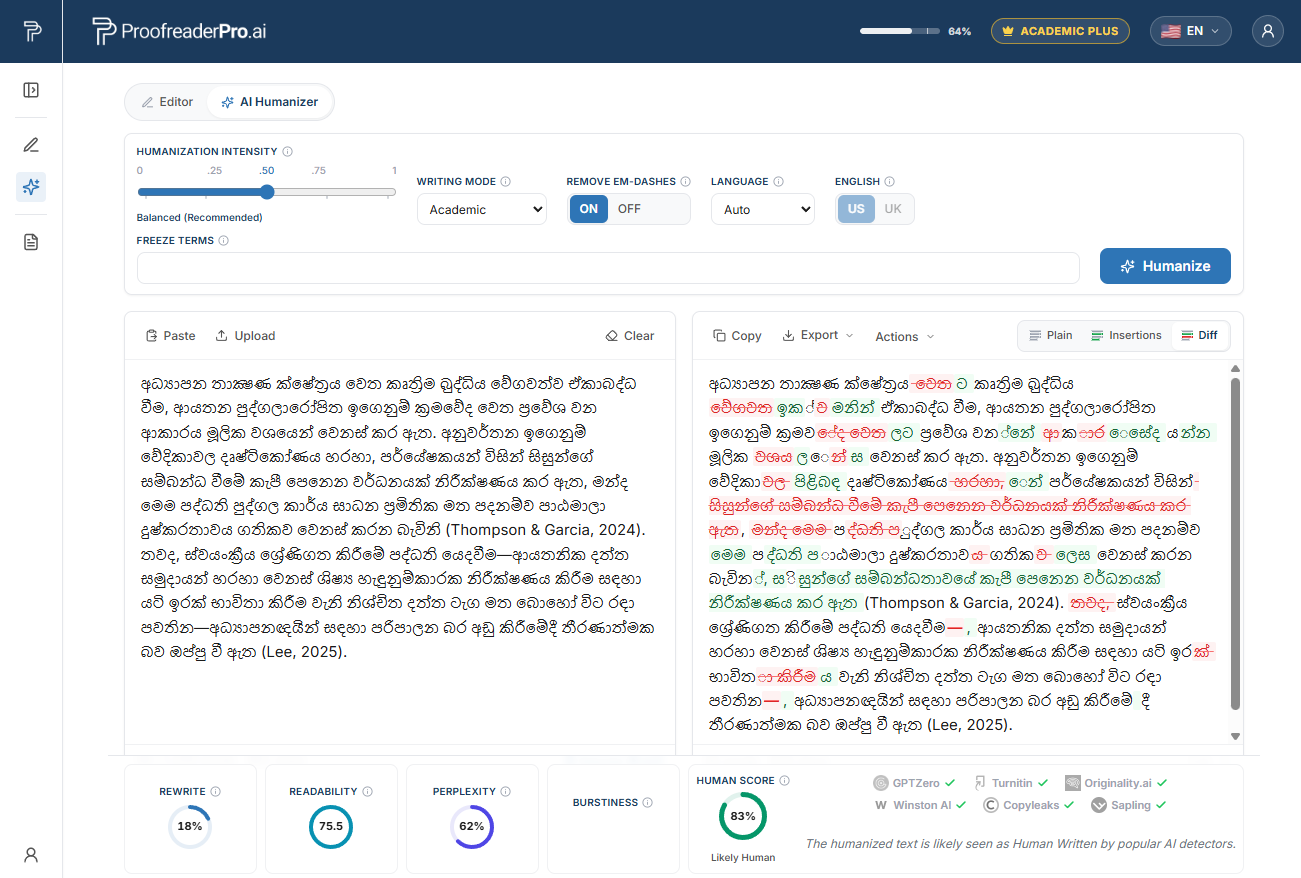
シンハラ語の学術文をリライトする ProofreaderPro AI Humanizer。before/after の差分が意味と引用(citations)を保ち、検出チェックが自然で人間らしい読み取りを確認します。
なぜスリランカの研究者はAI検出器にフラグを立てられやすいのか
2023年、Liang と共同研究者によるスタンフォードのチームが、Cell Press のジャーナル Patterns において「GPT detectors are biased against non-native English writers.」という研究を発表しました。彼らは、人間が書いたTOEFLのエッセイを、広く使われている7つのAI検出器に通しました。その結果、平均で非母語(non-native)のエッセイの約61%がAIとしてフラグされる一方、母語(native)英語の書き手では約5%でした。さらに、非母語エッセイのほぼ5分の1(約19.8%)が、すべての検出器によって一致してフラグされました。どのエッセイも人間が執筆しています。
この仕組みが不公平を説明しています。多くの検出器は「パープレキシティ(perplexity)」という指標、各単語の選び方が言語モデルにとってどれほど意外(surprising)かを測る指標、をスコアリングします。注意深い第二言語の書き手は、一般的な語彙や標準的で予測可能な言い回しを選ぶ傾向があります。するとパープレキシティが低くなり、検出器はそれを「機械文」として読んでしまうのです。スリランカの学術文が明確で正確になる要因となっている習慣そのものが、これらのツールが罰するよう学習された習慣と一致しています。
この仕組みの全体像は、なぜAI検出器が非母語の書き手をフラグするのか にて詳説しています。要点だけ言うと、あなたの文章へのフラグは、しばしば「機械が書いたかどうか」ではなく「英語力(English proficiency)」についての主張であることが多い、ということです。
偽フラグの背景にある、シンハラ語・タミル語の母語パターン
第二言語の英語を低パープレキシティに見せる特徴は、誤りではありません。正しく、慎重で、標準的な構文です。どれだけ丁寧に整えていくほど、あなたの文体はより一般的(conventional)になります。そして「一般的」とは、パープレキシティに基づく検出器が疑わしいとみなすまさにその状態です。
Article omission(冠詞の省略)。 シンハラ語にもタミル語にも、英語と同等の冠詞システムがありません。「the」「a」「an」に相当する直接の翻訳がどちらの言語にもなく、スリランカの学術執筆における冠詞関連の誤りの約51%が冠詞の省略によるものです。「Result showed that method was effective」を「The result showed that the method was effective」に直せば、完璧で、まったく標準的な文になります。その標準性が、低パープレキシティとしてスコアされるのです。
Copula and be-verb dropping(コピュラおよび be 動詞の省略)。 両言語ではコピュラが日常的に省略されます。シンハラ語の「Oya lassanai」は、「is」を伴わずに「She is beautiful」という意味になります。タミル語の「Avan periyavan」も、「is」がなく「He is big」を意味します。これが書き言葉に現れると、「The result significant at p < 0.05.」のようになります。これを「The result was significant at p < 0.05」に修正すると、教科書的に一般的な英語になり、検出器がモデルから期待する種類の文章になります。
Tense from simpler systems(より単純な体系からの時制)。 タミル語は英語の12種類の時制・相(tense-aspect)の組み合わせに対して、3つの時制で運用します。シンハラ語は(より豊かな体系を持つとはいえ)英語の perfect と progressive の形が欠けています。したがって「We collected samples since 2019」は、「We have collected samples since 2019」と修正されます。ジャーナル標準の注意深い時制運用は非常に予測可能で、予測可能な文章こそがフラグされます。
Prepositions from postpositions(前置詞の代わりに後置詞の発想)。 シンハラ語とタミル語では、マーカーが名詞の後に置かれます。シンハラ語の「mese uda」は文字どおり「table on」であり、タミル語の「mesei mel」も同様です。その結果、英語が「on the table」を求めるところで「in the table」のようになってしまいます。正しい前置詞を学び、それを一貫して適用できると、可能な限り標準的な英語の一部が生まれます、しかしそれはまた、低パープレキシティにもなります。
Pronoun and register patterns(代名詞とレジスターのパターン)。 シンハラ語は、厳密な he / she / it のシステムよりも、社会的レジスターに応じて代名詞を選びます。タミル語では性別に中立な形式のフォーマル代名詞("avar")が、性別のある形と並んで用いられます。これらを一貫した英語の代名詞へと正すと、滑らかで一般的な文になります。これは不正ではありません。検出器が機械から見分けられないのは、技能としての第二言語の文章だからです。
スリランカにおけるAI検出と Turnitin の文脈
スリランカでは、論文やジャーナル投稿はテキストの類似性のために、Turnitin または iThenticate でスクリーニングされることが一般的です。そしてこれらのツールは、類似性スコアに加えてAIの指標(AI indicators)を表面化するようになっています。UGC(大学助成委員会)の昇進基準では、キャリアはインデックス付き出版に結びついているため、1つの誤読によるフラグが、何か月も取り組んできたスリランカの研究者の原稿を止めてしまうことがあります。
ツール自体が争点になっていることを理解しておくと役に立ちます。Vanderbilt は2023年に Turnitin のAI検出器を無効化しました。非正(false positives)や非母語の書き手に対する偏りを理由に挙げています。また、Michigan State、UT Austin、Northwestern、Pittsburgh、SMU、Waterloo も同様の対応を取りました。Turnitin は1〜19%の範囲でスコアを抑制し、数字ではなくアスタリスクを表示し、またそのスコアだけでインテグリティ(integrity)の判断をすべきではないと警告しています。
結論として、実務的に大切なのはこうです。検出器のスコアは、争うことのできる主張であって、最終的な判決ではありません。ジャーナルや助成機関は、AI利用の開示を求める動きを強めています。正しい対応は、使ったツールを隠すことではなく、平易に書き、明確に開示することです。
誤検知フラグから、慎重な英語を守ります
シンハラ語の影響、またはタミル語の影響を受けた英語で書く、AI支援のご自身の原稿を人間らしく整えます。意味、用語、引用を保持し、そのうえで、ジャーナルが求める方法に従ってAI利用を開示してください。
Humanizer を無料でお試しスリランカの主要大学と、AIチェックが出る場所
スリランカの17の国立大学はすべて、UGCの昇進基準に従っており、インデックス付き出版が求められます。そしてすべてが、提出前に、類似性とAIの指標について学位論文や原稿をスクリーニングします:
- University of Colombo、Colombo。多くの指標で首位に立ち、国内でScopusインデックス付き出版物を最大量生み出す大学。
- University of Peradeniya、Peradeniya、Kandy。スリランカ最大のキャンパスで、農学・科学・工学・獣医学が強い。
- University of Moratuwa、Moratuwa。土木工学、コンピュータサイエンス、建築の分野で先導する、工学系の主要大学。
- University of Kelaniya、Kelaniya。人文科学、社会科学、科学、商学が強く、保健科学のアウトプットも拡大している。
- University of Jaffna、Jaffna。北部州で首位の大学であり、とりわけ英語での出版へ移行するタミル語教育の研究者にとって重要な存在。
- University of Sri Jayewardenepura、Nugegoda。マネジメント、応用科学、医学の分野に強い。
- University of Ruhuna、Matara。南部州で首位の大学であり、農学、水産、工学、医学に強い。
- University of Rajarata、Mihintale。農学、社会科学、テクノロジーに重点を置き、文化遺産研究や環境研究の分野の仕事も拡大している。
- Sabaragamuwa University of Sri Lanka、Belihuloya。食品科学、農学、測地情報学(geomatics)が強い。
- Wayamba University of Sri Lanka、Makandura と Kuliyapitiya。農学とテクノロジーに特化しており、食品技術やバイオテクノロジーでも注目されている。
- Uva Wellassa University、Badulla。科学とテクノロジーに重点を置き、動物科学とコンピューティングの研究が拡大している。
- Open University of Sri Lanka、Nawala。国内の遠隔教育機関であり、研究キャリアを追求する就業中の専門職にサービスを提供している。
国内の活動中の研究者はわずか6,064人しかいないため、言語支援への需要は高く、ほぼ全員が、丁寧な非母語文がフラグされることを防ぐ必要があります。
スリランカの研究者向けAIペ⾲マニュアライザーはどのように機能するか
ここがワークフローです。まずはあなたの主張を下書きします。推論の流れが最も自然に出る箇所は、任意でシンハラ語またはタミル語でも構いません。上にある文法・コピュラ・時制・前置詞のパターンが正されるよう、文法を校正します。その後、あなたのAI支援下の下書きを、私たちの text humanizer に通してください。そうすることで、注意深く標準化された文が自然な人間らしいリズムを取り戻し、誤読されにくくなります。あなたの意味、用語、引用(citations)はそのまま維持されます。
私たちは結果に関して具体的です。あなたには誇大広告ではなく正直さが必要だからです。主要な検出器で試験したところ、humanizer はAIテキストをより自然な人間の形へ書き換え、AIシグナルを下げ、難度の高い検出器に対する通過見込みを高めます。同時に、学術テキストにおける文法の正確さは高いまま保ちます。これらは保証ではなく試験に基づく結果です。検出器は数か月ごとに再学習されるため、100%検出不能、あるいはチェックを恒久的に回避できると約束できる信頼できるツールは存在しません。
そして最後に、あなたを守るためのステップが来ます。それは開示です。所属機関や投稿先ジャーナルが求める形式で、AI利用を明記してください。誤ったフラグから守るために自分の文章を humanize し、そのうえでAI支援を使ったことを開示することは、「隠すこと」とは反対です。これは実際の仕事に対する公平さです。もし最初に文法や構成も直す必要があるなら、スリランカの研究者のための学術編集 にあるガイドがその側面を扱っており、本記事は、言語を越えて同じワークフローをカバーする multilingual AI humanizer hub の中にあります。
地域の資金提供機関、学術誌、そしてAI開示への期待
スリランカの主要な資金提供者は、資金を公表された成果(published output)に結びつけています。National Science Foundation (NSF) は Competitive Research Grants を支援し、更新(renewals)は国際的に認められたジャーナルでの出版に基づいて評価します。National Research Council (NRC) は、5年間で最大Rs 50 millionの助成を提供し、出版に関する期待も比例して求められます。University Grants Commission (UGC) は、昇進のためにジャーナル論文から最低12点が必要であり、上級ポジションには傑出した論文5本を求めます。そしてSCIE、SSCI、Scopusインデックス付きジャーナルには最高点を与えます。
国内のジャーナル環境は小さいです。Journal of the National Science Foundation of Sri Lanka (JNSF) は、国境内で唯一のSCIEインデックス付きジャーナルであり、そのインデックスを14年連続で維持しています。これに加えて Ceylon Journal of Science(南アジアで最も古い科学系ジャーナルのひとつ)や、Ceylon Medical Journal(スリランカ医師会が1887年から発行)、Sri Lanka Journal of Social Sciences、Journal of the Rubber Research Institute of Sri Lanka、およびペラデニヤの Postgraduate Institute of Agriculture からの Tropical Agricultural Research などがあります。SLJOL (Sri Lanka Journals Online) は、オープンアクセスのために国のジャーナル172誌をホストしています。
重みづけが高いジャーナルのほぼすべてが英語で出版され、国内の外にあるため、多くのキャリアは国際投稿に依存します。そこでは編集者が、AI利用の開示ステートメントをますます求めるようになっています。開示は平易に書き、正確さを保ち、もし不当にフラグされた場合は、受け入れる判断ではなく回答すべき主張(claim to answer)として扱ってください。AI開示ステートメント原稿の書き方 と、誤ったAI検出フラグの異議申し立て方法 のガイドでは、両方のケースを扱っています。
よくある質問
Q: スリランカの研究者向けのAI humanizer は Turnitin を騙す方法ですか?
いいえ。適切な使い方は、自分自身のAI支援下の下書きを humanize して、丁寧なシンハラ語・タミル語の影響を受けた英語が機械文として誤読されないようにすることです。そのうえで、あなたの文章の意味と引用(citations)は、あなたが書いたとおりに正確に保たれます。そして、ジャーナルが求める形式でAI利用を開示し、インテグリティ(integrity)のルールの範囲内に収めます。これは何かを隠すこととはまったく逆です。
Q: どうしてAI検出器は、私がすべての単語を自分で書いたのに私の文章をフラグするのですか?
多くの検出器は、パープレキシティをスコアリングし、つまりあなたの単語選びがどれほど予測可能かを意味しています。注意深い第二言語の書き手は一般的な語彙や標準的な言い回しを使うため、低パープレキシティが生まれ、それが機械出力として読まれてしまいます。2023年のスタンフォードの研究では、人間が書いた非母語エッセイの約61%がAIとしてフラグされ、母語書き手では約5%だったことが分かっています。したがって、このパターンは記録されており、あなたのせいではありません。
Q: humanizer はシンハラ語・タミル語の影響を受けた英語に対応していますか?
はい。言語に対応しており、60以上の言語をサポートしているため、シンハラ語話者・タミル語話者が英語に持ち込む「冠詞の省略」「コピュラの省略」「時制の単純化」「後置詞に由来する前置詞パターン」を認識できます。技術用語、結果(findings)、参照文献(references)を保持しながら、リズムと語彙の選び方を変えます。
Q: 私の論文がすべてのAI検出器を通過することを保証できますか?
いいえ。そして、そう約束するいかなるツールも信用しないでください。主要な検出器で試験したところ、私たちの humanizer はAIテキストをより自然な人間の形へ書き換え、AIシグナルを下げ、難度の高い検出器に対する通過見込みを高めます。一方で、文法の正確さは高いまま維持されます。これらは、数か月ごとに検出器が再学習するため、保証ではなくテスト結果です。
Q: humanize をすると、引用(citations)や結果は変わりますか?
いいえ。humanizer は、あなたの意味、技術的な用語、引用(citations)を APA、MLA、Chicago、IEEE のいずれでも保持します。リズムと表現を調整し、反復的な語尾のリズムや紛れ込んだダッシュ(em dashes)を取り除くため、あなたが報告した科学は同一のまま維持されつつ、文章は自然に読めるようになります。
スリランカの研究者のための、言語に配慮したAIテキスト・ヒューマナイザーです。慎重なシンハラ語、タミル語の影響を受けた英語が自然かつ公正に読まれるようにしつつ、意味、用語、引用を保持します。

Moe は、自然言語処理の PhD を持つ NLP エンジニアです。 彼の研究は計算言語学、テキスト分析、機械学習をカバーしており、それは ProofreaderPro の背後にある編集および人間化モデルに直接反映されています。 彼は、ほとんどの人が目にすることのないプロセスの部分、つまり言語モデルがどのように文を読み取り、スコアを付け、何を変更するかを決定するかについて書いています。


