
英語で執筆するハンガリーの研究者のためのAI Humanizer
ハンガリーの研究者向けのAI humanizer。ハンガリーの影響を受けた英語における誤ったAI検出フラグを減らし、意味と引用を保ちつつ、正直に開示します。

ハンガリーの科学は実力以上の成果を出しています。人口1,000万人に満たない国にもかかわらず、傑出した数学者、物理学者、化学者、そして生命科学者を輩出しており、その伝統は今も同国の大学の成果物に色濃く反映されています。ただし、その研究成果が書かれるのは英語です。ブダペストやセゲドのほぼすべての研究者は、まず最初にハンガリー語で考え、下書きをします。その後、文法がほとんど共通しない第二言語へと議論を運びます。この翻訳ギャップこそ、ハンガリーの研究者のためのAI humanizerが担うべき役割です。丁寧なハンガリー語、英語の文章が、いま「機械文」として読み違えられてしまっているからです。
不都合な点はここです。英語がより整っていて標準的であればあるほど、AI検出ではフラグが立ちやすくなります。「各単語がどれほど“意外性”を持つか」で文章をスコアリングするモデルは、規律のある予測可能な書き方を、機械による著作の兆候として扱います。難しい第二言語で明快に書いたことへの報いが、誤った告発になってしまうのです。
私たちは、この特定の問題のためにhumanizerを作りました。誰かの“近道”を隠すためではなく、実在する研究者による実際の仕事を守るためです。このガイドでは、ハンガリーの学術研究者にとって、誠実な出版ワークフローの中でどのように機能するかを説明します。
ハンガリー語のAI文章を人間らしくする:ハンガリーの研究者向け
AI-szöveg humanizálása(AI文章のhumanize)とは、AI支援によって書かれた自分の文章を、より人間らしいリズムへと整えることです。その一方で、意味、専門用語、引用は変えずに保ちます。Our tool is built for Hungarian academics who draft in their own language and then publish in English.
要点は、何かを見えなくすることではありません。ハンガリーの研究者が書いた、注意深く標準的な英語の一文は、それが注意深く標準的であるという理由だけで疑わしいと扱われるべきではない、ということです。私たちの text humanizer が減らそうとしているのは、この“誤検知(false flag)”です。
ハンガリー語で下書き? humanizerが直接検出して書き換え
まずは、ハンガリー語の下書きを英語へ翻訳する前にhumanizeできます。文章を貼り付けるだけで、ProofreaderProが言語を自動的に検出し、その後、長い母音、膠着的な語形、そして文章中の引用を尊重する「ハンガリー語に配慮した」モデルへとルーティングします。AI-szöveg humanizálása では、ハンガリー語の文章のリズムを変化させつつ、すべての語彙と参照情報をそのまま保持します。自動検出は60以上の言語にまたがるため、ハンガリー語は英語へ“作り替えられる”のではなく、ハンガリー語として扱われます。
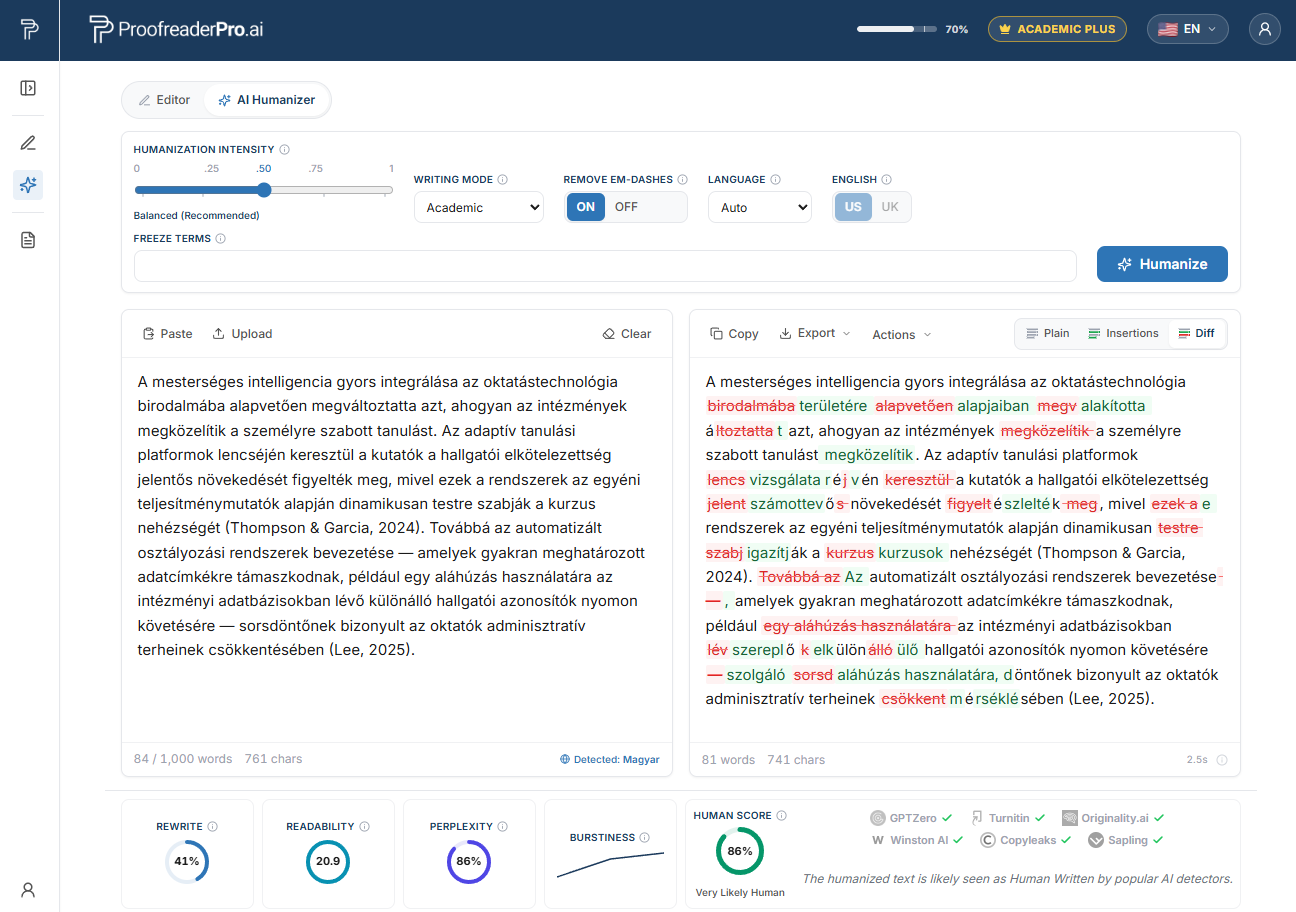
ProofreaderPro AI Humanizer がハンガリーの学術文章を書き換えている場面です。before と after の差分は意味と引用を保ち、検出チェックが自然な“人間らしい読み”を確認しています。
なぜハンガリーの研究者はAI検出でフラグを立てられやすいのか
2023年、スタンフォードの研究グループ(Weixin Liang が率いる)が、人間が書いたエッセイに対して、広く使われているGPT検出器を7種類テストしました。エッセイはTOEFL試験のものであるため、いずれにも人間の著者がおり、その著者は英語を母語としないライターでした。平均すると、そのエッセイの約61%がAI生成としてフラグを立てられました。英語を母語とする書き手のエッセイでは、この数値は約5%です。母語が英語でないエッセイでは、ほぼ5分の1に当たる約19.8%が、すべての検出器によって“全員一致で”フラグを立てられました。
もう一度読み直してください。英語が著者の第二言語であるというだけで、人間の文章が10倍以上の頻度でフラグを立てられてしまったのです。
仕組みは「パープレキシティ(perplexity)」と呼ばれます。多くの検出器は、単語の選択が言語モデルにとってどれほど予測可能かを推定します。第二言語で書くと、人は安全で一般的、正しい構文に手を伸ばします。慎重な書き手ならそうするからです。“安全で一般的”とはパープレキシティが低いことを意味し、パープレキシティの低さこそが、これらのツールが「機械文」として読み取るために学習してきた指紋です。詳しい仕組みは なぜAI検出器が非ネイティブの書き手にフラグを立てるのか で解説していますが、要約すると残酷なほど単純です。文章を明快にする習慣が、そのままフラグを立てられる原因にもなっているのです。
誤検知の背景にある「ハンガリー語を母語とする」特有パターン
ハンガリー語はウラル語族の言語であり、その周囲にあるインド・ヨーロッパ諸語とは無関係です。論理構造は英語と本質的に異なります。この違いが、ハンガリー語、英語の文章に“痕跡”を残します。これらは知性の誤りではありません。きわめて異なる文法の影が、英語へ滑らかに整えられた結果、検出器からは平板で予測可能なものとして読まれてしまうのです。
he と she の代名詞は1つだけ。 ハンガリー語では三人称の代名詞は1種類で、文法上の性がありません。そのため、英語では「he」と「she」が入れ替わります。この点を修正しようとする書き手は、最も安全な選択肢を使いすぎたり、「the author」や「the participant」を中心に文を組み立て直したりしがちです。その結果、非常に均一で、変化の少ない文章になります。
冠詞の分配が異なる。 ハンガリー語にも冠詞(a、az、egy)はありますが、英語とは異なるロジックで使われます。定冠詞・不定冠詞が省略されたり追加されたりし、慎重な修正はたいてい毎回、最も標準的で教科書的な冠詞になります。標準的であることが、そのまま“機械っぽさ”のスコアにつながります。
膠着語性と強い名詞化。 ハンガリー語は、語幹に接尾辞を積み重ねることで意味を作ります。これが英語へ移されると、その習慣は、密度の高い名詞句と長い名詞化の連鎖("the implementation of the optimisation of...")になります。文法的には完璧で、しかもリズムが単調です。検出器は単調さが大好きです。
話題優位の語順。 ハンガリー語は文の話題と焦点を前面に出すため、強調の位置が英語話者が想定する場所とは異なります。書き手がこれを、素直な主語、動詞、目的語の英語へと“正規化”すると、結果は正しく、整然としていて、そして予測可能になります。
未来を示すマーカーがなく、アスペクト体系も異なる。 ハンガリー語は未来の表し方が別で、アスペクトも独自に処理します。そのため英語で選ぶ時制がばらつき、そこから最も中立で一般的な時制へと修正されていきます。安全な時制とは結局、パープレキシティが最も低いものです。
前置詞ではなく後置詞(postpositions)。 ハンガリー語では、関係を示すマーカーを名詞の後ろに置きます。そのため英語では前置詞のミスが起きやすくなります。これを直すには、毎回、最も標準的な前置詞へと手を伸ばす必要があります。標準的であることが、“生成された文章”として検出器に読まれるのです。
ハンガリーにおけるAI検出とTurnitinの文脈
ハンガリーの機関から提出されるテーゼ(Theses)や学術誌への投稿原稿は、テキストの類似性について、日常的にスクリーニングされます。多くの場合、Turnitinまたは同等のシステムが用いられ、AIの指標も同じスクリーニングの中へ次第に組み込まれています。これは、博士論文の口頭審査や原稿査読における例外的な手順ではなく、すでに通常の一部になっています。
これらのツールの限界も見ておく価値があります。海外の主要大学のいくつか(Vanderbilt を含む)は、誤検知や非ネイティブ書き手への偏りを理由に、TurnitinのAIライティング検出をオフにしました。またTurnitin自身も、最も低いスコアを抑制し、「その数値だけで独立に完全性(integrity)に関する判断を決めるべきではない」と警告しています。検出器のスコアは、争うことが許される主張であって、判決ではありません。
ハンガリーの機関は生成AIに関する独自のガイダンスも出しており、助成機関や学術誌は、著者がこれらのツールの使われ方を開示することをますます求めています。正直な対応は、何も隠さないことです。責任を持って書き、編集し、そのうえで依拠したツールを宣言することが解決策です。
誤検知によるフラグから、慎重に作成したハンガリー語, 英語の文章を守ります
すべての引用, 用語, 発見をそのまま保持しつつ、AI支援の下書きを自然な文章に整えます。最後に、自信を持ってツールの使用を開示してください。
Humanizer を無料でお試しハンガリーの主要大学と、AIチェックが現れる場所
類似性とAI指標のスクリーニングは、博士課程の学校から学術誌の編集部まで、ハンガリーの高等教育全体にわたって見られます。以下の機関は、国内でも研究志向が強いところの一部であり、テーゼや原稿は次のチェックを通過します:
- Eötvös Loránd Tudományegyetem (Eötvös Loránd University, ELTE)、ブダペスト
- Semmelweis Egyetem (Semmelweis University)、ブダペスト(主要な医学部)
- Szegedi Tudományegyetem (University of Szeged)、セゲド
- Debreceni Egyetem (University of Debrecen)、デブレツェン
- Budapesti Műszaki és Gazdaságtudományi Egyetem (Budapest University of Technology and Economics, BME)、ブダペスト
- Budapesti Corvinus Egyetem (Corvinus University of Budapest)、ブダペスト
- Pécsi Tudományegyetem (University of Pécs)、ペーチ
- Pázmány Péter Katolikus Egyetem (Pázmány Péter Catholic University)、ブダペスト
- Óbudai Egyetem (Óbuda University)、ブダペスト
ELTEで擁護されるディスカッション(学位論文)であろうと、Semmelweisからの臨床原稿であろうと、同じダイナミクスが当てはまります。標準的で丁寧なハンガリー語、英語は、パープレキシティに基づくフラグを踏みやすい執筆スタイルだということです。
ハンガリーの研究者向けAI humanizerはどう機能するか
私たちが推奨するワークフローはシンプルで、そして何より誠実です。3つの段階があります。
第一に、下書きです。あなたの思考が最も早くページに乗る方法で、論文を書きます。多くのハンガリーの研究者にとっては、ハンガリー語で下書きをして翻訳する、またはAI支援を受けながら英語で直接書く、という形になります。どちらでも構いません。
第二に、内容を校正します。文法、専門用語、そして議論を修正し、科学が正しい状態にします。言語そのものに慎重な手入れが必要な場合は、私たちの global academic editing hub がその部分をカバーします。
第三に、自分の下書きをhumanizeします。ここで text humanizer が登場します。文の長さとリズムを調整し、ハンガリー語—英語の膠着的な性質が生みがちな単調な間隔をほどき、AIツールと第二言語の習慣が残しがちな紛れた長ダッシュ(em dash)や反復構造を取り除きます。重要なのは、意味、専門的な語彙、そしてすべての引用を保持することです。非英語の元テキストは言語に配慮したモデルにルーティングされ、ツールは60以上の言語をサポートしています。
それによって何が達成されるのでしょうか。私たち自身のテストでは、注意深く書かれた非ネイティブの下書きをhumanizeすると、主要な検出器に「機械が書いた文章」と誤読される頻度を大幅に下げられる一方で、学術的な意味はそのまま保たれました。私たちはこれを“テストで見られたこと”として説明しており、“約束”として述べているわけではありません。検出器は数か月ごとに再学習され、また「100%検出不能」をうたうサービスは、実際に提供できないものを売っているだけだからです。
最後に、第四の段階として開示します。大学と対象の学術誌が求める形式に従って、AI使用の声明を追加してください。自分のAI支援による文章をhumanizeしたうえで、それを宣言することは“ごまかし”ではありません。第二言語で明快に書いたというだけで不公平にフラグを立てられるのではなく、あなたの注意深い仕事がその価値に基づいて評価されるようにすることです。国をまたいだより広い言語の全体像については、私たちの multilingual AI humanizer hub をご覧ください。
地域の助成機関、学術誌、そしてAI開示への期待
ハンガリーの競争的研究は主に NKFIH (Nemzeti Kutatási, Fejlesztési és Innovációs Hivatal, the National Research, Development and Innovation Office) への支援で賄われており、MTA (Magyar Tudományos Akadémia, the Hungarian Academy of Sciences) が国内のアカデミーとして存在し、HUN-REN (the Hungarian Research Network) が公的な研究機関を運営しています。これらはいずれも、出版され索引化された成果を評価するため、研究者が英語で出版することへの圧力を常に維持する仕組みになっています。
この成果は、Web of Science と Scopus に索引されている学術誌で測定され、MTMT (Magyar Tudományos Művek Tára, the Hungarian Scientific Bibliography) に登録されます。これは国内の出版データベースです。評価文化は、国際的で英語による出版を後押ししており、それこそが、検出器に誤読されやすい“清潔で標準的な散文”へハンガリーの研究者を押しやる圧力になっています。
助成報告と学術誌への投稿の両方で、AI使用の開示がより一般的になっていくことが予想されます。ルーティンとして扱ってください。どのツールを、どのように使ったかを率直に述べ、データと引用を誠実に保てば、不公平なフラグから書く力を守りつつ、ルールの範囲内で安心して対応できます。
よくある質問
Q: ハンガリーの研究者向けAI humanizerは、私の引用や専門用語を変えますか?
いいえ。humanizerは、あなたの意味、分野固有の専門用語、そして参照情報を、あなたが書いたとおりに正確に保持することを目的に作られています。変更されるのはリズムや言い回しであって、あなたの科学や出典そのものではありません。
Q: どのツールでも、私の論文がすべてのAI検出器を確実に通過できると保証できますか?
いいえ。そうした主張をする相手は信頼しないでください。検出器は定期的に再学習されるため、誠実に運営しているサービスで「100%検出不能」を約束できるものはありません。私たちが言えるのは、テストにおいては注意深い非ネイティブの文章をhumanizeすることで、「機械が書いた文章」と誤読される頻度が大幅に下がった、ということです。
Q: 自分の下書きをhumanizeするのは不正(チート)に当たりますか?
それは不正ではありません。自分自身のAI支援による執筆作業に取り組み、調査結果を誠実に保ち、そして機関や学術誌が求めるとおりにツールの使用を開示している限りです。目的は、真正の仕事の公平さを守ることであって、偽装することではありません。
Q: 私の明快な英語だけがフラグを立てられ、弱い文章はそうならないのはなぜですか?
多くの検出器は「予測可能性」をスコアにしています。第二言語を書き手が注意深く書くと、安全で標準的な正しい構文に頼るため、パープレキシティが低いテキストになります。そしてパープレキシティの低さは、これらのツールが「機械による文章」と結び付けるまさにそのパターンです。あなたの明快さが、逆に不利に働いてしまうのです。
Q: 最初にハンガリー語で書きます。ツールはそれにも対応していますか?
はい。非英語のテキストは、60以上の言語にわたって文構造と意味を保持する言語に配慮したモデルにルーティングされます。つまり、ハンガリー語で下書きをし、翻訳してから、その英語版をhumanizeしても、あなたの議論を失わずに進められます。
すべての引用と発見を保持したまま、慎重に作成したAI支援のハンガリー語, 英語の下書きを自然な学術文にします。そして自信を持ってAIの使用を開示してください。

Moe は、自然言語処理の PhD を持つ NLP エンジニアです。 彼の研究は計算言語学、テキスト分析、機械学習をカバーしており、それは ProofreaderPro の背後にある編集および人間化モデルに直接反映されています。 彼は、ほとんどの人が目にすることのないプロセスの部分、つまり言語モデルがどのように文を読み取り、スコアを付け、何を変更するかを決定するかについて書いています。


