
英語で執筆するスイス研究者のためのAIヒューマナイザー
スイスの研究者向けAIヒューマナイザー。ドイツ語・フランス語の影響を受けた英語に対する誤ったAI検出フラグを減らし、意味と引用を維持しつつ、正直に開示します。

スイスは、地球上でもとりわけ研究経済が密な国の一つです。人口あたりで測ってみても、多くの国より発表数が多い、あるいは引用が集まる国が少なくありません。そしてETHの領域(ETHドメイン)は、重要なほぼすべてのランキングで上位に位置します。その膨大な研究成果のほとんどは、著者の母語がドイツ語、フランス語、イタリア語、ロマンシュ語のいずれであっても、英語で出版されます。
まさにそこから、現代的な問題が始まります。ドイツ語またはフランス語話者が書く、丁寧で標準的な英語が、自動検出器によって機械出力として誤読されるケースが増えています。つまり、スイスの研究者のためのAIヒューマナイザーが必要になっているのです。文は人間が書いたものです。それにもかかわらずソフトウェアは一致しません。そして、その食い違いは、レビューアが一文字も読まないうちに、投稿を止めてしまうことがあります。
ベルン大学(Universität Bern)でポスドクが、明快な教科書英語で方法(methods)セクションを下書きしている場面を想像してください。コピーもありません。捏造もありません。それでも検出器は「AI生成」といったスコアを返し、今度は研究者側が否定を証明しなければならなくなります。このガイドは、実際のAI利用を隠すことなく、その不公平を正直に是正することを目的としています。
KI-Text humanisieren: so publizieren Schweizer Forschende sicher auf Englisch
私たちのHumanizerは、ETHやEPFL、そしてその間のあらゆる場所で研究する方々が、英語の原稿を自然に響かせるのに役立ちます。意味や出典が失われることなく、です。Pour les chercheurs romands, l'objectif est identique: humaniser un texte IA tout en gardant le sens et les références intacts.
率直に言えば、チューリッヒで標準ドイツ語を書いても、ローザンヌでフランス語を書いても、このツールは英語のリズムを調整し、丁寧な第二言語の文章が機械的な文章だと誤解されにくくします。専門用語や引用は、あなたが設定したとおりにそのまま維持され、あなたが組み立てた主張も、あなたのものとして保たれます。
ドイツ語、フランス語、またはイタリア語で作成しますか。人間化機能がそれぞれを検知します
スイスの研究は複数の言語で書かれており、Humanizerは貼り付けた言語を検出します。ドイツ語、フランス語、イタリア語を入力すると、ProofreaderProが言語を自動判定し、その後、言語を意識したモデルに通して、用語と引用を正確にそのままの位置に保ちます。KI-Text humanisierenによって、あなたのドイツ語下書きは、最初から英語と同様に自然にヒューマナイズされます。最初に翻訳する必要はありません。同じ自動検出は60以上の言語にまたがり、それぞれのレジスターに合わせて書き換えます。
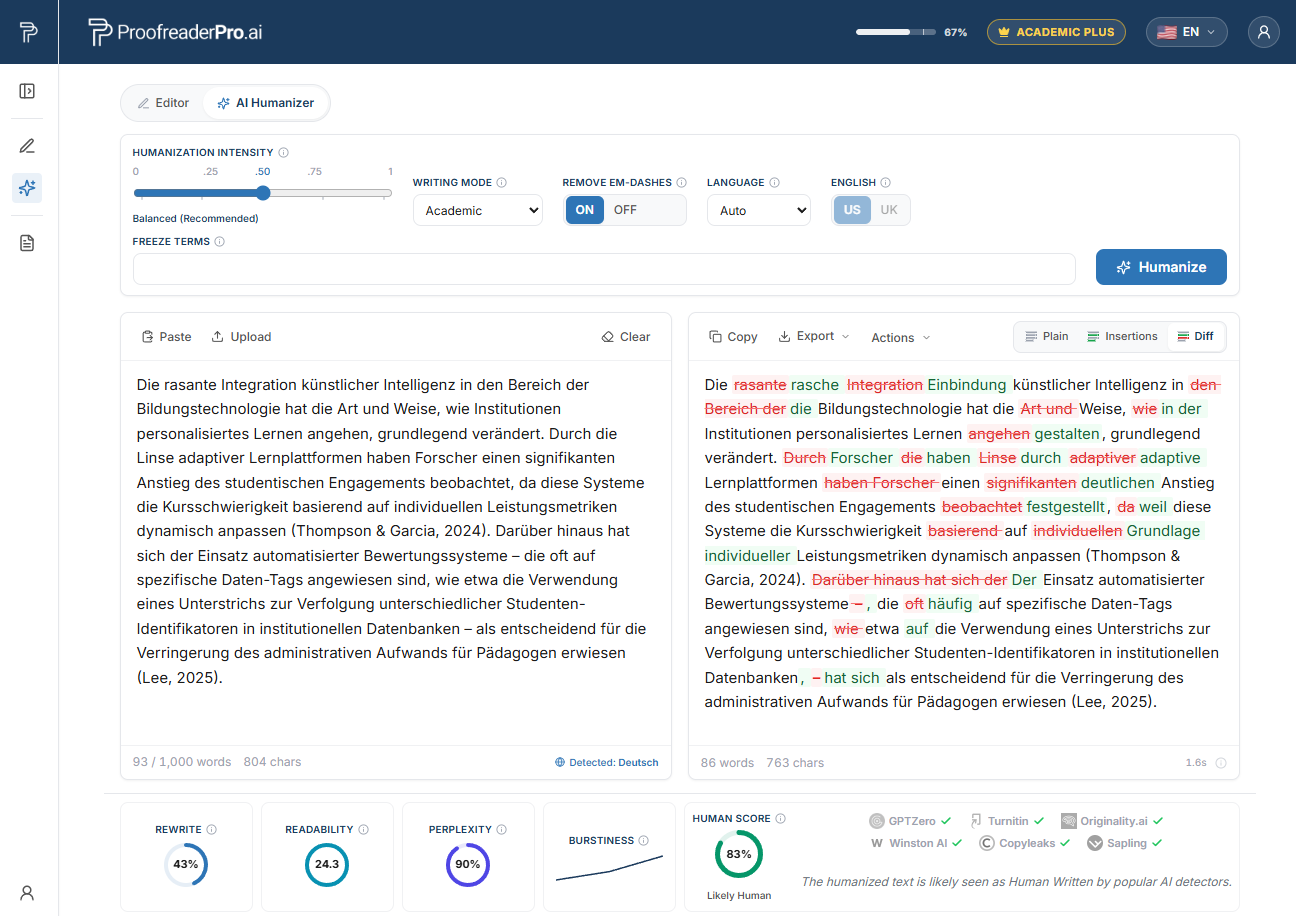
ProofreaderPro AI Humanizerがドイツ語の学術文を言語として自然に書き換える様子。before と after の差分は意味や引用を保持し、検出器チェックにより自然で人間らしい読まれ方が確認できます。
なぜスイスの研究者はAI検出器でフラグを立てられやすいのか
最も明確な根拠は、梁(Liang)らによる2023年のスタンフォード研究です。Cell Pressのジャーナル『Patterns』に、「GPT detectors are biased against non-native English writers.」という題名で掲載されました。研究チームは、人間が書いたTOEFLのエッセイを、広く使われている7種類の検出器に通し、結果として何が返ってきたかを確認しました。
この結果は、英語を第二言語、あるいは第三言語として書く人にとって不安材料となるはずです。平均すると、非ネイティブのエッセイの約61%がAIとしてフラグを立てられました。一方で、ネイティブ英語話者では約5%程度です。さらに、5分の1近く、約19.8%は、セット内のすべての検出器で一致してフラグが立てられました。これらのエッセイはすべて、人間が書いたものでした。
なぜ起きるのでしょうか。ほとんどの検出器は「パープレキシティ(perplexity)」と呼ばれる指標をスコア化します。これは、次に来る単語が言語モデルにとってどれくらい意外なのかを測るものです。よくある語彙や、標準的で予測可能な言い回しに手が伸びる作家は、低パープレキシティの文章を生み出します。そして、低いパープレキシティこそが、これらのシステムが「機械が書いた文章」として読む特徴そのものです。スイス英語を明快で正確に保つ習慣と、検出器をつまずかせる習慣は同じです。仕組みの詳細は、AI検出器が非ネイティブの書き手をフラグする理由で詳しく解説しています。
偽フラグの背後にある、ドイツ語・フランス語話者の第一言語パターン
スイス英語には、書き手の第一言語の痕跡があり、それは正しく、丁寧で、標準的です。残酷なのはここです。標準的であることは、検出器が低パープレキシティとして読み取る特徴であり、あなたが努力して作り上げた流暢さが、むしろ不利に働き得るのです。
ドイツ語話者はしばしば「偽の友(false friends)」を持ち込みます。文法的には問題ないのに、統計的には平坦です。「Aktuell」は、書き手が“現在の”という意味で使うときに「actual」に変わります。「eventuell」は「possibly」を意図して「eventually」へ。「also」は「so」や「thus」の意味で到来します。「bekommen」は受け取る(receive)の代わりに「become」へとずれていきます。どの選択も意図的で一貫しており、一貫性は予測可能性として読まれます。
次に、文構造です。ドイツ語の語順は「Therefore is the effect stronger,」のような構文を押し込みます。さらに、長い名詞の複合語や名詞化を好む言語的傾向が、英語にも密で整然とした言い回しとして持ち込まれます。ドイツ語話者は、英語が持続(duration)を示すために「for」を求める場面で「since」を選ぶこともあります。これらは、思考の誤りではありません。単に規則的であり、規則性はソフトウェアには機械的に見えるのです。
そしてフランス語話者にも、独自の偽の友があります。「Actuel」はcurrentの代わりに入り、「éventuellement」はpossiblyの代わりに入り、「sensible」はsensitiveの代わりに入ります。また「important」はlargeの代わりになりがちです。なかには「assist to」と書いて、実際には「attend」を意味する人もいます。注意深く、しかも標準的、これがまさに落とし穴全体です。
フランスの学術文体は、相対節(relative clauses)を積み重ねた長い周期文(periodic sentences)を好むこともあります。名詞化が多く、「which」が頻繁に登場し、「permit to」や「in the case where」のような転換も見られます。英語の査読者は、このような文章を「密度の高い散文」として読みます。検出器は、その均一さを低パープレキシティとして読み取ります。文章は人間のものです。ただ、そのリズムが機械の好みに対して整いすぎているのです。
誤検知フラグから、慎重な英語を守ります
ご自身のAI支援の下書きを自然な文章に整え、すべての引用と専門用語をそのまま保持してください。次に、自信をもってAI使用を開示します。
Humanizer を無料でお試しスイスにおけるAI検出とTurnitinの文脈
ここでのスクリーニングは日常的です。スイス国内の各機関における学位論文や学術誌への投稿は、類似性チェックとしてTurnitinまたはiThenticateを通過することが一般的であり、AIの指標がこれらの類似性スコアと並んで示されることも増えています。バーゼルやジュネーブの研究者は、いずれかのタイミングで何らかの自動チェックが走ると考えておくべきです。
機関の雰囲気は、処罰的というよりも熟慮的です。ETH ZürichやEPFLなどは学生・職員向けに生成AIのガイダンスを公開しており、進むべき方向性は禁止ではなく開示です。助成機関やジャーナルは、ますます多くの場面で、著者がどこでどのようにAIツールを使用したのかを明示するよう求めています。検出器のスコアを「対処できる主張」と捉え、受け入れなければならない「判決」として扱わないでください。
スイスの主要大学と、AIチェックが現れる場所
同じスクリーニングのロジックは、スイス全体の仕組みで一貫しています。これらの機関はすべて、学位論文や原稿を類似性についてチェックし、さらに今後はAIの指標についてもますますチェックしていきます:
- ETH Zürich (Eidgenössische Technische Hochschule Zürich), in Zürich
- EPFL (École polytechnique fédérale de Lausanne), in Lausanne
- Universität Zürich (UZH), in Zürich
- Université de Genève (UNIGE), in Geneva
- Universität Basel, in Basel
- Universität Bern, in Bern
- Université de Lausanne (UNIL), in Lausanne
- Université de Fribourg / Universität Freiburg, in Fribourg
- Università della Svizzera italiana (USI), in Lugano
- Universität St. Gallen (HSG), in St. Gallen
- Universität Luzern, in Lucerne
- Université de Neuchâtel, in Neuchâtel
ドイツ語圏の北・東、フランス語圏の西のどこでも、このパターンは保たれます。丁寧な非ネイティブ英語が標準であり、その丁寧な非ネイティブ英語がまさに誤読されるのです。
スイス研究者のためのAIヒューマナイザーはどのように機能するのか
ここでは、スイス研究者のためのAIヒューマナイザーの正直なワークフローを、ステップごとに示します。あなたが最も書きやすいところから始めましょう。多くの研究者は、第一言語(ドイツ語またはフランス語)で下書きを作り、その後に翻訳します。あるいは、AI支援を受けながら最初から英語で書く人もいます。いずれにせよ、元の下書きはあなたのものであり、その状態を保つべきです。
次に、文法と用語を整え、科学が正確であることを確認します。そして、AI支援で書かれたあなた自身の文章を、humanizerに通してください。文の長さや語の選び方を調整し、反復的なリズムをほどき、査読者や検出器が気づく機械的なリズムや、紛れ込んだemダッシュを取り除きます。同時に、あなたの意味、専門語彙、そしてすべての引用は、所定の位置のまま維持されます。全文を通す前に、単一のセクションで無料でhumanizerを試すこともできます。
何を期待できますか。私たち自身のテストでは、丁寧で標準的な非ネイティブ英語が主要な検出器(Turnitin、Originality.ai、GPTZeroなど)に誤読される頻度を、大幅に減らしつつ、学術的な意味は保持できています。これは「見えてきたこと」として述べるのであって、約束ではありません。検出器は数か月ごとに再学習され、正直なツールであれば「100%検出されない」と約束することはできません。
最後のステップは任意ではありません。開示です。機関と対象ジャーナルが求める形式で、AIの使用を明記してください。自分の文章をヒューマナイズし、その後で開示すること、この組み合わせによって、実際の作業を誤フラグから守りつつ、整合性(integrity)ルールの内側にとどまれます。ツールは、私たちのより広いグローバルな学術編集ハブの中に組み込まれており、また、数十の言語をカバーする多言語AIヒューマナイザーハブの一つの導線になっています。
地域の助成団体、ジャーナル、そしてAI開示の期待
スイスの研究は、周知の仕組みに支えられています。SNSF(Swiss National Science Foundation; Schweizerischer Nationalfonds, SNF; Fonds national suisse, FNS)が主要な公的助成機関であり、Innosuisseはイノベーションと応用プロジェクトを後押しし、スイスの研究グループは欧州研究会議(ERC)助成の相当な割合を獲得しています。さらにSNSFはオープンアクセスを義務づけているため、研究は可能な限り広く読まれることが前提となっています。
そのような出版の現実が、投稿先の選び方に影響します。ここでは研究者は、Web of ScienceおよびScopusにインデックスされるジャーナルを志向し、Plan Sにおけるオープンアクセスの早期導入者でもあります。投稿段階でのTurnitinまたはiThenticateによる類似性スクリーニングも標準的であり、英語が自然に読まれる状態にしておくべきもう一つの理由になります。
開示の期待は、ツールの進化に合わせて高まっています。助成機関やジャーナルは、著者に対しAIをどのように使用したかを明記するよう、ますます頻繁に求めています。そのため、あなたが何を、どこで使ったのかについて、短くて正直な記録を残しておきましょう。既成の文言が必要なら、私たちのAI開示ステートメントのテンプレートが出発点を提供します。そしてもし人間の作業に対してフラグが立ってしまった場合は、取り消し可能な論点として扱い、パニックによる書き直しではなく、落ち着いて根拠ある対応を準備してください。
よくある質問
Q: スイス研究者のためのAIヒューマナイザーの使用は不正行為(チート)とみなされますか?
いいえ、正直に使う場合には違います。ここで行うのは、自分自身のAI支援下書きをヒューマナイズして、誤フラグから丁寧な英語を守ることです。結果を捏造したり、方法を隠したりすることではありません。安全を保つルールは開示です。機関とジャーナルが求める形で、AIの使用を明記してください。
Q: humanizerは私の引用や専門用語を変更しますか?
いいえ。参照、数値、ドメインの用語は保持されます。そして、文章が自然に読めるようにリズムと語の選び方だけを調整します。方法はあなたの方法のままで、参考文献リストはそのまま残ります。
Q: 私の論文がAI検出器を通過することを保証できますか?
いいえ、そう主張する人には注意してください。検出器は定期的に再学習されるため、正直なツールであれば「100%検出されない」を約束することはできません。私たちが言えるのは、テストではヒューマナイズされた文章が意味を損なわない一方で、誤読される頻度が大幅に低い、ということです。
Q: ドイツ語話者とフランス語話者の両方に対応していますか?
はい。humanizerは言語を認識しており、60以上の言語をサポートします。第一言語がドイツ語、フランス語、イタリア語、ロマンシュ語のいずれであっても、意図した構造を尊重しながら、英語の下書きから作業できます。
Q: 私は丁寧な英語で自分で論文を書きました。なぜフラグが立ちましたか?
検出器はパープレキシティでスコアを付けており、丁寧で標準的な第二言語の英語は、その性質上パープレキシティが低くなりがちです。スタンフォードの調査結果は、人間が書いたエッセイであっても「予測可能」として読まれるだけで高い率でフラグが立てられることを示しています。フラグは、不正行為の証明ではなく、あなたの文体に関する統計的な推測です。
英語で執筆するスイスの研究者向け、言語に配慮した“humanizing”。意味、用語、引用を保ったまま、検出ツールが読み違えることのある均整のとれたリズムを整えます。

Moe は、自然言語処理の PhD を持つ NLP エンジニアです。 彼の研究は計算言語学、テキスト分析、機械学習をカバーしており、それは ProofreaderPro の背後にある編集および人間化モデルに直接反映されています。 彼は、ほとんどの人が目にすることのないプロセスの部分、つまり言語モデルがどのように文を読み取り、スコアを付け、何を変更するかを決定するかについて書いています。


