
バングラデシュの研究者向け:英語執筆のためのAIヒューマナイザー
バングラデシュの研究者向けのAIヒューマナイザーです。バングラ語の影響を受けた英語における誤ったAI検出フラグを低減し、意味と引用を保ちながら、正直に開示します。

バングラデシュは研究成果の分野で世界54位に位置し、アジアにおいて最も急成長している研究生産国の一つでもあります。2025年には、同国の研究者が18,613件の出版物を記録しており、インドおよびパキスタンを上回る20.76%の伸びを示しました。この数字の背後には、51,704名の博士号保有者と55の公立大学があり、すべてが英語の国際誌に掲載するプレッシャーにさらされています。
ここで、あまり知られていない落とし穴があります。バングラデシュのEF英語能力指数(EF English Proficiency Index)は506で、Low Proficiency帯に入っています。また、ベンガル語(バングラ語/Bangla)は英語と比べて構造レベルで異なります。バングラデシュの研究者向けのAIヒューマナイザーが存在するのは、ひとつの現実的な理由からです。すなわち、注意深く標準的な第二言語英語が、AI検出器によって機械的な文章として誤読され、その誤読が、実在する著者に実際のデスク拒否(desk rejection)という損失をもたらしている、ということです。
このガイドは「偽装」ではなく「公平性」についてです。私たちは、あなた自身の文章、あなた自身の発見、あなた自身の引用を保護するためにヒューマナイザーを構築しました。これにより、確率スコアが、あなたが数か月をかけて書いた論文を静かに上書きすることはできなくなります。
バングラデシュの研究者のためのAIヒューマナイザー(AI humanizer for Bangladeshi researchers)
AIヒューマナイザーは、バングラデシュの研究者が英語の国際ジャーナルで出版できるよう支援し、意味と引用を損なうことなく保ちます。(Our AI humanizer helps Bangladeshi researchers publish in international English-language journals while keeping meaning and citations intact.)
ダッカ大学、BUET、または国内の110の私立大学のいずれで原稿を作る場合でも、執筆のボトルネックは現実のものです。あなたは質の高い研究を行い、推論を英語に翻訳し、その後に、あなたが同意していない第二の読者、自動のAI検出器、に直面します。私たちのヒューマナイザーは、完成した下書きとその検出器の間に入り、議論そのものには触れずに、注意深い非ネイティブ文の機械的なパターンだけを滑らかにします。
バングラ語(বাংলা)と60以上の他言語をサポートし、非英語テキストを言語に配慮したモデルへとルーティングすることで、文構造や専門用語を維持します。
ベンガル語で下書きしていますか?ヒューマナイザーはそれも検出し書き換えます
すべての下書きが英語で始まるわけではなく、ヒューマナイザーも英語であることを前提にしません。ベンガル語のテキストを貼り付けると、ProofreaderProがスクリプトを自動認識し、その上で言語に配慮したモデルへルーティングします。そうすることで、用語と引用を、書かれたとおりに保持できます。এআই হিউম্যানাইজারとして、あなたのバングラ語の文章を直接書き換えるため、「翻訳の後」ではなく「翻訳の前」にヒューマナイズできます。さらに、同じ検出は60以上の言語に対応しており、それぞれが「それ自身」として書き換えられます。
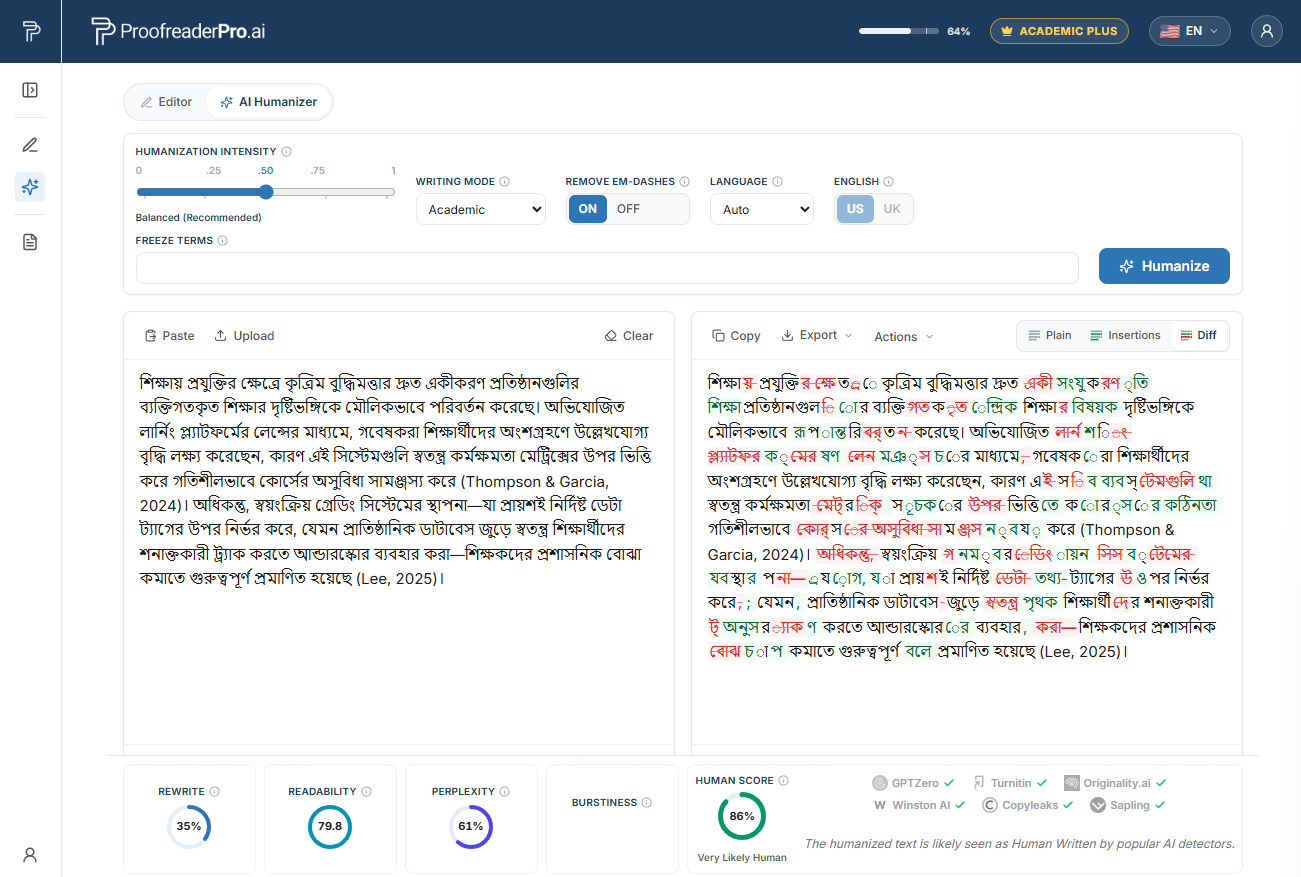
バングラ語の学術テキストを書き換えるProofreaderPro AIヒューマナイザー。ビフォー/アフターの差分は意味と引用を保ち、検出チェックにより自然な読み心地(人間らしい読解)が確認できます。
なぜバングラデシュの研究者はAI検出器にフラグを立てられやすいのか
2023年、スタンフォードのWeixin Liangらの研究チームが、Cell Pressの学術誌Patternsにて「GPT detectors are biased against non-native English writers」という研究を発表しました。同研究では、著者らが人間が書いたTOEFLの英作文を、広く使われている7種類の検出器にかけました。平均すると、非ネイティブの英作文の約61%がAIとしてフラグを立てられたのに対し、ネイティブ英語話者の作文では約5%でした。さらに、非ネイティブの英作文のうち約19.8%(5人に1人弱)が、すべての検出器によって一斉にAIとしてフラグを立てられました。どの英作文も、書いたのは人間です。
原因は「パープレキシティ(perplexity)」と呼ばれる指標です。多くの検出器は、言語モデルに対して、単語の選び方がどれだけ意外(驚き)かをスコア化します。第二言語で注意深く書くと、一般的な語や標準的で予測可能な言い回しを選びがちです。するとパープレキシティは低くなり、低パープレキシティは機械的な文章として読まれます。バングラデシュの学術文を明確かつ正確にする習慣こそが、これらのツールが罰するために学習された習慣そのものです。
仕組みの詳細は、こちらの解説をご覧ください: なぜAI検出器は非ネイティブ英語の書き手をフラグするのか。要点だけを短く言うと、検出器のスコアは「争う余地のある主張」であり、「受け入れるべき判決」ではありません。
偽フラグの背景にある、ベンガル語(第一言語)のパターン
ベンガル語はインド・アーリア系の言語であり、その構造は英語と比べて、よく文書化された形で異なります。以下の転移パターンは、英語が弱いサインではありません。それらは体系的で、注意深く構築された表現です。そして、このような非常に規則的な特徴が、検出器にとっては低パープレキシティの機械的テキストに見えてしまうのです。
冠詞の扱い。 ベンガル語にはそもそも冠詞の仕組みがありません。「the」「a」「an」に直接対応するものは存在しません。ベンガル語、英語のライティングに関する研究では、冠詞の省略は誤りの約30.93%を占め、不要な挿入は約26.25%を占めており、合わせると文法上のつまずきの半数を超えています。書き手が、均一で整った冠詞パターンに過剰修正すると、文章は統計的に滑らかになり、検出器が生成文と結び付けるまさにその表面を帯びます。
後置詞の転移による前置詞。 ベンガル語では名詞の後に粒子を置きます(「tebiler upore」は「table on-top-of」に対応します)。そのため書き手は、英語の前置詞を一貫した安全な形で標準化しがちです。一貫性は良い文法ですが、残念ながら低パープレキシティのシグナルでもあります。
SOV語順の残滓。 ベンガル語は主語、目的語、動詞の語順(「Ami boi porlam」は「I book read」を意味)に従います。高度な書き手はSOVを露骨に抑制しますが、その代わりに節のリズムを均一で測定されたものに補います。この均一さは、人間が書く文章で検出器が期待する「バースト性(burstiness)」を平坦化します。
コピュラ(be動詞)パターン。 ベンガル語ではコピュラが省略されることがよくあります(「Se shikkhok」は「She is a teacher」の一文全体に相当します)。「is」「are」「was」「were」を常に挿入する訓練をする書き手は、均一で教科書のように整った文フレームを生みやすくなり、これもまたモデルにとって予測可能なものとして読まれやすくなります。
これらはいずれも正しく、意図的な書き方です。問題はあなたの英語ではありません。注意深さを自動化と取り違える検出器にこそ問題があります。
バングラデシュにおけるAI検出とTurnitinの文脈
バングラデシュでは、学位論文、修士・博士論文、そしてジャーナル投稿が、類似性とAI指標の両面のために、TurnitinまたはiThenticateでスクリーニングされることが一般的です。大学助成委員会(UGC)の昇進枠組みにおいて、教員はScopus索引誌およびWeb of Science索引誌に継続的に掲載する必要があります。したがって、多くの研究者はキャリアを通じて繰り返しこれらのチェックを受けることになり、単発ではありません。
また、これらのAIスコアがどれほど争われているかも知っておく価値があります。Vanderbiltは2023年に、誤検出と非ネイティブの書き手に対するバイアスを理由に、TurnitinのAI検出器を無効化しました。ミシガン州立大学、UT Austin、ノースウェスタン、ピッツバーグ、SMU、ウォータールーも同様の対応を取りました。Turnitin自身も、1〜19%の範囲のスコアは抑制しており(数値の代わりにアスタリスクを表示)、そのスコアは単独で真正性の判断に用いるべきではないと警告しています。
しかし、これらのいずれも「フラグが無害である」ことを意味しません。指導教員や編集者が実際にそれに基づいて行動する可能性はあります。つまり正しい対応は、そもそも注意深い非ネイティブの文章が誤読されにくくすること、そして事後的な言い訳でなく、AIの利用をオープンに開示することです。
誤ったAIフラグからバングラデシュの研究を守る
ご自身のAI支援による下書きをHumanizeし、意図と引用をそのまま保持してから、ジャーナルが求める方法でAI利用を開示します。主要な検出器でテスト済み、高い文法精度。
Humanizer を無料でお試しバングラデシュの主要大学と、AIチェックが現れる場所
研究成果は比較的少数の機関に集中しており、すべてがUGCの「出版ベース」の昇進基準のもとで運営され、かつ、論文(theses)や原稿(manuscripts)について類似性とAI指標の両方がスクリーニングされます。
- ダッカ大学(DU / ঢাকা বিশ্ববিদ্যালয়)、ダッカ。最も古く、最高ランクの大学で、自然科学、薬学、社会科学が強み。
- バングラデシュ工科大学(BUET / বুয়েট)、ダッカ。主要な工学系機関で、土木、電気、コンピュータ、化学工学をリード。
- BRAC大学、ダッカ。公衆衛生、開発研究、コンピュータサイエンスに強い主要私立大学。
- ノース・サウス大学、ダッカ。同国初の私立大学で、ビジネス、工学、保健科学の研究が拡大中。
- ラジャシャヒ大学(University of Rajshahi)、ラジャシャヒ。2番目に古い大学(1953年設立)で、応用科学、農業、人文科学に強み。
- チッタゴン大学(University of Chittagong)、チッタゴン。海洋科学、林業、社会科学で強みを持つ主要な公立大学。
- ジャハンギルナガル大学(Jahangirnagar University)、セイバー、ダッカ。生物多様性研究、物理学、数学で知られています。
- クルナ工科大学(KUET)、クルナ。土木、機械、電気分野で工学系の成果が増加中。
- バングラデシュ農業大学(BAU)、ミメンシン。主要な農業研究機関で、作物科学、獣医学、水産学でリード。
- ダフォディル国際大学(Daffodil International University)、ダッカ。計算機、工学、保健科学にまたがる高出力の私立大学。
- チッタゴン工科大学(CUET)、チッタゴン。成長中の国際連携ネットワークを伴う、強い工学研究。
- アメリカン・インターナショナル大学バングラデシュ(AIUB)、ダッカ。工学、コンピュータサイエンス、ビジネスで目立った成果を持つ私立大学。
これらのいずれの機関でも、同じ現実が成り立っています。人間が最終判断を下す前に、あなたの原稿はAIチェックを通過するのです。そのゲートで注意深い執筆を守ることは、近道ではなく実務上の必然です。
バングラデシュの研究者向けAIヒューマナイザーはどのように機能するか
バングラデシュの研究者向けAIヒューマナイザーにはワークフローがあり、順序が重要です。
まず、下書き。あなたの推論がベンガル語のほうが自然に流れるなら、ベンガル語で書いて翻訳するか、あるいはAIアシスタントを使って直接英語で下書きし、「真っ白なページ」の壁を突破します。次に文法を校正します。なぜならヒューマナイザーは文法チェッカーではないからです。最後に、あなた自身のAI支援による文章を、text humanizerに通します。リズムや語の選び方を調整し、反復的なカデンツを断ち、紛れ込んだemダッシュ(—)を取り除きます。その一方で、意味、専門用語、そしてすべての引用は、書かれたとおりに保ちます。
私たちのヒューマナイザーは、AIテキストをより自然な「人間らしい形」へと作り直し、Turnitin、Originality.ai、GPTZeroのいずれの環境でも人間らしく読めるようにします。学術テキストにおいては、文法の正確性も高く維持されます。これらの結果を保証するものではありませんが、テストに基づいています。なお検出器は数か月ごとに再学習されるため、私たちは「100%検出不能」を約束しませんし、いかなる回避方法としても提示しません。
そして、ルールの内側にとどまるために重要なステップがあります。すなわち、AIの利用を、あなたの所属機関や対象ジャーナルが求める形式で開示することです。偏りのある検出器を回避するために、自分の下書きをヒューマナイズすることは、公正です。捏造された仕事を隠すことは公正ではなく、このツールの目的でもありません。これは、バングラデシュの研究者のための学術編集にあるのと同じ原則です。本ガイドの編集版にあたり、さらに、複数言語対応のmultilingual AI humanizer hubとして、数十か国の研究者を対象にしたより広い取り組みの中に位置付けられています。
地域の助成機関、ジャーナル、そしてAI開示への期待
バングラデシュにおける研究資金は主に、大学助成委員会(UGC)、大学内部の助成金および研究セル、バングラデシュ科学アカデミー、そして国際的な開発パートナーを通じて流れます。教育省および科学技術省の双方が、国の研究開発(R&D)支出がGDPの0.5%未満にとどまっているにもかかわらず、ビジョン2041の開発戦略の一環として国際的な出版を奨励しています。予算が非常に厳しい状況では、言語上の理由によるデスク拒否が、貴重な資金を浪費することになります。だからこそ言語保護は、贅沢ではなく効率化のための施策なのです。
ジャーナルの側でも、バングラデシュはBanglaJOL(Bangladesh Journals Online)を通じて索引化された媒体が拡大しており、142の国内ジャーナルが掲載されています。主要な誌としては、Journal of Health, Population, and Nutrition(Q1ランクで、同国最高インパクトのジャーナル)、Journal of Naval Architecture and Marine Engineering(Q2、BUETが発行)、Bangladesh Journal of Pharmacology、Bangladesh Journal of Medical Science、Journal of Bangladesh Academy of Sciences、Dhaka University Journal of Scienceなどが挙げられます。さらにUGC基準のもとで索引対象となる国際誌のターゲットは、ScopusおよびWeb of Scienceです。
資金提供者やジャーナルは、著者に対してAIツールを「使用したか/どのように使用したか」をますます求めるようになっています。その依頼を通常のものとして受け止め、率直に答えてください。明確な開示の一文と、「あなた自身が注意深い研究者であること」が伝わるヒューマナイズ済み原稿が揃うことで、信頼性とコンプライアンスの両方が保たれます。もしそれでもフラグが立った場合、私たちのヒューマナイザーは、対応に必要な明確な論文履歴(ペーパートレイル)を保ちます。また、単語ごとの課金が積み上がることなく、すべての改稿をtext humanizerに通すことができます。
よくある質問(FAQ)
Q: バングラデシュの研究者向けAIヒューマナイザーは、私の論文をTurnitinに通すのに役立ちますか?
主要な検出器に対してテストした結果、私たちのヒューマナイザーはAIテキストをより自然な人間らしい形へと書き換え、AIシグナルを下げ、手強い検出器に対する通過可能性を高めます。これは保証ではなく、検出器は数か月ごとに再学習されるため、テスト結果に基づくものです。目的は、注意深く書かれたバングラ語の影響を受けた英語が誤読されることを止めることであり、固定されたスコアを約束することではありません。
Q: AIヒューマナイザーを自分の下書きに使うことは、不正(チート)とみなされますか?
いいえ。あなたが自分自身のAI支援による文章をヒューマナイズし、本来の発見と引用を保持し、そのうえで所属機関やジャーナルが求める形式でAIの利用を開示する限り、問題ありません。このツールは、偏った検出器から「真正な非ネイティブの文章」を守るために作られており、捏造された、または借用された仕事を隠すためのものではありません。
Q: ヒューマナイザーは私の引用や専門用語を変えますか?
いいえ。意味、分野特有の用語、そして参照文献(APA、MLA、Chicago、IEEE)を、あなたが書いたとおりに保持します。リズムや語の選び方を調整し、反復的なカデンツを取り除くため、議論はあなたのまま保たれつつ、文章だけがより自然に読めるようになります。
Q: なぜバングラデシュの研究者は、ネイティブ話者よりも頻繁にフラグされるのですか?
2023年のスタンフォードの研究で、検出器は人間が書いた非ネイティブの英作文の約61%をAIとしてフラグしたのに対し、ネイティブの書き手では約5%でした。これは、注意深い第二言語の文章はパープレキシティが低いためです。冠詞なしの文法や、均一で標準化された言い回しといったベンガル語の特徴により、あなたの文章はモデルから見て予測可能になり、その結果、検出器はそれを自動化のように誤認してしまいます。
Q: ヒューマナイザーは、ベンガル語で下書きした文章にも対応しますか?
はい。ベンガル語(বাংলা)と60以上の言語を、言語に配慮したモデルでサポートします。ベンガル語で下書きして英語に翻訳する場合、またはAIの助けを借りて英語で直接書く場合でも、構造と意味を保ったまま結果をヒューマナイズできます。
意図と引用を保ち、AI検出器をつまずかせやすい慎重な非ネイティブのパターンを滑らかにし、その後AI利用を開示します。Turnitin、GPTZero、Originality.aiでテスト済み、高い文法精度。

Moe は、自然言語処理の PhD を持つ NLP エンジニアです。 彼の研究は計算言語学、テキスト分析、機械学習をカバーしており、それは ProofreaderPro の背後にある編集および人間化モデルに直接反映されています。 彼は、ほとんどの人が目にすることのないプロセスの部分、つまり言語モデルがどのように文を読み取り、スコアを付け、何を変更するかを決定するかについて書いています。


