
ウクライナの研究者のための英語執筆向けAIハマナイザー
ウクライナの研究者向けのAIハマナイザー。ウクライナ語・ロシア語の影響を受けた英語における誤ったAI検出フラグを減らし、意味と引用を維持しつつ正直に申告します。

ウクライナは、ほとんどの研究システムを停止させてしまうような状況下でも、真剣な科学を生み続けています。物理学者、数学者、材料科学者、そしてエンジニアたちは投稿を続け、国家の方針は全員を、Web of Science と Scopus に収載されたジャーナルへと向かわせ続けています。実際には、それは次の一点に集約されます。あなたが頭の中で考える言語が英語であるかどうかにかかわらず、英語で書くことです。
ウクライナの研究者のためのAIハマナイザーは、まさにこの「落とし穴」を対象にしています。慎重な学術書き手が整った標準英語で原稿を仕上げ、それをAIチェッカーに通して返ってきた結果が「機械的に書かれた文章」とフラグされるのを見ます。何かを偽造したわけではありません。文章があまりにも正確すぎただけです。このツールは、意味・専門用語・引用をそのまま保持しながら、注意深いノンネイティブの文章が、実際に人が書いたように読めるようにします。生命科学者や臨床家も同じ壁に直面します。
ほとんどのウクライナの研究者はバイリンガルで、ウクライナ語とロシア語を行き来しており、両言語は英語の文章に同種の「痕跡」を残します。それらはエラーではありません。スラブ系の文法を通じて英語を学んだ書き手が残す特徴であり、皮肉にも、その英語をいっそうきれいに整えれば整えるほど、検出器が誤って読み取る可能性が高まります。
ウクライナの研究者のためのAIテキストのハマナイゼーション
私たちのAIテキストのハマナイゼーションは、ウクライナの研究者が、内容と参照を保持したまま自信をもって英語で投稿できるよう支援します。Whether your first language is Ukrainian or Russian, the goal is the same: prose that keeps your argument exactly as you meant it, but no longer trips a detector trained mostly on native English.
私たちは、実際に研究を行っている研究者のためにハマナイザーを構築しました。単に「公平に読まれること」を望む人のためです。まず研究内容の文章を作成します。ツールは文のリズムや語彙の選び方を変化させ、機械が入り込みやすい、いわゆる「機械的な間」の流れを滑らかにし、あなたが言いたかったことを正確に保ったまま、それでいて人間らしく読める声で書いたような文章を手渡します。
ウクライナ語で書いていますか? 自動検知され、人間が書いたようにネイティブに整えられます
多くのウクライナの研究者は、英語で書き起こす前にウクライナ語で下書きを作り、それをAIハマナイザーが直接扱います。ウクライナ語のテキストを貼り付けると、ProofreaderPro はキリル文字の表記を認識し、それをロシア語と区別したうえで、言語に配慮したモデルにより処理します。これにより、専門用語と引用は書かれたとおりに維持されます。гуманізація AI-тексту を通じて、あなたのウクライナ語の下書きは、英語と同様にすぐに人間らしく整えられます。最初に翻訳する必要はありません。同じ検出範囲は60以上の言語に及び、それぞれの言語が持つ独自の声で書き換えられます。
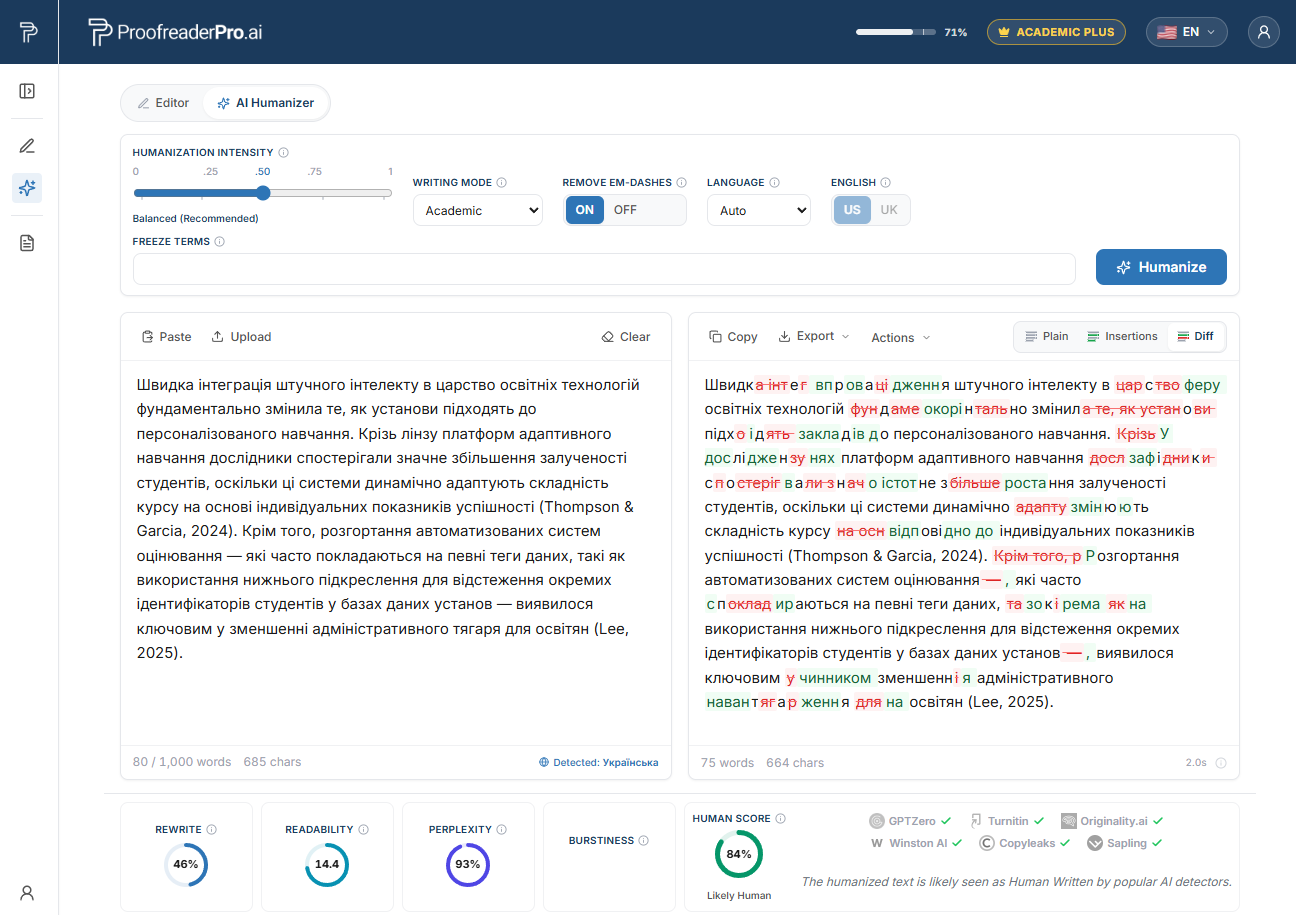
ProofreaderPro AIハマナイザーがウクライナ語の学術テキストを書き換える様子。before and after diff は意味と引用を維持し、検出チェックにより自然で人間らしい読みが確認されます。
なぜウクライナの研究者はAI検出器でフラグされるのか
最も明確な根拠は、Weixin Liang と共同研究者が率いた 2023 年のスタンフォード研究です。Cell Press のジャーナル Patterns に掲載されました。チームは、人が書いた TOEFL のエッセイを、広く使われている7つのAI検出器に通しました。その結果、平均では、ノンネイティブのエッセイの約61%が「AI生成」とフラグされました。一方で、ネイティブ英語の書き手では約5%でした。さらに、ノンネイティブのエッセイのうち5分の1未満にあたる約19.8%が、すべての検出器によって満場一致でフラグされました。すべてのエッセイは人間によって書かれていました。
では、なぜこのようなことが起きるのでしょうか。多くの検出器は、いわゆる「パープレキシティ(perplexity)」をスコアリングします。これは、次に来る語が言語モデルにとってどれほど「意外」かを測る指標です。第二言語で注意深く書くと、よく使われる語や安全で予測可能な言い回しに頼りがちになります。その結果、パープレキシティが低くなります。そして、パープレキシティが低いことこそが、検出器にとっては「機械が書いた文章」として読み取られるまさにその条件です。ウクライナ語、英語の組み合わせで、英語が明確で正確になるようにする習慣は、これらのシステムが「疑うように」学習されてきた習慣と同じものです。
したがって、フラグはあなたの誠実さに対する判決ではありません。ツールの仕組みに起因する統計的なアーティファクトです。詳細なメカニズムは、なぜAI検出器はノンネイティブな文章をフラグするのか で説明します。赤いスコアをどう扱うべきかも変わります。つまり「告白」ではなく「反証すべき主張」として受け止めるのです。
誤フラグの背景にあるウクライナ語・ロシア語の第一言語パターン
スラブ系の文法は英語と、いくつかの構造的な点で異なり、それぞれが英語を、検出器が罰する「平板で予測可能なレジスター」へと押し出します。これらはどれも間違いではありません。慎重に組み立てられた構文であり、その標準性そのものが問題なのです。
冠詞なし(No articles)。 ウクライナ語にもロシア語にも「the」や「a」はないため、英語の冠詞は落とされたり、追加されたり、割り当て直されたりします("result was significant"、"we studied the influence of the temperature")。編集者がこれらを整えると、訂正後の文は滑らかで一般的になります。すると読みはパープレキシティの低さとして現れます。
時制ではなくアスペクト(Aspect instead of tense)。 スラブ語の文法は、英語の時制体系というより、完了相・未完了相のアスペクトに基づいて構築されています。そのため、完了時制と単純過去の選択が一貫しない形で出てきます。これを修正すると、短く、教科書的で素直な文が作られやすくなります。
語順の柔軟さ(Flexible word order)。 格語尾がウクライナ語・ロシア語では意味を担うため、語順を自由に動かせます。英語に移すと、情報構造が少し不自然に着地し、最も安全な修正は最も慣習的な語順になり、結果的に最も機械的な並びになります。
可算名詞と不可算名詞(Countable and uncountable nouns)。 "informations"、"researches"、"an equipment"、"evidences" のような形は、元の言語から自然に引き継がれます。修正されると、数百万の学習例に現れる標準的な「集合名詞(マス名詞)」の語法へと収束します。
前置詞の転移と、欠けた助動詞(Preposition transfer and the missing auxiliary)。 前置詞は言語間で対応が異なり、英語の助動詞 "do/does" に直接の等価物がないため、編集の段階でどちらも標準化され、やはり最も素朴な形へと寄っていきます。
音訳(Transliteration)。 キリル文字から引き継がれた固有名詞や専門用語は、慣習的な英語表記へと正規化されます。これもまた、均一性に向かう小さな一歩です。これらをすべて合わせると、「きれいで正しく、分散が小さい(低バリアンス)」文章が得られます。それは、検出器が「人工的」とスコアするまさにそのプロフィールです。
ウクライナにおけるAI検出と Turnitin の文脈
類似度スクリーニングは、ウクライナの高等教育機関で日常的に行われており、その上にAIスクリーニングが到来しつつあります。多くの大学は Unicheck を運用しています。Unicheck は実際にウクライナで構築され、現在 Turnitin の一部になっています。別の大学では StrikePlagiarism を利用しています。学位論文や原稿を提出する場合は、人が細かく精読する前に、これらのいずれかを通過すると考えてください。
教育科学省(MES)および各機関は、学術的誠実性とAIに関するガイダンスを出しており、全体としての方向性は禁止ではなく「開示」です。資金提供者やジャーナルは、論文作成の際にAIをいつ・どのように使ったのかを、ますます求めるようになっています。
この状況は、正直に取り組めば対処可能です。人間らしく整える目的は、AIの使用を隠すことや Unicheck を騙すことではありません。目的は、ツールの偏りによって真の研究が罰せられないようにすることです。そして、そのうえで、大学および対象ジャーナルが求めるとおりにAIの使用を正確に開示することです。
ウクライナの主要大学と、AIチェックが登場する場所
以下の機関は、学位論文や原稿について類似度とAI指標のスクリーニングを行い、後者の比重が年々高まっています。これらのいずれかで働いている、あるいは在籍している場合、類似度とAIのチェックは、審査を経て学位を取得する、または提出論文を通すための通常のプロセスの一部になっています。
- キївський національний університет імені Тараса Шевченка (Taras Shevchenko National University of Kyiv)、Kyiv
- Національний технічний університет України «Київський політехнічний інститут імені Ігоря Сікорського» (Igor Sikorsky Kyiv Polytechnic Institute, KPI)、Kyiv
- Харківський національний університет імені В. Н. Каразіна (V. N. Karazin Kharkiv National University)、Kharkiv
- Львівський національний університет імені Івана Франка (Ivan Franko National University of Lviv)、Lviv
- Національний університет «Львівська політехніка» (Lviv Polytechnic National University)、Lviv
- Сумський державний університет (Sumy State University)、Sumy
- Національний університет «Києво-Могилянська академія» (National University of Kyiv-Mohyla Academy)、Kyiv
- Дніпровський національний університет імені Олеся Гончара (Oles Honchar Dnipro National University)、Dnipro
これらの大学に共通するワークフローは似ています。あなたの下書きは、委員会に出される前に自動チェックを通過します。そのチェックが実際に何を測っているのかを理解しておけば、パニックではなく落ち着いてフラグに対応できます。
ウクライナの研究者向けAIハマナイザーはどのように機能するか
誠実なワークフローは4つのステップから成り、開示はその一部であり、後付けではありません。
まず、研究内容を下書きします。多くのウクライナの研究者は、最初にウクライナ語またはロシア語で主張を考え、その後で翻訳します。これはまったく問題ありません。読み方の心配の前に、論理の筋を正しくすることが大切です。
次に、文法を校正して英語が正しく、専門用語の表記が一貫するようにします。整った文法と自然な声は別のものです。両方を手に入れたいのです。
3つ目として、自分のAI支援による文章を テキスト・ハマナイザー にかけます。文のリズムや語彙の選び方が変化し、機械や入念に編集された第二言語の文章に共通する反復的な「間」を取り除きます。さらに、意図しないダッシュを削除しつつ、意味、技術的な語彙、そしてすべての引用を保持します。私たちのハマナイザーは60以上の言語をサポートしているため、英語以外のテキストは言語に配慮したモデルにルーティングされ、文構造と意味を崩して「ぐちゃぐちゃにする」のではなく、そのまま維持します。
結果として、何を期待できますか? 私たち自身のテストでは、ハマナイズによって、注意深く標準的なノンネイティブ英語が主要な検出器(Turnitin、Originality.ai、GPTZero を含む)で誤って読み取られる頻度を大幅に下げることができました。一方で、あなたの学術的な意味は変わりません。これは約束ではなく、テストで見られたこととして説明しています。検出器は数か月ごとに再学習され、誠実なツールが「100%検出されない」と主張できることはありません。そう保証する人は、存在しない確実性を売っているだけです。
4つ目は、開示です。所属機関やジャーナルが求める形式でAIの使用に関する記述を追記し、あなたの仕事が誠実性のルールの範囲内で明確に保たれるようにします。これがすべての目的です。偏ったツールから実在する研究を守り、何かを偽装することではありません。ウクライナは私たちの 多言語AIハマナイズ・ハブ の一拠点です。もし論文に完全な言語編集も必要であれば、グローバルな学術編集ハブ が、そのプロセスの側面についても説明します。
ローカルの資金助成機関、ジャーナル、そしてAI開示に対する期待
ウクライナの研究は、いくつかの中核的な機関を通じて資金提供され、組織化されています。ウクライナ国立研究基金(NRFU、Національний фонд досліджень України)は競争的助成を運営します。ウクライナ国立科学アカデミー(NAS、НАН України)は国レベルの研究所を監督します。教育科学省(MES)は、収載出力への後押しを含む、研究と出版に関する方針を定めています。
この後押しは具体的です。国家方針は、Web of Science および Scopus に収載されたジャーナルでの出版を評価し、そのため英語で書くプレッシャーは年々高く維持されます。そうしたジャーナルを狙う場合、類似度スクリーニングが当然の手続きであること、そして提出時にAI使用の開示を求めるジャーナルが増えていくことを見込んでください。
その期待に真正面から応えてください。何を使ったかを明記し、記録をきれいに保ち、人間らしく整えられた下書きにより、あなた自身の主張を自然な声で届けましょう。もし誤りだと考えるフラグが届いた場合は、不承認の後ではなく、次の提出の前に テキスト・ハマナイザー にもう一度頼ることで、証拠に基づいて反論できる主張として扱ってください。
よくある質問
Q: ウクライナの研究者向けAIハマナイザーの使用は不正行為に当たりますか?
いいえ、正直に使うのであれば違います。あなたは、偏った検出器から注意深いノンネイティブの文章を守るために、自分自身のAI支援による下書きを人間らしく整えているのであって、結果を捏造したり、著者性を隠したりしているわけではありません。意味と引用を保持し、そのうえで、大学やジャーナルが求める形式でAIの使用を開示します。
Q: ハマナイザーは私の専門用語や引用を変えますか?
いいえ。ツールは、あなたが書いたとおりに、学術的な意味、技術的な専門用語、そしてすべての参照を保持するように設計されています。内容の周りで文のリズムや語彙の選び方を変えるため、あなたの手法、用語、引用番号はそのまま維持されます。
Q: гуманізація AI-тексту(AIテキストのハマナイゼーション)は、ロシア語話者のウクライナの研究者にも機能しますか?
はい。ウクライナ語とロシア語は多くの文法的特徴を共有しており、不在の冠詞やアスペクトに基づく動詞のように、英語の文章に同種の痕跡を残します。ハマナイザーは、非英語およびノンネイティブのテキストを言語に配慮したモデルにルーティングするため、どちらの言語がより得意であるかにかかわらず役立ちます。
Q: どのツールでも、論文がAI検出器に通ることを保証できますか?
いいえ。そして「通る」と主張する相手は信用しないでください。検出器は絶えず再学習されており、誠実なツールが100%検出されないことを約束することはできません。私たちが言えるのは、私たちのテストでは、注意深いノンネイティブ英語が誤って読み取られる頻度を大幅に下げられた、ということだけです。これは保証とは別の、より誠実で、しかし異なる主張です。
Q: 私の学位論文が、大学の Unicheck または Turnitin でフラグされました。どうすればよいですか?
スコアを「判決」ではなく「反証すべき主張」として扱ってください。あなたのプロセスの証拠として、下書きやメモを保管します。文章は自分で書いたものを人間らしく整えて自然に読めるようにし、AIの使用は所属機関の方針に従って開示してください。検出器のフラグは対話の始まりであり、終わりではありません。
言語に配慮しながら、意味, 用語, 引用を保持し、慎重に書かれた非ネイティブの文章を人が書いたように読みやすくする人間味付け機能です

Moe は、自然言語処理の PhD を持つ NLP エンジニアです。 彼の研究は計算言語学、テキスト分析、機械学習をカバーしており、それは ProofreaderPro の背後にある編集および人間化モデルに直接反映されています。 彼は、ほとんどの人が目にすることのないプロセスの部分、つまり言語モデルがどのように文を読み取り、スコアを付け、何を変更するかを決定するかについて書いています。


