
英語で執筆するパキスタン人研究者向けAIヒューマナイザー
パキスタン人研究者のためのAIヒューマナイザー。ウルドゥ語の影響を受けた英語における誤ったAI検出フラグを減らし、意味と引用を保ちつつ、正直に開示します。

パキスタンはNature Indexで43位に位置し、現在同国の262の大学がScopusに収録された研究成果を増え続ける形で公表しています。イスラマバードやカラチの研究室で行われる作業の多くは、いまやChatGPT、Claude、そしてその他のAIアシスタントの支援を受けて書かれています。ここまでは、もはや珍しい話ではありません。問題は、その次に何が起こるかです。
パキスタン人研究者向けのAIヒューマナイザーは、「不公平さ」を是正するために存在します。AI検出ツールは、母語ではない学術研究者が慎重かつ正確に書いた英語を、機械生成として頻繁にフラグ付けします。しかも、そのアイデア、データ、引用がすべて著者自身のものであってもです。クワイド・アザム大学の研究者であれば、手作業で丁寧な方法(methodology)セクションを書き、投稿前に検出ツールにかけてみることができます。そして「likely AI」と表示されるのを目の当たりにするのです。何かを偽装したわけではありません。単に、その英語が標準的すぎただけです。
パキスタンはEF English Proficiency Indexで493点を獲得し、「Moderate Proficiency」帯で世界67位にランクされています。英語は公用語で、多くの大学で教授言語になっています。それでも、授業用の英語と、出版に耐える学術英語の間には大きなギャップがあります。このギャップと、それが生み出す低いパープレキシティ(低い驚きの度合い)の文章こそが、人間化(ヒューマナイズ)によって守られるべき対象なのです。
英語で執筆するパキスタン人研究者向けAIヒューマナイザー(پاکستانی محققین کے لیے اے آئی ہیومنائزر)
اے آئی ہیومنائزر پاکستانی محققین کی مدد کرتا ہے کہ وہ اپنی تحقیق کو بین الاقوامی جرائد میں شائع کر سکیں۔ 私たちのヒューマナイザーは、パキスタン人研究者(پاکستانی محققین)が英語で出版できるように、彼ら自身のAI支援ドラフトを手直しし、丁寧で標準的な第二言語としての文章が、機械のテキストとして誤読される可能性を下げます。
私たちのtext humanizerは、意味、専門用語、そして引用(APA、MLA、Chicago、IEEE)をそのまま保持します。文のリズムや語の選び方を変え、検出ツールが見逃さない反復的なカデンツ(リズム)を取り除き、混入したemダッシュを削除します。60以上の言語に対応しているため、ウルドゥ語の影響を受けた学術文を、下にある主張を失わずに自然な英語へ整えることができます。
ウルドゥ語が第一言語?ネイティブに自動検出され、人間化されます
パキスタンの多くの研究者は、英語で書き上げる前にまずウルドゥ語で下書きを作り、その後に英語でまとめます。ヒューマナイザーは、その流れをそのまま扱います。ウルドゥ語のテキストを貼り付けると、ProofreaderProが右から左への文字体系を自動的に認識し、さらに言語に配慮したモデルで処理します。その際、用語や引用は、書かれている通り正確に維持されます。اے آئی ہیومنائزرは、英語と同じ自然さで、ウルドゥ語のドラフトに作用するため、先に翻訳する必要はありません。自動検出は60以上の言語に対応しており、それぞれが固有のレジスターで人間化されます。
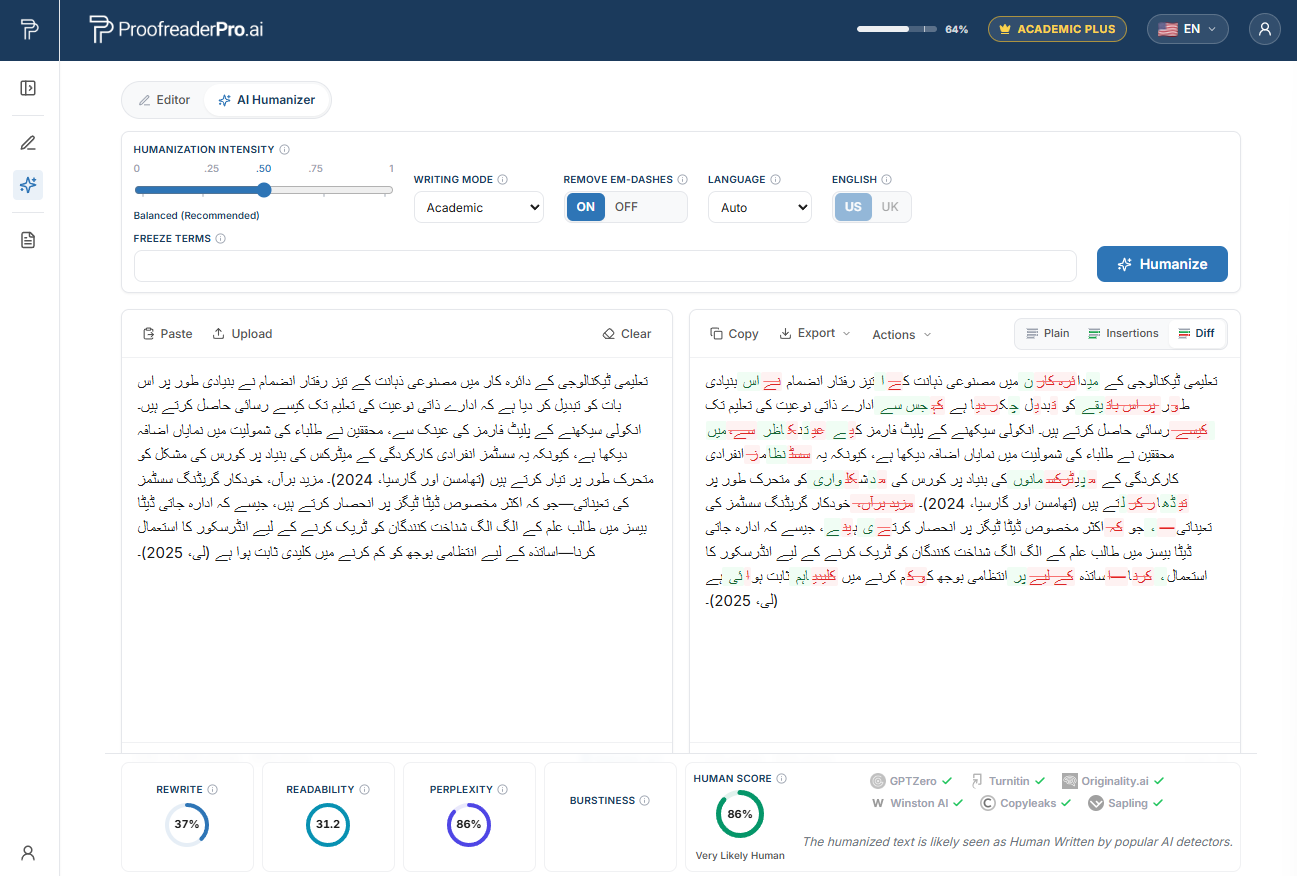
ProofreaderPro AI Humanizerがウルドゥ語の学術テキストを書き換える様子。ビフォー/アフターの差分が意味と引用を保持し、検出チェックが自然で人間らしい読みを確認します。
なぜパキスタン人研究者はAI検出でフラグを立てられやすいのか
2023年、Stanfordの研究チーム(Liangら)がCell Press誌Patternsに、「GPT detectors are biased against non-native English writers」というタイトルの研究を発表しました。そこでは、人手で書かれたTOEFLのエッセイを、広く使われている7種類のAI検出ツールに通しました。平均すると、非母語のエッセイの約61%がAIとしてフラグ付けされたのに対し、母語英語のライターでは約5%でした。非母語のエッセイの5件に1件弱(約19.8%)は、すべての検出ツールで満場一致でフラグ付けされています。もちろん、これらのエッセイはすべて人間が書いたものです。
これは「パープレキシティ」として知られる現象です。これらのツールの多くは、各語の選び方が言語モデルにとってどれほど意外かを順位付けします。熟練した第二言語のライターは、一般的な語や、慣習的で予測可能なフレーズを使おうとします。するとパープレキシティが低くなり、それが機械的なテキストのように見えてしまいます。ツールは、パキスタンの学術文を明確で正確にするのと同じ癖、つまり、まさにその特徴、を検出するよう訓練されていたのです。
だからこそ、検出スコアは「判決」ではなく「争うべき主張」です。すでに複数の機関が、これらのツールから距離を置いています。Vanderbiltは2023年に、誤検知と非母語話者に対する偏りを理由に、TurnitinのAI検出機能を無効化しました。Michigan State、UT Austin、Northwestern、Pittsburgh、SMU、Waterlooも同様の措置を取りました。Turnitin自身も、1〜19%の範囲におけるスコアを抑制し、件数だけを単独で整合性(integrity)の判断に使うべきではないと警告しています。全体像はwhy AI detectors flag non-native writersで説明しています。
誤検知を生みやすいウルドゥ語(第一言語)由来のパターン
パキスタンの国民言語であるウルドゥ語は、インド・アーリア語派に属しており、英語とは文法構造が異なります。ウルドゥ語に加えて、研究者はパンジャブ語、シンド語、パストゥー語、バローチー語からも影響を受けます。これらの言語からの移し替えパターンは正しく、注意深い構文として、かつては英語に整えられてきました。その「標準性」こそが、検出器にとっては低いパープレキシティとして読まれるのです。以下は、誤検知(false flag)を最も起こしやすいパターンです。
冠詞の扱い(Article handling)。 ウルドゥ語には、不定冠詞・定冠詞の体系がありません。英語の「the」「a」「an」に直接対応するものがないためです。パキスタン人ライターがここを修正すると、結果として冠詞の使い方が非常に規則的になり、教科書のような使用パターンになりがちです。パキスタンの研究者の70%以上がこの領域で困難を感じており、慎重でルールに沿った修正は検出器には平板で予測可能なものとして映ります。
語順(Word order)。 ウルドゥ語は、主語、目的語、動詞(Subject-Object-Verb)の語順に従います(「Maine kitab parhi」は、文字どおり「私は本を読んだ」と訳せる内容で、「I book read」に近い形になります)。これは英語の逆です。上級者はこれを、きれいな正統的(canonical)な英語のSVO文に修正します。きれいで正統的であること、それ自体が機械らしさとしてスコアリングされます。
前置詞(Prepositions)。 ウルドゥ語では、名詞の後に置かれる後置詞が用いられ、その意味範囲は英語の前置詞と一致しません。書き手は、最も安全で一般的な前置詞の選択に寄りかかることで補います。すると、段落全体にわたり語彙の意外性(lexical surprise)が下がります。
時制の一貫性(Tense consistency)。 英語は、過去・現在・未来のそれぞれの中で、単純形、進行形、完了形、完了進行形を重ねて使うことができますが、ウルドゥ語にはそうした重なりがありません。規範を習得したパキスタン人研究者(方法には過去形、確立した知見には現在形)ほど、それを非常に不自然でない規則性をもって適用する傾向があります。そして、その規則性が統計的なパターンとして検出されます。
主語、動詞の一致(Subject-verb agreement)。 ウルドゥ語の動詞は、性や数において主語と一致しますが、そのパターンは英語とは異なります。注意深い書き手は、長い学術文の中で一致を二重に確認し、その結果として、パープレキシティモデルが「疑わしい」と見なす非常に均一な構造が生まれます。
これらは、正しく修正された後にはエラーではありません。規律ある標準的な英語の目印であり、人間化(ヒューマナイザー)が対処するよう設計された不公平さはまさにここにあります。
パキスタンにおけるAI検出とTurnitinの文脈
パキスタン国内の学位論文やジャーナル投稿は、類似度チェックとしてTurnitinまたはiThenticateでスクリーニングされることが一般的で、AI指標がそれらの類似度スコアに並んで表示されるケースが増えています。ほとんどのパキスタン人の博士課程候補者にとって、Turnitinレポートは学位取得までの通常のチェックポイントであって、特別な出来事ではありません。
公開(publish)への圧力は強烈です。Higher Education Commission(HEC)の大学ランキングの評価基準には、研究成果が41%の割合で組み込まれています。HECのTenure Track Systemは、キャリア存続の手段として、継続的な国際的な出版を重視します。Journal Citation Reportsにインパクトファクターとともに収録されるWカテゴリーのジャーナルは、より大きな比重を持ちます。Web of Scienceに収録されたパキスタンの学術誌は33誌しかないため、研究者は圧倒的に国外で発表せざるを得ず、そこでの「母語レベルの英語」が標準だとみなされます。
開示(disclosure)の風潮も同時に変化しています。助成機関、大学、そしてジャーナルはますます、著者に対して、原稿作成にAIツールがどう使われたかを明記するよう求めています。こうした流れに対して筋のよい対応は、AI支援を隠すことではなく、責任をもって活用し、申告することです。ヒューマナイザーは、その期待の中に収まるのであって、その外側に回避するためのものではありません。
ご自身の文章を誤ったAIフラグから守る
意図、用語、引用をそのまま保ちつつ、ご自身のAI支援による下書きをHumanizeします。慎重な非ネイティブ学術英語向けに設計され、その後、ジャーナルが求める方法で開示します。
Humanizer を無料でお試しパキスタンの主要大学と、どこでAIチェックが見られるか
パキスタンの262の大学は、研究生産に強いところから教育重視の機関まで幅があります。以下の主要校はいずれもHECのテニュア・トラック要件およびWカテゴリー要件のもとで運用しており、すべて学位論文や原稿を類似度およびAI指標の観点からスクリーニングします。
- クワイド・アザム大学(Quaid-i-Azam University (QAU)、イスラマバード。パキスタン最高位の研究大学で、物理、化学、生物、地球科学が強み。
- 国立科学・技術大学(National University of Sciences and Technology (NUST)、イスラマバード。電気工学、コンピュータサイエンス、機械工学で先導的。
- パンジャブ大学(University of the Punjab)、ラホール。パキスタンで最大かつ最古の大学(1882年設立)。幅広い研究ポートフォリオを有する。
- 管理科学大学(Lahore University of Management Sciences (LUMS)、ラホール。パキスタンを代表する私立の研究大学で、経済、ビジネス、コンピュータサイエンスが強み。
- 農業大学ファイサラバード(University of Agriculture Faisalabad (UAF)、ファイサラバード。作物・獣医学の分野が強い、農業研究のトップ大学。
- COMSATS University Islamabad、複数キャンパス。コンピュータサイエンス、薬学、環境科学で強い成果。
- パキスタン工学・応用科学研究所(Pakistan Institute of Engineering and Applied Sciences (PIEAS)、イスラマバード。核工学・システム工学と応用物理を中心に据えたエリート機関。
- 工学技術大学(University of Engineering and Technology (UET)、ラホール。パキスタン最古の工学大学で、土木、機械、電気の研究が強い。
- ペシャワル大学(University of Peshawar)、ペシャワル。カイバル・パフトゥンクワ州の主要研究大学で、地質学と化学が強み。
- アガ・カーン大学(Aga Khan University)、カラチ。臨床医学、看護、公衆衛生で評価される、パキスタンを代表する医学研究大学。
- カラチ大学(University of Karachi)、カラチ。国内でも最大級の大学の一つで、海洋科学、薬理学、化学が強み。
- イスラマバード国際イスラム大学(International Islamic University Islamabad (IIUI)、イスラマバード。イスラム研究、法学、社会科学で特筆され、自然科学分野の成果も伸びている。
これらの機関のいずれにおいても、大学院生や教員は、真に独創的な仕事を生み出しながら、スクリーニング段階でAIフラグが立つことがあり得ます。下記のワークフローは、その瞬間のために構築されています。
パキスタン人研究者向けAIヒューマナイザーはどう機能するか
パキスタン人研究者向けAIヒューマナイザーは、整合性(integrity)を迂回する近道ではなく、ワークフローの最後のステップです。私たちが推奨する手順は次の通りです。
まず、下書き。推論の流れがウルドゥ語の方が自然なら、そこに書いて英語へ翻訳します。または、AIアシスタントを使って英語で直接下書きを作ります。いずれにせよ、アイデアと根拠はあなた自身のものです。
次に、文法を整えます。ウルドゥ語の移し替えによって生じる冠詞、前置詞、時制、一致のパターンを修正し、科学的な内容がすっきりと読める形にします。当社の学術テキストにおける文法精度は96%以上です。
次に、あなた自身のAI支援文を人間化します。text humanizerは、文のリズムや語の選び方を変え、検出器が注目する反復的なカデンツを取り除きます。そのうえで、意味、専門用語、そしてあらゆる引用を保持します。主要な検出器でテストすると、AIテキストをより自然な人間の文章へと書き換え、AIシグナルを低下させ、手強い検出器に対する通過可能性を高めます。これは保証ではなく、テスト結果によるものです。検出器は数か月ごとに再学習されるため、私たちは「完全で恒久的に見えなくなる」とは決して約束しませんし、チェックをすり抜ける方法として提示することもありません。
最後に、開示します。機関や投稿先ジャーナルが求める形式に従って、AIをどのように使ったかを明記してください。丁寧な執筆と明確な開示の組み合わせによって、ルールの範囲内に収めながら、誤検知によるフラグから標準的な非母語英語を守ることができます。
本ヒューマナイザーには、編集(editing)の相棒があります。原稿が人間化の前に修正を必要としている場合は、まずパキスタンの研究者向けアカデミック編集から始めてください。国別の全体的なクラスターは多言語AIヒューマナイザーのハブをご覧ください。
地域の資金提供機関、学術誌、そしてAI開示に関する期待
パキスタンの多くの研究者は、Higher Education Commission(HEC)の枠組みのもとで活動しています。これは主要な資金提供機関であり、枠組みを定める主体でもあります。HECにはTenure Track SystemとWカテゴリーのリストがあり、昇進、テニュア、PhD修了に向けて活用できる出版物が列挙されています。一般に、言語編集はHECの助成金枠組みにおける容認された研究コストとみなされます。特定の助成条件は確認してください。ただし、人間化(ヒューマナイザー)のサブスクリプションは、通常、適格な学術執筆支援の範囲に収まります。
パキスタンの複数のジャーナルは実際の国際的評価を獲得しており、英語品質とAI開示に関する編集方針の期待は、国際的な基準に歩調を合わせて高まっています。
- Pakistan Veterinary Journal。Q1ランキングを持つ、パキスタン最高インパクトのタイトル。
- Pakistan Journal of Medical Sciences (PJMS)。臨床医学、外科、公衆衛生をカバー。
- Pakistan Journal of Botany。アジアでも最古級の植物学系ジャーナルの一つ。
- Journal of the Pakistan Medical Association (JPMA)。1953年に設立され、国内で最も古い医学雑誌。
- Pakistan Journal of Pharmaceutical Sciences。製薬研究と創薬開発をカバー。
- Pakistan Journal of Agricultural Sciences。南アジアの農業システムに関連する研究をカバー。
これらのジャーナルに投稿する場合でも、海外のWeb of Science収録誌に投稿する場合でも、原則は同じです。編集者はますます、AIをどのように使ったかについて短く簡潔な注記を求めるようになっています。書き添えれば、英語は「パープレキシティの点数」ではなく、その実質によって評価されます。
よくある質問
Q: パキスタン人研究者向けのAIヒューマナイザーは不正行為(cheating)に当たりますか?
いいえ。あなた自身のAI支援ドラフトを人間化し、そのうえでAIが使用されたことを開示する限りにおいて、という条件付きです。目的は、慎重で独創的な非母語の文章を、機械テキストとして誤読されないように守ることです。偽装された仕事を隠したり、他人の文章だと偽って主張したりするためではありません。意味と引用を保ち、AI使用を申告することが、機関やジャーナルのルールの範囲内に留まるための要点です。
Q: ヒューマナイザーは私の引用や技術用語を変えますか?
いいえ。ヒューマナイザーは、あなたの参照文献(APA、MLA、Chicago、IEEE)と、分野固有の専門用語を保持します。文のリズムや語の選び方を変え、反復的なカデンツを取り除きますが、主張の実質や情報源には触れません。
Q: 私の論文がTurnitinやGPTZeroに確実に通ることを保証できますか?
いいえ。これを約束するツールは信用しないでください。主要な検出器でテストすると、当社のヒューマナイザーはAIテキストをより自然な人間の文章へ書き換え、AIシグナルを下げ、手強い検出器に対する確率を高めます。ただし、特定の結果を保証できるツールはありません。検出器は頻繁に再学習されるため、確実な「合格率の固定」を約束できる信頼できるサービスは存在しません。
Q: ウルドゥ語の影響を受けた英語でも使えますか?
はい。ヒューマナイザーは60以上の言語に対応し、非英語やウルドゥ語の影響が強いテキストを、言語を理解したモデルを通して処理します。文の構造と意味を保持しつつ、自然な学術英語へなめらかに整えます。
Q: 検出器が、それでも私の正真正銘の作業にフラグを立てた場合、私は何をすべきですか?
スコアを「判決」ではなく「争うべき主張」として扱ってください。ドラフトやメモを保ち、実際に使ったAIをオープンに開示し、執筆プロセスを説明できるようにしておきましょう。単一の検出器番号だけでは不正の証拠になりません。また、多くの機関は、いまやそれだけを単独で使うべきではないと述べています。
AI支援による、ご自身のウルドゥ語の影響を受けた英語を作り直し、引用、用語、意味を保ったまま、編集者や査読者に自然に読めるようにします。主要な検出器でテスト済み、その後、オープンに開示。

Moe は、自然言語処理の PhD を持つ NLP エンジニアです。 彼の研究は計算言語学、テキスト分析、機械学習をカバーしており、それは ProofreaderPro の背後にある編集および人間化モデルに直接反映されています。 彼は、ほとんどの人が目にすることのないプロセスの部分、つまり言語モデルがどのように文を読み取り、スコアを付け、何を変更するかを決定するかについて書いています。


