
英語で執筆するポルトガル研究者のためのAIヒューマナイザー
ポルトガル研究者向けのAIヒューマナイザー。ポルトガルの影響を受けた英語に対する誤ったAI検出フラグを減らし、意味と引用をそのまま保持し、AI利用は率直に開示します。

ポルトガルは規模の割に大きく成果を公表しています。過去20年ほどで、海洋科学・材料・ヘルス・工学におけるアウトプットが急速に伸び、その多くが英語で世界へ届けられています。そこでは、欧州ポルトガル語で考え、下書きする人々が英語原稿を書いているのです。インセンティブは明白です。キャリアや研究ユニットの資金は、Web of ScienceおよびScopusに収載される学術誌に論文を載せることに左右されるため、高インパクトの英語媒体へ書くことへの常時の圧力がかかります。
ここで解決すべき問題が、ポルトガル研究者向けAIヒューマナイザーです。第二言語として英語を丁寧に書き、整って標準的な英語を作ったとしても、AI検出器はその「明瞭さ」を機械的な文章として読み取り、原稿にフラグを立てることがあります。書いているのは人間です。しかしソフトウェアはそれに同意せず、誤検出が1件でも投稿を止めたり、指導教員や編集者との気まずい誠実性に関する会話のきっかけになってしまい得ます。
あなたが実際に書いた内容と、検出器が報告する内容のギャップは、あなたの失敗ではありません。何かを隠すことなく、それを埋めることができます。正直で現実的な道はシンプルです。自分の下書きを磨き、すべての引用とすべての技術用語をそのまま保持し、そして大学や投稿先ジャーナルが求める形でAI利用を開示してください。本ガイドでは、ポルトガル語、英語の書きぶりがなぜ誤読されるのか、そしてそれにどう対処するかを説明します。
欧州ポルトガル語のためのAIテキスト・ヒューマナイザー
ポルトガル語で書いて英語で発表する場合、AIテキスト・ヒューマナイザーは、厳密さ・意味・自分の研究における引用を失わずに、ページ上で自然に見えるよう支援します。
わかりやすく言うと、text humanizer は、あなた自身が書いた英語の下書きを取り、リズムや語句の選び方を変えることで、ポルトガル語→英語の丁寧な表現が自動検出器に誤読されにくくするものです。見解を書き換えたり、情報源を新たに作ったり、あなたの主張を変えたりはしません。すでに書いた文章、またはAIの助けで下書きした文章に対して機能し、参考文献もあなたが配置した場所のまま維持します。
狙いは偽装ではなく公平性です。あなたの科学は本物です。目的は、明確な英語をパターン照合ツールに「機械の文章」と誤って扱われないようにすることです。
欧州ポルトガル語の下書きは検出され、書き換えられる
英語に翻訳する前に、ポルトガル語の下書きをヒューマナイズできます。テキストを貼り付けると、ProofreaderProが言語を自動検出し、その後、ポルトガル語に配慮したモデルへとルーティングします。アクセント、用語、引用をそのまま保持します。AIテキスト・ヒューマナイザーとして、欧州ポルトガル語の文章のリズムを変えつつ、すべての発見と参考文献を保持します。自動検出は60以上の言語にまたがるため、ポルトガル語は英語へ作り替えられるのではなく、ポルトガル語として扱われます。
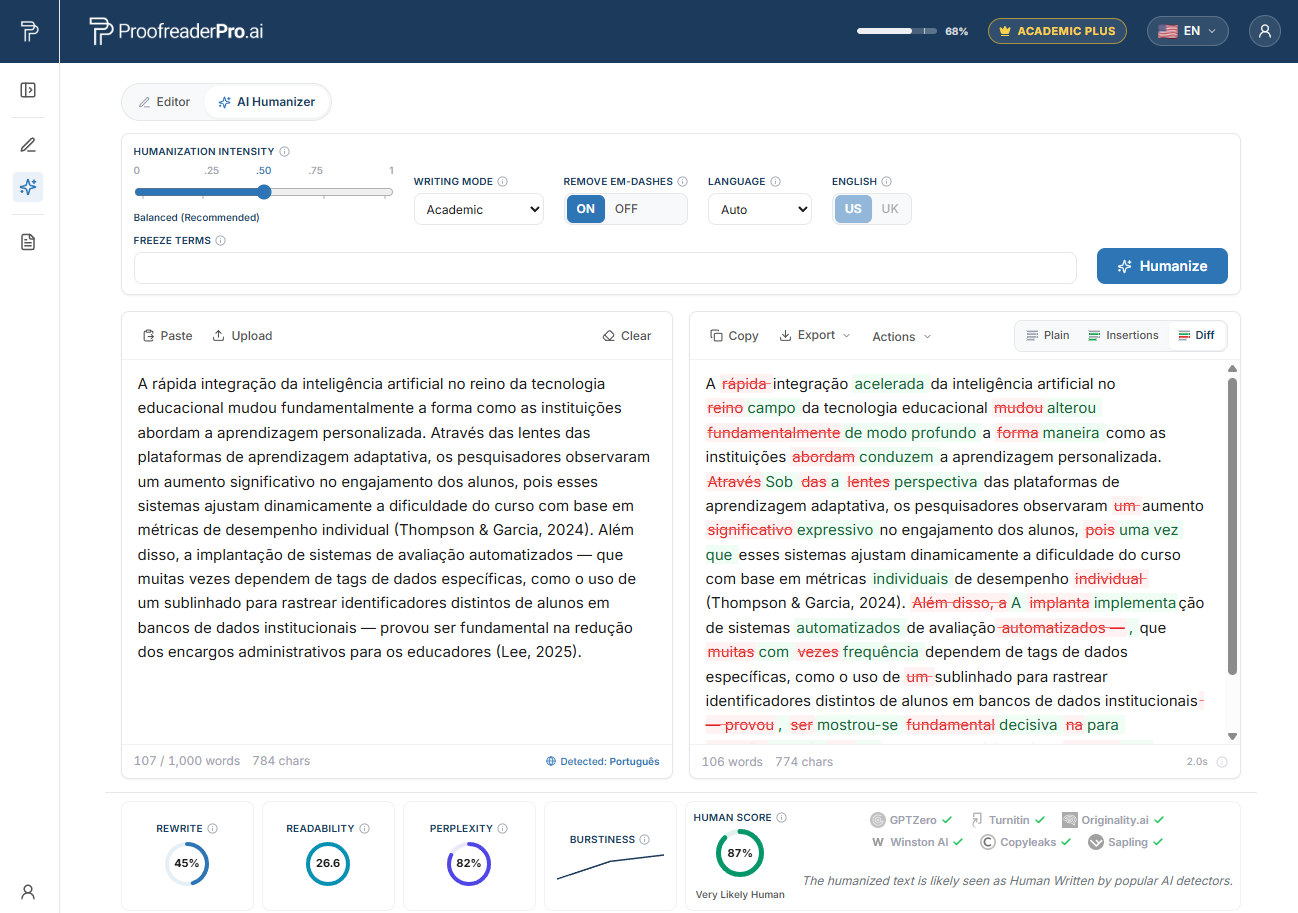
ProofreaderPro AI Humanizerがポルトガルの学術テキストをリライトする様子。ビフォー/アフターの差分は意味と引用を保持し、検出器チェックは自然で人間らしい読みによって確認できます。
なぜポルトガル研究者はAI検出器でフラグを立てられやすいのか
最も明確な根拠は、Liangらによる2023年のStanford研究です。Cell PressのジャーナルPatternsに、「GPT detectors are biased against non-native English writers.(GPT検出器は非ネイティブ英語話者に不利)」という率直なタイトルで掲載されました。チームは、人間が書いたTOEFLのエッセイを、広く使われている7つの検出器に通しました。その結果、平均では非ネイティブのエッセイの約61%がAIとしてフラグ付けされ、ネイティブ英語話者では約5%でした。さらに、5人に1人弱、つまり非ネイティブのエッセイの約19.8%が、すべての検出器によって一致してフラグ付けされました。それらすべてのエッセイは「人が書いた」ものです。
なぜこのように起きるのでしょうか。多くの検出器は「パープレキシティ(perplexity)」という指標をスコア化します。これは、次に来る単語が言語モデルにとってどれほど意外かを測るものです。第二言語で書く人ほど、一般的で安全な語彙や、標準的で予測しやすい言い回しに手が伸びます。するとパープレキシティが低くなり、低パープレキシティはまさにこれらのシステムが「機械生成」として読み取るよう学習した特徴なのです。ポルトガル語、英語を明確で正確にする習慣は、検出器にとっては不審とみなされる習慣と同じです。仕組みの詳細はwhy AI detectors flag non-native writersで詳しく解説します。
賭けの大きさは抽象的ではありません。非ネイティブ英語話者は、すでにネイティブ話者よりも棄却率が約2.5倍高く、論文を書くのに約51%多く時間を費やし、英語を読むのにはおよそ91%多く時間を使い、言語品質に結びついた修正依頼は約12.5倍受け取っています。非英語の投稿を受け入れるジャーナルは7%未満です。誤ったAIフラグは、そのすべての上に降りかかります。
誤フラグの背後にあるポルトガル語の第一言語パターン
以下に挙げる構文はいずれも、通常の意味での誤りではありません。欧州ポルトガル語によって形作られた、慎重で標準的な選択であり、その「標準性」こそが検出器にとっては低いパープレキシティとして読まれるのです。
偽の友(false friends)。ポルトガル語と英語は非常に大きなラテン語系の語彙を共有しており、語彙選択を静かに後押しします。ポルトガル語話者のライターは、「current(現在)」の意味で"actual"、「possible(可能)」の意味で"eventual"、「intend(意図する)」が意図されていたのに、"pretend"(pretender)が入り、「attend(出席する)」の意味で"assist"(assistir a)、あるいは「carry out(実行する)」の意味で"realize"(realizar)を使ってしまうかもしれません。語が正しく着地する場合であっても、こうした安全な同族語への引力が、文章を予測しやすく低サプライズな言い回しへ平坦化させます。
一般名詞を伴う定冠詞の過剰使用。ポルトガル語では抽象名詞や一般名詞の前に定冠詞を置くため、"a ciência" や "a sociedade" は英語では「定冠詞なし」の場面にも "the science" や "the society" として持ち込まれます。文法的で一貫しており、この種の一貫性は機械のように滑らかだと読まれます。
長く従属節が多い文。ロマンス系の学術スタイルは長い周期文を好みます。主要な動詞が来る前に、複数のアイデアを保持する連続した関係節が積み重なる形です。英語の査読者はそれを密度が高いと呼ぶことが多く、検出器はネイティブが草稿を書いたときの不均一なリズムではなく、安定した均一なケイデンスを検出します。
前置詞の転移(transfer)。ポルトガル語の前置詞は習慣として英語へ対応します。例えば、depender deから"depend of"、consistir emから"consist in"、different fromの代わりに"different of" などです。これは小さな体系的な置換であり、体系的であることは、パープレキシティ・モデルが低スコアで評価するまさにその特徴です。
名詞化と"which"の過剰使用。名詞中心の言い回しを好むことに加え、一般的な接続詞としての"which"、そして"it"の代わりとしての"the same"(o mesmo)が、解析しやすく、測定された形式の文を生みます。検出器にとっては、生成テキストと誤認しやすいタイプの文章です。
きれいなポルトガル語英語が誤読されるのを防ぐ
AIを補助した原稿を人間らしく整え、すべての引用と専門用語を保持したうえで、AIの利用を開示してください。注意深い文章は、機械のものと誤解されるべきではありません。
Humanizer を無料でお試しポルトガルにおけるAI検出とTurnitinの文脈
ポルトガルからの論文やジャーナル投稿は日常的にスクリーニングされます。TurnitinやiThenticateによる類似性チェックは、大学やジャーナルでは標準的な実務であり、AIの指標は、従来の剽窃レポートと並んで、ますます重み付けされるようになっています。ポルトガルの機関で学位論文を提出する場合や、収載されたジャーナルに原稿を投稿する場合は、何らかの自動スクリーニングがあなたのテキストに触れると考えてください。
誠実性(integrity)に関する環境は、罰する方向ではなく責任ある方向へと発展しています。FCTおよび個別の大学が責任あるAI利用のガイダンスを出しており、助成機関やジャーナルも著者に対してAIツールがどのように関与したのかを明示するよう求める動きが強まっています。取るべき現実的な立場は、沈黙ではなく開示です。何を使ったのか説明でき、内容が自分のものであることを示せるなら、検出器のフラグは、受け入れざるを得ない判決ではなく、答えられる主張になります。
検出器ベンダー自身が自社ツールについてどのように語っているかを思い出しておくと役に立ちます。Turnitinは1〜19%の範囲におけるAIスコアを抑制し、硬い数値というよりはアスタリスクを表示し、また自社のスコアだけで誠実性の判断を下すべきではないと警告しています。さらに踏み込んで、AI検出器をオフにした大学もあります。これは検出が無関係になるという意味ではありませんが、フラグが「会話の始まり」であって「会話の終わり」ではないことを意味します。
ポルトガルの主要大学と、AIチェックが現れる場所
以下の機関はいずれも、学位論文や原稿を類似性の観点からスクリーニングします。多くはTurnitinまたはiThenticateを用い、さらに同じレビューの一部としてAIの指標も重み付けされるようになっています:
- Universidade de Lisboa (ULisboa)、リスボン
- Universidade do Porto (UPorto)、ポルト
- Universidade de Coimbra (UC)、コインブラ
- Universidade NOVA de Lisboa (NOVA)、リスボン
- Universidade de Aveiro (UA)、アヴェイロ
- Universidade do Minho (UMinho)、ブラガおよびギマランイス
- Instituto Superior Técnico (IST)、リスボン、ULisboaの一部
- Universidade de Évora、エヴォラ
- ISCTE, Instituto Universitário de Lisboa (ISCTE-IUL)、リスボン
- Universidade da Beira Interior (UBI)、コヴィリャン
- Universidade do Algarve、ファロ
どこに向けて書いても、スクリーニングのロジックは同じです。ツールはあなたの文章にスコアを付けますが、丁寧なポルトガル語、英語は、注意深い人間の作業を誤って表す形でスコアになり得ます。事前にそれを知っておくことが、戦いの半分です。
ポルトガル研究者向けAIヒューマナイザーはどのように動作するのか
率直なワークフローは4つのステップで構成され、その一部として開示が組み込まれています。後付けではありません。
まず、下書きです。英語で書くか、欧州ポルトガル語で考えて下書きし、それを翻訳してもよいでしょう。いずれにせよ、あなたの論理を最も明確に落とし込める方を選んでください。最初の叩き台を作るためにAIアシスタントを使っても構いません。重要なのは、主張・データ・結論があなた自身のものであることです。
次に、文法と用語を校正し、科学が正確になるよう整えます。偽の友や前置詞を正しくすることは、検出器の有無にかかわらず、読者にとって重要です。
そして、自分の下書きをヒューマナイズします。英語を当社のtext humanizerに貼り付けてください。文のリズムと語の選び方を変え、低パープレキシティとして読まれやすい均一なケイデンスをほぐし、繰り返しの表現や不意に混ざるemダッシュのような癖を取り除きます。その一方で、意味・技術用語・引用は保持されます。非英語のテキストは言語に配慮したモデルへルーティングされ、文構造と意味がそのまま保たれます。さらにヒューマナイザーは60以上の言語をサポートするため、ポルトガル語の下書きも英語と同じ注意で扱われます。
このステップで何を期待できますか。私たち自身のテストでは、注意深く標準的な非ネイティブ下書きをヒューマナイズすると、主要な検出器(Turnitin、Originality.ai、GPTZeroおよび類似ツール)に「機械が書いた文章」と誤読される頻度が大幅に下がる一方で、意味と文法はそのまま保たれました。これは、保証ではなく、テストで見えてきた事実として述べています。検出器は数か月ごとに再学習されるため、どのような正直なツールであっても「どんな文章でも100%検出不能」と約束できません。また、そのように主張する製品には注意してください。
4つ目は開示です。AI利用は、あなたの所属機関と投稿先ジャーナルが求める形式で記載します。言語をまたいだこのワークフロー全体をより広く見るには、当社のmultilingual AI humanizer hubをご覧ください。さらに、人による編集の一段も希望する場合は、global academic editing hubが、校正とヒューマナイズがどのように組み合わさるかを説明します。
国内の助成団体、ジャーナル、そしてAI開示の期待
主要な国内助成機関は**FCT (Fundação para a Ciência e a Tecnologia)**で、研究やフェローシップを支援し、Ciência IDの研究者識別子も運営しています。ポルトガルの研究グループは欧州研究会議(ERC)の助成も獲得し、Plan Sに基づくFCT支援研究のオープンアクセスが適用されるため、ポルトガルのアウトプットの大部分はオープンに公開され、広く読まれています。
出版面では、対象はほぼ確実にWeb of ScienceまたはScopusに収載されたジャーナルであり、コピーは国内のオープンアクセス・リポジトリRCAAPに預けられます。こうした場では、AI開示の期待が締まってきています。編集者は、AIツールが草稿作成や編集でどのように使われたかを、著者にますます説明するよう求めるようになっており、助成機関側も同様の方向へ動いています。
この流れを脅威ではなく機会として読み替えてください。短く正直な開示の一文はあなたを守ります。それは、正当な言語支援と不正を切り分けることになり、また検出器のフラグが立っても、あなたが実際に行ったことを率直に説明できることを意味します。自分の文章をヒューマナイズし、それを開示することは、同じ公正なプロセスの両面です。
よくある質問
Q: ポルトガル研究者向けのAIヒューマナイザーを使うことは不正(cheating)と見なされますか?
いいえ。自分の仕事を磨き、その内容を開示している限り、該当しません。結果を捏造したり、他者の文章を横取りして渡したりしていないからです。丁寧なポルトガル語、英語を自然に読みやすい形へ整え、さらにAIがどのように関与したかを所属機関とジャーナルに伝えることになります。これは偽装のための手段ではなく、公正さのためのステップです。
Q: ヒューマナイザーは私の引用や技術用語を維持してくれますか?
はい。ヒューマナイザーはリズムと語の選び方を変えますが、意味・参考文献・分野固有の用語は保持します。参考文献リストと本文中の引用は、あなたが置いた場所のまま維持され、専門語彙はゆるい類義語への置換ではなく、そのまま残されます。
Q: どのツールでも、AI検出器に確実に通ることを保証できますか?
いいえ。そう主張するツールは信用しないでください。検出器は定期的に再学習されるため、誠実なツールでも「通過率の具体的な数値」や「文章が100%検出不能であること」を約束できません。良いヒューマナイザーができること、そして私たちのテストで見えていることは、注意深い非ネイティブの文章が誤ってフラグ付けされる頻度を大幅に下げつつ、あなたの仕事の正確性を保つことです。
Q: 私の明確な英語が、完全に自分自身の文章なのにフラグを立てられるのはなぜですか?
多くの検出器がパープレキシティをスコア化しているからです。パープレキシティは「意外な語の選び方」を評価し、安全で標準的な選択を罰します。第二言語で書く人は一般的な語彙や予測しやすい言い回しを使いがちで、それが低パープレキシティを生みます。Stanfordの研究では、人が書いた非ネイティブのエッセイの方が、ネイティブよりもはるかに高い率でフラグ付けされたことがわかっているため、フラグはしばしば機械による著作ではなく、あなたの文体を反映していると考えられます。
Q: ヒューマナイザーは英語だけでなく欧州ポルトガル語にも対応していますか?
はい。欧州ポルトガル語で下書きを作り、言語に配慮したモデルが文構造と意味を維持するようにすれば、英語へ移行した後も同じ配慮が適用されます。このツールは60以上の言語をサポートしているため、ポルトガル語起点のワークフローは最初から最後まで完全に支えられます。
きれいなポルトガル語英語を、意味、引用、用語をそのままに、自然に読める文章へ。さらに、自信を持ってAIの利用を開示してください。

Moe は、自然言語処理の PhD を持つ NLP エンジニアです。 彼の研究は計算言語学、テキスト分析、機械学習をカバーしており、それは ProofreaderPro の背後にある編集および人間化モデルに直接反映されています。 彼は、ほとんどの人が目にすることのないプロセスの部分、つまり言語モデルがどのように文を読み取り、スコアを付け、何を変更するかを決定するかについて書いています。


