
英語で執筆するオランダ研究者のためのAI Humanizer
オランダ研究者向けのAI humanizer。オランダの影響を受けた英語における誤ったAI検出フラグを減らし、意味と引用を維持しつつ、正直に開示します。

オランダは、地球上のほぼあらゆる国よりも一人当たりで高いインパクトの研究成果を生み出しており、その大半は英語で発表されています。オランダの研究者は毎年EF英語熟達度指数(EF English Proficiency Index)で上位、あるいはそれに準じた順位に位置するため、アムステルダムやデルフト発の原稿は通常、清潔で正確、そして教科書のように文法的です。ところが、そのような「整った」文章をAI検出器が読み取ると、同じ原稿が高い「AI生成」確率として返ってくることがあります。そして、すべての単語を手書きで自ら書いたにもかかわらず、研究者は突然、自分自身に説明を求められるのです。この、オランダ研究者のためのAI humanizerが解決するべき具体的な問題はまさにここにあります。
ここに、身につまされる皮肉があります。英語が上手であるほど、あなたの言い回しは標準的で予測可能になりがちであり、そして現行の検出器が「機械による文章」としてスコアを付けるのは、まさにその“予測可能な言い回し”だからです。強いオランダ英語は、誤検出のフラグから論文を守ってはくれません。むしろ、ある意味ではそれを招きます。
本ガイドでは、なぜそうなるのか、オランダ語が母語の人に見られるどの習慣がそれを引き起こすのか、オランダの大学において類似性評価とAIスクリーニングが実際にどのように機能しているのか、そしてあなた自身の文章を正直に守る方法、すでに作成済みのAI支援下の草稿をhumanizeし、意味と引用をそのまま維持したうえで、所属機関や学術誌が求めるとおりにAI利用を開示する、を説明します。
英語で発表するオランダの研究者向け:オランダ語の原文をAI-tekst humaniseren
当社のhumanizerは、オランダの研究者が英語で書かれた原稿を、丁寧で正しいプローズが誤って「機械文」と見なされることなく公表できるよう支援します。AI-tekst humaniserenの目的は明快です。意味、用語、出典の記載(source references)はそのまま保持しつつ、リズムと語彙選択をより自然にすることです。
Plain Englishで言えば: humanizer は、すでにあなたが書いた草稿、あるいはAIの助けで下書きをした草稿に対して動作します。文のリズムを変化させ、反復的なカデンツをほどき、検出器をつまずかせる“クセ”を取り除きます。ただし、主張、データ、参照文献には一切触れません。非英語テキストの場合は、60以上の言語にまたがって構造と意味を維持する、言語に配慮したモデルを経由します。
オランダ語で書いていますか? 直接自動検知され、人間らしく整えます
人間らしくする前に、草稿を英語へ翻訳する必要はありません。オランダ語テキストを貼り付けるだけで、ProofreaderProが言語を自動検知し、その後オランダ語対応モデルを通します。これにより、あなたの用語、複合語、引用が、書かれたとおりに保持されます。これは、あなたの第一言語に対して行うAI-tekst humaniserenです。オランダ語の草稿は、英語の場合と同じように容易にhumanizeされます。同じ検知範囲は60以上の言語に及ぶため、オランダ語は英語へ平板化されるのではなく、オランダ語のまま書き直されます。
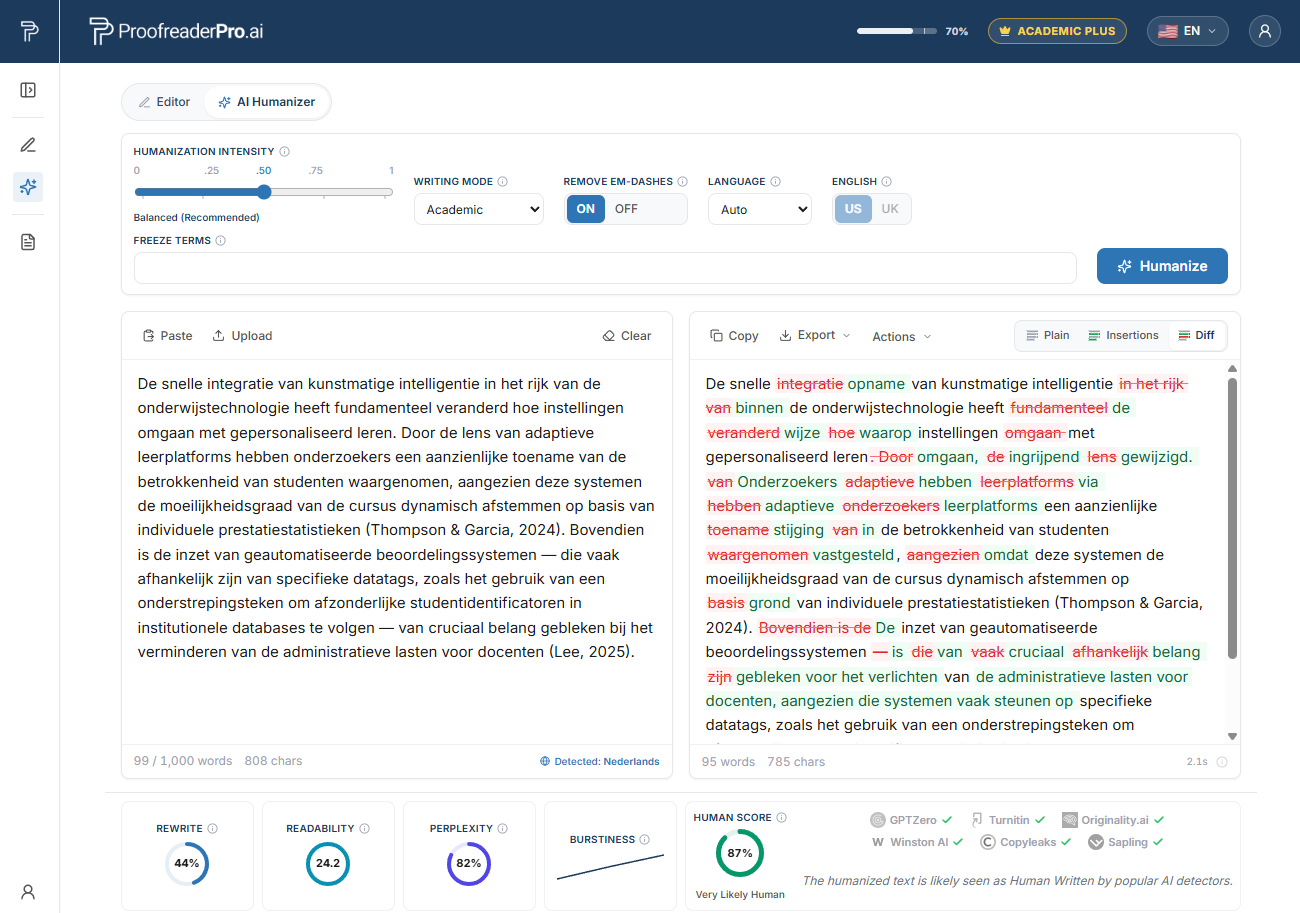
ProofreaderPro AI Humanizerによってオランダの学術テキストを書き換える様子。before/afterの差分により意味と引用が保たれ、検出器チェックは自然な人間の読み取りであることを確認します。
なぜオランダの研究者はAI検出器でフラグを立てられやすいのか
2023年、Weixin Liangが率いるスタンフォードのチームは、Cell Pressの学術誌Patternsに、率直なタイトルの研究を発表しました:「GPT検出器は非ネイティブ英語話者に対して偏りがある」。彼らは、人が書いたTOEFLのエッセイを、広く使用されている7つのAI検出器にかけました。その結果、平均すると非ネイティブのエッセイの約61%がAI生成としてフラグ付けされました。ネイティブ英語話者によるエッセイでは、この数値は約5%です。非ネイティブのエッセイのほぼ5分の1、つまり約19.8%が、すべての検出器によって一斉にフラグ付けされたことも示されています。もちろん、それらは一人の人間がすべてを書いています。
この仕組みを理解する価値はあります。流暢さが“盾”にならない理由を説明できるからです。多くの検出器は「パープレキシティ(perplexity)」と呼ばれる指標をスコア化します。これは、言語モデルにとって各単語選択がどれほど“驚き”をもって扱われるかを測るものです。一般的な語を、標準的で予想される組み合わせで用いる文章はパープレキシティが低くなり、パープレキシティの低さは機械文として読まれやすくなります。丁寧で学術的な作法、特に第二言語で執筆している人ほど、安全で正しいために、明快で定型的な言い回しへと自然に寄っていきます。つまり、読みやすい文章を作るための習慣こそが、検出器が“罰する”ように学習した習慣なのです。
オランダの研究者は、ここでやや厄介な位置にいます。オランダにおける英語の運用能力は非常に高いため、オランダの学術英語は平均的なネイティブ草稿よりもさらに整っており、標準化された傾向があります。この洗練は、パープレキシティをさらに下げます。この力学についてより踏み込んだ説明を、why AI detectors flag non-native writersで詳述しており、オランダの研究に対しては、通常より強い調子で当てはまります。
誤検出フラグの背景にある、オランダ語(第一言語)側のパターン
以下に挙げるパターンは、誤りではありません。正しく、慎重で、標準的な構文です。そして、その“標準的であること”こそが、検出器にとって低パープレキシティで機械的に見える文章になるのです。いくつかの例から、オランダ語の習慣が英語のプローズをどのように形作るかを示します。
オランダ語と英語は語彙を多く共有しており、その結果、信頼できる「誤った類似(false friends)」が生まれます。「Actueel」は“actual”ではなく「現在の(current)」を意味します。「eventueel」は「eventually」ではなく「おそらく(possibly)」です。「controleren」は「to control」ではなく「確認する(to check)」です。こうした落とし穴を避けることを学んだオランダの研究者は、変化を平板化するほど、意図的で慎重な精度で書くことがよくあります。その結果は一貫して正しくなり、一貫性はパープレキシティのシグナルにもなります。
語順も、もう一つの静かな手がかりです。オランダ語では従属節内で有限動詞が第2位に置かれるため、たとえば副詞を前に出した文が、英語では「Therefore is the result significant」や「In this study investigate we the effect」のように表れることがあります。多くのオランダ語話者の著者は投稿前にこれを直しますが、修正後の文章は、生成文に関連づけられる“整った正統(tidy, canonical)”な文構造を生みます。
さらに問題になるのが冠詞です。オランダ語では、普通名詞や抽象名詞の前に定冠詞を置くことが許されるため、草稿には「the research shows」「the society」「the nature of the problem」のような構文が残りがちです。一方、英語では冠詞が省略されることが多くあります。これらは形式的で精密に感じられ、実際にそうでもあります。しかし非常に規則的であるため、やはり一定の反復パターンとして読み取られます。
最後に、もう2つの習慣が全体を完成させます。オランダ語は名詞句を厚くし、名詞化(nominalization)を好むため、「the realisation of the implementation of」のように構文を積み重ねる傾向があります。また「namely(namelijk)」や「respectively(respectievelijk)」のような談話標識にも依存しがちで、さらに査読者が「簡潔すぎる」と時に感じるほど、直接的で率直なレジスターが伴うこともあります。これらはいずれも文法的にはまったく問題ありません。しかしそれらが組み合わさることで、検出器にとって“あなたに不利な”滑らかで驚きの少ない質感が形成されていきます。
ご自身の文章を守りましょう、正直に
意味、用語、引用をそのまま保持しつつ、AI支援の下書きを自然な文章に整えてください。その後、ジャーナルの求める方法でAI使用を開示してください。
Humanizer を無料でお試しオランダにおけるAI検出とTurnitinの文脈
オランダの学位論文や雑誌への投稿は、日常的に類似性チェックを受けます。多くの場合、TurnitinまたはiThenticateが用いられ、機関は以前からの剽窃チェックに加えて、AIの指標もますます重視しています。これは例外というより、いまや投稿プロセスの通常部分になっています。
オランダ大学連合(UNL)および個別の機関は、生成AIに関するガイダンスを発行しており、全体の方向性は明確です。AIツールは多くの作業で許可される一方、その利用は隠すのではなく開示されるべきだ、ということです。助成機関や学術誌も同じ方向に動いており、著者に対して、AIがどこでどのように支援したのかを明記するよう求めています。
また、検出器のスコアが実際にどれほどの重みを持つのかを思い出しておく価値があります。Turnitinは、1〜19%の範囲にあるAIスコアを抑制し、その数値だけを用いて真正性(integrity)の判断を下すべきではないと警告しています。さらに踏み込んだ対応を取っている主要機関もあります。たとえば2023年、Vanderbiltは誤検出と非ネイティブの書き手に対する偏りを理由に、TurnitinのAI検出器を無効化しました。またMichigan State、Northwestern、University of Pittsburghも同等の措置を取りました。検出フラグは、覆い得る“主張”であって、下されるべき“確定的な判決”ではありません。
オランダのトップ大学と、どこでAIチェックが行われているか
スクリーニングはオランダ全体の仕組みの中で行われています。以下の各機関はいずれも、学位論文や原稿について類似性をチェックしており、一般にTurnitinまたはiThenticateを用い、さらにAI指標を取り込む動きが強まっています:
- Universiteit van Amsterdam (UvA)、Amsterdam
- Universiteit Utrecht、Utrecht
- Universiteit Leiden、Leiden
- Technische Universiteit Delft (TU Delft)、Delft
- Erasmus Universiteit Rotterdam (EUR)、Rotterdam
- Rijksuniversiteit Groningen (RUG)、Groningen
- Wageningen University & Research (WUR)、Wageningen
- Radboud Universiteit、Nijmegen
- Vrije Universiteit Amsterdam (VU)、Amsterdam
- Technische Universiteit Eindhoven (TU/e)、Eindhoven
- Universiteit Twente (UT)、Enschede
- Universiteit Maastricht (UM)、Maastricht
- Tilburg University、Tilburg
もしライデンで学位論文を擁護する場合、またはWURの研究室から提出する場合、この種のチェックを通過することになります。事前にそれを知っていることは、最終稿の準備のしかたを変えることにつながります。
オランダの研究者のためのAI humanizerの仕組み
正直なワークフローは3ステップで成り立っており、開示は付け足しではなくその一部です。
まず、下書きです。英語で書くか、オランダ語で書いてから翻訳します。思考を速めるならAIの支援を使っても構いません。議論、分析、そして根拠となるエビデンスが本当にあなたのものである限り、AI支援による最初の下書きに問題はありません。
次に、校正してhumanizeします。文法をきれいに整えた後、AI humanizerに草稿を通します。文の長さを変化させ、機械文を示す反復的なカデンツを崩し、迷い込んだ書式の癖を取り除きます。その一方で、意味、技術的語彙、すべての引用は、あなたが置いた場所のまま維持されます。当社の独自テストでは、丁寧で標準的な非ネイティブ英語が、Turnitin、Originality.ai、GPTZeroのような主要検出器に誤って読み取られる頻度が大幅に減少することが確認できました。学術的な意味と文法は保たれています。これは、約束としてではなく、検証で見えてきたこととして位置づけています。検出器は数か月ごとに再学習を行い、正直なツールであっても100%検出されないことを主張することはできません。それを保証する者は、あなたに何かを売り込んでいるのです。
最後に、開示します。AIの利用を、あなたの指導教員、所属機関、そして対象ジャーナルが求める形式で記載してください。これがすべての要点です。AIを隠すことや、類似性チェッカーをだますことが目的ではありません。誠実で正しい文章が誤読されないようにし、そのうえで、あなたが取り組んでいる間中、真正性に関するルールの範囲から逸脱しないこと、それが狙いです。
この流れは、当社の multilingual AI humanizer hub 内にある一連の仕組みの一部であり、複数の言語背景を持つ研究者に向けて同様のワークフローをカバーしています。もしあなたのより大きなニーズが「検出の公平性」ではなく「行レベルの言語編集」だという場合は、まず当社の global academic editing hub が適切な出発点になります。
地域の助成機関、学術誌、およびAI開示に関する期待
オランダの競争的研究助成は主としてNWO(Nederlandse Organisatie voor Wetenschappelijk Onderzoek、オランダ科学研究評議会)の枠組みで実行されており、Talentプログラムの助成(Veni、Vidi、Vici)を含みます。健康・医療分野の助成はZonMwを通じて行われ、KNAW(Koninklijke Nederlandse Akademie van Wetenschappen、オランダ王立芸術科学アカデミー)は全国の研究コミュニティの中心に位置します。さらにオランダの研究グループは欧州研究会議(ERC)の助成も大きな割合で獲得しており、Plan Sに基づくオープンアクセス出版はNWO助成による成果に対して義務づけられています。
出版の側では、オランダの研究者はWeb of ScienceおよびScopusに収載されている学術誌を対象にし、成果物を機関リポジトリに登録し、SURFと大学によって調整される国内のインフラを活用します。助成機関や学術誌の間で、AIに関する期待は同じ原則へと収束しつつあります、AIの利用は開示し、隠さないことです。AIが下書きにどこでどのように使われたかについて短く正直な記録を残しておけば、助成金の報告書や提出フォームでそれを求められた際にも、開示は容易になります。もし自分で書いたにもかかわらずフラグを立てられてしまった場合、appealing a false AI detection flagのガイドが、対応方法を案内します。
よくある質問
Q: 自分の論文にAI humanizerを使うのは不正行為(cheating)に当たりますか?
私たちが説明する方法で使うのであれば、当たりません。あなた自身のAI支援下の草稿をhumanizeし、主張、データ、引用をそのまま維持し、そのうえでAIの利用を所属機関と学術誌に開示します。これは、何かを隠すことの真逆です。解決されるのは真正性(integrity)に関する問題ではなく、技術的な問題、丁寧な文章が機械文として誤読されること、です。
Q: 私の英語は本当にとても優れています。それなのに、なぜ検出器は私の原稿をフラグ付けするのでしょうか?
検出器は、文章が良いかどうかを測定しているわけではありません。「どれほど予測可能か」を測っています。強く標準的で、第二言語話者としての英語は、しばしば非常に一貫性が高く、その一貫性が、検出器がAI文として結びつける低パープレキシティを生み出します。スタンフォードの研究では、人が書いた非ネイティブのエッセイがネイティブのものよりもはるかに頻繁にフラグ付けされていました。これが、多くの流暢なオランダ研究者が直面するパターンです。
Q: humanizerは、TurnitinやGPTZeroに確実に通ることを保証できますか?
いいえ、そして「通せる」と言うツールには注意すべきです。検出器は数か月ごとにモデルを更新するため、誠実な製品であっても、特定の結果を約束したり、100%検出されないと主張したりすることはできません。私たちが言えるのは、検証の結果としてhumanizerが、丁寧な非ネイティブ文が誤ってフラグ付けされる頻度を大幅に下げる一方で、意味や引用はそのまま保つ、という点です。
Q: humanizeすると引用、用語、またはデータが変わりますか?
いいえ。humanizerは、技術用語、参照マーカー、そしてあなたの主張の中身(substance)を保持するように設計されています。リズムと語彙選択をより自然に整えるのは行いますが、事実、数値、そして引用する出典そのものは変えません。提出前には、どの編集でも同様に結果を必ず読み直してください。
Q: 私は最初にオランダ語で書いてから翻訳しています。これでも機能しますか?
はい。オランダ語で下書きをし、英語版に翻訳してからhumanizeすることができます。ツールは非英語および翻訳されたテキストを、言語に配慮したモデルを通して処理し、その結果、文構造と意味が安定したまま維持されます。そのため、実際に多くのオランダ研究者が行っている書き方に合ったワークフローになります。
慎重に書いた非ネイティブ英語で、誤検知のAIフラグを減らしつつ、意味、用語、引用をそのまま保持します。無料でお試し可、研究者向けに設計。

Moe は、自然言語処理の PhD を持つ NLP エンジニアです。 彼の研究は計算言語学、テキスト分析、機械学習をカバーしており、それは ProofreaderPro の背後にある編集および人間化モデルに直接反映されています。 彼は、ほとんどの人が目にすることのないプロセスの部分、つまり言語モデルがどのように文を読み取り、スコアを付け、何を変更するかを決定するかについて書いています。


