
英語で執筆するスペイン研究者のためのAI人間化(Humanizer)
スペイン研究者向けのAI人間化ツール。スペインの影響を受けた英語における誤ったAI検出のフラグを減らし、意味と引用を維持し、正直に開示します。

スペインはヨーロッパの中でも大きな研究生産国の一つで、生産量において世界のトップ10〜12位を一貫して維持しています。その研究のほとんどは英語で読者に届けられますが、執筆者の多くにとって英語は第二言語です。この「スペイン語で考え、英語で出版する」というギャップこそが、スペイン研究者のためのAI人間化(humanizer)が担うべき領域です。
ここに、誰も想定していなかった問題があります。AI文章検出器は現在、論文審査やジャーナル投稿をふるいにかけるツールの内部に組み込まれています。機械による文章を見つけるために作られましたが、非ネイティブ英語話者による丁寧で正確な人間の文章を、日常的に誤ってフラグ付けしてしまうのです。あなたの文章自体が問題なのではありません。問題は「予測可能性」です。
マドリードやバルセロナの研究者が、スペイン語で下書きを作り、翻訳し、整った学術英語へと編集していくと、言語ツールを一切使わない不注意なネイティブ話者よりも、機械のように見えてしまうことがあります。本記事は、そのギャップを正面から埋めることについてです。つまり、あなた自身の下書きを改善し、意味と引用を保ち、大学や学術誌が求める形でAI利用を率直に開示することです。
スペイン人研究者のためのAIテキスト・ヒューマナイザー
当社のAIテキスト・ヒューマナイザーは、スペイン人研究者が、丁寧に書かれた文章が機械が生成したテキストと誤認されることなく、英語で発信できるよう支援します。意味、専門用語、引用を維持し、検出器が自動的だと解釈する語調や語彙の選び方に変化を加えます。
平易な言い方をすると、このツールは、慎重に書かれた第二言語の文章が読み違えられにくくなるように、あなた自身の下書きのリズムと語句の選び方を調整します。一方で、主張と参照(引用元)は、あなたが配置した場所のまま正確に維持されます。これは、何かを紛らわすためのものではなく、実際の著者が実際の仕事に使うために作られています。
スペイン語は英語だけでなく、直接人間化しましょう
人間化を行う前に英語へ移行する必要はありません。スペイン語の一節を貼り付けるとProofreaderProが言語を自動判定し、次にスペイン語に配慮したモデルを通して、アクセント、専門用語、引用を記載どおりに保持します。AIテキストの人間化(humanizador de texto de IA)として、スペイン語の下書きに対しても英語と同様に機能し、意味を保ちながら、言い回しは自然に読み取れます。対応言語は60以上なので、スペイン語はスペイン語のまま書き換えられ、英語へ平板化されません。
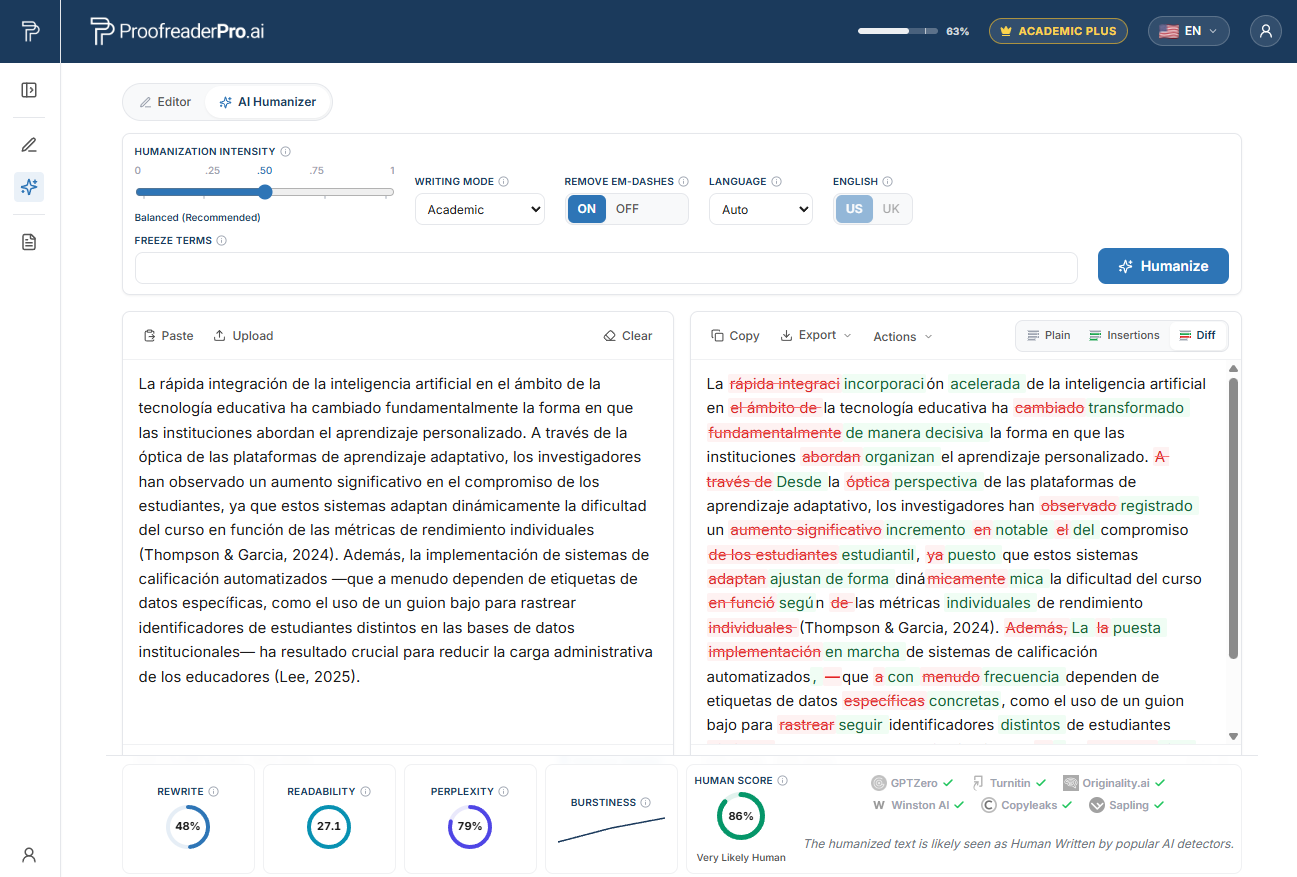
ProofreaderPro AI Humanizerがスペイン語の学術文を言い換え/人間化する様子。ビフォー・アフターの差分は意味と引用を保持し、検出チェックによって自然で人間らしい読みが確認されます。
なぜスペイン研究者はAI検出器にフラグ付けされやすいのか
最も分かりやすい根拠は、2023年のスタンフォード大学の研究です。Liangらによるこの研究は、Cell Pressのジャーナル Patterns において「GPT detectors are biased against non-native English writers.」というタイトルで公表されました。チームは、人間が書いたTOEFLのエッセイを、広く使われている7つの検出器にかけました。
その結果は、第二言語で出版する誰にとっても不安材料になります。非ネイティブのエッセイは平均で約61%がAIとしてフラグ付けされたのに対し、ネイティブ英語話者では約5%でした。さらに、非ネイティブのエッセイのうち約19.8%(ほぼ5人に1人)が、すべての検出器で一致してフラグ付けされています。すべてのエッセイは人間が執筆しました。
この仕組みは「パープレキシティ(perplexity)」と呼ばれます。これは、言語モデルにとって各語の選択がどれほど「驚き(意外性)」をもって受け取られるかを測る指標です。丁寧な第二言語話者は、よくある語や標準的で予測可能な言い回しを選びがちです。その結果、パープレキシティが低くなり、検出器はそれを機械的な文章だと読んでしまいます。スペイン研究者の英語が明確で正確になるための習慣こそ、これらのツールが「フラグを立てる対象」として学習してきた習慣なのです。詳細な仕組みは、ガイドのなぜAI検出器は非ネイティブの書き手をフラグ付けするのかで解説します。
誤検出の背後にあるスペイン語(第一言語)のパターン
スペイン語はロマンス語であり、その特徴は英語へと持ち込まれます。しかも、それは完全に正しい一方で、非常に規則的でもあります。この規則性が罠です。私たちがスペイン語話者の原稿で特に多く見かけるものを挙げます。
偽の類義語(false cognates)。 「Actual」と「actually」が「current」と「currently」に使われたり(スペイン語のactualは「current」を意味します)、realizeが「carry out」(realizar)を表す、assistが「attend」(asistir)を表す、sensibleが「sensitive」を表す、などです。これらは学習可能で標準的な置き換えであるため、まさに「予測可能」に読み取られてしまうのです。
抽象名詞での冠詞の使いすぎ。 スペイン語では、一般名詞に対して定冠詞が置かれます。そのため「the research shows」「the science」「the society」などが、英語では冠詞を落とす位置に現れます。これは一貫した、ルールに基づくパターンであり、パープレキシティを下げるのはまさに「一貫性」です。
長く、従属節が多い文。 ロマンス系の学術文体では、長めの周期的な文(相対節を積み重ねた形)が好まれます。文法的には問題ありませんが、節が節のあとに続く整ったリズムは、検出器にとって「機械のように滑らか」に見えるのです。
前置詞の転移。 「Depend of」(depender de)、「consist on」(consistir en)、「different to」、および「in relation with」は、スペイン語の前置詞の統制そのままに英語へ持ち込まれます。丁寧で体系的であるがゆえに、モデルにとって予測しやすいのです。
強い名詞化と語順。 「the realization of the analysis of」のような構文が、抽象名詞を固定された形で積み上げます。さらに、関係代名詞の「which」の使いすぎや、「On the other hand」で多くの文を開始するようなカルト(直訳)を加えると、文章は驚くほど規則的になります。
これらはいずれも、思考の誤りではありません。正しい、丁寧で、標準的な構文です。そしてその標準性こそ、検出器がパープレキシティを低くスコアし、それゆえ「機械的な文章」とラベル付けしてしまう要因なのです。
スペインにおけるAI検出とTurnitinの文脈
スペインの研究者のキャリア発展は、研究のための「sexenios de investigación(6年単位の研究評価)」に左右されます。これはANECAおよびCNEAIを通じた6年ごとの研究評価であり、Journal Citation Reports(Web of Science)およびScopusに掲載されているジャーナルで公表された論文が評価されます。この仕組みは、スペインの研究者に対して、インパクトの高い英語ジャーナルに投稿することを恒常的に促し、そのジャーナルでは検出器が待ち受けています。
スペインの学位論文は、TDXなどの機関リポジトリに登録されるほか、国内のTESEO登録にも収載されます。その前に、TurnitinまたはiThenticateによる類似度スクリーニングが一般的に行われます。さらに、同じプラットフォームが、類似度スコアに加えてAI指標も表示するケースが増えています。
その指標は、適切な比率で見ることが重要です。たとえばVanderbiltは2023年に、非ネイティブの書き手へのバイアスや誤検出(false positives)を理由に、TurnitinのAI検出器を無効化しました。同様に、Michigan State、UT Austin、Northwestern、Pittsburgh、SMU、Waterlooも対応しています。Turnitinは1〜19%の範囲のスコアを抑制し、完全性判断のためにスコアだけを頼りにしないよう注意しています。検出器のフラグは争うための「主張」であって「断定」ではありません。資金提供者やジャーナルは、推測された割合ではなく、AIがどのように使われたかを明確に開示することを、ますます求めるようになっています。
誤ったAIフラグから、丁寧な英語を守る
AI支援による下書きをそのまま人間らしく整え、すべての引用と技術用語を配置した場所に保ったままにします。そのうえで、ご自身のAI利用をジャーナルの求める方法で開示してください。
Humanizer を無料でお試しスペインの主要大学と、AIチェックが現れる場所
スペインの研究は強固な公的大学システムのもとで広く分散しており、これらの機関では、学位論文や原稿を類似度の観点で審査し、一般的にTurnitinが用いられ、さらにAI指標も加味するようになっています:
- Universitat de Barcelona (UB)、Barcelona
- Universidad Autónoma de Madrid (UAM)、Madrid
- Universidad Complutense de Madrid (UCM)、Madrid
- Universitat Autònoma de Barcelona (UAB)、Barcelona
- Universitat de València (UV)、Valencia
- Universidad de Granada (UGR)、Granada
- Universidad Politécnica de Madrid (UPM)、Madrid
- Universitat Politècnica de València (UPV)、Valencia
- Universidad de Sevilla (US)、Seville
- Universidad del País Vasco / Euskal Herriko Unibertsitatea (UPV/EHU)、Bilbao
- Universidad de Salamanca (USAL)、Salamanca
- Universitat Pompeu Fabra (UPF)、Barcelona
- Universidad de Navarra (UNAV)、Pamplona
- Universidad de Zaragoza (UNIZAR)、Zaragoza
論文がUB、UAM、あるいはUNIZARのいずれに提出されても、スクリーニング手順は大きく変わらず、そのため「丁寧な第二言語としての英語」が誤って読まれてしまうリスクも同様です。
スペイン研究者のためのAI人間化(Humanizer)はどのように機能するか
ワークフローはシンプルで、ルールの範囲にあなたをとどめます。まず、あなたが最も考えやすい形で原稿を作ります。多くの場合はスペイン語から始め、次に翻訳します。意味が正確になるように文法を直し、英語そのものに対する二度目の見直しが必要なら、スペイン研究者のためのAI校正でその手順を説明しています。その後で初めて、注意深くパープレキシティの低い文章が誤読されにくくなるように、自分のAI支援文章を人間化します。
この最後のステップが私たちのAI人間化(humanizer)です。意味、専門用語、引用を保持し、検出器が「機械のような間(cadence)」と解釈する語調や語彙の選び方に変化を加えます。60以上の言語に対応しており、非英語の文章を、文構造と意味のバランスが崩れないよう言語に配慮したモデルで処理します。
私たちは、主張することに慎重です。人間化(humanizer)は、AI文章をより自然な人間の形へ書き換え、AIのシグナルを下げ、厳しい検出器に対する成功確率を高めます。主要な検出器でテストされています。また、学術文の文法について96%以上の精度を実現しています。これらは保証ではなく、テスト結果です。検出器は数か月ごとに再学習されるため、私たちは数値や「何かを回避する方法」を約束することはありません。
次に、開示します。所属機関や対象ジャーナルが求める形式でAI利用に関する声明を追加し、ツールが、どのように生成されたのかを隠すことなく、丁寧な文章を守れるようにします。この解説は、私たちの多言語AI人間化ハブの一部に位置づけられており、さらに人による編集レイヤーを加えたい場合は、私たちのグローバルな学術編集ハブと連携します。
地方の資金提供機関、学術誌、そしてAI開示に対する期待
スペインにおける競争的資金は、Agencia Estatal de Investigación (AEI) や Ministerio de Ciencia, Innovación y Universidades を通じて流れます。一方で、Consejo Superior de Investigaciones Científicas (CSIC) は同国最大の公的研究機関です。学術ポストはANECAによって認定され、FECYTはスペインの学術ジャーナルに品質のシールを付与するため、掲載のされ方と言語品質の両方が、スペインでのキャリアにとって実質的な重みを持ちます。
出版の面では、スペインの研究者はWeb of Science(JCR)やScopus掲載誌をターゲットにします。国の指標や分野別の指標が重視される領域もあります。学位論文はTDXやTESEO登録へ到達します。これらの組織全体として、AI利用の開示は「任意」から「期待されるもの」へと移行しています。安全な姿勢はどこでも同じです。自分の研究に対してツールを使い、引用を正確に保ち、AIがどのように役立ったかを率直に述べてください。最後に人間化(humanizer)を通し、文章を誤って表現することなく守りましょう。
よくある質問(FAQ)
Q: スペイン研究者のためのAI人間化(humanizer)の使用は、カンニングに当たりますか?
自分のAI支援の下書きに対して使ったうえで、それを開示するのであれば問題ありません。このツールは、すでにあなたが作成した文章のリズムを言い換え、注意深い非ネイティブ英語が機械文として誤読されないようにします。ジャーナルや大学が求める形式でAI利用を開示することが、プロセス全体を誠実性(integrity)のルールの範囲に収めます。
Q: AIテキストの人間化(humanizador de texto de IA)は、私の引用や専門用語を変えますか?
いいえ。人間化(humanizer)は、語彙の選び方や語調を変える一方で、技術的な用語、参照、そしてあなたの主張の構造を保持するように作られています。引用キー、図、専門語彙はあなたが配置した場所にそのまま残ります。なぜなら、それらを変更してしまえば目的が失われるからです。
Q: 私の正しい英語が、最初からなぜAIとしてフラグ付けされるのですか?
多くの検出器がパープレキシティ(perplexity)や、あなたの語の選択がどれほど予測可能かをスコアするからです。丁寧なスペイン語話者は、よくある語や標準的な言い回しを使うため、パープレキシティが低くなります。すると、それが機械文として読まれてしまうのです。スタンフォードの研究では、人間が書いた非ネイティブのエッセイの約61%がフラグ付けされましたが、ネイティブ話者では約5%にとどまりました。したがって、あなたの文章にフラグが立つのは珍しくありませんし、争う余地もあります。
Q: Humanizerは実際にどの程度の通過率を達成していますか?
主要な検出器に対してテストすると、AIテキストをより自然な人間の形へ書き換え、それによってAIシグナルを下げ、厳しい検出器に対する成功の確率を高めます。同時に、学術文における文法の正確さは高水準のまま維持されます。これらはテスト結果であり、保証ではありません。検出器は頻繁に再学習されるため、私たちは固定の結果を約束するのではなく、測定した内容を説明しています。
Q: 私の大学で、私の学位論文はTurnitinでスクリーニングされます。何をすべきですか?
AI指標を、裁定ではなく1つのシグナルとして扱ってください。あなたが最も考えやすい言語で書き、正確性のために編集し、誤ったフラグが立つ可能性を下げるために自分の下書きを人間化し、そして明確なAI利用の開示を添付してください。それでもフラグが表示される場合は、あなた自身の下書きプロセスを示す証拠によって争えるようになります。
意味、用語、引用をそのまま保ちつつ、スペイン語の注意深い著者に誤って付いてしまうAI判定のフラグを減らす、言語に配慮したHumanizerです。

Moe は、自然言語処理の PhD を持つ NLP エンジニアです。 彼の研究は計算言語学、テキスト分析、機械学習をカバーしており、それは ProofreaderPro の背後にある編集および人間化モデルに直接反映されています。 彼は、ほとんどの人が目にすることのないプロセスの部分、つまり言語モデルがどのように文を読み取り、スコアを付け、何を変更するかを決定するかについて書いています。


