
ルーマニア研究者のための英語ライティングAIヒューマナイザー
ルーマニア研究者向けのAIヒューマナイザー。ルーマニアの影響を受けた英語における誤検知のAI検出フラグを減らし、意味と引用を保ったまま、正直に開示します。

ルーマニアは真剣な科学を発信しています。数学者、コンピュータ科学者、物理学者、化学者たちは、毎年Web of ScienceおよびScopusのジャーナルに研究を掲載し、CNATDCUが定める国内の昇進基準が、そのプレッシャーを一定に保っています。インデックスされた出版物がなければ、前進はありません。そうした研究のほぼすべてはルーマニア語で下書きされ、英語としてまとめられています。
ここで解決すべき課題は、ルーマニア研究者のためのAIヒューマナイザーが取り組むべき問題です。第二言語として丁寧で標準的な学術英語を書いていると、AI検出器がそれを機械生成文と誤読してしまうことがあります。文法はきれいで、表現も予測しやすい。そして、予測しやすさこそが、これらのツールが「見つける」ように学習されてきた特徴なのです。
これは稀な不具合ではありません。それは構造的なバイアスであり、特に、明確で正しい英語を書こうと最も長く努力してきた研究者ほど、その影響を強く受けます。
Cum ajută umanizarea textului AI cercetătorii români
AIによるテキストのヒューマナイズは、ルーマニアの研究者が、自分の丁寧で正確な文章が機械が生成した文章だと誤解されることなく、英語で発表できるよう助けます。Meaning(意味)、terminology(用語)、citations(引用)は、あなたが配置した場所のまま保持されます。
考え方はシンプルで、正直です。あなたは引き続き、厳密な英語を書きます。ヒューマナイザーは、文のリズムや語の選び方を変えることで、予測しやすさを罰するようチューニングされた検出器に引っかかりにくくします。あなたの主張、データ、参照文献が変わることはありません。
ルーマニア語は英語だけでなく、そのまま直接人間らしくできます
英語に翻訳してからヒューマナイズする必要はありません。ルーマニア語で書かれた文章を貼り付けるだけで、ProofreaderProが言語を自動判定し、その後、元の文章のディアクリティカルマーク、文法、学術的レジスターを尊重する「ルーマニア語対応モデル」に通します。meaning(意味)、技術的な用語、citations(引用)はそのまま維持されるため、AIによるヒューマナイズは、英語の場合と同様に第一言語の書き言葉にもその効果が及びます。このヒューマナイザーはこの方法で60以上の言語に対応し、それぞれを個別に検出して、汎用的な英語へ平坦化するのではなく、その言語として書き換えます。
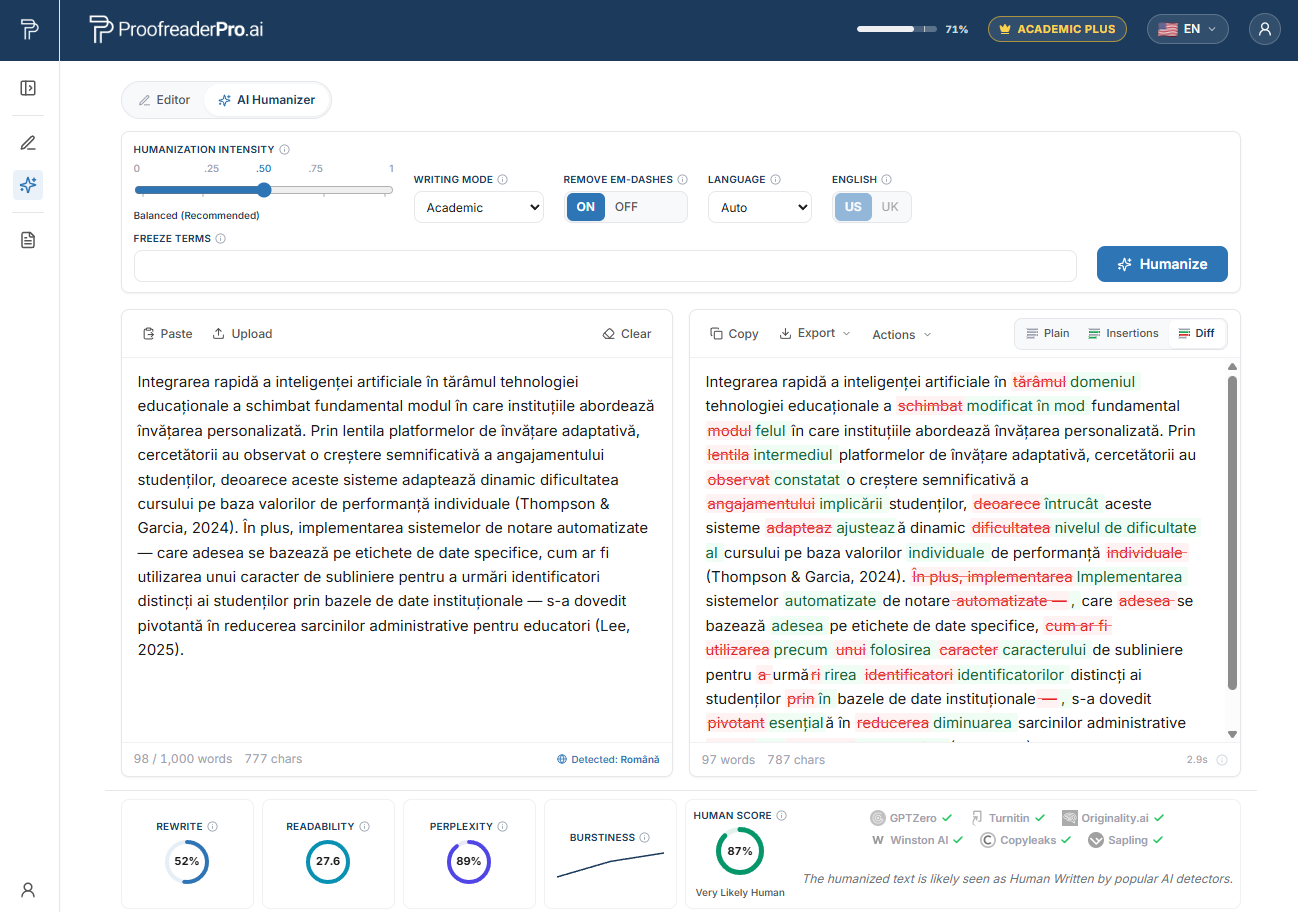
ProofreaderPro AIヒューマナイザーがルーマニア語の学術文を書き換えます。beforeとafterの差分は意味と引用を保ち、検出チェックは自然で人間による読みになっていることを確認します。
Why Romanian researchers get flagged by AI detectors
2023年、Stanfordの研究者であるWeixin Liangらは、Cell PressのジャーナルPatternsに、率直なタイトルの研究を発表しました:"GPT detectors are biased against non-native English writers."(「GPT検出器は母語でない英語の書き手に不利」)。彼らは、TOEFLのエッセイを(人間が書いたものだけで)用意し、それを7種類の広く使われているAI検出器にかけました。
結果は、第二言語で発表する人すべてを不安にさせるはずです。平均すると、非ネイティブのエッセイの約61%がAI作成としてフラグ付けされたのに対し、ネイティブ英語話者のエッセイではおよそ5%でした。さらに、非ネイティブのエッセイのうち約19.8%(ほぼ5人に1人分)が、すべての検出器によって満場一致でAIと判定されました。これらのエッセイはすべて、人間が書いたものです。
仕組みの中心は、perplexity(パープレキシティ)という指標です。これは、言語モデルにとって各単語の選択がどれほど「意外か」をスコア化します。第二言語の書き手は、一般的な語や標準的で安全な構文を選びがちなので、パープレキシティは低くなります。パープレキシティが低い文章は、機械文として読まれやすくなるのです。ルーマニア語、英語の組み合わせで明確かつ正しい英文にするための習慣こそが、これらのツールに「疑うべきもの」として学習されてしまった習慣です。仕組みの詳細はwhy AI detectors flag non-native writersで詳しく解説します。
The Romanian first-language patterns behind false flags
ルーマニア語はラテン文字で書かれるロマンス系言語で、英語にとっては親しさもありつつ、同時に十分に違いもあって、痕跡(フィンガープリント)が残ります。以下のパターンはいずれも誤りではありません。正しく、注意深く、標準的な選択であり、その「標準性」が検出器にとっては低いパープレキシティとして読み取られるのです。
False friends give your prose a recognisable shape. ルーマニア語では、actualは現在のこと、eventualは可能性のあること、a realizaは達成する/実行すること、sensibilは敏感であること、a pretindeは主張することを意味します。これらの落とし穴を避けるよう学習した丁寧な書き手は、しばしば毎回、同じ「安全な教科書英語」の語を選びます。その結果、多様性が平坦化され、検出器がそれを「見つける」ことになります。
The definite article behaves differently. ルーマニア語では冠詞は名詞の末尾に付くため、前に別の語として置くわけではありません。したがって英語の「the」は省略したり、誤って配置したりしやすくなります。過剰に修正してしまうと、非常に規則的な冠詞の用い方になり、これもまた均一なシグナルとして検出されます。
Sentences run long and subordinate-heavy. ルーマニアの学術文は、重ね書きのような節構造や接続法を好み、査読者が翻訳版を「密である」と読むことがあります。密で、きっちり構造化された文は、検出器にとって統計的に滑らかに見えやすいのです。
Prepositions transfer straight across. "depend of" や "different of" のような構文はルーマニア語のパターンにそのまま従い、関係節を導くために"which"に強く依存すると、予測可能なリズムが生まれます。
Nominalisation piles up. 動詞を重い名詞句に置き換えることは、形式的なルーマニア語では普通であり、形式的な英語でも普通です。しかしそれが積み重なると、機械的に見えるような、均一で抽象的なリズムが生成されます。
これらをまとめると、正確でプロフェッショナルな文章であっても、AI検出器にとっては「不自然なほど滑らか」に見える文章になります。
Romania's AI-detection and Turnitin context
ルーマニアの高等教育機関では、類似度スクリーニングが一般的です。博士論文やジャーナル投稿は、Turnitinまたは同等のシステムで確認されることが多く、さらに最近では、それらのプラットフォームが従来の類似度スコアに加えて、AIライティング指標を付与するようになっています。
大学側からは生成AIに関する独自のガイダンスが示されており、今後の方向性は明確です。助成機関やジャーナルが、著者に対し、どのようにAIツールを使用したかを開示するよう求める動きが強まっています。これは妥当な要請であり、AIを全面的に禁止することとはまったく別物です。
正直に取るべき立場は、保持する価値があるものです。AIを使って下書きや推敲の補助を行い、すべての主張と引用が真実であることを保ったうえで、機関や対象ジャーナルが求める形式でその使用を開示してください。検出器のスコアは、争うべき主張であって判決ではありません。責任ある査読者なら、単一の数値を不正の証明として扱うべきではありません。
誤検知によるAIフラグから、ルーマニア語, 英語の研究を守ります
慎重に作成した学術的な下書きを自然な文章に整え、すべての引用と専門用語を保持し、そのうえで自信を持ってAIの使用を開示してください。
Humanizer を無料でお試しTop Romanian universities and where AI checks appear
以下は、ルーマニアの研究が書かれ、擁護され、そしてスクリーニングされる機関です。それぞれの機関は、論文や原稿を類似度システムに通しており、同じレビューの中でAI指標の比重もますます高めています。
- Universitatea din București (University of Bucharest)、ブカレスト
- Universitatea Babeș-Bolyai (Babeș-Bolyai University)、クルージュ=ナポカ
- Universitatea Politehnica din București (Politehnica University of Bucharest)、ブカレスト
- Universitatea Alexandru Ioan Cuza din Iași、ヤシ
- Universitatea de Vest din Timișoara (West University of Timișoara)、ティミショアラ
- Universitatea de Medicină și Farmacie Carol Davila、ブカレスト
- Universitatea Tehnică din Cluj-Napoca (Technical University of Cluj-Napoca)、クルージュ=ナポカ
- Universitatea Transilvania din Brașov (Transilvania University of Brașov)、ブラショフ
- Academia de Studii Economice din București (Bucharest University of Economic Studies, ASE)、ブカレスト
- Universitatea din Craiova (University of Craiova)、クルヨーヴァ
これらのどのシステムからのフラグも「会話の始まり」であって「終わり」ではありません。望むのは、そもそも最初に会話が持ち上がらない文章です。なぜなら、それが、すでにあなたが書いている丁寧な人間による文章であると、紛れなく読めるからです。
ルーマニアの研究者向けAI人間化機能の仕組み
ワークフローは率直で、あなたがすでに書いているやり方に合っています。ルーマニア研究者のためのAIヒューマナイザーが実際にどう機能するのかを説明します。
原稿を作成します。まずルーマニア語で考えたほうがよいなら、その方法で進めてください。そのうえで翻訳して英語で書き起こすか、AIアシスタントを使って最初の下書きを動かします。文法と用語を修正し、科学が正確になるようにします。次に、あなた自身の英語をtext humanizerにかけます。ここでは、文の長さや語の選び方を変え、検出器が罰するような均一な語り口を滑らかにし、機械的な下書きに特有の、紛れ込んだemダッシュや繰り返し表現を静かに取り除きます。
meaning(意味)、技術的語彙、citations(引用)は保持されます。非英語のテキストは、文の構造を尊重する言語対応モデルにルーティングされるため、ルーマニア語の影響を受けた一節がぐちゃぐちゃに崩れることはありません。私たちの独自テストでは、学術的コンテンツをそのまま維持しながら、Turnitin、Originality.ai、GPTZeroを含む主要な検出器において、丁寧で標準的な非ネイティブ英語が誤読される頻度を大幅に低減できることが分かっています。
これは、私たちが見てきたものをそう呼んでいるにすぎず、約束ではありません。検出器は数か月ごとに再学習され、誠実なツールが「100%検出不能」を主張することはできません。私たちが言えるのは、明確で人間らしい文を、少し多様にすることで、機械の文章と見分けられにくくなるということです。これは、私たちのmultilingual AI humanizer hubの一部であり、編集全体の観点からは、私たちのglobal academic editing hubと並んで位置づけられます。
最後のステップは任意ではありません。下書きが自然に読めるようになったら、機関やジャーナルが求める方法でAIの使用を開示してください。自分自身の原稿をヒューマナイズすることは、偏ったフラグからそれを守ることになります。開示は、あなたをルールの内側にきちんと保ちます。
Local funding bodies, journals, and AI-disclosure expectations
ルーマニアの競争的助成金は、主にUEFISCDI(高等教育、研究開発、イノベーションのための実行機関)を通じて運営されています。研究評価の方針はCNCS(国立科学研究評議会)およびAcademia Română(ルーマニア・アカデミー)が定め、ルーマニア国内の研究機関ネットワークを運営しています。さらにその上にあるのがCNATDCUで、そこでは昇進の最低基準としてインデックスされたジャーナルでの成果が評価されます。
このインデックス志向が、誰もが同じ目標へと向かわせます。つまりWeb of ScienceおよびScopusのジャーナルです。そこでは言語面が厳密に見られ、AIフラグが出れば、科学が読まれる前に投稿が止まってしまうことがあります。
助成金報告やジャーナル投稿システムの中で、AIの開示要求がさらに広がることを想定してください。安全な習慣は、開示を「認めること」ではなく、通常の実務として扱うことです。どのツールが書くのに役立ったかをはっきり述べ、データと引用が正直であることを保ち、そのうえで、クリーンで人間らしく聞こえる原稿がその仕事を語らせましょう。あなたがrun your draft through the humanizerを行うとき、それは何かを偽装するのではなく、正確な書きぶりを守る行為です。
Frequently asked questions
Q: ルーマニア研究者向けのAIヒューマナイザーは、私の引用や技術用語を変えますか?
いいえ。ヒューマナイザーは、あなたの意味、用語、そしてすべての引用を、書かれているとおりに正確に保持します。周辺の文章全体でリズムと語の選び方を変えるため、参照文献や専門的な語彙はそのまま保たれつつ、文章はより自然に読めるようになります。
Q: どんなヒューマナイザーでも、私の論文がAI検出器を通過すると保証できますか?
いいえ。誠実なツールは、そのような保証はできませんし、そうした主張をするものは信用しないでください。検出器は数か月ごとに再学習されるため、結果の保証はできず、100%検出不能と呼ぶこともできません。私たちが言えるのは、テストでは、注意深い非ネイティブ文を多様にすることで、主要な検出器による誤読の頻度が大幅に下がることです。
Q: 自分の原稿にumanizarea textului AIを使うのは不正行為(カンニング)と見なされますか?
正直に行うのであれば、その限りではありません。あなたは自分自身のAI支援による作業を磨き、すべての主張と引用が真実であることを保ち、そして大学やジャーナルが求める方法でAIの使用を開示します。これは本物の作業に対する公正さであり、何かを隠すための方法ではありません。
Q: そもそも、私の正しい英語が最初からAIとしてフラグ付けされるのはなぜですか?
検出器は予測可能性をスコア化しており、注意深い第二言語の文章は非常に予測しやすいからです。Stanfordの研究では、人間が書いた非ネイティブのエッセイは、ネイティブのものよりもAIとしてフラグ付けされる頻度がはるかに高いことが分かりました。クリーンで標準的なルーマニア、英語は低いパープレキシティとして読み取られ、これらのツールはそれを機械のシグナルとして扱います。
Q: ルーマニアの大学は実際にAIをスクリーニングしていますか?
はい、一般的な意味ではあります。Turnitinまたは同等のシステムによる類似度チェックは日常的であり、多くのプラットフォームがAIライティング指標も表示するようになっています。フラグは「査読するための根拠」であって判決ではないため、そもそも文章がその疑問を招かないようにしておく価値があります。
意味, 用語, 引用をそのままにし、検出を引っかけやすいリズムを変えたうえで、自信を持ってAIの使用を開示してください。

Moe は、自然言語処理の PhD を持つ NLP エンジニアです。 彼の研究は計算言語学、テキスト分析、機械学習をカバーしており、それは ProofreaderPro の背後にある編集および人間化モデルに直接反映されています。 彼は、ほとんどの人が目にすることのないプロセスの部分、つまり言語モデルがどのように文を読み取り、スコアを付け、何を変更するかを決定するかについて書いています。


