
英語で執筆するギリシャ人研究者のためのAIヒューマナイザー
ギリシャ人研究者のためのAIヒューマナイザー。ギリシャの影響を受けた英語での誤ったAI検知フラグを減らし、意味と引用を維持しつつ、正直に開示します。

ギリシャのアテネ国立工科大学の物理学者が、英語で研究手法の章を下書きする。彼女は、すべての論文とすべての時制を二度ずつ確認し、そしてスコーパスに収録されている雑誌へ投稿する。数週間後、共著者から編集者のメモが転送されてきた。「原稿の一部が機械で書かれたものとして、自動のAI検知器にフラグを立てられた」という内容だ。彼女はすべての文を自分で書いている。
いまではこのような状況は珍しくなく、そもそも投稿すること自体がどれほど慎重であるべきか、研究者の感覚を形作っている。ギリシャ人研究者のためのAIヒューマナイザーは、この問題に対処するためにある。そして、それが必要とされる理由は、文章そのものよりも検知器のほうに関係している。
ギリシャの研究は、工学、コンピュータサイエンス、物理学、医学、そして古典に強く、思考や初稿はギリシャ語で行われる一方で、その多くが英語で世界へ届けられる。進展と分野評価は、Web of ScienceやScopusに収録される出版を評価するため、明確な英語で書くことへの圧力は一向に弱まらない。ところが、明確で標準的な第二言語の英語こそが、こうしたツールによって最も頻繁に誤って読み取られてしまう種類の文章なのだ。
ギリシャ人研究者のためのAIテキストのヒューマナイズ(εξανθρωπισμός κειμένου AI)
私たちのヒューマナイザーは、ギリシャの学術関係者が英語で発表できるよう支援し、細やかなネイティブの影響を受けた文体が「機械文」と誤認されることを防ぎます。これは、あなた自身のAI支援による下書きを対象に、意味と引用をそのまま維持し、検知器が執着するリズムや語彙の選択を変えます。公平にフラグを立てられた段落なら、text humanizerで試せます。
本ガイドは、60以上の言語にまたがって同じ問題を扱うより広い多言語AIヒューマナイザーハブの一つのノードです。人々が第二言語として学術英語を書く場所では、誤検知フラグのパターンが繰り返し現れるためです。
ギリシャ語で下書き?ヒューマナイザーはそれも検知・処理します
すべての下書きが英語から始まるわけではなく、ヒューマナイザーもそれを前提にしません。ギリシャ語のテキストを貼り付けると、ProofreaderProはギリシャ文字を自動的に認識し、その後、言語に配慮したモデルを通して処理します。用語、アクセント、引用は「書かれたとおり」に維持されます。εξανθρωπισμός κειμένου AIとして、ギリシャ語の文章を直接書き換えるため、翻訳の前にヒューマナイズできます。検知対象は60以上の言語に及び、それぞれが「その言語のまま」として書き換えられます。
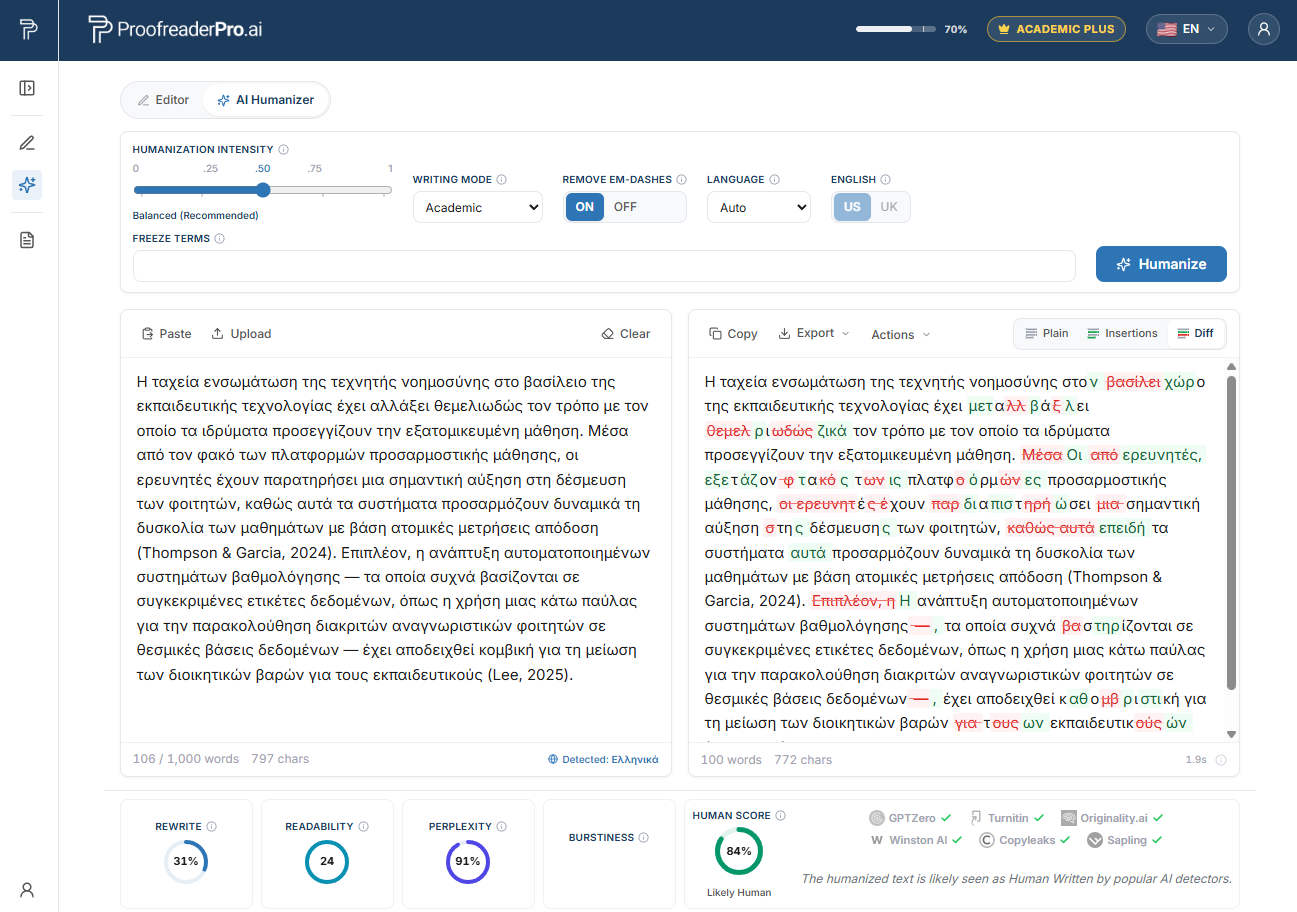
ProofreaderPro AIヒューマナイザーがギリシャの学術テキストを書き換える例。ビフォー/アフターの差分は意味と引用を保ち、検知チェックは自然な人間による読みを確認します。
なぜギリシャ人研究者はAI検知器にフラグを立てられるのか
まずは、この問題を数値で示した研究から始めましょう。2023年、スタンフォードのチーム(Weixin Liangが率いる)が、Cell Pressの雑誌Patternsにおいて「GPT detectors are biased against non-native English writers」を発表しました。彼らは、人が書いたTOEFLのエッセイを集め、広く使われている7つの検知器にかけました。
結果は偏っていました。平均すると、非ネイティブの書き手によるエッセイの約61%がAIとしてフラグされる一方、ネイティブ英語の書き手では約5%でした。さらに、非ネイティブのエッセイの約19.8%にあたるほぼ5分の1が、セット内のすべての検知器によって「全会一致」でフラグされました。これらのエッセイすべてに、人間の著者がいました。
メカニズムはperplexity(当惑度)と呼ばれます。多くの検知器は、次の単語が言語モデルにとってどれほど「意外」かをスコア化します。そして、一般的な語が予測可能な順序で並んだテキストは低いスコアになります。低いperplexityは機械文として読まれやすい。標準的な語彙や安全な文パターンを選ぶ、注意深いギリシャ人研究者は、検知器が「疑うように学習された」まさにその文章を書いていることになります。この失敗モードについて、なぜAI検知器は非ネイティブの書き手にフラグを立てるのかでさらに掘り下げます。
偽陽性フラグの背後にあるギリシャ語の第一言語パターン
以下の習慣は誤りではありません。正しく、標準的な構文です。そしてそれがまさに、perplexityを下げ、フラグを引き寄せてしまう理由なのです。
記事(冠詞)が最も分かりやすい例です。ギリシャ語では抽象名詞、固有名詞、総称に対して定冠詞を用います。そのため、ギリシャ語話者が書いた英語は自然に「the」で満たされます。「the science shows」「the Professor Papadopoulos argued」「the nature of the problem」。どのフレーズも文法的であり、それらの積み重なり方は非常に規則的です。
時制と相(アスペクト)も第二のサインになります。ギリシャ語は英語とは異なる形で相を示すため、「現在完了」と「単純過去」、あるいは「単純形」と「継続形」の選択が、段落全体で均等かつ予測可能に現れてしまうことがあります。検知器は、この「均等さ」を、選択を行う人物ではなく、パターンとして読み取るのです。
文の長さもまた重要です。ギリシャの学術スタイルは、重めの接続詞で結ばれた長い文を好むため、「moreover」「furthermore」「in addition」が議論の継ぎ目に積み重なっていきます。さらに、それらの接続詞は、モデルが次に目にすることを最も確からしく期待する語でもあり、perplexityをさらに引き下げます。
さらに二つの移し替え効果がそれを補完します。語順は、語順の自由度が高い言語から持ち越されるため、正しいものの形が均一なトピカライズ(話題化)された文が生まれます。そして、名前や専門用語がギリシャ文字から移る際の転写(transliteration)の選択は、規則性の別の層を追加します。これらの特性が組み合わさることで、正直なギリシャ語、英語が、検知器にとって「不自然に滑らか」に見えるのです。
ギリシャのAI検知とTurnitinの文脈
ギリシャの機関から提出されるテーゼ(論文)やジャーナル投稿は、日常的にスクリーニングされています。学位論文や原稿では、TurnitinまたはiThenticateによる類似性チェックが標準的な実務であり、同じプラットフォームが、類似性スコアに加えてAI執筆の指標も現在では提示します。
ギリシャ国内の大学は、それぞれ独自の生成AIに関するガイダンスを発行しており、流れは「禁止」ではなく「開示」へ向かっています。助成機関や雑誌はますます、著者に対して、どこでどのようにAIツールを使用したかを明記するよう求めています。これらのいずれも、AI支援を禁じるものではありません。禁じるのではなく、その利用について正直であることを期待するだけです。これは「隠すこと」とはまったく別のことです。
思い出しておくべきは、検知器のスコアは判決ではない、という点です。Turnitin自体が低いAIスコアを抑制し、その数値だけを完全性(integrity)の判断根拠にすべきではないと警告しています。ほかの複数の大学は、上で示したのと同じバイアスに基づく理由で、AI検知器をオフに切り替えたところもあります。フラグは「争うことが許される主張」であり、「有罪の確定」ではありません。
偏った検出器に、研究を語らせない
フラグが付いた段落を貼り付けて、ヒューマナイズによって意味、用語、引用が保持され、リズムを検出する装置が誤読する可能性を変えられることをご確認ください。
Humanizer を無料でお試しギリシャの主要大学と、AIチェックが現れる場所
以下の機関は、類似性とAIの指標を検討する度合いを高めながら、テーゼや原稿をスクリーニングしています。これらのいずれかで執筆する場合、あなたの学位論文または投稿が、いずれかのシステムを通過することになると見込んでください。
- Εθνικό και Καποδιστριακό Πανεπιστήμιο Αθηνών (National and Kapodistrian University of Athens, NKUA), in Athens
- Αριστοτέλειο Πανεπιστήμιο Θεσσαλονίκης (Aristotle University of Thessaloniki, AUTH), in Thessaloniki
- Εθνικό Μετσόβιο Πολυτεχνείο (National Technical University of Athens, NTUA), in Athens
- Πανεπιστήμιο Πατρών (University of Patras), in Patras
- Πανεπιστήμιο Κρήτης (University of Crete), in Heraklion and Rethymno
- Πανεπιστήμιο Ιωαννίνων (University of Ioannina), in Ioannina
- Πανεπιστήμιο Θεσσαλίας (University of Thessaly), in Volos
- Οικονομικό Πανεπιστήμιο Αθηνών (Athens University of Economics and Business, AUEB), in Athens
- Δημοκρίτειο Πανεπιστήμιο Θράκης (Democritus University of Thrace), in Komotini
このリストはギリシャの高等教育の全てではありませんが、英語で書かれた研究文として、また実際のスクリーニングとして、最も多くの場面がそこで起きていることをカバーしています。
ギリシャ人研究者向けAIヒューマナイザーの仕組み
ワークフローは率直でシンプルであり、あなたをルールの範囲内に保ちます。
まず下書き。思考が最も明確になるのであれば、その場所でギリシャ語で書き、そして翻訳します。あるいは、使用している支援に応じて、最初から英語で下書きをしてください。文章の読み方を気にする前に、議論と根拠を正しく整えましょう。
次に文法を校正します。冠詞の過剰使用を直し、時制を整え、用語を確認して、意味が意図どおりであることを確実にします。私たちのtext humanizerは、このステップの代替ではありません。クリーンな入力は、より良い出力を生むためです。
その後、あなた自身のAI支援による文章をヒューマナイズします。このツールは、文のリズムと語彙の選択を変え、低いperplexityとして読まれやすい一様な語感を分解し、さらに、反復された接続詞や紛れ込んだダッシュ(em dash)など、決定的な痕跡を取り除きます。同時に、意味、技術的な用語、そしてすべての引用は維持されます。非英語のテキストは言語に配慮したモデルを通過するため、ギリシャ語の段落は平板化されることなく、その構造が保たれます。
では、結果について率直にどこまで言えるのでしょうか。私たち自身のテストでは、ヒューマナイズによって、学術的な意味を保ったまま、Turnitin、Originality.ai、GPTZeroといった主要な検知器に誤って読み取られる頻度を大幅に下げられることが分かりました。私たちは数値を断定しません。検知器は数か月ごとに再学習され、誠実なツールが「完全に検知されない」ことを約束することはできません。それを保証する人は、あなたに何かを売ろうとしているのです。
最後に開示します。あなたの指導教員、所属機関、そして目標とする投稿先雑誌が求める形式に従って、AIの利用を明記してください。ヒューマナイズは、偏ったフラグから丁寧な執筆を守ります。開示は、利用した支援について正しく記録を残すためのものです。両者はセットであるべきです。ヒューマナイズを超えた編集支援については、私たちのグローバルな学術編集ハブが、言語サポートのリソースを一か所に集めています。
地域の資金提供機関、雑誌、そしてAI開示への期待
ギリシャにおける競争的な研究資金は、主としてHFRI、Hellenic Foundation for Research and Innovation(ΕΛΙΔΕΚ)を通じて運用されています。これは研究者主導のプロジェクトに資金を提供します。一方でGSRI(General Secretariat for Research and Innovation)が、全国の研究政策を定めます。多くのギリシャの研究グループはまた、欧州研究会議(ERC)の助成金も獲得しています。これらはそれぞれ独自の報告文化を持ち、AI利用の開示がその一部として着実に定着しつつあります。
出版の側では、ギリシャ人研究者はWeb of ScienceやScopusに収録される雑誌を目指し、National Documentation Centre(EKT)が国内のリポジトリと研究統計を維持しています。多くの国際的な雑誌では、投稿者向けガイドラインにAI開示条項がいまでは含まれることが一般的です。安全な習慣は、その条項を投稿前に読み、推測されるままにせず、ツールについて短い声明を書いておくことです。
推論を見失わないでください。自分の下書きをヒューマナイズすることは、これらのどれをも回避する方法ではありません。記録された検知器バイアスから、明確なギリシャ語、英語を守ります。そして開示が、記録を正しく整えます。公正な形で扱われる実務。
よくある質問
Q: 私の論文は、私が自分で書いたのにフラグを立てられました。それでもAIヒューマナイザーは役立ちますか?
はい、それがまさにこのツールが作られたケースです。注意深い非ネイティブの英語はperplexityが低くなり、その結果「機械で書かれた文章」として誤読されやすくなります。ヒューマナイズは、フラグのきっかけとなるリズムや語彙の選択を変えつつ、意味は維持します。検知器が不完全である事実を消し去ることはできませんが、検知器が過剰に重み付けしてしまう特性を取り除けます。
Q: AIテキストのヒューマナイズは、私の引用や専門用語を変えますか?
いいえ。ヒューマナイザーは引用、参考文献、そして領域固有の用語を維持します。変更すると論文が損なわれるからです。これは、あなたの根拠や専門的な語彙ではなく、語感や言い回しに作用します。
Q: ギリシャ人研究者向けのAIヒューマナイザーを使うことは不正(チート)と見なされますか?
率直に使うのであれば、不正にはなりません。あなた自身のAI支援による下書きをヒューマナイズし、意味と引用を維持したうえで、所属機関や雑誌が求める形でAI利用を開示します。目的は、捏造された仕事の偽装ではなく、実際の執筆に対する公平さです。
Q: どんなツールでも、私のテキストがすべてのAI検知器を確実に通過することを保証できますか?
できませんし、そのようなことを言う相手は信用しないでください。検知器は定期的にモデルを更新するため、どのツールも「100%検知されない」ことは約束できません。優れたヒューマナイザーができるのは、誠実な非ネイティブ文が誤ってフラグされる頻度を下げることだけです。私たちがテストで確認できたのは、まさにそこです。
Q: 私はギリシャ語で下書きしてから翻訳しました。これだとフラグが立ちやすくなりますか?
そうなる可能性があります。翻訳された学術文は非常に標準的で規則的になりがちで、それこそが低いperplexityとして読まれやすいからです。翻訳した下書きをヒューマナイズし、そのうえでプロセスを開示することは、明確な文章が明晰さゆえにペナルティを受けるのを避ける、筋の通った方法です。
非ネイティブの学術従事者向け, 注意深いギリシャ語英語の誤ったAIフラグを減らしつつ、引用、用語、主張を保持します。

Moe は、自然言語処理の PhD を持つ NLP エンジニアです。 彼の研究は計算言語学、テキスト分析、機械学習をカバーしており、それは ProofreaderPro の背後にある編集および人間化モデルに直接反映されています。 彼は、ほとんどの人が目にすることのないプロセスの部分、つまり言語モデルがどのように文を読み取り、スコアを付け、何を変更するかを決定するかについて書いています。


