
英語で執筆するアルゼンチン研究者のためのAI Humanizer
アルゼンチンの研究者向けAI humanizer。スペインの影響を受けた英語における誤ったAI検出フラグを減らし、意味と引用を維持し、正直に開示します。

アルゼンチンは年間18,000〜22,000本のScopusに収載された論文を公表しており、世界ではおよそ40位〜45位、ラテンアメリカではブラジルとメキシコに次いで2位に位置します。こうした研究の多くは、いまやAIアシスタントの存在がどこかしらの工程に組み込まれる形で始まっています。ChatGPTで最初の草稿を骨子として作り、Claudeで段落を引き締め、スペイン語からの翻訳を滑らかにする、それは一般的で、開示する場合には多くの学術誌がそれを認めています。
問題は、その後に始まります。アルゼンチンの研究者のためのAI humanizerが必要とされるのは、AI検出器が、丁寧な第二言語としての英語を機械的な文章として誤読することが日常的に起きており、アルゼンチンの著者は、単にクリーンで標準的、かつ正しいだけの文体に対して支払いをしているためです。
アルゼンチンはEF英語能力指数で562点を獲得し、ラテンアメリカで最高です。しかし、この高い熟達度はここではあなたを守りません。むしろ、長年のフォーマルな学習から得られる洗練され、教科書どおりに正しい英語こそが、検出器にとって最もフラグを立てられやすいタイプの文章になっている可能性があります。
アルゼンチン研究者向けAI文章humanizador de texto de IA
私たちのAI文章humanizador de texto de IAは、アルゼンチンの研究者が英語でより安心して発表できるよう支援します。AI支援で作成したあなた自身の草稿を再書き換えし、あなたの丁寧な英語が自動生成の文章と誤解されないようにします。意味、専門用語、引用をそのまま維持します。
平たく言えば、あなたは科学を書き、意味は保ち、text humanizerはリズムと語彙の選び方を変えます。その結果、丁寧に作られたスペインの影響を受けた英語が、すでにそれが人間による仕事であるかのように読めます。60以上の言語をサポートし、非英語テキストは文の構造を保持する言語対応モデルを経由します。
これは何かを隠すことではありません。送信する前に、実際の仕事を公正に読んでもらうこと、そして機関や学術誌が求める方法でAI利用を正直に開示することです。
スペイン語での執筆?自動で検出され、そのままhumanizadoされます
アルゼンチンでは、英語でまとめる前にスペイン語で草稿を作る研究者が少なくありません。humanizerはそれを直接サポートします。スペイン語の文章を貼り付けると、ProofreaderProが言語を自動認識し、次にスペイン語に配慮したモデルで処理します。その際、あなたの専門用語、アクセント、引用は記載どおりに正確に保持されます。さらに、先に翻訳する必要はなく、Through humanizador de texto de IAによってスペイン語の草稿は英語と同じようにhumanizadoされます。検出は60以上の言語にまたがり、それぞれの言語の声(トーン)で書き直されます。
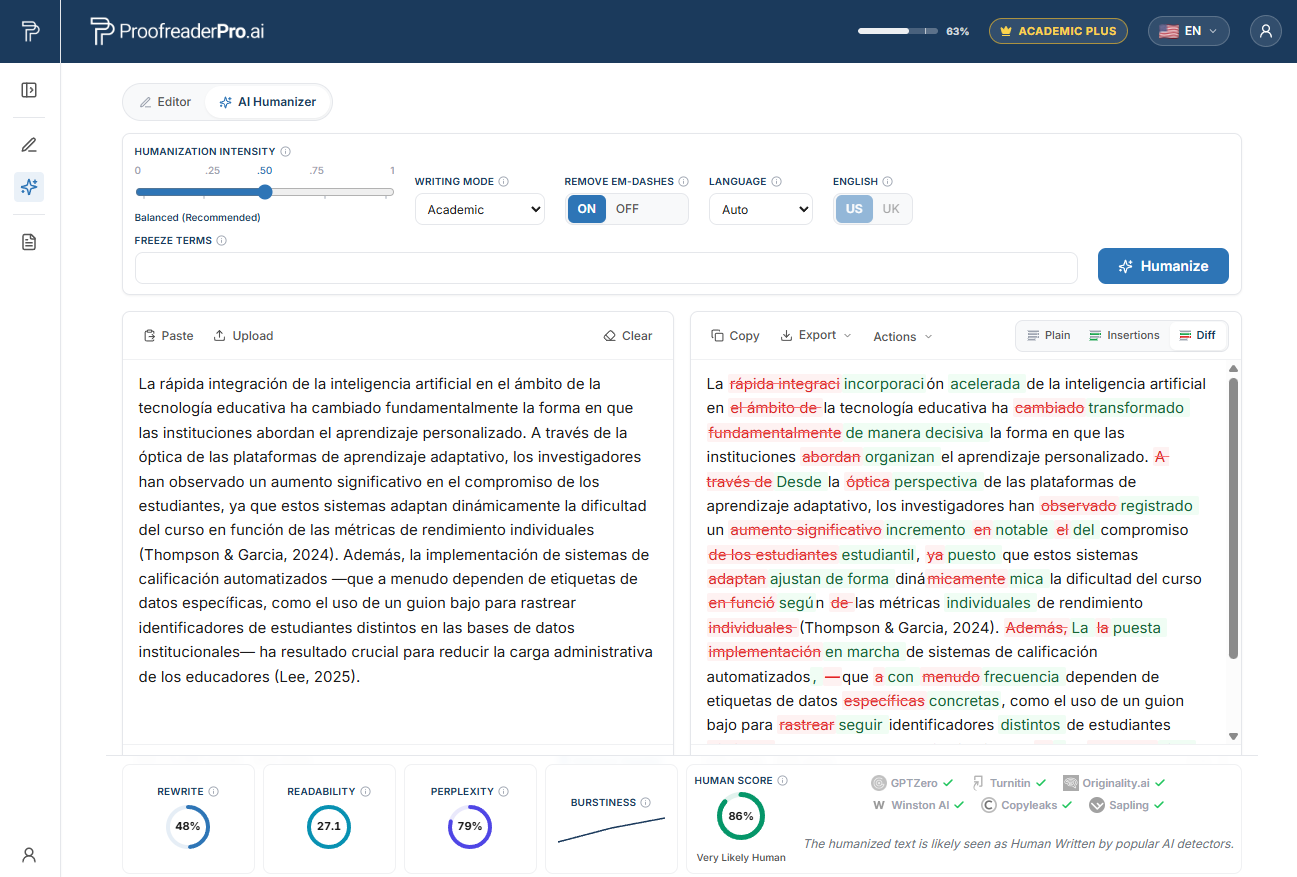
ProofreaderPro AI Humanizerがスペイン語の学術文を言語humanizadoしています。beforeとafterの差分は意味と引用を維持し、検出器のチェックは自然で人間らしい読みを確認します。
なぜアルゼンチンの研究者はAI検出器にフラグを立てられやすいのか
2023年、Liangらが率いるスタンフォードのチームは、Cell Pressの学術誌Patternsに「"GPT detectors are biased against non-native English writers."(GPT検出器は非ネイティブの英語ライターに偏っている)」という研究を発表しました。彼らは、人間が書いたTOEFLのエッセイを、広く使われている7種類の検出器に通しました。その結果、平均すると非ネイティブのエッセイの約61%がAIとしてフラグを立てられたのに対し、ネイティブのライターでは約5%でした。非ネイティブのエッセイのほぼ5本に1本は、全ての検出器で同時にフラグが立てられています。各エッセイは人が書いていました。
メカニズムは「当惑(perplexity)」です。多くの検出器は、言語モデルにとって各語の選択がどれほど意外かをスコア化します。慎重な第二言語の書き手は、一般的な単語や標準的で予測可能な言い回しを選びがちです。その結果、当惑度が低くなり、機械文として読まれます。アルゼンチンの学術文を明瞭で安全なものにするまさにその習慣が、これらのツールには疑うべきものとして学習されてしまっています。
私たちは、なぜAI検出器が非ネイティブの書き手をフラグにするのかで、この失敗パターンを詳しく説明しています。短く言えば、検出器のフラグは、論文がどのように書かれたかに関する証拠ではなく、語のパターンに関する統計的な推測にすぎません。
誤検出フラグの背後にある、スペイン語を母語とする書き方のパターン
アルゼンチンの熟達度が高いことを背景に、決定的な大きな誤りは見られません。高度な書き手が正確さを保つために選ぶ丁寧で標準的な選択があり、それが当惑度を下げてしまうのです。以下は、アルゼンチン英語を機械的なシグネチャへと押しやるパターンです。
最も安全な冠詞ルール。どこでも適用する。 スペイン語は、抽象名詞に対して英語よりもはるかに自由に定冠詞を用います(例:"la investigacion demuestra que la desigualdad afecta la educacion")。アルゼンチンの著者は一般的な叙述ではそれらの冠詞を取り除くよう学び、その後、修正されたルールを一貫して適用します。すると、ほぼ変化のない教科書どおりに予測できる名詞句ができあがり、モデルがちょうど期待する形になります。
形容詞の定番の語順。 スペイン語では形容詞は名詞の後ろに置かれます。一方英語では名詞の前に積み上げるように置きます。英語の慣習を反復して身につけた書き手は、"un analisis estadistico multivariado robusto"を"a robust multivariate statistical analysis"として表し、その語順を毎回守ります。こうした剛直な正しさは、そもそも「意外性が低い」状態を作り出します。
すべてのfalse friend(紛らわしい類似語)に対する最も安全な同義語。 falsos amigos("actual," "realizar," "eventualmente," "sensible," "pretender")を避けるために、慎重な著者は最も一般的で曖昧さのない英語の語を選びます。高確率の同義語を繰り返し選ぶほど、検出器が「人間らしさ」として読む語彙の多様性は平坦化します。
辞書どおりの前置詞を毎回1つだけ。 スペイン語の転移が"consist in," "depend of," "interested on," "different to," を生むことを学んだ後、書き手は"consist of," "depend on," "interested in," "different from"に固定してしまいます。常に単一の標準的なコロケーションで、決して意外なものにはしません。
機械的な時制選択。 リオプラテンセ・スペイン語は単純過去に寄るため、アルゼンチンの書き手は方法と結果のセクションで、英語の現在完了および単純過去のルールを意図的に適用します。意図的でルールに縛られた時制の使い方は一貫しており、予測可能です。これは当惑度が低く読まれます。
最大限のフォーマルさ。 アルゼンチンの学術的レジスターはフォーマルな方向に傾きがちです。そのため著者は、最も標準的で、最も保守的な表現を選びます。最も安全な文は最も期待される文でもあり、期待される文章こそが、検出器にとって機械生成としてスコア化されやすいのです。
アルゼンチンにおけるAI検出とTurnitinの文脈
アルゼンチンでは、学位論文、キャリアレポート、学術誌への投稿が、類似性とAIの兆候の双方についてTurnitinまたはiThenticateでスクリーニングされることがよくあります。CONICETの評価委員会、大学のテニュア(終身在職権)プロセス、そして国際的な学術誌はすべて、そのパイプラインのどこかに位置しているため、大学院生もシニア研究者も同じ検出器にかけられ得ます。
ベンダーが自社ツールについてどのように語っているかを知っておくと役立ちます。TurnitinはAIスコアを1〜19%の範囲で抑制し、数値ではなくアスタリスクを表示しており、そのスコアは単独で完全性(integrity)の判断に使うべきではないと警告しています。いくつかの大学はさらに踏み込みました。たとえばVanderbiltは、誤検出や非ネイティブの書き手に対するバイアスを理由に2023年にTurnitinのAI検出器を無効化し、Michigan State、UT Austin、Northwestern、Pittsburgh、SMU、Waterlooも同様の対応を取りました。
この経緯を公正に読むなら、検出器が無意味だと言いたいわけではありません。問題は、スコアが「有罪(判決)」ではなく、争うための主張になっている点です。同時に、資金提供者や学術誌はますますAI支援の開示を求めています。これら2つの事実が同じ方向を示しています。つまり、丁寧な文章が誤読されないようにし、利用したツールについて透明性を確保することです。
英語を公正に読み直します
AI支援によるご自身の原稿を人間らしく整え、スペイン語の影響を受けた慎重な文章が機械の文章として誤読されないようにします。意味、用語、引用を保持します。次に、自信をもって開示してください。
Humanizer を無料でお試し主要なアルゼンチンの大学と、AIチェックが現れる場所
アルゼンチンの公立大学制度は、学部レベルでは大規模で、かつ無料です。研究は国立大学やCONICETの研究機関に集中しており、それらがキャンパス内に併設されていることもよくあります。ここは国内を代表する研究の生産拠点であり、各機関が学位論文や原稿を類似性とAIの兆候についてスクリーニングします。
- Universidad de Buenos Aires (UBA)、ブエノスアイレス。全国の産出の約40%と、圧倒的に最大の生産規模を誇ります。
- Universidad Nacional de Cordoba (UNC)、コルドバ。1613年に設立され、アメリカ大陸で最古級の大学の一つであり、天文学、物理学、化学に強みがあります。
- Universidad Nacional de La Plata (UNLP)、ラプラタ。正確科学・自然科学の重要拠点で、複数のCONICET研究ユニットがあります。
- Universidad Nacional de Rosario (UNR)、ロサリオ。医学、生化学、農学で注目されています。
- Universidad Nacional del Litoral (UNL)、サンタフェ。化学工学、食品技術、バイオテクノロジーに強みがあります。
- Universidad Nacional de Cuyo (UNCuyo)、メンドーサ。西部アルゼンチンの主要な研究大学です。
- Universidad Tecnologica Nacional (UTN)、複数キャンパス型。在籍者数で国内最大で、工学と技術に重点を置いています。
- Universidad Austral、ブエノスアイレス近郊。医学とバイオメディカル工学に強い有力な私立大学です。
- Universidad Nacional del Sur (UNS)、バイア・ブランカ。化学、化学工学、地球科学に強みがあります。
- Universidad Nacional de San Martin (UNSAM)、ブエノスアイレス州。バイオテクノロジーとナノテクノロジーで急成長しています。
- Instituto Balseiro、バリロチェ。アルゼンチン有数の物理学・原子力工学のエリート研究機関で、小規模ながら非常に生産的です。
- Instituto Tecnologico de Buenos Aires (ITBA)、ブエノスアイレス。コンピュータとデータサイエンスに強い私立の工学系機関です。
これらの機関すべてにおいて、CONICETのキャリアの前進とANPCyTの助成金競争により、英語での出版が職業上の必然になっています。つまり、毎年より多くの原稿が、より多くの検出器を経由することになります。
アルゼンチン研究者向けAI humanizerはどのように機能するか
アルゼンチン研究者向けAI humanizerは、ワークフローの最後の工程であり、単独のショートカットではありません。私たちが推奨する順序は次のとおりです。
まず、草稿作成です。多くのアルゼンチン研究者はスペイン語でより自然に考えるため、議論をスペイン語で組み立てたうえで英語へ翻訳します(私たちのAI translatorは引用をそのまま保持します)。次に、文法を校正します。そうすることで、上記の「記事」「前置詞」「false friend」のパターンが実際に正しくなります。第三に、自分でAI支援を加えた文章をtext humanizerに通し、注意深く当惑度の低い書き方が、機械出力として誤読される可能性を下げます。
humanizerは、あなたの意味、技術的な専門用語、引用を保持します。リズムと語彙の選び方を変え、反復的な語り口をほぐし、AI草稿が置き去りにしがちな「余計なemダッシュ」を取り除きます。
試験では、具体性をもって述べ、約束しすぎないようにしています。主要な検出器に対してテストすると、私たちのhumanizerはAI文章をより自然な人間の形に書き換えます。その結果AIのシグナルが低下し、難しい検出器に対する成功確率が高まる一方で、学術文における文法の精度は高く保たれます。これらは試験結果であり保証ではありません。検出器は数か月ごとに再学習されるため、検出不能であることを信頼できるツールとして約束できるものはありません。
次に、開示します。機関や対象の学術誌が求める形式で、あなたのAI利用を明記してください。誤検出フラグのリスクから守られた丁寧な文章と、完全な開示を組み合わせること、それが、整合性(integrity)ルールの範囲内にとどまるための要点です。人間主導の修正と比較したい場合はアルゼンチンの研究者向け学術編集をご覧ください。国全体の言語クラスターについては多言語AI humanizerハブにアクセスしてください。
地域の資金提供機関、学術誌、そしてAI開示への期待
アルゼンチンの研究者が最初に検出器へと導かれる「出版のプレッシャー」を作っているのは、主に2つの機関です。**CONICET(Consejo Nacional de Investigaciones Cientificas y Tecnicas)**は、5段階のキャリア制度のもとで11,000人超の研究者を雇用しており、前進にはScopusおよびWeb of Science収載ジャーナルでの継続的な出版が必要です。**ANPCyT(Agencia Nacional de Promocion de la Investigacion, el Desarrollo Tecnologico y la Innovacion)**は競争的助成金を運用しており、特にPICT(Proyectos de Investigacion Cientifica y Tecnologica)プログラムでは、あらゆる評価において国際的な出版が強く重視されます。
アルゼンチンにはまた、強固な学術誌の伝統があり、その多くはSciELO Argentinaに収載されており、さらにScopusおよびWeb of Scienceにも増えつつあります。アルゼンチンの著者がよく知る代表的な誌名には、以下が含まれます。
- Medicina (Buenos Aires)、ラテンアメリカで最も尊敬されている医学系学術誌の一つ。PubMedとScopusに収載されています。
- Ecologia Austral、アルゼンチン生態学会(Argentine Ecological Association)発の学術誌です。
- Latin American Applied Research、Universidad Nacional del SurとCONICETによって刊行されています。
- Revista de la Union Matematica Argentina、同地域で最も古い数学系学術誌の一つです。
- Ameghiniana、古生物学および地質学分野。
- Electronic Journal of Biotechnology、ラテンアメリカに焦点を当てたジャーナルです。
これらの学術誌がScopusへの収載を求める、または維持する中で、彼らはますます英語を好むようになっています。そして国際的な同業他誌と同様に、AI支援に関する声明を求めるよう、ますます強くなってきています。開示は率直に書き、ツール名を挙げ、何をしたのかを説明してください。もし、あなたの配慮にもかかわらず正当な研究に対して検出器のフラグが立つことがあれば、誤ったAI検出フラグへの異議申し立てのプレイブックが、証拠の集め方や委員会に対してどのようなトーンで臨むべきかを案内します。
よくある質問
Q: アルゼンチン研究者向けのAI humanizerは、Turnitinの不正行為を手助けしますか?
いいえ。これはあなた自身のAI支援草稿を対象にしています。その役割は、丁寧な第二言語の英語が機械文として誤読されないようにすることです。あなたは引き続き意味と引用を保持し、AI利用は機関および学術誌に対して開示します。実在する研究を誤検出フラグから守ることは、それを偽装することとは同じではありません。
Q: humanizeは、私の意味、技術用語、引用を変えてしまいますか?
いいえ。humanizerは、あなたの意味、技術的な専門用語、参照文献を保持しつつ、リズムと語彙の選び方を変えます。これは、検出器をつまずかせる統計的なパターンを滑らかにするために作られており、あなたの科学を書き換えたり、引用を移動させたりするためのものではありません。
Q: 実際にAI検出器をどれくらい通過できますか?
主要な検出器に対してテストすると、AI文章をより自然な人間らしい形に書き換え、AIのシグナルを下げることで難しい検出器に対する成功確率を高めます。その一方で、文法の精度は高く保たれます。これはテスト結果であって保証ではありません。検出器は頻繁に再学習されるため、深刻なツールであっても「二度とフラグが立たない」とは約束できません。
Q: 私の英語はすでに十分に強いです。なぜ検出器が私をフラグするのでしょうか?
「強い、標準的な英語」が問題の一部になり得ます。検出器はperplexityをスコア化し、注意深く、予測可能で、教科書どおりの言い回しは当惑度が低く読まれるため、彼らはそれを機械的な文章と結び付けます。アルゼンチンの高い熟達度が、文章をより均一にし得るためです。つまり、フラグされにくくなるどころか、むしろフラグされやすくなる可能性があります。
Q: 草稿をhumanizeするなら、AI利用はまだ開示すべきですか?
はい、常に。開示とhumanizeは別々の課題を解決します。humanizeは、丁寧な文章が誤読されることから守り、開示は資金提供者、委員会、学術誌に対してあなたの説明責任を果たします。両方を、毎回行ってください。
英語で発表するアルゼンチンの研究者のために、意味、用語、引用をそのまま維持しつつ、ご自身のAI支援による原稿での誤ったAIフラグを減らし、次に自信をもって開示してください。

Moe は、自然言語処理の PhD を持つ NLP エンジニアです。 彼の研究は計算言語学、テキスト分析、機械学習をカバーしており、それは ProofreaderPro の背後にある編集および人間化モデルに直接反映されています。 彼は、ほとんどの人が目にすることのないプロセスの部分、つまり言語モデルがどのように文を読み取り、スコアを付け、何を変更するかを決定するかについて書いています。


