
英語で執筆するイタリアの研究者のためのAI人間化(Humanizer)
イタリアの研究者向けのAI人間化ツール。イタリアの影響を受けた英語に対する誤ったAI検出フラグを減らし、意味と引用を保ちつつ、正直にAI利用を開示します。

イタリアは、研究成果の生産高で世界の上位8〜10か国に入るにもかかわらず、その多くがイタリア語で読者に届くことはほとんどありません。ここでは研究者が1つの言語で考え、執筆し、別の言語で発表します。というのも、イタリアの研究キャリアは、インデックス付きの英語論文誌を通じて進むからです。VQR(研究の質の評価)とASN(教授職のための国家資格)のいずれも、ScopusおよびWeb of Scienceにおける書誌計量上の閾値に依拠しているため、適切なジャーナルで英語論文を出すことは選択肢ではありません。
しかし、そのプレッシャーが、いま新しい問題と衝突しています。イタリアの研究者向けのAI人間化(humanizer)が存在するのは、注意深く正しい第二言語としての英語こそが、AI検出器に「機械が書いた文章」と見なされやすい種類の文体だからです。あなたの同僚が作業を行い、すべての単語を書いたにもかかわらず、それでもフラグが立ってしまった、そういうことが起きています。
本ガイドは「偽装」ではなく「公平さ」についてです。目的は、AI支援で作成した草稿を自分の文章として人間らしく整え、意味と引用をそのまま保持し、そのうえで、所属機関やジャーナルが求める方法に従ってAI利用を正直に開示することです。
英語で執筆するイタリアの研究者のためのAIテキスト・ヒューマナイザー(umanizzatore di testo IA)
当社のAIテキスト・ヒューマナイザーは、イタリアの研究者が英語で発表する際に、正しい書きぶりが「機械によって生成された文章」と誤認されることなく執筆できるよう支援します。意味、専門用語、引用を保持し、リズムと語彙選択を変えます。
平たく言えば、あなたが科学を記述し、ツールは、非ネイティブの標準的な文章が人工的に読まれる原因となる統計的な指紋を滑らかにします。あなたの主張、データ、参照文献が変わることはありません。変わるのは、一部の検出器が「機械のサイン」とみなすような、均一で予測可能なキャデンスだけです。
イタリア語で下書き?人間化ツールが直接検出して書き換える
英語に翻訳してからでなく、イタリア語の下書きを人間らしく整えることができます。テキストを貼り付けると、ProofreaderProが言語を自動判定し、その後、イタリア語に配慮したモデルを通して処理します。アクセント、専門用語、引用はその位置のまま保持されます。AIテキスト・ヒューマナイザー(umanizzatore di testo IA)として、イタリア語の文章のリズムを変えつつ、すべての発見と参照を保護します。自動検出は60以上の言語に対応しているため、イタリア語は英語へ「作り替える」のではなく、イタリア語として扱われます。
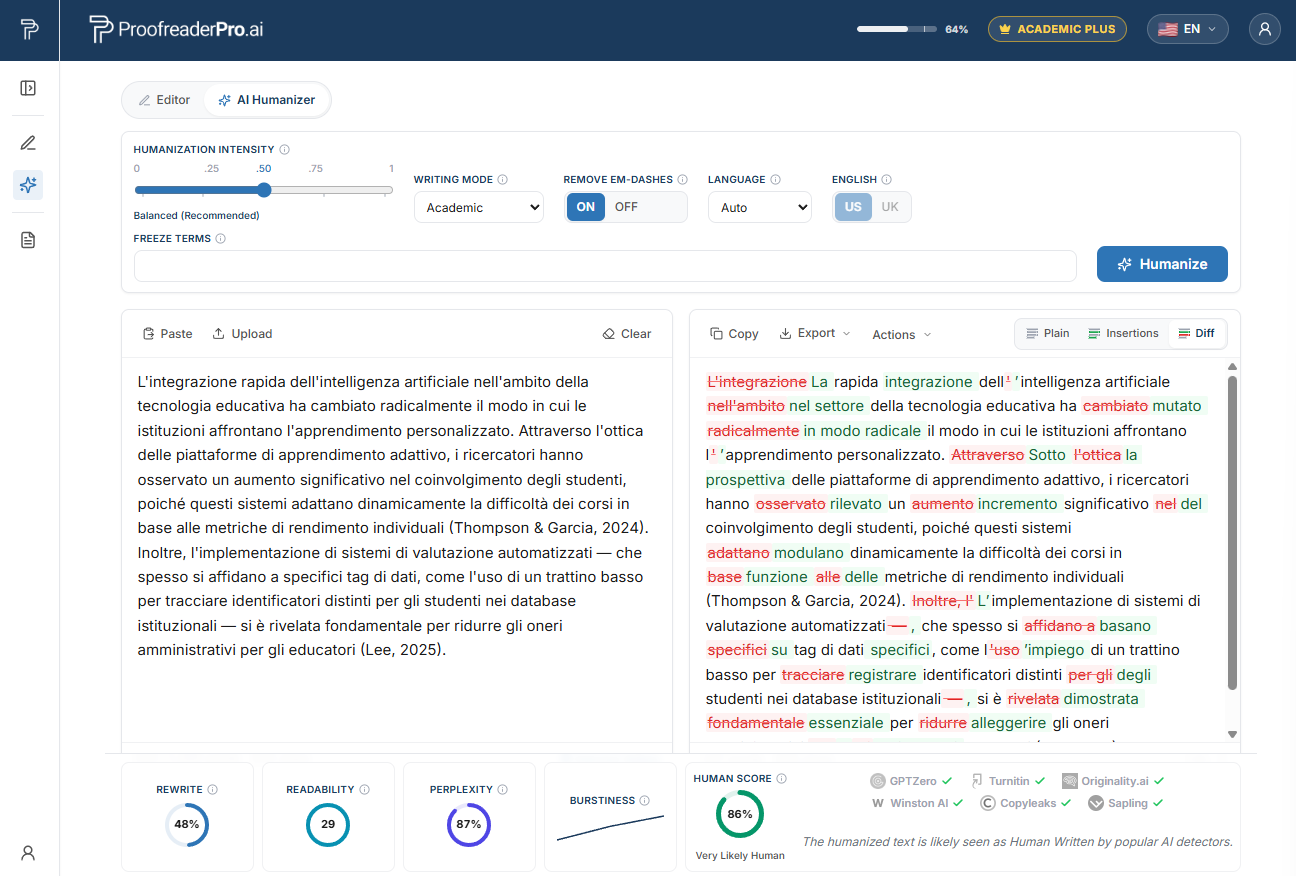
ProofreaderPro AI Humanizerによるイタリアの学術テキストの書き換え。before/afterの差分は意味と引用を保持し、検出チェックは自然で人間らしい読みを確認します。
なぜイタリアの研究者はAI検出器にフラグを立てられるのか
2023年、スタンフォード大学のLiangらのチームが、Cell Pressのジャーナル『Patterns』において、率直なタイトルの研究を発表しました。「GPT検出器は、非ネイティブ英語の執筆者に対して偏っている」。彼らは、人間が書いたTOEFLのエッセイを、広く使われている7つの検出器にかけました。
結果は、第二言語で発表するすべての人にとって心配なものです。平均すると、非ネイティブのエッセイの約61%がAIとしてフラグを立てられたのに対し、ネイティブ執筆者では約5%でした。さらに約19.8%においては、すべての検出器が一致してフラグを立てています。これらのエッセイはすべて人間が書いたものです。
この仕組みは「パープレキシティ(perplexity)」と呼ばれます。検出器は、言語モデルにとって各単語の選択がどれほど「意外」かを測定します。注意深い第二言語の執筆者は、よく使われる語や標準的で予測可能な言い回しを選ぶため、パープレキシティが低くなります。その結果、文章は機械文として読まれます。あなたの英語を明確にする習慣と、これらのツールが「罰する」ために学習された習慣は同じです。詳しくは why AI detectors flag non-native writing で解説します。
フォールスポジティブの背後にある「イタリア語が第1言語」由来のパターン
以下のどのパターンも誤りではありません。イタリアの学者が手に取る、丁寧で教科書的な構文です。そして、その非常に規則的な性質こそが、検出器には「低パープレキシティ」として読まれます。
長い従属節の連なる文(長い従属節型)。 イタリアの学術文体では、入れ子になった従属節が複数含まれる長い文(長いピリオド)を好みます。それが英語に置き換えられても文法的には成立しますが、内容は密になり、均一で過剰に整ったリズムがモデルにとって予測可能に見えてしまいます。
抽象名詞を伴う冠詞。 「自然」「科学」「社会」などを書き、英語では通常は冠詞を落とすところを、イタリア語から直接かつ一貫した形で持ち込むことがあります。この一貫性は、検出器が低スコアとして「報酬」を与えるまさにそのシグナルです。
前置詞の移し替え(transfer)。 dipendere da に対する depend from、または based on に対する on the basis of のように、体系的でルールに従った選択が行われます。体系的な選択は定義上、低パープレキシティになります。
名詞化とラテン語系の語彙(Latinate diction)。 the realization of the analysis のような重めの名詞句、そしてラテン語系の語彙を一定して好む傾向は、標準的なフォーマル・レジスターです。フォーマルで標準的であることが、まさにこれらのツールに引っかかります。
写し(calqued)調のコネクタ(接続詞)。 Moreover, Furthermore, In fact のような文頭での使用が頻繁で、イタリア語の談話マーカーに対応してそのまま写し取られると、規則的で繰り返しの多いキャデンスが生まれ、「機械が滑らかに書いた」ように読まれます。
紛らわしい類義語(false friends)。 currently へ向かうのではなく actually へ、または possibly へ向かうのではなく eventually へ、のように(attualmente は actually へ、eventualmente は eventually へ)注意深い書き手が最も標準的に見える語へ向けて行う修正です。最も標準的な語は、同時に最も「意外性が低い」語でもあります。
イタリアにおけるAI検出とTurnitinの文脈
イタリアの学位論文や原稿は、テキストの類似性について日常的にスクリーニングされます。多くの場合、TurnitinまたはiThenticateが用いられ、これらのツールは、馴染みのある類似性スコアとともにAIの兆候を表面化させる傾向が強まっています。類似性レポートは博士課程の学校や編集プロセスで一般的な実務ですが、それだけではあなたの誠実さについて何も述べられません。
視点を揃える上で重要なのは、次の2点です。第一に、AI指標は「判決」ではなく「主張」です。Turnitin自体も1〜19%の範囲のスコアを抑制し、単独の数値で誠実性の判断を決めるべきではないと警告しています。Vanderbilt、Michigan State、UT Austinなど複数の大学は、誤検知と非ネイティブ執筆者に対する偏りを理由に、AI検出器を完全に無効化しました。
第二に、イタリアでも他地域でも同様に、進む方向は「開示」です。助成機関やジャーナルはますます、どこでどのようにAIを使ったのかを明記するよう求めています。その期待こそがあなたの保護になります。完璧な検出器スコアではなく、適切な全開示が、あなたをルールの内側にとどめます。
あなたの文章を誤検知から守る
数分でAI支援による下書きを人間らしく整え、すべての引用を保持したまま、その後開示してください。慎重な非ネイティブ英語の学術執筆に最適です。
Humanizer を無料でお試しイタリアの主要大学と、AIチェックが現れる場所
上で述べたスクリーニングは、イタリアの主要な機関すべてで行われます。博士課程の学校や編集部門が、これらの大学では論文や原稿を類似性チェックにかけ、さらに近年ではAI指標の比重も高めています。
- Sapienza Università di Roma, in Rome
- Università di Bologna (Alma Mater Studiorum), in Bologna
- Politecnico di Milano and Università degli Studi di Milano (Statale), in Milan
- Università degli Studi di Padova, in Padua
- Università degli Studi di Napoli Federico II, in Naples
- Politecnico di Torino and Università degli Studi di Torino, in Turin
- Università di Pisa, Scuola Normale Superiore, and Scuola Superiore Sant'Anna, in Pisa
- Università degli Studi di Firenze, in Florence
- Università degli Studi di Trento, in Trento
- Università Cattolica del Sacro Cuore, in Milan
それぞれの機関において、フラグはあなたの「誠実さ」についての結論である前に、方法について話し合いを始めるサインです。こうしたチェックが日常的だと知っていることは、不安になる理由ではなく、準備する理由になります。
イタリアの研究者のためのAI人間化(AI humanizer)の仕組み
以下がワークフローであり、順序は重要です。
まず、あなたの主張を下書きします。考えが最も鋭くなる場所がイタリア語であれば、その言語で書き、その後英語に翻訳するか、あるいは最初から英語で直接下書きしても構いません。いずれにせよ、アイデアとデータはあなたのものです。
次に、文法を整えます。誤った友(false friends)、前置詞、冠詞の取りこぼしを修正し、他の作業が触れる前に言語がきれいな状態になるようにします。当社の校正ツールはまさにこの目的のために作られており、姉妹ワークフローは AI proofreading for Italian academics でも確認できます。
第三に、自分自身の文章を人間らしくします。AI支援で作成した草稿を AI text humanizer にかけてください。リズムや語彙選択を調整し、検出器につまずかせる反復的で低パープレキシティなキャデンスを取り除きつつ、意味、専門用語、引用を保持します。
人間化ツールは主要な検出器に対してテストされており、AIテキストをより自然な人間の形式へと作り直すことで、Turnitin、Originality.ai、GPTZero上では「人間らしい」読みとして表示されます。一方で、学術テキストにおける文法精度は高く保ちます。結果は約束ではなくテストに基づくものです。検出器は数か月ごとに再学習するため、何かを回避することを約束はしません。
第四に、開示します。AI利用は、所属機関や対象ジャーナルが求める形式で記載してください。この最後のステップが、「実際の仕事を公正に守る」ことと「偽装」とを分けます。
本記事は、multilingual AI humanizer hub にある当社のワンストップ拠点であり、第一言語が別の研究者にも同じワークフローを提供しています。より大きなニーズが検出器の公平さではなく、言語編集の全面である場合は、global academic editing hub から始めてください。
地域の研究助成機関、ジャーナル、そしてAI開示に関する期待
イタリアの研究助成や評価は、いくつかの機関を通じて進み、それぞれが「どこに掲載されるか」という論点の重要度を引き上げています。
MUR(Ministero dell'Università e della Ricerca)は、大学および国家レベルの助成を資金面で支えています。PRIN(Progetti di Ricerca di Rilevante Interesse Nazionale)は主要な競争的な全国制度です。CNR(Consiglio Nazionale delle Ricerche)は同国最大の公的研究機関です。ANVURはVQR評価とASN資格の両方を運用し、さらに、人文社会科学において実際に重みを持つクラスAのジャーナル一覧を維持しています。
配置(掲載先・評価対象)という観点では、ScopusおよびWeb of Scienceへのインデックス、そして書誌計量以外の分野におけるANVURのクラスAステータスが意味を持ちます。これらのジャーナルを目指す原稿は、TurnitinまたはiThenticateでスクリーニングされ、加えて、ジャーナルや助成機関のなかでAI利用の明示的なステートメントを求める数が増えています。そのステートメントは早めに準備し、もし検出器が「きれいな」原稿を誤ってフラグした場合には、そのレポートを判決としてではなく争える証拠として扱ってください。投稿前に AI text humanizer を一度通すことで、注意深い非ネイティブの文章はより公平に読まれやすくなり、開示が全プロセスを透明に保ちます。
よくある質問
Q: イタリアの研究者向けのAI人間化(humanizer)を使うことは、いわゆる不正行為(チート)ですか?
いいえ、自分自身の成果物に対して使う場合に限っては違います。あなたが研究を書きました。ツールは、丁寧な非ネイティブの文章のリズムと語彙選択をわずかに変えるだけで、「機械文」として誤読されにくくします。透明性を担保するためのルールは「開示」です。つまり、所属機関とジャーナルに対して、どのようにAIを使ったかをあなた自身が伝える必要があります。
Q: humanizerは、私の引用や専門用語を変えますか?
いいえ。参照文献、データ、そしてあなたの分野の用語を保持します。検出器が反応するのは、主張の中身ではなく低パープレキシティなキャデンスです。
Q: 私の論文はTurnitinやGPTZeroを確実に通りますか?
いいえ、そしてそのようなことを約束するツールには注意してください。私たちのテストでは、人間化ツールはAIテキストをより自然な人間の形式へと書き換え、AIシグナルを下げ、手強い検出器に対する通過率の見込みを高めています。ただし、検出器は絶えず再学習するため、保証ではなくテスト済みの結果として報告します。
Q: 正しい英語なのに、なぜフラグが立つのですか?
検出器は、あなたの単語選択がどれほど予測可能かをスコア化するからです。冠詞の使い方からラテン語系の語彙まで、標準的な教科書型の「イタリア語→英語」の構文は非常に予測可能で、結果として低パープレキシティとして読まれます。そして一部のツールは、それをAIの兆候とみなします。これは、あなたの仕事に対する評価ではなく、注意深い第二言語の執筆に対する記録された偏りです。
Q: 委員会やジャーナルが私の文章にフラグを立てた場合、何をすべきですか?
落ち着いて、フラグを「答えるべき主張」として扱ってください。結論ではありません。下書きやメモを保持し、非ネイティブ執筆者に対する記録された偏りを指摘し、AI利用の開示を共有します。検出器のスコアは争える証拠であって、証明ではありません。
慎重な非ネイティブ英語を、より公平に読み取れる形にします。意味と引用を維持し、誤ったAIフラグを減らし、そして自信を持って開示してください。

Moe は、自然言語処理の PhD を持つ NLP エンジニアです。 彼の研究は計算言語学、テキスト分析、機械学習をカバーしており、それは ProofreaderPro の背後にある編集および人間化モデルに直接反映されています。 彼は、ほとんどの人が目にすることのないプロセスの部分、つまり言語モデルがどのように文を読み取り、スコアを付け、何を変更するかを決定するかについて書いています。


