OpenAIのウォーターマーク、SynthID、Claudeの比較:テキストウォーターマークの違い
OpenAIはテキストにウォーターマークを付けるのか。一般公開されたOpenAIのウォーターマークチェッカーはあるのか。またSynthIDとClaudeのウォーターマークは学術執筆の観点でどう違うのか
OpenAI、Google、Anthropicはいずれも同じ技術を開発しています。AI生成テキスト向けの統計的ウォーターマークです。OpenAIは自社の方式を長年非公開にしていましたが、2026年10月にtextGrainとして展開を開始しました。GoogleはGeminiの中にSynthIDを組み込み、手法を公開しました。Anthropicは2026年8月に、Claudeのウォーターマークをすべての利用者に必須化しました。いかなる形であれAI支援で書く場合、この3つの判断が現在、あなたの文書がどのように評価されるかを左右します。
ウォーターマーキングは研究テーマから2026年8月11日の大手ニュースへと移りました。Anthropicが、すべての新しいClaudeモデルがテキスト出力に印を付けると発表したためです。その発表内容を、当社のClaudeウォーターマーク解説で詳しく取り上げました。本ガイドでは全体像を説明します。テキストウォーターマークとは何か、3つの主要ラボがそれをどのように実装したのか、または見送ったのか。そして各システムが、その文章のどの点を示せるのかを解説します。
AIテキストウォーターマークとは
AIテキストウォーターマークは、生成テキストの単語の選び方の中に隠された統計的なパターンです。検出器が適切な鍵を持っていれば、後からそのテキストが特定のAIシステムから生成されたものであることを検証できます。これは可視のラベルではなく、隠し文字でもなく、ファイルに付属するメタデータでもありません。この印は、単語そのものの中に存在します。
この違いが重要なのは、"ウォーターマーク"という用語が、異なる3つのものを雑に指して使われるからです。
| それは何か | どこに存在するか | コピーアンドペーストで生き残るか? | |
|---|---|---|---|
| 統計的ウォーターマーク | モデルが選ぶ語彙に対する偏り | テキストそのもの | はい |
| ファイルメタデータ(C2PA) | 署名付きの来歴ラベル | ファイルコンテナ | いいえ、プレーンテキストのコピーでは剥がれてしまいます |
| ゼロ幅文字 | テキスト内に挿入された見えないUnicode | 可視の文字の間に入る部分 | いいえ、単純に取り除けます |
3つのうちコピー、貼り付け、打ち直し、さらに新しいドキュメントへの貼り付けやフォーマット変換にも耐えて生き残るのは、統計的ウォーターマーキングだけです。そのため、3つの主要ラボはいずれもテキストにそれを採用する方向で収束し、また見えない文字を削除する「ウォーターマーク除去」では対抗できません。私たちの 無料のClaudeウォーターマーク除去 のページでは、この失敗パターンを出典付きで説明しています。
統計的ウォーターマーキングは実際にはどのように機能しますか?
文の作成のあらゆる段階で、言語モデルは互いにほぼ同等な複数の語から選びます。そしてウォーターマークは静かに、その選択に使うサイコロを読み込ませます。土台となるレシピは、2023年1月にメリーランド大学の Kirchenbauer らが 大規模言語モデルのためのウォーターマーク(ICML 2023)として公開しました。仕組みは次のとおりです。
- 各語が選ばれる前に、直前の語から導出された秘密鍵によって語彙が優先セットと中立セットに分割されます。
- モデルは、選択を優先セットへと押し動かします。「indicate」の代わりに「Suggest」。 「among」の代わりに「Across」。個々の選択は完全に自然に見えます。
- 鍵を保持する検出器は、テキストが優先セットに着地する頻度がどれくらいかを数えます。人間の文章は偶然によって期待される率になります。ウォーターマーク付きの文章はそれがはるかに高い頻度になり、統計的検定によってその食い違いが検出されます。
特定の単語だけでは何も証明できません。信号は、何十回から何百回もの選択の中で初めて現れます。そのため長い文章のほうが短い文章より検査しやすく、また検出は常に「はい/いいえ」のスタンプではなく確率的です。
Google DeepMindの本番システムは、2024年10月に Nature で 大規模言語モデルの出力を識別するためのスケーラブルなウォーターマーキング として公開されました。この研究では tournament sampling という手法で洗練されました。これにより、文章品質を十分に保ったまま、消費者向け製品に大規模に組み込んで、静かに動かせるほどに実用性が高まります。この論文はGoogleに限りません。Anthropicが Claude の実装で参照している、公開された根拠だからです。
最大の弱点は、ほとんどの導入が始まる前に公表されていました。2023年3月、Krishna らは 言い換えによりAI生成テキストの検出を回避できる(NeurIPS 2023)において、ある一節の言い回しを作り直すことで、ウォーターマーキングを含むあらゆる手法で検出が崩れることを示しました。信号は、正確なトークン列の中にだけ存在し、ほかのどこにもありません。そのため、その列を書き換えるものなら何でも、たとえ人間の編集者であっても、証拠を消してしまいます。今日ウォーターマークを提供するあらゆるベンダーは、その制限をそれぞれのドキュメント内で明記しています。
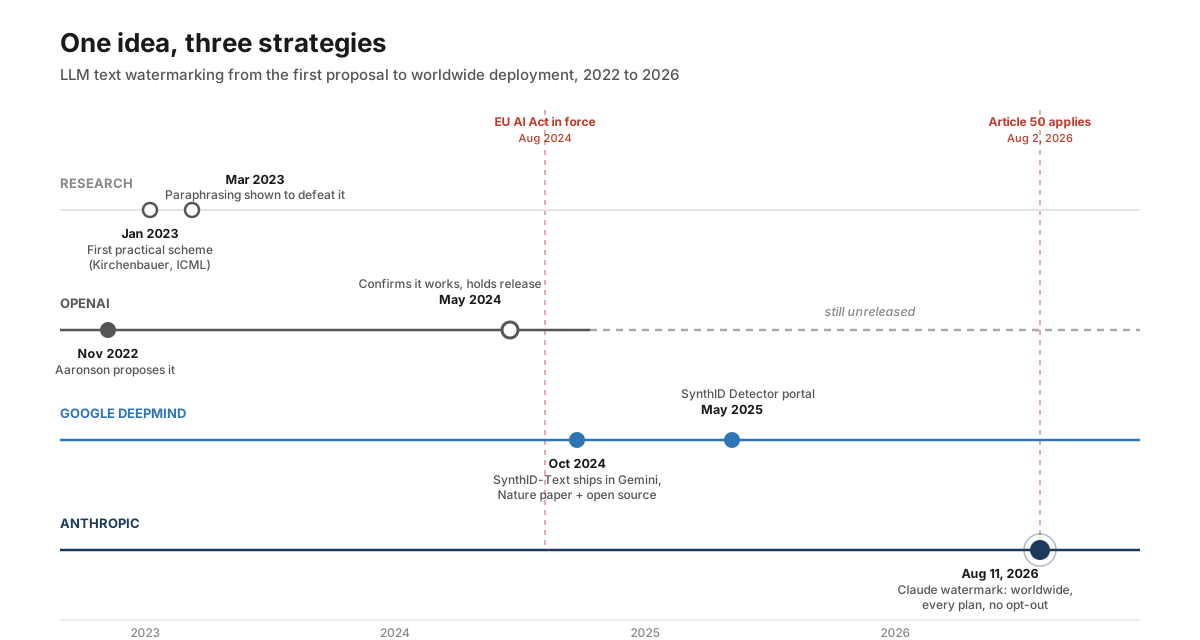
それを発明し、最後に出荷した企業であるOpenAI
OpenAIは長年にわたりテキストのウォーターマーキングを実用化できていたのに、2026年10月になるまで公開しないことを選びました。当時OpenAIで安全性の取り組みに携わっていた Scott Aaronson は、そこでの構想を初めて一般向けに公に説明したのは、2022年11月の講演 でした。この手法は、秘密の暗号学的関数を用いて、互いにほぼ同等な語の間でモデルの選択にバイアスをかけます。そのため、テキストそのものが「出どころ」を示すことになります。この講演は、導入済みのあらゆるシステムよりも前のものです。
2024年5月、OpenAIはプロベナンス更新情報の中で、プロジェクトの状況を説明しました。私たちがオンラインで目にしたり聞いたりするものの出どころを理解する。同社は、テキストのウォーターマーキング手法が小規模な改変に対して正確で効果的だと述べましたが、トレードオフを見極めるためにリリースを保留していました。OpenAIが挙げた2つのリスクは、学術ライターにとって直接関係があります。
- 簡単な回避。 テキストを言い換えたり翻訳したりすると、印が消えるのは、2023年の研究が予測したとおりです。存在を知らない人の多くにしか引っかからないようなウォーターマークでは、強い施行手段にはなりません。
- 非ネイティブ英語話者への不均衡な影響。 OpenAIは、ウォーターマーキングによって、第二言語で書く人が文章作成の補助としてAIを正当に使うことが、偏見や烙印につながり得ると述べています。AI検出器が非ネイティブの書き手にフラグを立てる理由で扱っている内容は、検出側の観点から見た同じ問題です。
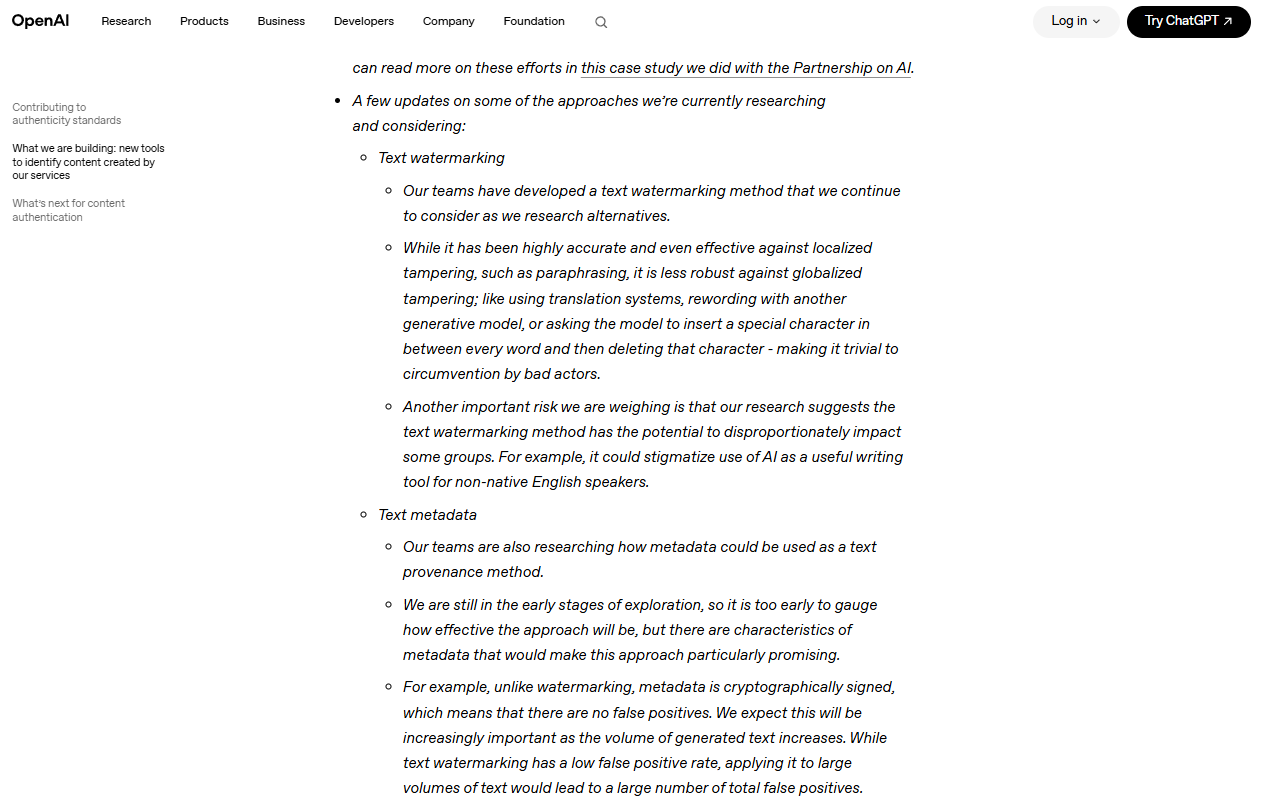
OpenAIの2024年のプロベナンス更新情報: 手法は機能しており、その時点で同社が採用を見送った理由も列挙されている。
画像と音声については、OpenAIは別の方針を取りました。DALL-EとSoraの出力にC2PAのプロベナンスメタデータを付与し、コンテンツ内の「印」ではなく「ファイル単位のラベル」としています。テキストの場合、ChatGPTの出力にはウォーターマークがなく、2026年10月までは導入されませんでした。この技術を提案した企業は、その3社のうち最後に実装した企業でした
OpenAIは今、テキストにウォーターマークを付けていますか?
はい。OpenAIはEUのAI Actへの対応として、2026年10月5日から一部のテキストにウォーターマーク付与を開始しました。その発表では、textGrainというテキスト・ウォーターマークが導入されるとしています。モデルが単語を選ぶ際に、見えない統計的な信号を追加するものです。ロールアウトは3つの段階で行われ、ウォーターマークはグローバルな標準設定ではありません:
- APIの利用者であれば、どこでも対象モデルに限り、ウォーターマーク付き出力をオンにできます。デフォルトではオフのままです。
- その後の数週間で、欧州連合内の対象となるChatGPTおよびCodexのテキスト出力にウォーターマークが適用されます。すべてのプランで対象になります。
- 承認された研究者および専門組織は、テキスト・ウォーターマーク検出器へのアクセスを申請できます。
OpenAIは、textGrainが検証した他の手法、Googleのテキスト向けSynthIDを含むものと比べて、同等以上または上回る性能だったと言っています。また、検出が弱くなる領域についても公開しています。誤検知率1%の条件では、心理学コンテンツの200トークンの文章で約80%、400トークンの文章で約95%の割合でウォーターマークを検出しました。単語選択の自由度が低い数学では、検出は大幅に低下しました。
編集によって信号は急速に弱まります。400トークンの文章で、単語の10%を類義語に置き換えると、検出は約92%から66%に下がり、25%置き換えると17%にまで下がりました。
OpenAIはさらに、最新モデルであるAstraにおいてウォーターマークが回答品質を変えるかどうかも確認し、有意な差は見られなかったと述べています。同社が公開したベンチマークのうち4つは次のとおりです:
| ベンチマーク | ウォーターマークなし(Astra) | ウォーターマークあり(Astra) |
|---|---|---|
| Artificial Analysis Intelligence Index | 49.57ポイント | 49.76ポイント |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
学生にとって重要なのは日付です。ロールアウト前に書かれたChatGPTのテキスト、またはAPI設定なしでEU外で作成されたテキストには、OpenAIのウォーターマークは付きません。暫定的な期間に、学校が独自のAI利用方針をどのように定めているかについては、Turnitin Clarityを解説に関するガイドをご覧ください。
一般公開されているOpenAIのウォーターマーク検査ツールはありますか?
現時点では、テキスト用のOpenAI公開ウォーターマーク検査ツールはまだありません。OpenAIの無料の検証ツールは、C2PA Content CredentialsおよびSynthIDウォーターマークについて、画像や音声ファイルをチェックします。OpenAIは、対応している画像や音声にOpenAIが埋め込むSynthIDウォーターマークが対象だと説明しています。OpenAIは、このツールはテキストに対応していないとも述べています。
テキストについては、OpenAIは、承認された研究者および専門組織に対して、Content Provenance APIフォームを通じて検出器アクセスをケースバイケースで提供しています。OpenAIは、見落としによるウォーターマークの取り逃しや誤検知のリスクがあるため、立ち上げ時点でテキスト検出器を一般公開しないとしていると述べています。検出器はOpenAIのウォーターマークを見つけたかどうかを報告し、ユーザーの特定やプロンプトの表示は行いません。
| 確認したい内容は何ですか | ツール | 誰が利用できますか |
|---|---|---|
| OpenAIの画像または音声ファイル | OpenAIの検証ツール | 誰でも利用可能、無料 |
| OpenAIのテキスト出力(textGrain) | OpenAIのテキストウォーターマーク検出器 | 申請により、承認された研究者および専門組織 |
| Claudeのテキスト出力 | Claude Watermark Detector | 申請により利用可能な組織(当社のAnthropicのClaudeウォーターマークの解説(2026年)をご覧ください) |
OpenAIは、結果で分からないことについてもはっきりしています。検出されたウォーターマークは、どれだけの寄与があったかを測るものではなく、誰がその文章を書いたのか、または誰が使用したのかも特定しません。ウォーターマークが見つからないことも、人間の著者性を証明しません。テキストは短すぎたり、編集されたり、翻訳されたり、対応していないモデルからのものだったりして、見つからない場合があるためです。
Google: 最初に提供してから、レシピを公開した
Google DeepMindが先に提供し、完全な内容を公開してから、その方法をオープンにしました。同社のシステムSynthIDは、2023年に画像のウォーターマークとして始まり、2024年にテキストへ拡張されました。2024年10月にNatureの論文が掲載される時点では、SynthID-TextはすでにGeminiの本番環境で稼働しており、消費者向けの規模で展開された最初の統計的テキストウォーターマークでした。
SynthIDはテキスト、画像、音声、動画をカバーし、2024年10月からGeminiのテキスト出力で稼働しています。
その後Googleは、実装をHugging Faceでオープンソースとして公開し、任意の開発者が自分のモデルに同じウォーターマーキング方式を適用できるようにしました。2025年5月には、SynthID Detectorを発表しました。これは、コンテンツをテキスト、画像、音声、動画にわたってSynthIDの印で検証できる検証ポータルです。
重要な制約があります。SynthIDはGoogle自身のモデルによるコンテンツに対してのみ印を付け、また検出できるのはその範囲に限られます。ChatGPTやClaudeの出力については何も言えず、SynthIDの走査がクリーンであっても、そのテキストが人間によって書かれたことを意味しません。意味するのは、Googleのモデルがそれを書いたのではないという、はるかに限定された主張です。
Anthropic: 最後に動き、最も厳格な方針
Anthropicは最も遅く導入しましたが、カバレッジは最大です。2026年8月2日以降に開始されたすべてのClaudeモデルは、そのテキスト出力に統計的ウォーターマークを世界中で、あらゆるプランで埋め込みます。オプトアウトはありません。同社は仕組みを解説で説明しており、そのHow Claude's text watermark worksと、ポリシーの適用範囲はヘルプセンター記事How Claude marks AI-generated contentに記載されています。対象にはClaude API、claude.ai、Claude Code、Claude Cowork、Claude Tagがすべて含まれます。締め切りより前に開始されたモデルは移行期間にあり、Anthropicはそれらにも同様のマーキング対応を追加していると言います。統計的な印に加えて、Claudeで生成したファイルにはC2PAメタデータも付与されます。これは、プレーンテキストのコピーで失われる別系統の2つ目の仕組みです。
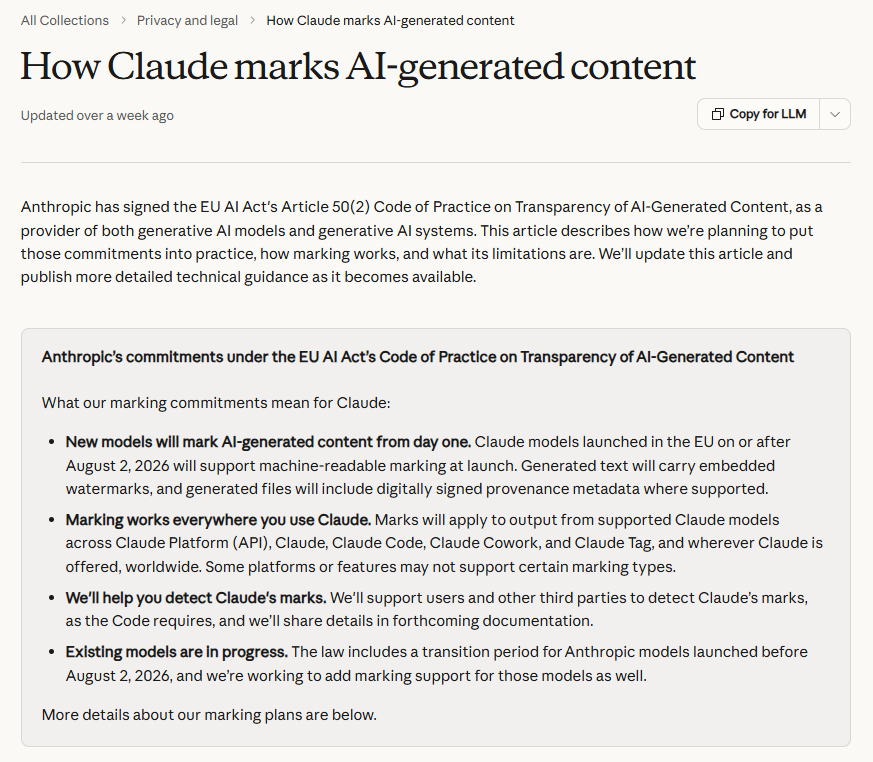
Anthropic自身の言葉による方針: 新しいモデルはすべて、すべてのプラットフォームで、世界中で。古いモデルは追加される.
Anthropicのドキュメントは限界を明確に述べています。検出は確率的です。このマーキングは、Claudeが書いた文書と、人間が書いてClaudeが軽く編集した文書を区別できません。完全な書き直しをするとそれが消えます。私たちは、肯定的な検出が実際に何を証明するのか、また自分の文章がマーキングされた場合に何をすべきか、これらを含めてすべて確認しました。専用のClaudeウォーターマークガイド.
タイミングは規制に沿っています。Anthropicは、EU AI Actの下で、AI生成コンテンツの透明性に関するArticle 50(2)の実務規範に署名しており、生成AIシステムの提供者には「機械可読な形式でマークされ、人工的に生成されたものとして検出可能であること」を出力に確実に適用することが求められています。この透明性に関する義務は2026年8月2日に適用されました。これは一般公開の9日前にあたる、Anthropicのモデル方針における正確な締切日です。Anthropicは、EU向けトラフィックに対して挙動を分けるのではなく、世界規模で対応することを選びました。Googleは設計上すでに準拠しています。OpenAIの未マークのテキスト出力は、2027年に向けたオープンクエスチョンです。
3つのアプローチを並べて比較
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| テキストウォーターマークは展開済み? | はい(textGrain、EUは2026年10月5日から展開) | はい(Gemini、2024年10月から) | はい(Claudeモデル、2026年8月2日から) |
| 手法 | textGrainは、語の選択における統計的シグナル | SynthID-Textによるトーナメントサンプリング | 統計サンプリングのマーキング。SynthID方式 |
| カバレッジ | 対象はEUのChatGPTおよびCodexテキスト。APIは全世界でオプトイン | Googleのモデルのみ | 新しいすべてのClaudeモデル。古いモデルは移行中 |
| オプトアウト | APIではデフォルトでオフ | いいえ | いいえ |
| 公開検出器 | いいえ | SynthID Detectorポータル(2025) | 予定中で未リリース |
| 方式は公開された? | 概念講義のみ | Nature論文 + オープンソース | 公開済みの研究に基づく解説 |
| ファイルメタデータ(C2PA) | はい、画像と音声 | はい、メディアをまたいで | はい、生成ファイル上で |
| 明示された制約 | 回避、ESLの偏見 | 自社モデルに限定した範囲 | 確率的で、編集によって著者性がぼやける |
各列に共通しているパターンは次のとおりです。OpenAIはテキストのウォーターマーキングを未解決のポリシー問題として扱い、Googleは標準化するためのインフラとして扱い、Anthropicは完全に実装すべきコンプライアンス上の義務として扱っています。
それが研究者や学術ライターに意味すること
実際の影響は、どのツールがあなたの文章に触れるかで変わります。ChatGPTで下書きすると、現時点ではその文章にウォーターマークは付きません。Geminiで下書きすると、SynthIDのマークが付きますが、読み取れるのはGoogleの検出器だけです。現在のClaudeモデルで下書きまたは編集すると、Anthropicのマークが付きます。これをオフにする設定はありません。
学術ライターが知っておくべき3つのこと:
ウォーターマークは著者ではなくツールを特定するものです。 すべてのベンダーが自社のドキュメント内でこれを述べています。機関のポリシーが常にこの違いを反映しているとは限らないため、繰り返す価値があります。テキストは、AIが下書きしたためにマークされる場合もあれば、AIがその2文を校正したためにマークされる場合もあります。あるいは、マークされた段落が引用されたためにマークされる場合もあります。機関がウォーターマーク検査を実施しているなら、その検査で証明できるのは、特定のモデルがある時点でそのテキストに触れたという事実だけであり、それ以上のことは分かりません。重要になる場面でその主張を行う方法は、誤ったAI検出フラグを不服申し立てする方法で解説しています。
ウォーターマークとAI検出器は別の技術であり、失敗の仕方も異なります。 TurnitinやGPTZeroのような検出器は、統計的な文体から推測します。これは私たちが記録した精度の問題によって左右されます。ウォーターマーク検出は鍵に基づくテストで、未マークの人間の文章に対する誤検知率は非常に低いのが特徴です。一方で見逃し(false negative)の非対称性は逆になります。ウォーターマークチェックは、非ウォーターマーキング型のモデルが生成したAIテキストを見落とします。現在、その対象にはすべてのChatGPTが含まれます。
開示が依然として最も強力な立場です。 ウォーターマーキングは、無言でのAI利用のリスクを高めますが、開示されたAI利用は安全になります。開示されたワークフローには、肯定的なマークから恐れるものがないためです。現在、多くの学術誌や大学にはAI利用に関する明確なポリシーがあります。私たちのAI利用ポリシーでは、当社ツールの中でその線引きをどのように行うかを説明しており、透明性のある利用がどのようなものかという点で、妥当なテンプレートになります。
テキストのウォーターマークを除去するもの、除去しないもの
書き直すと除去できますが、体裁変更では除去できません。コピー、貼り付け、フォント変更、ファイル形式の変換、不可視文字の削除はすべて、統計的なウォーターマークを完全に残します。なぜなら、そのマークは単語の選択に埋め込まれているからです。除去できるのは、文章を生成し直すようなもの、つまり深い人手の編集、翻訳、あるいは本物の言い換えです。これがNeurIPS 2023の頑健性に関する研究で、これらのシステムが出荷される前に示されました。
ここでは両方向が重要です。マークが消えたからといってその文章があなたのものになるわけではなく、マークが残ったからといってあなたのものではないとは限りません。AIによって書き直された草稿であっても、所属機関の開示ルールは適用されます。当社のAI text humanizerは、AI支援の草稿を自然な学術表現に書き換えます。そしてこのプロセスではトークン列が再生成されるため、統計的マークは生き残りません。特にClaudeの文章については、claudeの透かし削除が事実、数値、引用を変えずに、すべての文を新しい言い回しで再表現します。どのツールでも変えられないのは、読者に対してあなたが負うものです。文書がどのように作られたかについての透明性です。
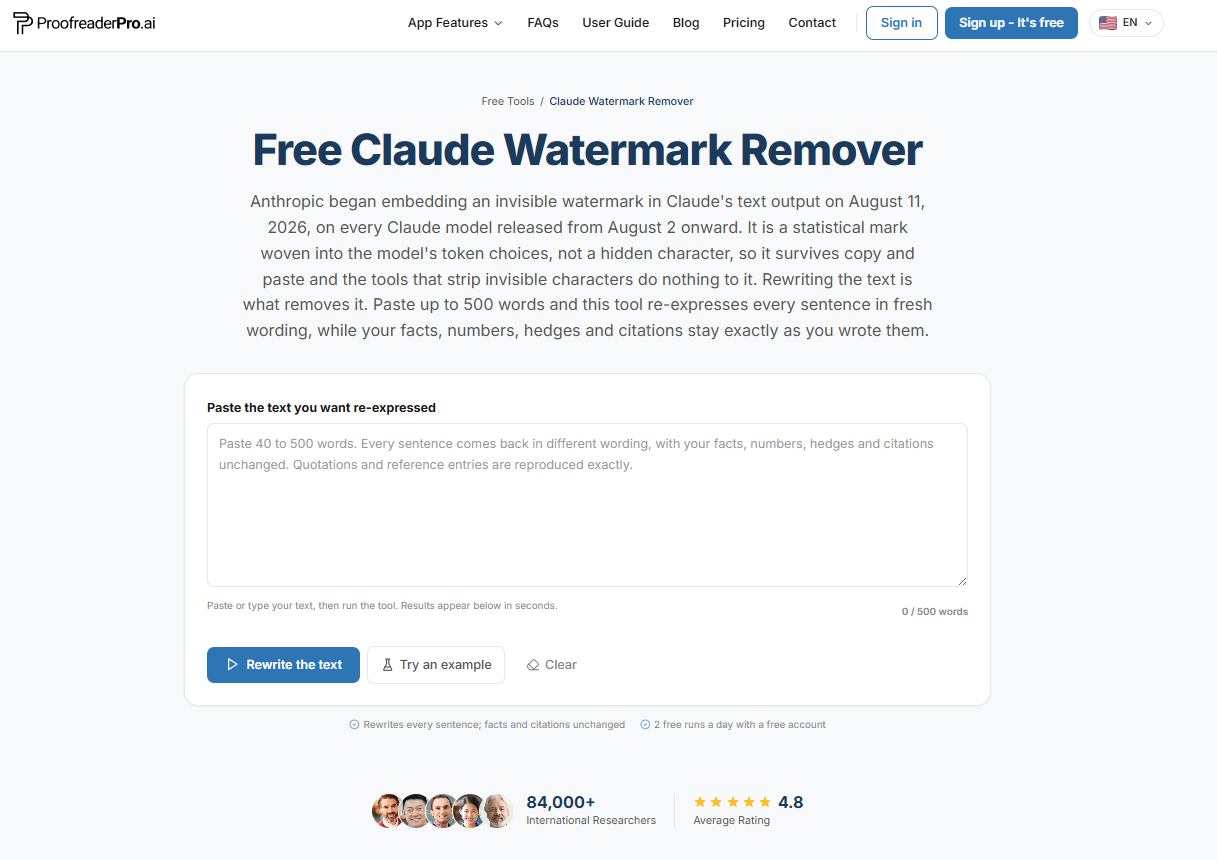
書き換えは統計的マークを取り除く唯一の操作であり、このツールが文ごとに行うことです。
次にどうなるか
2027年までに、次の3点を見届けてください。まず、OpenAIがテキストをテキストGrainで水印化できるかどうかがEUを超えるかです。ここが起点になったのは、EUのArticle 50の執行によりAIテキストには機械可読なマークが必要だからです。次に、検出が収束するかどうかです。もし主要なすべての研究機関が公開された方式で水印を付けるなら、大学は書きぶりから推測するのではなく鍵を確認できます。これは現在の誤検知が起きやすい検出を改善することにつながります。第三に、マークが互換になるかどうかです。今日では3つの研究機関が3つの異なるマークを使っており、単一のチェックでそれらすべてをカバーできません。C2PAはファイルについてはそのギャップを埋めますが、生のテキストについてはまだ何も埋めていません。
ChatGPTは自分の文章に水印を付けますか?
はい、一部は2026年10月5日以降です。OpenAIは、欧州連合内の対象となるChatGPTおよびCodexのテキストに対して、textGrainウォーターマークの追加を開始しました。APIの利用者なら、どこにいてもオンにできます。水印は単語選びに含まれる統計的なシグナルで、隠し文字はありません。OpenAIはさらにDALL-EとSoraのメディアファイルに対してC2PAの真正性メタデータを適用していますが、これは別のファイル単位の仕組みです。
Google Geminiは自分の文章に水印を付けますか?
はい。Geminiの出力には、2024年10月以降、Google DeepMindのSynthID-Textウォーターマークが含まれています。これは単語選びにおける統計的マークで、読者からは見えず、GoogleのSynthID Detectorで確認可能です。Google自身のモデルにのみ適用されるため、SynthIDでの否定的な結果は他のAIシステムのテキストについて何も意味しません。
Claudeは自分の文章に水印を付けますか?
はい。2026年8月2日以降にリリースされたすべてのClaudeモデルは、あらゆるプラットフォームとプランで、出力テキストに統計的ウォーターマークを埋め込みます。オプトアウトはありません。また、Claude-generatedのファイルには加えてC2PAメタデータも付与されます。これより前にリリースされたモデルはまだ出力にマークを付けていません。Anthropicは、移行期間中にそれらへのマーク付け対応を追加しているところだと述べています。詳しい情報は、当社のClaudeウォーターマーク解説をご覧ください。
大学はAIの水印を検出できますか?
ベンダーの協力がある場合に限ります。検出にはベンダーの鍵が必要だからです。GoogleはSynthIDコンテンツ向けの公開検出ポータルを提供しています。Anthropicは、ユーザーや第三者向けの検出サポートを予定しているものの、まだ公開の検出器はリリースしていません。現在、主流の剽窃チェック用スイートは、どの研究機関の統計的ウォーターマークでも検証できません。そのため機関としての「AI検出」は、今日では依然として書きぶりによる推測であり、ウォーターマークの検証ではありません。
AIの水印付けは法律で義務付けられていますか?
EUでは実質的にそのとおりです。EU AI Actの第50条(2)では、生成AIの提供者に対し、出力を機械可読な形式で表示し、人工的に生成されたものとして検知可能にすることが求められており、透明性に関する義務は2026年8月2日から適用されます。Anthropicは関連する行動規範コードに署名し、世界規模での遵守を選択しました。2027年に、規制当局がOpenAIの未公開テキスト用ウォーターマークをどう扱うのかが注目点です。
AIウォーターマークは翻訳で生き残るか?
いいえ。統計的ウォーターマークは、モデルが選んだ単語の正確な並びの中に存在し、翻訳ではすべての単語が置き換わります。深い言い換えや大幅な人手による編集でも同様です。こうした制約は査読付きの文献で記録され、ウォーターマークを搭載して提供するすべてのベンダーによって認められています。
テキスト用のOpenAIウォーターマーク検査ツールは公開されていますか?
いいえ。OpenAIの公開されている検証ツールは、画像と音声ファイルのみを確認します。C2PAメタデータとSynthIDウォーターマークも対象です。OpenAIは、テキストには対応していないと述べています。テキスト用のウォーターマーク検出は、承認された研究者および専門組織に対してのみ、ケースバイケースで公開されます。
textGrainとは何ですか?
textGrainはOpenAIのテキスト用ウォーターマークで、2026年10月5日に発表されました。モデルの単語選択に目に見えない統計的な信号を追加するため、その印は単語の一部になり、隠し文字やファイルのメタデータはありません。OpenAIは、テストした他の手法の少なくとも同等、または上回る結果が出たとしており、テキスト向けのSynthIDも含まれます。そして編集はその強度を弱めるとも述べています。
研究者はOpenAIのテキスト用ウォーターマーク検出器へのアクセス申請できますか?
はい。承認された研究者および専門組織は、OpenAIのContent Provenance APIフォームを通じて申請できます。OpenAIはEUの行動規範コードのもとで、ケースバイケースにてアクセスを付与します。OpenAIは、技術とエビデンスが進展するにつれて、より広いアクセスを見直すとも述べています。
出典
- Anthropic, Claudeのテキスト用ウォーターマークの仕組み, 2026
- Anthropic Help Center, ClaudeがAI生成コンテンツに付加する方法, 2026
- OpenAI, オンライン上で私たちが目にし聞くものの出どころを理解する, 2024年5月
- Google DeepMind, SynthID
- Dathathriら, 大規模言語モデルの出力を識別するためのスケーラブルなウォーターマーキング, Nature, 2024年10月
- Google, SynthID Detector発表, 2025年5月
- Hugging Face, SynthID Textの導入, 2024年10月
- Kirchenbauerら, 大規模言語モデルのためのウォーターマーク, ICML 2023
- Krishnaら, 言い換えはAI生成テキストの検出器を回避する, NeurIPS 2023
- Scott Aaronson, UT効果的利他主義向け私のAI安全講義, 2022年11月
- 欧州連合, AI Act 第50条
- C2PA, コンテンツ・プロヴェナンスと真正性のための連合
Dana は ProofreaderPro のコンテンツ クリエイターで、毎日のブログと執筆活動を行っています。 彼女はオンライン編集プラットフォームがどのように機能するかについて記事を書き、毎日顧客メッセージを処理しており、その満足度スコアは 5 つ星です。