
フィリピン人研究者のための英語AIヒューマナイザー
フィリピン人研究者向けのAIヒューマナイザーです。フィリピンの影響を受けた英語で、誤ってAI検出フラグが立つ可能性を下げつつ、意味と引用を維持し、利用は正直に開示します。

フィリピンは急成長を続ける研究国で、科学分野のアウトプットにおいて世界でおおむね50〜60位に位置し、出版数は年あたり約13.43%のペースで増加しています。約2,000の高等教育機関が、380万人の学生に対応しており、アジアでも最大級の教育システムの一つです。フィリピンの研究者は英語で執筆・発表しており、しかも英語はここでの指導用の公用語であるため、多くは流暢に書いています。
では、なぜフィリピン人研究者のためのAIヒューマナイザーが必要なのでしょうか。理由は明確です。訓練されたフィリピン人ライターが作り上げるような、丁寧で標準的な学術英語が、機械で書かれた文章としてAI検出ツールに誤読されるケースが増えているからです。卒論や学術誌への投稿原稿をスキャンするツールは、誠実さを測りません。測るのは、あなたの文がどれだけ予測可能かどうかであり、予測可能性こそが、規律ある第二言語の書き手が目指すものです。
このズレこそが、このページの全てです。あなたの英語が問題なのではありません。検出器がスコアリングする“仕組み”が問題なのです。
フィリピン人研究者のためのAIテキスト・ヒューマナイザー(Humanizer ng tekstong AI para sa mga mananaliksik na Pilipino)
私たちのAIテキスト・ヒューマナイザーは、フィリピン人研究者が英語で書いた国際ジャーナルへの投稿を、意味・技術用語・研究の参考文献(サンガンニアン)を失わずに行えるよう支援します。
平たく言えば、私たちのヒューマナイザーは、AI支援で作成した英語ドラフトを“実際に人が書く文章”の読み味に整えるのを助けます。その結果、丁寧な非母語の文章であっても、誤ってフラグを立てられる可能性を低減できます。リズムや語彙の選び方を調整し、反復的な語り口(カデンツ)を削り、引用や技術用語を、あなたが配置した場所のまま維持します。
これは、自分のものではない作業を“偽装”するためではなく、実在の研究者が実際に書いた研究のために作られています。章を任せる前に、まずは1つの段落で text humanizer を試してみてください。
フィリピノ語で下書きしますか?人間化は検出・処理にも対応
フィリピン人研究者は、学術英語へ移る前にフィリピノ語で下書きをすることがよくありますが、ヒューマナイザーはそれを直接サポートします。フィリピノ語のテキストを貼り付けるとProofreaderProが自動で言語を検出し、その後、あなたの専門用語と引用をあなたの配置したとおりに保つ、言語に配慮したモデルにルーティングします。AIテキスト・ヒューマナイザー(humanizer ng tekstong AI)として、英語のドラフトと同様にフィリピノ語のドラフトにもそのまま適用できるため、翻訳の前に“人間らしく”できます。同じ検出は60以上の言語を対象とし、それぞれが“その言語のまま”書き換えられます。
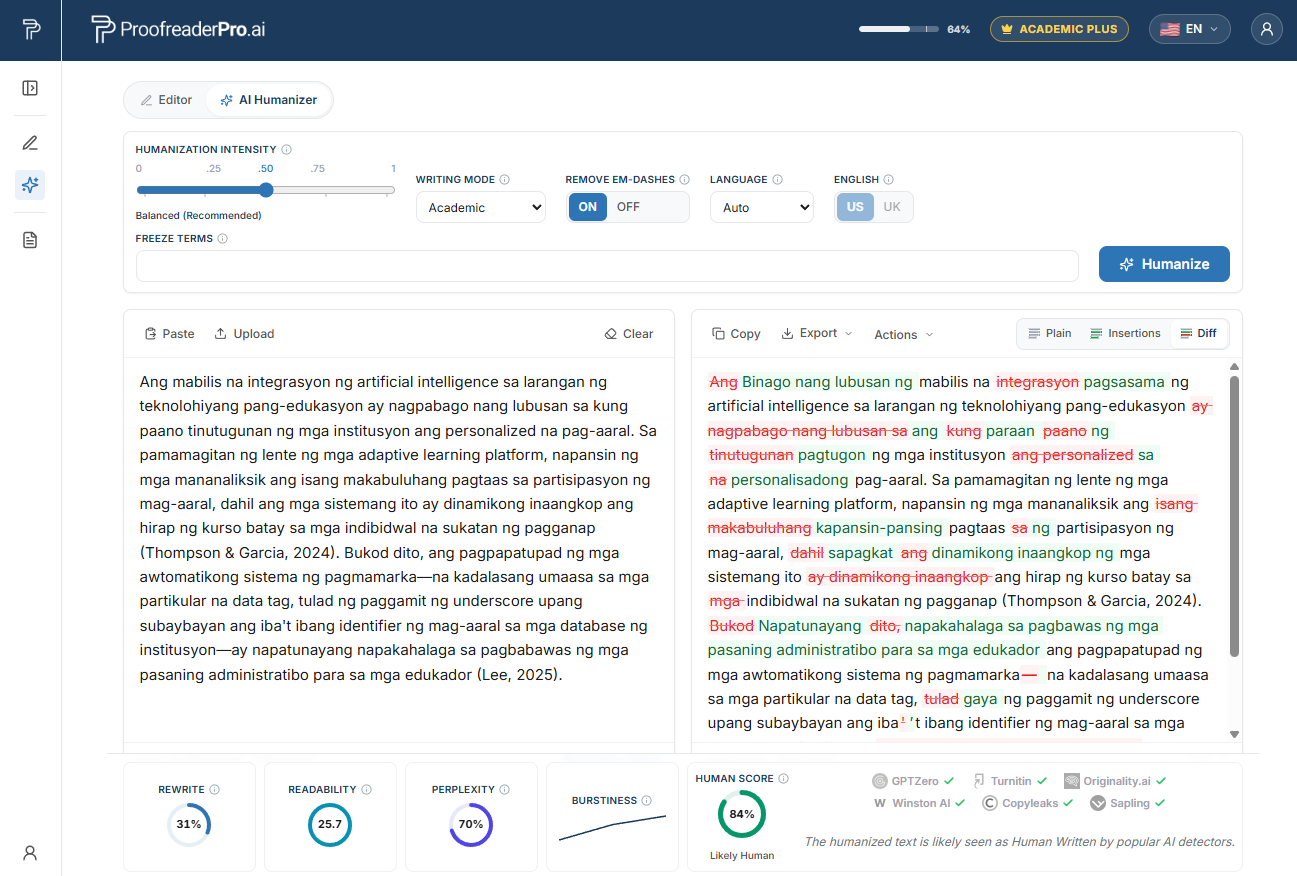
ProofreaderPro AI Humanizerがフィリピノ語の学術テキストを書き換える様子。ビフォー/アフターの差分(diff)は意味と引用を保持し、検出チェックが自然な“人が読む”文章であることを確認します。
なぜフィリピン人研究者はAI検出器にフラグを立てられやすいのか
2023年、Liangと共同研究者によるスタンフォードのチームが、Cell Pressのジャーナル『Patterns』に「GPT detectors are biased against non-native English writers」という研究を発表しました。彼らは、広く使われている7つのAI検出器に、人が書いたTOEFLのエッセイを投入しました。その結果、非母語のエッセイでは平均で約61%がAIとしてフラグされる一方、母語英語の書き手では約5%でした。さらに、5件に1件近くの非母語エッセイが、すべての検出器によって“全員一致”でAIとフラグされています。すべてのエッセイは人間が執筆したものでした。
これは“パープレキシティ(perplexity)”と呼ばれます。検出器は、言語モデルにとって各語の選択がどれほど意外(驚き)かを測定します。標準的で予測可能な定番フレーズの中で、よく使われる語を選んで書けば、パープレキシティは低くなります。低いパープレキシティは機械的な文章として読まれます。これらのツールは、非母語の学術文を明確にするまさにその習慣を罰するよう訓練されてきました。
これは単なる“根拠のない不満”ではありません。説明できないAIフラグが返ってくるため、多くの丁寧なフィリピン語圏の原稿が困っているのはこのためです。詳しい分析は、why AI detectors flag non-native writers で扱います。
偽フラグの背景にあるフィリピン語の第一言語(L1)パターン
フィリピン人研究者は、少し特殊な立ち位置にいます。英語は公用で日常的に使われるため、基本的な流暢さは高いからです。しかし、(タガログ語)Filipino、セブアノ語、イロカノ語、イロイロンゴ語といった言語からの特定の転移パターンが、フォーマルな文章の中に表れます。そして、それを管理するために、注意深い書き手は最も安全で標準的な英語の形を選びます。ところが、その“安全さ”こそがパープレキシティを下げてしまうのです。どのように起きるかを示します。
文法規律(Article discipline)。 フィリピン諸語には、「a」「an」「the」に相当する直接の等価物がありません。フィリピノ語では「ang」や「ng」のようなマーカーを用いますが、これは英語の冠詞には対応しません。冠詞は罠だと理解している書き手は、まず定番のパターンをしっかり練習し、あらゆる場面で適用します。例えば「the results showed that the concentration increased」という形です。正確で明確である一方、平坦で均一、そして非常に予測可能であり、その結果、パープレキシティが低いというシグナルになります。
安全な前置詞(The safe preposition)。 フィリピノ語では「sa」が、at, in, on, to, for, fromといった幅広い範囲をカバーします。誤りを避けるため、書き手はそれぞれの文脈において中立で辞書標準の前置詞を選びます。こうした高頻度で、驚きの少ない選択は、検出器がモデルから出力されることを期待するまさにそのタイプです。
教科書的な一致(Textbook agreement)。 フィリピン語の動詞は、英語の動詞のように数の屈折がありません。そのため注意深い書き手は、ルールブックを厳密に適用します。例えば「the data show」「each participant was」「the analysis of the samples shows」。こうした“ルール通りの一致”は、滑らかで機械的に見えやすくなります。
代名詞の中立性(Pronoun neutrality)。 フィリピン語では、一人称三人称の代名詞「siya」を、heとsheの両方に使います。性別の偶発的な入れ替えを避けるため、書き手は「the researcher」「the participant」「they」のように安定した中立形へ言い換えることがよくあります。繰り返される中立名詞句は、語彙の多様性が少ない/均一に見えて、さらに“それらしくない”方向へ働きます。
時制の一貫性(Tense consistency)。 フィリピン語では時制ではなく、相(完了・進行・考慮される状態など)を示します。安全に書くために、書き手は標準的な慣習を採用し、方法では単純過去を用い、確立された知見では現在形を用いて、それらを厳密に維持します。一貫性は良い文章であると同時に、検出器がフラグする“揃いすぎた予測可能性”でもあります。
素直な語順(Plain word order)。 フィリピン語のデフォルト語順は、動詞、主語、目的語(VSO)で、英語の逆です。注意深い書き手は、すべてを素直な主語、動詞、目的語(SVO)に変換します。標準的な文の語順は、モデルが最も予測しやすい構造なので、パープレキシティが低いと判定されやすくなります。
これらは、正しく修正すれば“誤り”ではありません。規律ある書き手の指紋(フィンガープリント)です。皮肉なのは、その規律が検出器には“誤読”されてしまう点にあります。
フィリピンにおけるAI検出とTurnitinの文脈
TurnitinまたはiThenticateは、類似性のチェックに加えて、フィリピンで提出される学位論文や学術誌記事におけるAIの兆候を確認するためにも、しばしば利用されます。2019年のCHED Memorandum Order No. 15(シリーズ)に基づく「no publication, no graduation(出版しなければ卒業できない)」という方針のもとでは、大学院生は、学位取得の前に出版するか、原稿が受理されていなければなりません。そのため、多くの論文章は、ジャーナルに届くはるか前に類似性チェックが行われることになります。
検出器が出すスコアが意味するものについては、見通しを持つことが大切です。Vanderbiltは2023年にTurnitinのAI検出器を無効化しました。根拠として、誤検出と、非母語の書き手に対するバイアスを挙げています。また、Michigan State、UT Austin、Northwestern、Pittsburgh、SMU、Waterlooも同様の対応を取りました。Turnitin自身も、1〜19%の範囲ではスコアを抑制し、数値だけを独立した誠実性判断の根拠にすべきではないと警告しています。フラグは“検討対象である”という主張であって、判決ではありません。
同時に、助成機関やジャーナルはAI利用の開示を求める方向へ進んでいます。両方のプレッシャーに対する正しい対応は同じです。自分自身の仕事を書き、自分の文章が自然に読めるよう丁寧に整え、そして利用したAI支援は必ず開示してください。
誤ったAIフラグから、丁寧な英語を守る
標準的で非ネイティブな文章が自然に読めるように、ご自身のAI支援による下書きをHumanizeし、意図、用語、引用をそのまま保持します。その後、ご所属のジャーナルが求める方法でAI利用を開示してください。
Humanizer を無料でお試しフィリピンの主要大学と、AIチェックが見られる場所
これらの機関は国内のインデックス付き研究の多くを生み出しており、大学院やジャーナルでは、論文や原稿を類似性およびAI関連の指標でスクリーニングします。
- フィリピン大学ディリマン校(UP Diliman)、ケソン・シティ。UP Systemの旗艦キャンパス。
- フィリピン大学ロス・バニョス校(UPLB)、ラグナ。農学・生命科学分野で主導的な大学。
- フィリピン大学マニラ校(UP Manila)、ヘルスサイエンス系キャンパス。医学研究のトップクラスの生産拠点。
- デ・ラ・サール大学(DLSU)、マニラ。同国で最も評価の高い私立大学。
- アテネオ・デ・マニラ大学、ケソン・シティ。社会科学、環境科学、公的政策に強い。
- サント・トーマス大学(UST)、マニラ。1611年に創設され、アジアで現存する最古の大学。
- マプア大学、マニラ。工学に重点を置く私立大学。
- ミンダナオ州立大学イリガン工科研究所(MSU-IIT)、イリガン市。ミンダナオの主要研究大学。
- シリマン大学、ドゥマゲテ市。海洋生物学と環境科学で知られる。
- セントラル・ルソン州立大学(CLSU)、ヌエバ・エシハ。国内屈指の農学系大学。
- サン・カルロス大学(USC)、セブ市。ビサヤ地方の主要研究大学。
- フィリピン工科大学(PUP)、マニラ。登録者数(在籍者数)で最大の州立大学。
あなたの学位論文や原稿がどこでチェックされるとしても、目標は同じです。丁寧に書かれた人間の文章が、そのように読まれる状態を目指します。
フィリピン人研究者向けAIヒューマナイザーの仕組み
フィリピン人研究者向けのAIヒューマナイザーは、いたずらでも、何かを隠すための手段でもありません。ワークフローの一工程です。
まず、原稿を作成します。推論がフィリピノ語のほうが自然に流れるなら、まずはそこから書いて英語へ翻訳するか、AIアシスタントの助けを借りて英語で下書きします。次に、文法を校正して“仕組み”が正しいことを確認します。このとき、編集側から同じL1パターンを扱う私たちの フィリピン人研究者向けアカデミック・編集 ガイドも併用できます。
第三に、あなたの下書きを text humanizer に通します。文のリズムや語彙の選び方を変え、検出器が引っかかりやすい反復的なカデンツや混ざり込んだ機械的な句読点を取り除きます。そして、意味、技術用語、すべての引用を保持します。主要な検出器に対する私たちのテストでは、ヒューマナイザーはAIテキストをより自然な人間らしい形へ書き換え、AIシグナルを下げて、難しい検出器に対する成績の可能性を高める一方で、学術文における文法の正確さは高く維持されました。これらは“テスト結果”であり“保証”ではありません。検出器は数か月ごとに再学習するため、私たちは約束ではなく測定した内容を報告します。
第四に、開示します。利用したAI支援は、あなたの所属機関や対象ジャーナルが要求する形式で明記してください。丁寧な人間の作業+自然に読める最終ドラフト+完全な開示、という組み合わせは、誠実性(インテグリティ)のルールの範囲内にあなたを保ちつつ、誤フラグによってあなたの文章が不利になることを防ぎます。各国のガイドについては、multilingual AI humanizer hub をご覧ください。
国内の助成機関・ジャーナル、およびAI開示に対する期待
フィリピンの研究助成には、出版に関する期待が伴うだけでなく、近年は開示に関する期待も加わりつつあります。高等教育委員会(Commission on Higher Education: CHED) が「no publication, no graduation(出版しなければ卒業できない)」の義務を推進しています。科学技術省(Department of Science and Technology: DOST) は、大学にまたがるプロジェクトに資金提供し、PCIEERD(Philippine Council for Industry, Energy, and Emerging Technology Research and Development)やPCHRD(Philippine Council for Health Research and Development)といった評議会を含む体制のもと、ScopusインデックスおよびWeb of Scienceインデックスのアウトプットで評価します。フィリピン国立研究評議会(National Research Council of the Philippines: NRCP) は、出版関連経費として最大PHP 20,000の助成を提供しており、言語支援や出版支援を正当な研究コストとして認めています。
現在、同国には200以上のScopusインデックス・ジャーナルがあり、対象となる投稿先には次が含まれます。
- Philippine Journal of Science、学際分野の旗艦ジャーナル。100年以上にわたり刊行されています。
- Acta Medica Philippina、UP ManilaのNational Institutes of Healthの機関誌。
- Philippine Agricultural Scientist、UPLBが発行。
- Philippine Journal of Nursing、国内を代表する看護研究ジャーナル。
- Asia Pacific Journal of Education、同地域の教育研究をカバー。
- Philippine Political Science Journal、Scopusにインデックスされています。
フィリピンのジャーナルに投稿する場合でも、ScopusまたはWeb of Scienceにインデックスされた国際ジャーナルに投稿する場合でも、原稿はスクリーニングされ、いずれ遅かれ早かれ「どのようにAIを使ったのか」を尋ねられると考えてください。明確なAI-disclosure statement があれば、査読者が取り上げる前に疑問は解消します。
よくある質問
Q: フィリピン人研究者向けのAIヒューマナイザーの使用は、いわゆる不正(チート)に当たりますか?
いいえ、責任ある形で使用するのであれば違います。ポイントは、AI支援で作成したドラフトを“自分自身で”人間らしく整え、丁寧で標準的な英語が機械文章として誤読されないようにすることです。その一方で意味と引用はそのまま保持します。加えて、AI利用は所属機関やジャーナルが求める形式で必ず開示します。これは本当の作業に対するフェアさであり、“偽装”ではありません。
Q: ヒューマナイザーはTurnitinまたはGPTZeroへの通過を保証しますか?
いいえ。テスト結果を報告するものであり、保証ではありません。私たちのテストでは、ヒューマナイザーがAIテキストをより自然な人間らしい形へ書き換えることで、AIシグナルを下げ、難しい検出器に対する可能性を高めます。ただし検出器は頻繁に再学習するため、永続的な“通過”を約束できるツールはありません。いかなる単一の検出器スコアも、最終的な判決ではなく“検討対象である”という主張として扱ってください。
Q: 文法的に正しいのに、なぜ私の丁寧な英語がフラグされるのですか?
検出器は“正確さ”ではなく“予測可能性”をスコア化します。スタンフォードの研究では、人間が書いた非母語のエッセイの約61%がAIとしてフラグされる一方、母語の書き手では約5%でした。フィリピン語の書き手が、安全な冠詞、標準的な前置詞、教科書的な一致を使ってL1由来のつまずきを避けると、その標準性はパープレキシティの低さとして読まれ、検出器はそれを“機械による生成”と誤読します。
Q: ヒューマナイザーは引用や技術用語を変えますか?
いいえ。ヒューマナイザーは引用、用語、そして各文の意味を保持します。リズムや語彙の選び方を変え、反復的なカデンツや混ざり込んだ機械的な句読点を取り除きます。参考文献や分野固有の用語は、あなたが書いたとおりのままです。
Q: 最初にフィリピノ語で書いても、これを使えますか?
はい。多くの研究者は、フィリピノ語や地域言語でより自然に考えられるため、まずはそこで下書きし、その後、校正とヒューマナイズの前に英語へ翻訳します。ヒューマナイザーは60以上の言語に対応しており、言語に配慮したモデルが、そのプロセスを通じて文の構造と意味を崩さないよう維持します。
引用と意図を保ちながら、慎重な非ネイティブ英語を自然に仕上げます。主要な検出器でテスト済み、明確な開示のために設計されています。

Moe は、自然言語処理の PhD を持つ NLP エンジニアです。 彼の研究は計算言語学、テキスト分析、機械学習をカバーしており、それは ProofreaderPro の背後にある編集および人間化モデルに直接反映されています。 彼は、ほとんどの人が目にすることのないプロセスの部分、つまり言語モデルがどのように文を読み取り、スコアを付け、何を変更するかを決定するかについて書いています。


