
コロンビアの研究者が英語で執筆するためのAIヒューマナイザー
コロンビアの研究者向けAIヒューマナイザー。スペイン語の影響を受けた英語で誤ってAI検出フラグが立つのを減らし、意味と引用を保ちつつ、AI利用を誠実に開示します。

年間で約25,000〜30,000本のScopusに収録された論文を生み出しており、科学的知識のアウトプットにおける世界順位は45〜50位に相当します。これは、GDPの約0.3%をR&D(研究開発)に投じていることによって実現されています。つまり、コロンビアの研究者たちは非常に限られた資源で多くの成果を上げているのです。そして、その大半の成果は英語で書かれた国際誌に到達しなければなりません。
そこで、コロンビアの研究者のためのAIヒューマナイザーがその役割を担います。ここでは多くの学術研究者が専門分野において英語を流暢に読める一方で、執筆は比較的ゆっくりになります。コロンビアはEF英語能力指数で485に位置し、「Moderate Proficiency(中程度の能力)」帯では世界で69位です。そのため、コロンビアの原稿では、慎重で、標準的で、教科書のように正しい英語が通常の前提になります。
問題は不都合なところにあります。こうした注意深い正確さこそが、AI検出器に「機械的な文章」と誤読される要因になり得るのです。一般的な語彙と予測可能な言い回しで構成された、きれいな第二言語の文は、チャットボットから貼り付けられた文章と同様のフラグを引き起こすことがあります。実在の研究者による本当の仕事が、網の目にかかってしまうのです。
コロンビアの研究者のためのAIテキスト・ヒューマナイザー
当社のAIテキスト・ヒューマナイザーは、コロンビアの研究者がより安心して英語で発表できるよう支援します。原稿の意味、専門用語、引用を保持しつつ、「第二言語としての丁寧な文章」が機械生成テキストとして誤認されるリスクを低減します。
In plain terms: あなたが科学を書き、ヒューマナイザーは、人が書いたように文章が読めるようにします。人が書いているからです。内容を捏造せず、AIツールを使ったことも隠しません。まず、不公平なフラグから丁寧な記述を守り、そのうえで、開示の判断をあなたに委ねます。
目的は、真正な仕事を「偽装」することではなく、公平性にあります。あなたは引用を保ち、発見を保ち、所属大学や対象となる学術誌が定めるインテグリティ(誠実性)のルールの範囲内にとどまります。
スペイン語で下書きしていますか? ヒューマナイザーはそれも検出し、書き換えます
英語に翻訳する前に、スペイン語の下書きをそのままヒューマナイズできます。テキストを貼り付けると、ProofreaderProが言語を自動で検出し、次にスペイン語に配慮したモデルへと振り分けます。その結果、アクセント、専門用語、引用はそのまま保持されます。AIテキスト・ヒューマナイザーとして、スペイン語の文章のリズムを調整しつつ、すべての発見と参照を維持します。自動検出は60以上の言語にまたがるため、スペイン語は英語へと作り替えられるのではなく、スペイン語として扱われます。
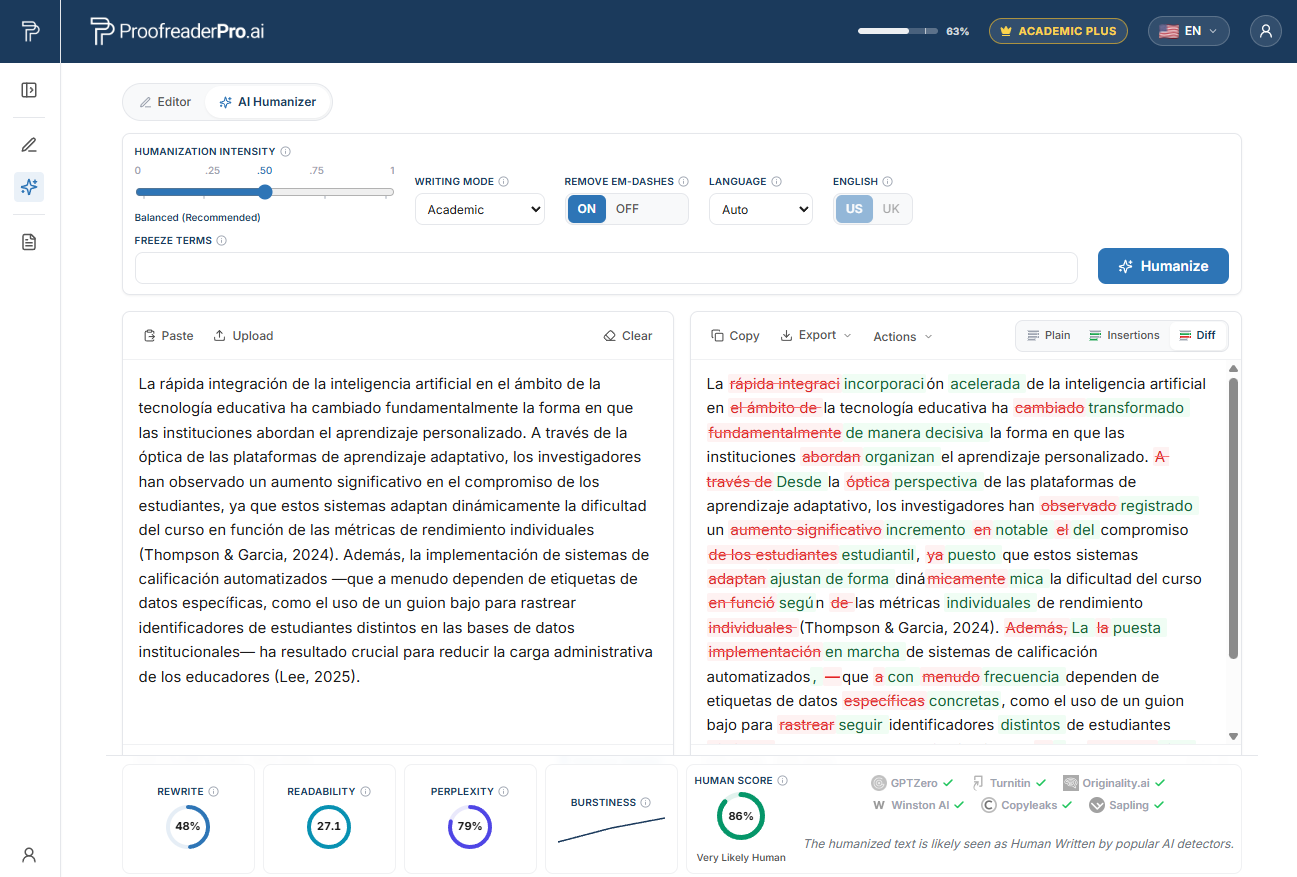
ProofreaderPro AIヒューマナイザーがスペイン語の学術テキストを書き換えた例。before/afterの差分は意味と引用を保ち、検出チェックが「自然で人が読んだ」ようになることを確認しています。
なぜコロンビアの研究者はAI検出器にフラグを立てられるのか
2023年、Liangらが率いるスタンフォードのチームは、Cell Pressの雑誌 Patterns に「GPT detectors are biased against non-native English writers(GPT検出器は非母語の英語話者に偏っている)」という研究を発表しました。彼らは、広く使われている7つのAI検出器に対して、人が書いたTOEFLのエッセイを投入しました。すべてのエッセイには人間の著者がいます。
平均すると、非母語のエッセイの約61%がAIとしてフラグを立てられたのに対し、母語英語話者の約5%でした。さらに、非母語のエッセイのほぼ5分の1、約19.8%が、あらゆる検出器で同時にフラグを立てられました。これらはAIによるエッセイではありません。注意深く、標準的であることにたまたま特徴がある、人による文章でした。
仕組みの鍵は「perplexity(当惑度)」です。多くの検出器は、次に来る単語が言語モデルにとってどれだけ意外か(驚きが大きいか)をスコア化します。流暢な母語話者は慣用句や独特の言い回しを散りばめるため、当惑度が高くなります。第二言語話者は安全で一般的な「正しい語」を選ぶため、当惑度が下がります。当惑度が低いと「機械文」と読まれます。私たちはなぜAI検出器が非母語の書き手をフラグするのかで、より詳しい説明を書いており、それはスペイン語話者の学術界にほぼ完全に当てはまる形で対応しています。
誤検出フラグの背景にあるスペイン語母語のパターン
スペイン語話者は英語でランダムな誤りを犯しているわけではありません。体系的で、パターン化された構文を生み出し、その多くは「文としては正しいのに、あまりに標準的に読めてしまう」英語です。ここでは、当惑度を下げる方向に働くものを挙げます。
抽象名詞と冠詞の規律。 スペイン語では冠詞が幅広く使われるため、コロンビアの執筆者は抽象名詞の前にある「the(定冠詞)」について慎重に考えます。自然な英語へ自己修正する際(「the poverty affects the education」ではなく「poverty affects education」)、結果として最も素直で平易な言い回しに着地します。正しく、丁寧で、当惑度が低い。
形容詞の配置。 スペイン語では形容詞が名詞の後に来ます(「resultados significativos」)。そのため、意識して英語の語順へ切り替える書き手は、奇妙に修飾が重なることを避け、保守的で曖昧さの少ない構文を選びがちです。安全な語順は検出器にとって予測可能に映ります。
誤訳しやすい(false friends)語を避ける。 「actual」は現在を意味し、「realizar」は実行することを意味し、「eventualmente」は時々を意味し、「sensible」は繊細(敏感)を意味します。こうした事情から、慎重なコロンビアの執筆者は、危険な同族語(cognate)を避け、その代わりに平易な英語の動詞を選ぶよう学びます。こうした意図的で慎重な語彙選択が、当惑度を下げる「ありふれた語の選び方」とちょうど一致します。
時制への慎重さ。 スペイン語の現在完了(he analizado)は英語の単純過去と一致しません。そのため、「We collected the data in 2023」のように書く訓練を自分自身に課してきた書き手は、きれいで、教科書的な方法論の文を生成します。ここで問題になるのは文法ではなく「教科書的であること」です。
前置詞の精密さ。 「consist in」と「consist of」の違い、あるいは「depend of」と「depend on」の違いを修正された後、研究者は毎回、標準的なコロケーション(語の連結)にぴったり従います。安定していて、正しく、予測可能です。
これらは、検出器が「間違い」を見つけているわけではありません。むしろ、規律ある第二言語の書き手に見られる特徴であり、検出器は規律と機械的アウトプットの違いを見分けられません。
コロンビアにおけるAI検出とTurnitinの文脈
コロンビアの学位論文や学術誌への投稿は、テキストの類似性を確認する目的で、TurnitinまたはiThenticateによってスクリーニングされることが一般的であり、両プラットフォームは従来の類似性スコアに加えてAI執筆の指標も今では表示します。多くのコロンビアの大学と編集委員会は、審査(ディフェンス)や編集判断の前に、原稿や学位論文をこれらのいずれかのシステムに通します。
AIスコアがどれほど脆いかを知っておく価値はあります。Vanderbiltは2023年に、誤検出と非母語話者へのバイアスを理由に、TurnitinのAI検出器を無効化しました。また、Michigan State、UT Austin、Northwestern、Pittsburgh、SMU、Waterlooも同様の対応を取りました。Turnitin自身も、スコアを1〜19%の範囲では抑制し、数値の代わりにアスタリスクを表示しており、そのスコアだけでインテグリティ上の判断を行うべきではないとも警告しています。
したがって、フラグとは争うことのできる主張であり、判決ではありません。同時に、助成機関や学術誌は、著者に対してAIツールの使い方を開示することをますます求めています。適切な道は、「誤検出のフラグ」から注意深い文章を守りつつ、実際のAI支援は両方を同時に誠実に開示することです。
ご自身の原稿を自然な文章にし、すべての引用をそのままにする
スペイン語から英語への慎重な文章を、誤ったAI検知フラグから保護します。意味、用語、参照を維持し、そのうえで、ジャーナルが求める方法に従ってAI利用を開示してください。
Humanizer を無料でお試しコロンビアの主要大学と、AIチェックが現れる場所
コロンビアでの研究成果は、よく知られた複数の公的・私的大学に集中しており、それぞれが卒業や出版の前に、学位論文や原稿を類似性およびAI指標についてチェックします。
- Universidad Nacional de Colombia(UNAL)、ボゴタ。同国最大かつ最も生産性の高い研究大学で、ボゴタ、メデジン、マニサレス、パルミラにキャンパスがあります。
- Universidad de los Andes(Uniandes)、ボゴタ。トップランクの私立大学で、工学、経済学、物理学に強みがあります。
- Universidad de Antioquia(UdeA)、メデジン。多くのMincienciasクラスの研究グループを抱える主要な公立大学です。
- Pontificia Universidad Javeriana、ボゴタとカリ。医学や環境科学で幅広い成果を持つ、主要なイエズス会系大学です。
- Universidad del Valle(Univalle)、カリ。南西部の主要な公立大学です。
- Universidad Industrial de Santander(UIS)、ブカラマンガ。工学、石油科学、化学で評価されています。
- Universidad EAFIT、メデジン。工学や応用科学のプログラムを拡大中の私立大学です。
- Universidad del Norte(Uninorte)、バランキージャ。カリブ海沿岸で最有力の私立大学です。
- Universidad de Caldas、マニサレス。農学と健康分野に強みがあります。
- Universidad del Cauca、ポパヤン。研究能力を拡大中の歴史ある公立大学です。
- Escuela de Ingenieria de Antioquia(EIA)、メデジン。工学およびバイオメディカル科学に特化した機関です。
- Universidad del Rosario、ボゴタ。アメリカ大陸で最も古い大学の一つで、法学、医学、経済学に強みがあります。
これらのどの機関でも、圧力は同じです。Mincienciasの分類を前進させるために、英語の国際誌で公表することです。つまり、公平なAI検出の結果は、抽象的な問題ではなく実際のキャリアの論点になります。
コロンビアの研究者向けAIヒューマナイザーはどのように機能するか
ワークフローはシンプルで、そこに「隠す」要素は含まれていません。コロンビアの研究者向けAIヒューマナイザーが実際に行うことは以下の通りです。
まず、下書きを作成します。多くの研究者はスペイン語で考えて整理し、議論がより自然に流れる形を作ってから、それを英語に翻訳します。それは問題ありません。次に、文法、冠詞の選択、誤訳しやすい語、そして前置詞を整えます。そうして科学の文章をきれいにします。第三に、自分自身が作ったAI支援下書きをテキスト・ヒューマナイザーにかけます。リズムや語彙選択を調整し、反復的なカデンツァや紛れ込んだダッシュを取り除きつつ、意味、専門用語、引用をあなたが置いた場所に正確に保持します。
検出器側から何が期待できますか。主要な検出器に対してテストした結果、当社のヒューマナイザーはAIテキストをより自然な人の文章へ書き換え、AIシグナルを下げて、手強い検出器に対する勝率を高めるとともに、学術文における文法の正確さは高い水準を維持します。これは保証ではなく、テストに基づく結果です。検出器は数か月ごとに再学習されるため、私たちは測定した内容を説明し、何かを「バイパスする」と約束したり、テキストが100%検出不能であると主張したりすることはありません。
そして開示します。所属機関や対象の学術誌が求めるAI使用のステートメントを追加してください。自分自身が丁寧に書いた文章をヒューマナイズし、AI利用を開示することは矛盾しません。両者を合わせることで、誠実性のルールの範囲内にとどまりつつ、誤検出によって本当の第二言語の文章が不利を受けることを防げます。さらに、人が読むことを前提にした言語面のパスも必要であれば、コロンビアの研究者向けアカデミック編集ガイドがその側面をカバーしており、本記事は当社のより広い多言語AIヒューマナイザー・ハブの一部として位置づけられています。
地域の助成機関・学術誌・AI開示に関する期待
Minciencias(Ministerio de Ciencia, Tecnologia e Innovacion)は、コロンビアの研究者分類システムを運用し、学術研究者をInvestigador Junior、Asociado、Senior、Emeritoの各ティアに振り分けます。上位へ進むには、索引付き(インデックス付き)学術誌での継続的な出版が必要であり、ScopusおよびWeb of Scienceのアウトプットが最も重く評価されます。現在Mincienciasが管理するColcienciasの研究グループは、同様の生産性指標に基づきA1、A、B、C、Dにランク付けされ、グループのランクが競争的資金へのアクセスを左右します。
システム全体を支える通貨が国際出版である以上、あなたの原稿、助成金申請書、査読者への返信に含まれる英語は、正確であるだけでなく自然である必要があります。投稿に誤ってAIフラグが立てられると、その分類のアップグレードに依存しているまさにその出版が止まってしまう可能性があります。
コロンビアの状況は、このシステムがどれほど「英語優先」になっているかを示しています。非常に評価の高い学術誌がいくつもあります。Colombia Medica(Universidad del Valle)はPubMedとScopusの両方に掲載されています。ほかにも、Revista Colombiana de Quimica(Universidad Nacional de Colombia)、Ingenieria y Competitividad(Universidad del Valle)、Revista Colombiana de Ciencias Pecuarias(Universidad de Antioquia)、Universitas Scientiarum(Pontificia Universidad Javeriana)、Boletin de Investigaciones Marinas y Costeras(INVEMAR)などがあります。さらにSciELO Colombiaにも多く存在します。スペイン語を使用しているにもかかわらず、ほとんどの学術誌は、ScopusやWeb of Scienceに入るための投稿では、質の高い英語の完成原稿を求めます。
こうした助成機関や学術誌をまたいで、AI利用の開示は「任意」から「期待されるもの」へと移行しています。ツール利用を明確に記載する計画を立ててください。ヒューマナイザーを自分の下書きに適用し、その後に開示すること、その組み合わせこそが、精査の場でも通用します。
よくある質問
Q: コロンビアの研究者向けにAIヒューマナイザーを使うことは不正行為(チート)と見なされますか?
いいえ。あなた自身がAI支援下書きをヒューマナイズし、その後に所属機関や学術誌が求める方法でAI利用を開示する限りにおいては不正行為には当たりません。このツールは、意味と引用を保持し、丁寧な第二言語の執筆が誤検出のフラグを受けるのを回避するのに役立ちます。捏造された仕事を偽装するためのものではなく、AIを使ったことを隠すためのものでもありません。
Q: ヒューマナイザーは、私の論文がTurnitinまたはGPTZeroを通過することを保証しますか?
いいえ。また、それを約束する人には注意してください。主要な検出器に対してテストした結果、当社のヒューマナイザーはAIテキストをより自然な人の文章へ書き換え、AIシグナルを下げて手強い検出器に対する勝率を高めます。ただし、特定の結果を保証できるツールはありません。検出器は頻繁に再学習されるため、私たちは「約束」ではなく、測定した内容を報告します。
Q: なぜ検出器は、丁寧なスペイン語→英語の学術執筆をそもそもフラグするのですか?
多くの検出器は、perplexity(当惑度)をスコア化し、語彙選択がどれほど予測可能かを意味として評価します。規律ある第二言語話者は一般的な語彙と標準的な言い回しを使うため、当惑度が低く、その結果として機械的に見えます。スタンフォードの研究では、人が書いた非母語のエッセイが約61%でフラグを立てられ、母語話者では約5%だったことが分かっており、その偏りは明確です。
Q: ヒューマナイザーは私の引用や専門用語を変えますか?
いいえ。参照(引用元)、分野固有の専門用語、そしてあなたの発見を保持し、変えるのはリズムと語彙選択だけです。APA、Vancouver、IEEEなどの引用形式(またはその他の引用)はそのまま維持されるため、エビデンスや帰属が変わることはありません。
Q: スペイン語で先に下書きして、それでもヒューマナイザーを使えますか?
はい。多くのコロンビアの研究者は、スペイン語でアウトラインを作り、考えを整理したうえで、英語へ翻訳し、磨き込みの段階に入ります。ヒューマナイザーは翻訳後の英語の下書きと校正に対して働き、文章を滑らかにしつつ、スペイン語で組み立てた議論を完全に保持します。
ご自身のAI支援による学術原稿を人間らしく整え、意味と引用を保持しつつ、スペイン語の影響を受けた慎重なスペイン語から英語の文章が不当なAI検知フラグとして誤認されないよう保護します。自信をもって開示してください。

Moe は、自然言語処理の PhD を持つ NLP エンジニアです。 彼の研究は計算言語学、テキスト分析、機械学習をカバーしており、それは ProofreaderPro の背後にある編集および人間化モデルに直接反映されています。 彼は、ほとんどの人が目にすることのないプロセスの部分、つまり言語モデルがどのように文を読み取り、スコアを付け、何を変更するかを決定するかについて書いています。


