
Humaniseur d’IA pour les chercheurs éthiopiens rédigeant en anglais
Humaniseur d’IA pour les chercheurs éthiopiens. Réduisez les faux signaux de détection d’IA sur un anglais influencé par l’amharique, tout en conservant le sens et les citations, et en déclarant votre recours à l’IA de manière transparente.

L’Éthiopie a publié 10 614 articles indexés dans Scopus en 2023, soit une hausse de 20,2 %, ce qui la place parmi les producteurs de recherche les plus dynamiques en Afrique. Son H-index se situe au 77e rang mondial : l’un des trois seuls pays à revenu faible figurant dans le top 100 pour l’impact des citations. Derrière ces chiffres se trouvent des milliers d’académiciens amharophones qui rédigent, révisent et, de plus en plus, se tournent vers des outils d’IA pour écrire dans une deuxième langue.
C’est là que les difficultés commencent. Un humaniseur d’IA pour les chercheurs éthiopiens ne vise pas à dissimuler un travail. Il s’agit de protéger un anglais soigneux et standard contre des détecteurs qui le comprennent à tort.
Quand un chercheur de Bahir Dar ou de Gondar rédige un style académique clair et prévisible, les qualités mêmes qui le rendent lisible peuvent déclencher par erreur un détecteur d’IA. Ce guide explique pourquoi, et comment y remédier de façon simple : humanisez votre brouillon assisté par IA, conservez votre sens et vos citations, puis déclarez votre recours à l’IA comme l’exigent votre institution et la revue.
ሰላም : un humaniseur d’IA conçu pour les chercheurs éthiopiens rédigeant en anglais
ሰላም (selam) signifie « bonjour ». Notre humaniseur aide les chercheurs éthiopiens à publier en anglais en prenant votre propre brouillon assisté par IA et en en lissant le rythme « machine » sans modifier votre sens, vos données ni vos citations. Il prend en charge plus de 60 langues, dont l’amharique (አማርኛ), le tigrinya et l’oromiffa, de sorte qu’un article que vous élaborez d’abord dans votre langue de travail puisse ensuite entrer dans l’anglais académique tout en restant le vôtre.
Peu importe que vous écriviez à l’Université d’Addis-Abeba, dans la capitale, ou sur un campus régional disposant d’un soutien limité en anglais. Vous pouvez l’utiliser partout, à condition d’avoir une connexion internet. Cela compte dans un pays où l’écart linguistique entre les institutions est important, tout comme la pression de publication, identique partout.
Rédaction en amharique ? Détection automatique et humanisation « native »
De nombreux chercheurs éthiopiens rédigent d’abord en amharique avant de mettre au propre en anglais, et l’humaniseur gère cela directement. Collez un texte en amharique (አማርኛ) et ProofreaderPro reconnaît lui-même l’écriture ge’ez, puis le traite via un modèle sensible aux langues qui conserve votre terminologie et vos citations exactement telles qu’elles apparaissent. Votre brouillon en amharique est humanisé aussi facilement que votre anglais : aucune traduction préalable n’est nécessaire. La même détection couvre plus de soixante langues, chacune réécrite dans son propre système d’écriture.
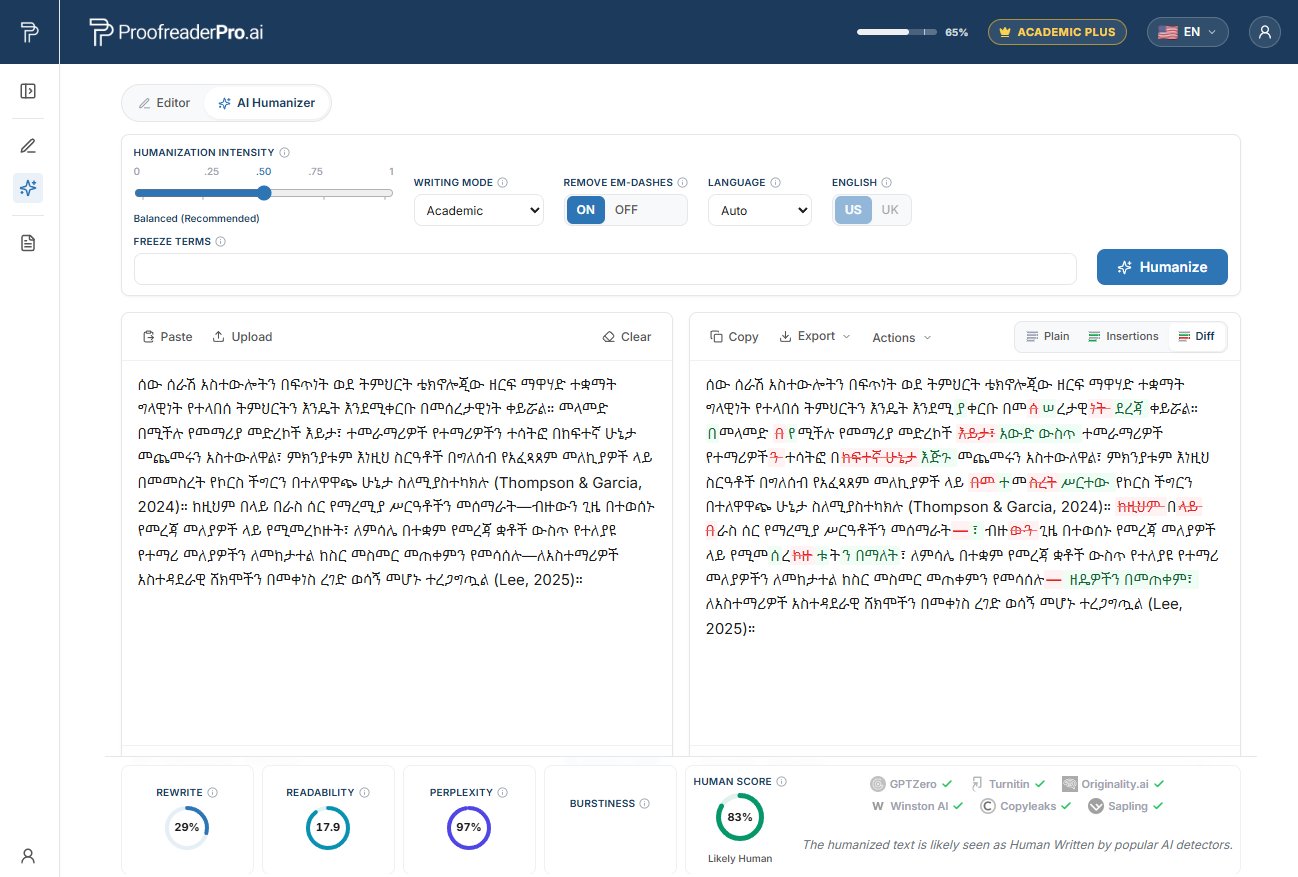
Le ProofreaderPro AI Humanizer réécrit un texte académique en amharique. La comparaison avant/après conserve votre sens et vos citations, et les contrôles du détecteur confirment une lecture naturelle, humaine.
Pourquoi les chercheurs éthiopiens sont-ils signalés par des détecteurs d’IA ?
En 2023, une étude de Stanford menée par Liang et ses collègues, publiée dans la revue Cell Press Patterns, portait un titre sans détour : « GPT detectors are biased against non-native English writers. » L’équipe a fait passer des essais rédigés par des humains (TOEFL) dans sept détecteurs d’IA largement utilisés. Chaque essai avait un auteur humain.
Les détecteurs ont signalé environ 61 % des essais non natifs comme produits par une IA, contre environ 5 % pour les auteurs natifs d’anglais. Près d’un cinquième (environ 19,8 %) a été signalé à l’unanimité par tous les détecteurs de l’ensemble. Aucun n’avait été écrit par une machine.
Le mécanisme tient à la « perplexité ». De nombreux détecteurs évaluent à quel point chaque choix de mots est « surprenant » pour un modèle de langue. Les auteurs maîtrisant une langue seconde ont tendance à utiliser des mots courants et des formulations standard, prévisibles ; cela produit une perplexité faible, qui ressemble à un texte produit par machine. Les habitudes qui rendent les universitaires amharophones clairs en anglais sont précisément celles que ces outils ont été entraînés à signaler. Nous détaillons le mécanisme complet dans why AI detectors flag non-native writers.
Les schémas en première langue amharique à l’origine des faux signaux
L’amharique est une langue sémitique écrite en alphabet ge’ez, et sa grammaire diverge de l’anglais de manière systématique. Une recherche sur l’écriture étudiante en Éthiopie a mis en évidence que 55,6 % des étudiants déclarent que la syntaxe de l’amharique influence directement leur anglais. Voici ce que les détecteurs manquent : une fois ces schémas corrigés, votre prose devient conforme aux standards « manuel » et un anglais « manuel » est exactement ce qui se lit comme une perplexité faible.
Voix passive. Dans l’écriture formelle, l’amharique favorise les constructions impersonnelles, et l’enseignement de l’anglais plus ancien en Éthiopie a appris la voix passive comme « plus académique ». Environ 32 % des manuscrits s’appuient fortement sur elle. La prose passive est grammaticale et cohérente, et cette cohérence constitue encore un signal supplémentaire pour un détecteur qui « lit » une cadence de machine.
Temps verbal. L’amharique marque le temps, l’aspect et le mode via des racines consonantiques et des patrons vocaliques qui ne correspondent pas directement au passé, au présent et au futur de l’anglais. Environ 28 % des manuscrits font varier le temps dans une section. Quand un éditeur lisse ces variations pour n’en conserver qu’un seul, le résultat devient uniforme et prévisible.
Accord sujet-verbe. L’amharique encode le sujet à l’intérieur du verbe, de sorte que l’accord explicite que l’anglais exige peut sembler redondant. Environ 23 % des manuscrits présentent des erreurs d’accord avec des sujets complexes, tels que « The analysis of the collected data from all three sites show ». Une fois corrigé, on obtient un ensemble propre et régulier, autre signal de faible « surprise ».
Omission de l’article. L’amharique n’a pas d’équivalent direct de « a », « an » ou « the » ; les articles sont donc omis : « Result was significant » au lieu de « The result was significant ». Ajoutez-les comme le ferait un auteur attentif, et la référence devient précise et standard.
Ordre des mots. L’amharique place le modificateur avant le nom principal selon un ordre différent de l’anglais, ce qui produit des composés comme « temperature increase rate » au lieu de « rate of temperature increase ». Une fois figés, ils se lisent comme un anglais technique propre.
Tout cela n’est ni de la triche ni une faiblesse. Il s’agit d’une écriture soignée qui, par coïncidence, reste prévisible, et un humaniseur rétablit la variation naturelle que le détecteur s’attend à observer.
Contexte de détection d’IA et de Turnitin en Éthiopie
Turnitin ou iThenticate fait partie des outils utilisés pour vérifier les similitudes dans les mémoires et les soumissions aux revues des universités publiques en Éthiopie. Le recours à des indicateurs d’IA devient courant. Les promotions académiques exigent une publication dans des revues indexées au niveau international sous la directive harmonisée du Ministry of Science and Higher Education (MoSHE). Cela signifie que tous les articles seront soumis à davantage de contrôles, et non à moins.
Il est utile de savoir à quel point ces scores d’IA peuvent être instables. En 2023, Vanderbilt a désactivé le détecteur d’IA de Turnitin en raison de faux positifs et d’un biais contre les auteurs non natifs. Michigan State, UT Austin, Northwestern, Pittsburgh, SMU et Waterloo ont également fait de même. Turnitin lui-même réduit les scores dans la fourchette de 1 à 19 % et avertit que son chiffre ne doit pas être utilisé seul pour décider des cas d’intégrité.
Pour un chercheur éthiopien, l’essentiel est simple : un signal d’IA est une affirmation que vous pouvez contester, pas un verdict. Aucun étudiant « a poursuivi Turnitin et a gagné » ; les vrais litiges concernaient les établissements sur la manière dont un signal était utilisé. Votre rôle est de garder votre rédaction claire et d’empêcher qu’elle soit mal interprétée dès le départ.
Humanisez votre propre brouillon, conservez chaque citation
Téléversez votre article assisté par IA et laissez l’humaniseur restaurer une variation naturelle tout en préservant votre sens, votre terminologie et vos références. Conçu pour les chercheurs parlant l’amharique qui rédigent en anglais.
Essayez gratuitement le HumanizerGrandes universités éthiopiennes et présence des contrôles d’IA
Le système universitaire éthiopien s’est développé pour compter plus de 47 institutions publiques, et ses principaux producteurs de recherche analysent tous les mémoires et les manuscrits pour les similitudes ainsi que pour les indicateurs d’IA. Si vous étudiez dans l’un de ces établissements, le processus ci-dessous s’applique à vous :
- Addis Ababa University (አዲስ አበባ ዩኒቨርሲቲ), la plus ancienne université du pays et la plus orientée recherche, dans la capitale.
- Jimma University (ጅማ ዩኒቨርሲቲ), reconnue en sciences de la santé et en santé publique.
- Bahir Dar University (ባህር ዳር ዩኒቨርሲቲ), un pôle en pleine expansion en ingénierie, agriculture et éducation dans la région d’Amhara.
- University of Gondar (ጎንደር ዩኒቨርሲቲ), connue pour la médecine et les sciences vétérinaires.
- Hawassa University (ሃዋሳ ዩኒቨርሲቲ), un des plus solides producteurs, classé en tête, en agriculture et sciences naturelles.
- Mekelle University (መቀሌ ዩኒቨርሲቲ), grande université de recherche dans le Tigray, avec des forces en agriculture des zones sèches et en géosciences.
- Adama Science and Technology University (አዳማ ሳይንስና ቴክኖሎጂ ዩኒቨርሲቲ), orientée vers l’ingénierie et la technologie.
- Haramaya University (ሀረማያ ዩኒቨርሲቲ), l’une des plus anciennes, solide en agriculture et en médecine vétérinaire.
- Arba Minch University (አርባ ምንጭ ዩኒቨርሲቲ), connue pour la technologie de l’eau et la recherche environnementale.
- Debre Berhan University (ደብረ ብርሃን ዩኒቨርሲቲ), université régionale avec des capacités de recherche en développement rapide.
Ici, on voit l’importance de l’écart de maîtrise régionale. Addis Ababa obtient 522 sur l’EF English Proficiency Index, mais la région d’Amhara obtient 436 (soit une différence de 86 points). Ainsi, le chercheur de Bahir Dar ou de Gondar franchit une marche plus élevée que son homologue d’Addis. Mais ils appliquent les mêmes règles et utilisent les mêmes détecteurs. Un outil qui fonctionne depuis n’importe quelle connexion aide à uniformiser le terrain.
Comment fonctionne l’humaniseur d’IA pour les chercheurs éthiopiens
Voici le processus que nous recommandons, de bout en bout.
D’abord, rédigez. Exposez votre argument dans la langue qui vous vient le plus vite : amharique, oromiffa, tigrinya ou anglais. Si vous rédigez dans votre langue de travail, notre AI translator le transforme en anglais académique tout en conservant vos termes et votre structure.
Ensuite, relisez. Lancez le contrôle de grammaire qui corrige la densité de voix passive, la dérive des temps, les erreurs d’accord et les articles manquants décrits ci-dessus. Un anglais propre et corrigé est la base ; l’humaniseur n’est pas un substitut à cette étape.
Troisièmement, humanisez. Prenez votre propre brouillon assisté par IA et faites-le passer dans le text humanizer. Il fait varier le rythme des phrases et le choix des mots, supprime les cadences répétitives ainsi que les tirets cadratin isolés, et rétablit la variation naturelle qu’un détecteur s’attend à voir, tout en préservant votre sens, votre terminologie technique et vos citations.
Notre humaniseur, testé par rapport aux principaux détecteurs, réécrit le texte produit par IA sous une forme plus naturelle et humaine, lisible comme « humain » sur Turnitin, Originality.ai et GPTZero, tout en conservant une grande précision grammaticale pour les textes académiques. Il s’agit de résultats issus de tests, non de garanties. Les détecteurs se réentraînent tous les quelques mois, et aucun outil sérieux ne promet d’être indétectable. L’objectif est l’équité pour un travail réel, et non le camouflage.
Quatrièmement, déclarez. Indiquez votre recours à l’IA dans le format exigé par votre institution et par la revue cible. Humaniser sa propre rédaction et déclarer qu’on a utilisé l’IA ne s’opposent pas : ensemble, ils vous permettent de rester dans les règles d’intégrité tout en protégeant une prose non native soigneuse contre un faux signal.
Cette étape d’humanisation constitue le pendant de notre academic editing for Ethiopian researchers, et elle s’inscrit dans notre plus large multilingual AI humanizer hub, qui couvre des chercheurs rédigeant dans des dizaines de langues.
Organismes de financement locaux, revues et attentes en matière de déclaration d’IA
Le financement de la recherche en Éthiopie provient principalement du gouvernement via des subventions universitaires sous MoSHE, ainsi que de projets internationaux de développement et de collaborations avec des ONG. La majorité des fonds se concentre sur la santé, l’agriculture et l’ingénierie, domaines pour lesquels les revues cibles sont toutes publiées en anglais. Le National Academic Digital Repository of Ethiopia (NADRE) exige l’accès ouvert pour les recherches financées publiquement. L’accès ouvert signifie publication en anglais. Les chercheurs ont besoin de publier pour obtenir des promotions et sécuriser les financements futurs.
Les revues indexées du pays accueillent des soumissions conformes aux standards linguistiques internationaux :
- Ethiopian Journal of Health Sciences, indexée dans MEDLINE et Scopus.
- Ethiopian Journal of Health Development, indexée dans Scopus et Web of Science.
- Ethiopian Medical Journal, l’une des plus anciennes revues médicales d’Afrique.
- Ethiopian Journal of Education and Sciences, couvrant l’éducation et la pédagogie.
- Ethiopian Journal of Agricultural Sciences, couvrant la recherche agraire en Éthiopie.
Les bailleurs et les revues demandent de plus en plus aux auteurs de déclarer leur recours à l’IA, et cette attente ne fait que croître. Le schéma « prudent » est le même partout : humanisez votre rédaction pour plus d’équité, faites passer le manuscrit par le text humanizer avant de soumettre, puis déclarez précisément comment vous avez utilisé l’IA. Si un détecteur signale malgré tout un travail soigneux et légitime, vous avez tout à fait le droit de faire appel à ce signal auprès de votre éditeur plutôt que de l’accepter comme définitif.
Questions fréquentes
Q: Un humaniseur d’IA aidera-t-il les chercheurs éthiopiens à passer Turnitin équitablement ?
Oui, au sens réel : il rétablit une variation naturelle dans votre anglais soigné, assisté par IA, de sorte qu’un détecteur risque moins de le mal interpréter. Lors de nos tests, l’humaniseur réécrit le texte produit par IA sous une forme plus humaine, ce qui réduit le signal d’IA sur Turnitin, mais les détecteurs se réentraînent en permanence et aucun outil ne peut garantir d’être indétectable. Traitez tout signal comme une affirmation à discuter, gardez votre travail authentique et déclarez votre recours à l’IA.
Q: Le humaniseur fonctionne-t-il si je rédige d’abord en amharique ?
Oui. De nombreux chercheurs éthiopiens pensent le plus vite en amharique, en oromiffa ou en tigrinya. Vous pouvez rédiger dans votre langue de travail, traduire en anglais académique, relire la grammaire, puis humaniser, et l’outil préserve votre sens et vos citations à chaque étape sur plus de 60 langues.
Q: Utiliser un humaniseur d’IA est-il considéré comme de la triche ?
Non, pas si vous l’utilisez sur votre propre travail et que vous le déclarez. Humaniser signifie lisser le rythme de « machine » d’un brouillon que vous avez vous-même rédigé et que vous avez vous-même étayé par la recherche, tout en conservant le sens. La triche consiste à soumettre un travail fabriqué ou celui de quelqu’un d’autre, et déclarer une assistance IA authentique est l’opposé du fait de la cacher.
Q: Pourquoi des articles en anglais soigné et correct sont-ils malgré tout signalés ?
Parce que de nombreux détecteurs évaluent la perplexité, c’est-à-dire le caractère prévisible de vos choix de mots. L’écriture académique en langue seconde a souvent tendance à être standard et peu « surprenante », et c’est précisément ce profil de faible surprise que ces outils ont été entraînés à qualifier de texte écrit par une machine. Une étude de Stanford a montré qu’environ 61 % des essais non natifs rédigés par des humains étaient signalés comme IA. Il s’agit donc d’un biais connu, et non d’un reflet de vos compétences.
Q: L’humanisation change-t-elle mes citations ou mes termes techniques ?
Non. L’humaniseur préserve vos citations, vos données et votre terminologie propre à votre discipline, tout en faisant varier le rythme des phrases et le choix des mots. Vous vérifiez chaque modification : rien dans vos références ou vos résultats ne change sans votre accord.
Rétablissez une variation naturelle dans votre anglais académique assisté par IA, conservez chaque citation et divulguez avec assurance. Conçu pour les chercheurs éthiopiens qui rédigent pour des revues internationales.

Moe est un ingénieur NLP avec un PhD en traitement du langage naturel. Ses recherches portent sur la linguistique informatique, l'analyse de texte et l'apprentissage automatique, et elles ont directement alimenté les modèles d'édition et d'humanisation derrière ProofreaderPro. Il écrit sur la partie du processus que la plupart des gens ne voient jamais : comment un modèle de langage lit une phrase, la note et décide quoi changer.


