
Humanizer IA pour les chercheurs néerlandais qui rédigent en anglais
Humanizer IA pour les chercheurs néerlandais. Réduisez les faux signalements de détection d’IA sur un anglais influencé par le néerlandais, tout en conservant le sens et les citations, et en déclarant honnêtement votre utilisation.

La recherche néerlandaise publie davantage d’études à fort impact par habitant que presque n’importe quel autre pays au monde, et la quasi-totalité de ces travaux paraît en anglais. Chaque année, les universitaires néerlandais se classent au niveau des tout premiers au classement de l’EF English Proficiency Index, si bien qu’un manuscrit d’Amsterdam ou de Delft arrive généralement propre, précis et grammaticalement irréprochable, comme dans un manuel. Puis un détecteur d’IA lit ce même texte fluide et le qualifie avec une forte probabilité de « généré par IA », ce qui oblige soudain un chercheur attentif, qui a écrit chaque mot à la main, à s’expliquer. C’est précisément ce problème que vise un humanizer IA pour les chercheurs néerlandais.
Voici l’ironie malaisante. Plus votre anglais est bon, plus votre formulation tend à être standard et prévisible, et une formulation prévisible est exactement ce que les détecteurs actuels interprètent comme une écriture de type machine. Un solide anglais « à la néerlandaise » ne protège pas un article contre un faux signalement. À certains égards, il y invite.
Ce guide explique pourquoi cela se produit, quelles habitudes néerlandaises de première langue déclenchent ce phénomène, comment la similarité et la vérification par IA fonctionnent réellement dans les universités néerlandaises, et comment protéger votre propre écriture en restant honnête : humanisez le brouillon assisté par IA que vous avez déjà rédigé, conservez votre sens et vos citations, puis déclarez votre utilisation de l’IA comme l’exigent votre institution et votre revue.
AI-tekst humaniseren voor Nederlandse onderzoekers die in het Engels publiceren
Notre humanizer aide les chercheurs néerlandais à publier leurs manuscrits rédigés en anglais sans que, à tort, une prose soignée et correcte soit classée comme du texte de machine. L’objectif de l’AI-tekst humaniseren est simple : le sens, la terminologie et les références restent inchangés, tandis que le rythme et le choix des mots deviennent plus naturels.
En anglais clair : le humanizer traite le brouillon que vous avez déjà rédigé, ou que vous avez préparé avec une aide IA. Il fait varier le rythme des phrases, rompt la cadence répétitive et supprime les signaux qui font trébucher un détecteur, sans toucher à votre argument, à vos données ni à vos références. Pour les textes non rédigés en anglais, l’outil passe par un modèle sensible à la langue, qui préserve la structure et le sens sur plus de soixante langues.
Écrire en néerlandais ? Il est détecté automatiquement et humanisé directement
Vous n’avez pas besoin de traduire un brouillon en anglais avant de l’humaniser. Collez un texte néerlandais : ProofreaderPro détecte la langue par lui-même, puis le fait passer par un modèle « néerlandais-aware » qui conserve exactement votre terminologie, vos mots composés et vos citations, tels qu’ils ont été écrits. L’AI-tekst humaniseren s’applique ainsi à votre langue maternelle : votre brouillon néerlandais est humanisé aussi aisément que votre anglais. La même détection s’étend à plus de soixante langues : le néerlandais est donc réécrit comme du néerlandais, plutôt que « aplati » en anglais.
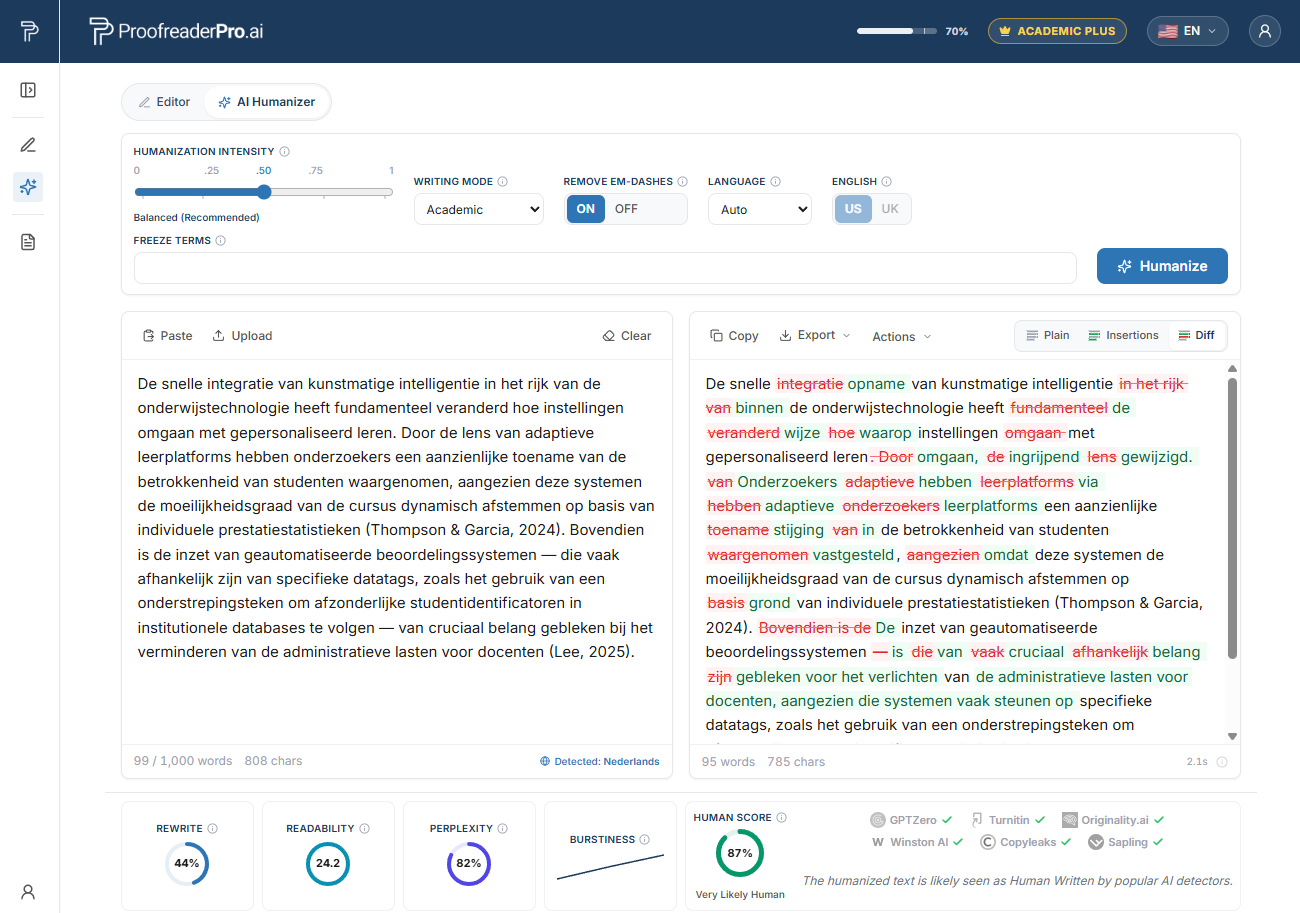
Le ProofreaderPro AI Humanizer réécrivant un texte académique néerlandais. Le diff avant/après conserve votre sens et vos citations, et les vérifications du détecteur confirment une lecture naturelle et humaine.
Pourquoi les chercheurs néerlandais sont signalés par les détecteurs d’IA
En 2023, une équipe de Stanford menée par Weixin Liang a publié une étude dans la revue Patterns de Cell Press, avec un titre sans détour : « GPT detectors are biased against non-native English writers ». Ils ont fait passer des essais rédigés par des humains, issus de l’examen TOEFL, à travers sept détecteurs d’IA largement utilisés. En moyenne, environ 61 % des essais non natifs ont été signalés comme « générés par IA ». Pour les essais rédigés par des locuteurs natifs de l’anglais, le chiffre était d’environ 5 %. Près d’un essai non natif sur cinq, soit environ 19,8 %, a été signalé unanimement par chaque détecteur. Chaque essai avait été écrit par un humain.
Le mécanisme mérite d’être compris, car il explique pourquoi la fluidité n’est pas une protection. La plupart des détecteurs évaluent ce qu’on appelle la perplexité : une mesure de la surprise associée à chaque choix de mot pour un modèle de langue. Un texte qui utilise des mots courants dans des combinaisons standard et attendues obtient une perplexité faible ; une faible perplexité est alors lue comme du texte produit par machine. Les auteurs académiques attentifs, en particulier ceux qui travaillent dans une langue seconde, s’orientent vers des formulations claires et conventionnelles précisément parce qu’elles sont sûres et correctes. Ce sont les habitudes qui rendent votre prose lisible que les détecteurs ont été entraînés à sanctionner.
Les chercheurs néerlandais se trouvent ici dans une position délicate. En termes de maîtrise de l’anglais, les Pays-Bas sont d’un niveau exceptionnel, ce qui signifie que l’anglais académique néerlandais est souvent plus propre et plus standardisé que la moyenne des brouillons natifs. Ce degré de finition réduit encore la perplexité. Nous avons proposé une explication plus complète sur cette dynamique dans pourquoi les détecteurs d’IA signalent les auteurs non natifs, et elle s’applique aux travaux néerlandais avec une force inhabituelle.
Les schémas de la première langue néerlandaise à l’origine des faux signalements
Aucun des schémas ci-dessous n’est une erreur. Ce sont des constructions justes, soigneuses et standard, et cette standardité est précisément ce que le détecteur lit comme une perplexité faible, une écriture « machine » au rythme régulier. Quelques exemples montrent comment les habitudes néerlandaises façonnent la prose anglaise.
Le néerlandais et l’anglais partagent une grande partie du vocabulaire, ce qui produit des « faux amis » fiables. « Actueel » signifie actuel, et non « actual » ; « eventueel » signifie éventuellement, et non « eventually » ; « controleren » signifie vérifier, et non « to control ». Un chercheur néerlandais qui a appris à éviter ces pièges écrit souvent avec une précision délibérée, ce qui aplatit les variations. Le résultat est cohérent et correct, et la cohérence constitue un signal de perplexité.
L’ordre des mots est un autre signal discret. En néerlandais, le verbe fini se place en deuxième position dans une proposition ; ainsi, une phrase avec un adverbe en tête peut apparaître en anglais comme « Therefore is the result significant » ou « In this study investigate we the effect ». La plupart des auteurs néerlandais corrigent cela avant la soumission, mais la correction produit alors le type de structure de phrase « soignée », canonique, que les détecteurs associent à un texte généré.
Viennent ensuite les articles. Le néerlandais autorise les articles définis avant les noms génériques et abstraits, de sorte que les brouillons portent des constructions comme « the research shows », « the society » ou « the nature of the problem », là où l’anglais supprimerait l’article. Ces tournures paraissent formelles et précises. Elles sont aussi lues comme très régulières.
Deux autres habitudes complètent l’ensemble. Le néerlandais privilégie les groupes nominaux lourds et la nominalisation, en empilant des constructions comme « the realisation of the implementation of », et il s’appuie sur des marqueurs discursifs tels que « namelijk » (namelijk) et « respectievelijk » (respectievelijk), souvent avec un registre direct et abrupt que certains évaluateurs perçoivent comme bref. Chacun de ces éléments est grammaticalement correct. Ensemble, ils construisent la texture fluide et à faible surprise que le détecteur mesure contre vous.
Protégez votre propre rédaction, en toute honnêteté
Humanisez votre brouillon rédigé avec assistance par IA tout en conservant votre signification, votre terminologie et vos citations, puis divulguez votre utilisation de l’IA comme l’exige votre revue.
Essayez gratuitement le HumanizerLe contexte de détection par IA et de Turnitin aux Pays-Bas
Les thèses néerlandaises et les soumissions en revue font régulièrement l’objet de contrôles de similarité, le plus souvent avec Turnitin ou iThenticate, et les institutions évaluent de plus en plus les indicateurs d’IA parallèlement aux contrôles plus anciens contre le plagiat. Il s’agit désormais d’une partie normale du pipeline de soumission, plutôt que d’une exception.
Les Universités des Pays-Bas (UNL) et des institutions individuelles ont publié des recommandations concernant la génération d’IA, et la direction générale est claire : des outils d’IA sont autorisés pour de nombreuses tâches, mais leur usage doit être déclaré plutôt que dissimulé. Les financeurs et les revues évoluent dans la même direction, en demandant aux auteurs d’indiquer où et comment l’IA a assisté leur travail.
Il est utile de se souvenir de la part réelle de poids que représente un score de détecteur. Turnitin atténue les scores d’IA dans la plage de 1 à 19 % et avertit que son chiffre ne doit pas être utilisé à lui seul pour prendre une décision sur l’intégrité. Plusieurs grandes institutions sont allées plus loin : Vanderbilt a désactivé le détecteur d’IA de Turnitin en 2023, en invoquant des faux positifs et un biais contre les auteurs non natifs, et Michigan State, Northwestern et l’Université de Pittsburgh ont pris des mesures comparables. Un signal de détection est une allégation que vous pouvez contester, pas un verdict tombant d’en haut.
Grandes universités néerlandaises et où apparaissent les contrôles d’IA
Les contrôles se font à l’échelle du système néerlandais. Les institutions ci-dessous vérifient toutes les thèses et les manuscrits pour la similarité, généralement avec Turnitin ou iThenticate, et intègrent de plus en plus les indicateurs liés à l’IA :
- Universiteit van Amsterdam (UvA), Amsterdam
- Universiteit Utrecht, Utrecht
- Universiteit Leiden, Leiden
- Technische Universiteit Delft (TU Delft), Delft
- Erasmus Universiteit Rotterdam (EUR), Rotterdam
- Rijksuniversiteit Groningen (RUG), Groningen
- Wageningen University & Research (WUR), Wageningen
- Radboud Universiteit, Nijmegen
- Vrije Universiteit Amsterdam (VU), Amsterdam
- Technische Universiteit Eindhoven (TU/e), Eindhoven
- Universiteit Twente (UT), Enschede
- Universiteit Maastricht (UM), Maastricht
- Tilburg University, Tilburg
Si vous défendez une thèse à Leiden ou si vous soumettez depuis un laboratoire WUR, votre document passera par ce type de contrôle. Le savoir à l’avance modifie la manière dont vous préparez la version finale.
Comment fonctionne l’humanizer IA pour les chercheurs néerlandais
Le processus de travail honnête comporte trois étapes, et la déclaration en fait partie : ce n’est pas un ajout après coup.
Première étape : rédiger. Écrivez en anglais, ou écrivez en néerlandais puis traduisez, en utilisant l’aide d’IA si cela accélère votre réflexion. Rien ne s’oppose à un premier brouillon assisté par IA, tant que l’argument, l’analyse et les preuves sont bien les vôtres.
Deuxième étape : relire et humaniser. Faites d’abord un nettoyage grammatical, puis passez le brouillon dans le AI humanizer. Il fait varier la longueur des phrases, rompt la cadence répétitive qui signale un texte de machine, et supprime les tics de mise en forme parasites, tout en laissant votre sens, votre vocabulaire technique et chaque citation exactement là où vous les avez placés. Lors de nos propres tests, cela réduit sensiblement la fréquence à laquelle un anglais non natif soigné et standard est mal interprété par les principaux détecteurs, tels que Turnitin, Originality.ai et GPTZero, tout en préservant le sens académique et la grammaire. Nous présentons cela comme ce que nous avons observé lors des tests, et non comme une promesse. Les détecteurs se réentraînent tous les quelques mois, et aucun outil honnête ne peut prétendre être 100 % indétectable. Quiconque vous le garantit vend quelque chose.
Troisième étape : déclarer. Indiquez votre utilisation de l’IA dans le format exigé par votre directeur de recherche, votre institution et la revue visée. C’est là l’objectif. Il ne s’agit ni de cacher l’IA ni de tromper un contrôleur de similarité ; il s’agit d’empêcher une écriture soignée et correcte d’être lue à tort, et de rester clairement aligné avec les règles d’intégrité pendant tout le processus.
Cette section s’inscrit dans notre multilingual AI humanizer hub, qui couvre le même workflow pour des chercheurs écrivant à partir de dizaines d’horizons linguistiques. Si votre besoin principal est davantage l’édition de la langue au niveau des lignes que l’équité de détection, notre global academic editing hub constitue le point de départ le plus pertinent.
Organismes financeurs locaux, revues et attentes en matière de déclaration de l’IA
Le financement compétitif néerlandais passe largement par le NWO (Nederlandse Organisatie voor Wetenschappelijk Onderzoek, le Conseil de recherche néerlandais), y compris ses programmes de subventions Talent Veni, Vidi et Vici. Les travaux de santé et de médecine sont financés via ZonMw, et le KNAW (Koninklijke Nederlandse Akademie van Wetenschappen, l’Académie royale néerlandaise des arts et des sciences) se trouve au cœur de la communauté nationale de recherche. Les équipes néerlandaises remportent également une part importante des subventions du European Research Council (ERC) et la publication en accès ouvert sous Plan S est exigée pour les résultats financés par le NWO.
Côté publication, les chercheurs néerlandais visent des revues indexées dans Web of Science et Scopus, déposent leurs productions dans des dépôts institutionnels et s’appuient sur l’infrastructure nationale coordonnée via SURF et les universités. Au fil des financeurs et des revues, l’attente relative à l’IA converge vers le même principe : déclarez votre utilisation, ne la dissimulez pas. Tenir une trace courte et honnête de l’endroit où l’IA a assisté votre rédaction rend cette déclaration simple lorsque, dans un rapport de subvention ou un formulaire de soumission, on vous le demande. Si vous êtes signalé malgré le fait d’avoir rédigé vous-même votre article, notre guide sur faire appel d’un faux signalement de détection d’IA explique comment répondre.
Questions fréquemment posées
Q : L’utilisation d’un humanizer IA sur mon article compte-t-elle comme de la triche ?
Non, lorsque vous l’utilisez comme nous le décrivons. Vous humanisez votre propre brouillon assisté par IA, en conservant votre argument, vos données et vos citations, puis vous déclarez votre utilisation de l’IA auprès de votre institution et de la revue. C’est l’inverse de dissimuler quelque chose. Le problème qu’il résout est d’ordre technique : une écriture attentive lue à tort comme du texte de machine, et non un problème d’intégrité.
Q : Mon anglais est vraiment excellent. Pourquoi un détecteur signalerait-il mon travail ?
Parce que les détecteurs ne mesurent pas si l’écriture est bonne ; ils mesurent à quel point elle est prévisible. Un anglais solide, standard et en langue seconde a tendance à être très cohérent, et cette cohérence produit la faible perplexité que les détecteurs associent à un texte d’IA. L’étude de Stanford a montré que des essais rédigés par des non-natifs étaient signalés bien plus souvent que ceux rédigés par des natifs : c’est précisément le schéma auquel de nombreux chercheurs néerlandais très à l’aise sont confrontés.
Q : Le humanizer peut-il garantir que je passe Turnitin ou GPTZero ?
Non, et vous devriez vous méfier de tout outil qui affirme le contraire. Les détecteurs changent leurs modèles tous les quelques mois : aucun produit honnête ne peut donc promettre un résultat spécifique ni prétendre être 100 % indétectable. Ce que nous pouvons dire, c’est qu’à travers nos tests, le humanizer réduit considérablement les risques que des textes non natifs soignés soient signalés à tort, tout en laissant votre sens et vos citations intacts.
Q : L’humanisation va-t-elle modifier mes citations, ma terminologie ou mes données ?
Non. Le humanizer est conçu pour préserver les termes techniques, les marqueurs de référence et le fond de votre argument. Il ajuste le rythme et le choix des mots pour sonner plus naturel, pas les faits, les chiffres, ni les sources que vous citez. Vous devez toujours relire le résultat avant de soumettre, comme vous le feriez pour toute autre modification.
Q : J’écris d’abord en néerlandais puis je traduis. Est-ce que cela fonctionne encore ?
Oui. Vous pouvez rédiger en néerlandais, traduire, puis humaniser la version anglaise. L’outil fait passer les textes non anglais et ceux issus de la traduction par un modèle sensible à la langue, qui maintient la structure des phrases et le sens stable : le workflow s’adapte ainsi à la manière dont écrivent, dans la réalité, de nombreux chercheurs néerlandais.
Réduisez les faux signaux d’IA sur une rédaction soignée en anglais non natif, tout en conservant votre signification, votre terminologie et vos citations. Gratuit pour essayer, conçu pour les chercheurs.

Moe est un ingénieur NLP avec un PhD en traitement du langage naturel. Ses recherches portent sur la linguistique informatique, l'analyse de texte et l'apprentissage automatique, et elles ont directement alimenté les modèles d'édition et d'humanisation derrière ProofreaderPro. Il écrit sur la partie du processus que la plupart des gens ne voient jamais : comment un modèle de langage lit une phrase, la note et décide quoi changer.


