QuillBot 的 AI 检测器:与改写及 AI humanizer 文本对比
在纯文本与改写后的 AI 文本上,QuillBot 的 AI 检测器几乎准确无误,但一项 2025 年研究发现,一旦该文本被 AI humanizer 处理,其准确率会降至 58%。
QuillBot 的 AI 检测器在识别纯文本与改写后的 AI 文本方面几乎精准。一项 2025 年的独立研究指出:一旦这些文本经过 AI humanizer 处理,其准确率会降至 58%。QuillBot 还打造了更受欢迎的 AI 改写工具之一,因此它自己的检测器必须应对与其其他工具所产出的那类“换句话”文本完全相同的情况。
这篇文章将介绍 QuillBot 如何标注扫描结果,2025 年研究对改写与 AI humanizer 文本得出的结论,以及 QuillBot 对其自身准确率的说法。文章也会涵盖免费版与 Premium 的限制,并说明该检测器与 Turnitin 的关联。
QuillBot 的检测器如何标注文本
一次 QuillBot 扫描会返回 0% 到 100% 的分数。它还会返回三种标签之一:AI 生成、人类撰写,或 AI 优化。QuillBot 使用“AI 优化”标签来标注:一个人开始撰写的内容随后被 AI 工具编辑或改写。这与模型从零开始直接生成的文本不同。只要文本先后被它的任一工具触碰,QuillBot 就会同样适用这三个标签。
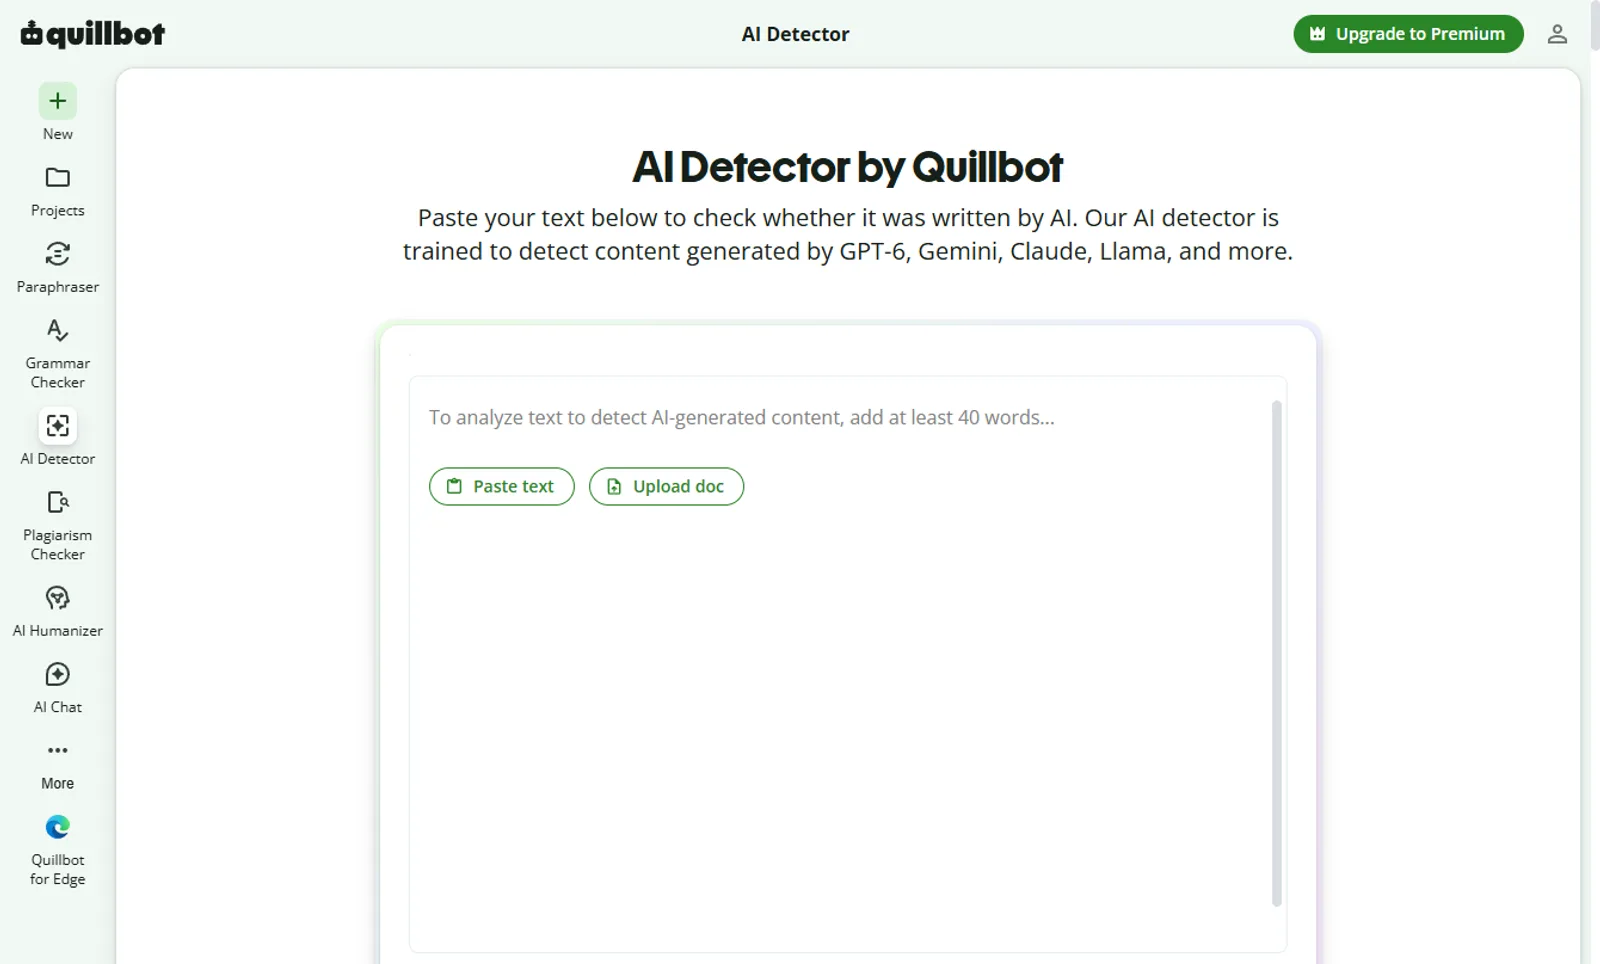
在实际使用中,这三个标签对应三种常见情形。将 ChatGPT 或 DeepSeek 的完整草稿直接、不做任何处理地粘贴进去,通常会被标记为 AI 生成。仅仅把语法修正过的人类草稿通常仍会被标为人类撰写,因为这种编辑不会触及句子结构。由改写器改写,或被 AI humanizer 重写的人类草稿,是 QuillBot 用来构建“AI 优化”标签的那类情况。
每个被标记句子旁边都会出现一个说明卡片,并附上简短原因,例如措辞过于可预测或节奏异常均匀。这两种信号,即“措辞可预测”和“句子节奏”,与困惑度和突发性相对应,而困惑度与突发性是大多数 AI 检测器在不同名字下使用的衡量方式。我们的关于 AI 检测中困惑度的解析更详细地介绍其工作原理。
QuillBot 建议至少 80 个词以获得可靠分数。它表示在 300 个词或更多时准确率最佳。像一段从上下文中截取出来的短内容,通常比完整文档能让模型获得的信息少得多。QuillBot 会逐句检查文档,而不是把整段当作一个整体,因此如果一篇长文只有一个被 AI 优化的段落,并不必然会让整篇在结果上被判定为 AI 生成。
这些标签都不是永久固定的。QuillBot 可以在你修改后对同一段文本重新扫描,并且随着措辞变化,标签可能在不同类别之间移动。单次扫描得到的分数描述的是该版本文档的情况,它并不能显示这份文档最初是如何写出来的。
网站所有者和博客作者也可以申请 QuillBot 证书与用于已发布页面的验证徽章,用于表明该页面为人类撰写。这一功能独立于主要扫描框,面向的是希望在在线页面上展示署名真实性证据的发布者。
一项 2025 年研究:QuillBot 在 DeepSeek、改写及 AI humanizer 文本上的表现
A 2025年 Hulayyil Alshammari 和 Praveen Rao 的研究,发布在 arXiv 上,使用来自 DeepSeek-v3 的文本来测试了六种 AI 检测器。这六种分别是:AI Text Classifier、Content Detector AI、Copyleaks、QuillBot、GPT-2 和 GPTZero。研究人员首先选取了 49 组来自 LLM 时代之前的人类编写的问答对,然后为这些相同问题生成 49 条对应的 DeepSeek-v3 答案。随后,他们通过改写和 AI humanizer 处理 AI 答案又增加了 196 个样本。接着在完整样本集上对这六种检测器进行了评分。
DeepSeek-v3 是一款比大多数公开检测器所主要调校对象更新的模型,这也是该研究有用的原因之一。主要针对 ChatGPT-style 输出构建并训练的检测器,并不会自动以相同方式处理其他模型的写作。研究从不存在大语言模型之前就已经写好的真实人类答案开始,也排除了“人类示例本身可能被 AI 影响过”的可能性。
| 条件(DeepSeek-v3 文本) | 研究中 QuillBot 的结果 |
|---|---|
| 原始的、未编辑 | 几乎完美 |
| 改写后 | 几乎完美 |
| AI humanizer 处理后 | 58% 准确率 |
在原始和改写后的 DeepSeek 文本上,QuillBot 和 Copyleaks 都达到了近乎完美的表现,这意味着它们几乎没有漏掉这些样本。研究中的其他一些工具(包括 AI Text Classifier 和 GPT-2)在相同样本上给出了不一致的结果。AI humanizer 处理文本是对六种检测器准确率影响最大的变化。它把 Copyleaks 降到了 71%,把 QuillBot 降到了 58%,并把 GPTZero 降到了 52%。
以检测器基准测试的标准来看,该研究的文本集规模不算大:49 份原始人类答案、49 份未编辑的 DeepSeek-v3 答案,以及通过改写和 AI humanizer 处理这类 AI 答案得到的另外 196 个样本。虽然样本量不足以提供更精确的百分比,但足以在六种检测器之间呈现出清晰的规律。论文还把 DeepSeek 本身测试为检测器:它使用少样本示例和 chain-of-thought 提示,而不是专门的检测模型。该部分关注的是 DeepSeek 自身的分类能力,并不包含 QuillBot 的结果。
对于那些把 AI 草稿先改写一遍并只依赖这一做法的人来说,这项研究是一个有用的数据参考。改写并没有降低本次测试中 QuillBot 的准确率。仅靠调整词序和改变句子结构,单独来看也不足以改变结果。降低 QuillBot 准确率的唯一变化是对文本进行 AI humanizer 处理,而 QuillBot 仍然能检测出大多数经过 AI humanizer 处理的样本。
对学生而言,这一结果里真正有用的是区分“改写”和“重写”。改写者会更换词语,并调整一定的句子顺序。基于你自己的理解进行重写,会改变论点、例子和结构,这也是让草稿更像是你自己的原因。
QuillBot 对准确率的说明
QuillBot 引用了在 RAID 上 99% 的检测率。RAID 是一个覆盖多个大型语言模型的独立基准。我们在关于 Grammarly 的 AI detector 的文章中解释 RAID 会测试什么内容,该工具在 RAID 的排行榜上排名第一。
QuillBot 的 FAQ 提到了两种它预期会出现更多错误的情况。公式化写作,例如学术定义、法律文本或结构化模板,更容易触发误报。大幅改写或仅做轻度 AI 编辑的写作,对任何检测器来说都更难识别。QuillBot 还表示没有任何 AI detector 能达到 100% 的准确率,并且某个结果应当被视为一种信号而不是定论。
上述 2025 年研究为更新的模型 DeepSeek-v3 提供了一个独立的数据点,而许多检测工具最初并未针对该模型进行调优。
QuillBot 的 humanizer 页面提到了一点相关内容,说明该公司如何定位其完整的 AI 写作工具箱。它表示该 humanizer 旨在改进草稿,并要求用户根据所在机构或雇主的政策披露 AI 的使用。这个定位同样适用于同一账户中的检测器。
免费 vs Premium
| 功能 | 免费 | Premium |
|---|---|---|
| 每次扫描的字数限制 | 最多 1,200 字 | 无字数限制 |
| 每日扫描次数 | 最多 6 次 | 无限制 |
| 说明卡 | 1 张免费卡 | 在全文范围内无限制 |
| 价格 | US$0 | 每月 US$4.17,按年计费 |
QuillBot 的免费 AI Detector 每次扫描最多限制 1,200 字,并允许每天进行 6 次扫描,每次扫描包含 1 张说明卡。Premium 取消这两项限制,并对每一条被标记的句子提供完整解释,而不是仅提供一条。QuillBot 的其他工具也包含在同一价格中,也就是按年计费时每月 US$4.17。
如果有人只检查一份简短作业,可能几乎永远不会触及免费额度上限,因为一次扫描大约覆盖双倍行距文本的四页内容。一份 6,000 字的文献综述若按 1,200 字分段检查,在免费计划下需要 5 次扫描,仍在每天 6 次的限制内。更长的论文章节如果在一次坐下的过程中多次检查,你最可能触达到每日上限。Premium 还允许你下载整份报告的副本。如果主管或编辑想查看解释细节,而不仅是最终的百分比,这会很有用。
QuillBot 的检测器与 Turnitin
QuillBot 的 AI Detector 和 Turnitin 是两个独立工具,由两家不同公司构建,并且其中一个的分数并不能预测另一个的分数。Turnitin 将其 AI 写作检测授权给学校、大学和出版社,因此大多数学生只会通过授课老师看到 Turnitin 的结果。我们的 Turnitin 分数指南 介绍了 Turnitin 如何展示其自身的 AI 与相似度数据。
2025 年 8 月,Turnitin 增加了一项它称为 AI bypasser detection 的功能,这是一组面向已被 humanizer 或重度改写器处理过文本的模型。该功能目前仅覆盖英语。我们的 QuillBot Humanizer 替代指南 会讲解这项更新对 QuillBot 自身 humanizer 的含义。
两种工具之间的实际差异对通过 Turnitin-enabled 课程提交的人最关键。一次 QuillBot 扫描的分数,即使是令人安心的分数,也无法说明 Turnitin 自己的 AI 写作报告是否同样会给出低分。这两者运行在不同的训练数据上,并采用不同的阈值。
上述 DeepSeek 研究显示了类似的分化。仅改写并不会降低 QuillBot 或 Copyleaks 的准确性,而 humanizing 会。Turnitin 在 2025 年的更新瞄准的正是这一差口:改写到足以让文本读起来不同,但仍然携带检测器可能衡量的结构性模式。
如果你的课程使用 Turnitin,请把一次 QuillBot 扫描当作对自己草稿的核查,并把结果与笔记一起保存。如果之后授课老师对 Turnitin 结果提出质疑,你的草稿与笔记会比任一分数都更有证据价值,正如我们在 过程就是新的证明 中解释的那样。
Scribbr 的免费 AI Detector 使用的是 QuillBot 自身的技术。Scribbr 的检测器页面会通过 QuillBot 的合作伙伴脚本,从一个面向 Scribbr 站点设置的 QuillBot 子域 quillbot.scribbr.com 加载其扫描结果。我们的 查看 Scribbr 的 AI 检测器 会介绍这对 Scribbr 自身结果意味着什么。
如果你只是把 AI 草稿改写了,并且仅靠这一点来应对,那上面的研究值得你再看一遍。用你自己的笔记、用你自己的例子和你自己的结构来重写内容,比改写工具所做的变化更能影响一篇写作本身。如果你更想先把工具逐一对比,我们的QuillBot 学术写作替代方案以及我们的ProofreaderPro.ai 对比 QuillBot对比都涵盖了 QuillBot 在学术草稿中的适用位置。无论你选择哪条路径,QuillBot 官方的建议仍然适用:无论任何检测分数显示什么,都要按照你所在课程或雇主的政策披露 AI 辅助。我们的学术 AI humanizer通过同时调整句子结构和用词选择来尽可能降低 AI 检测评分,并且会保持引文、技术术语和数字不受影响。
常见问题
Q: QuillBot 的 AI 检测器能检测它自己的改写器吗?
在仅包含纯改写文本的情况下,是的。Alshammari 和 Rao 在 2025 年的一项研究发现,QuillBot 的检测器对经过改写器处理后的 DeepSeek-v3 文本几乎是完美的。对同一文本进行 humanizing 会带来更大挑战,使该研究中的 QuillBot 准确率降至 58%。
Q: QuillBot 的 AI 检测器能检测 DeepSeek 文本吗?
可以。上述同一项 2025 年研究将 QuillBot 专门测试在 DeepSeek-v3 的输出上,发现对原始版本和改写版本都取得了接近完美的结果,与该测试中的 Copyleaks 表现一致。
Q: QuillBot 中的“AI refined”是什么意思?
这是 QuillBot 对一种写作的标注:写作起初来自一个人的原创文本,然后再使用 AI 工具进行编辑或改写,而不是从零开始由模型直接生成。QuillBot 是逐句评分的,所以一段被 AI refined 的段落不会把整篇文档都变成 AI 生成结果。
Q: 我最多可以免费检查多少词?
最多可扫描 1,200 词,每天最多 6 次扫描(QuillBot 免费计划)。Premium 会移除这两项限制,价格为 US$4.17/月,按年计费。
Q: 只为了检测功能,QuillBot Premium 值得吗?
这取决于你扫描的频率以及你的文档长度。Premium 会移除 1,200 词的上限和每日 6 次扫描的限制,并且会为每一句被标记的句子提供完整解释,而不是只给一句说明。QuillBot 的其他工具仍会以相同价格提供。
Q: Turnitin 能检测 QuillBot 的改写吗?
通常是可以的。Turnitin 在 2024 年 7 月增加了专门的 AI 改写检测,在 2025 年 8 月增加了一个 AI 绕过层,面向经过 humanizer 或重度改写处理的文本。我们的QuillBot Humanizer 替代方案指南涵盖了完整情况。
Q: QuillBot 的检测器支持其他语言吗?
可以。QuillBot 表示其 AI 检测器支持超过 20 种语言,包括英语、西班牙语、法语和葡萄牙语。其 AI humanizer 覆盖的语言更少:西班牙语、德语、法语、葡萄牙语,以及 4 种英语方言。
Q: QuillBot 的检测器和 Scribbr 的是否相同?
基本是的。Scribbr 的 AI 检测器页面会通过页面嵌入的 QuillBot 合作方脚本,从 quillbot.scribbr.com 加载其扫描结果,这是一个 QuillBot 子域。我们的查看 Scribbr 的 AI 检测器介绍了 Scribbr 如何在该同一工具的基础上呈现其自有结果。
在引文、术语和含义保持不变的前提下,重写由 AI 辅助的学术草稿。
Dana 是 ProofreaderPro 的内容创作者,负责日常博客和写作业务。 她撰写有关在线编辑平台如何运作的文章,每天处理客户消息,并获得了五星级的满意度评分。