Pangram AI检测器评测(2026):准确率与误报
Pangram的AI检测器准确吗?它宣称准确率99%+,误报率为每1万次约1次。看看独立研究的结论,以及它与其他工具的对比。
Pangram是Pangram Labs推出的AI检测器,公司表示其准确率超过99%。它也表示会把约每1万条人类文本误判为AI。Pangram提到来自芝加哥大学和马里兰大学的外部研究,并称这些研究得出了类似结果。
下面我们将依次查看Pangram自身给出的准确率与误报数据,以及独立研究的发现。随后还会介绍Pangram如何检测AI文本、它与GPTZero、Copyleaks和Turnitin的对比,并提供其定价与语言支持情况。
Pangram能做什么
Pangram是一款面向学校、出版机构、律所及其他需要区分人类与AI写作的组织的AI检测工具。你可以粘贴文本或上传文件。Pangram会给出“Human(人类)”“AI-Generated(AI生成)”或“AI-Assisted(AI辅助)”的预测结果,并为文档中每个标签占比提供评分。
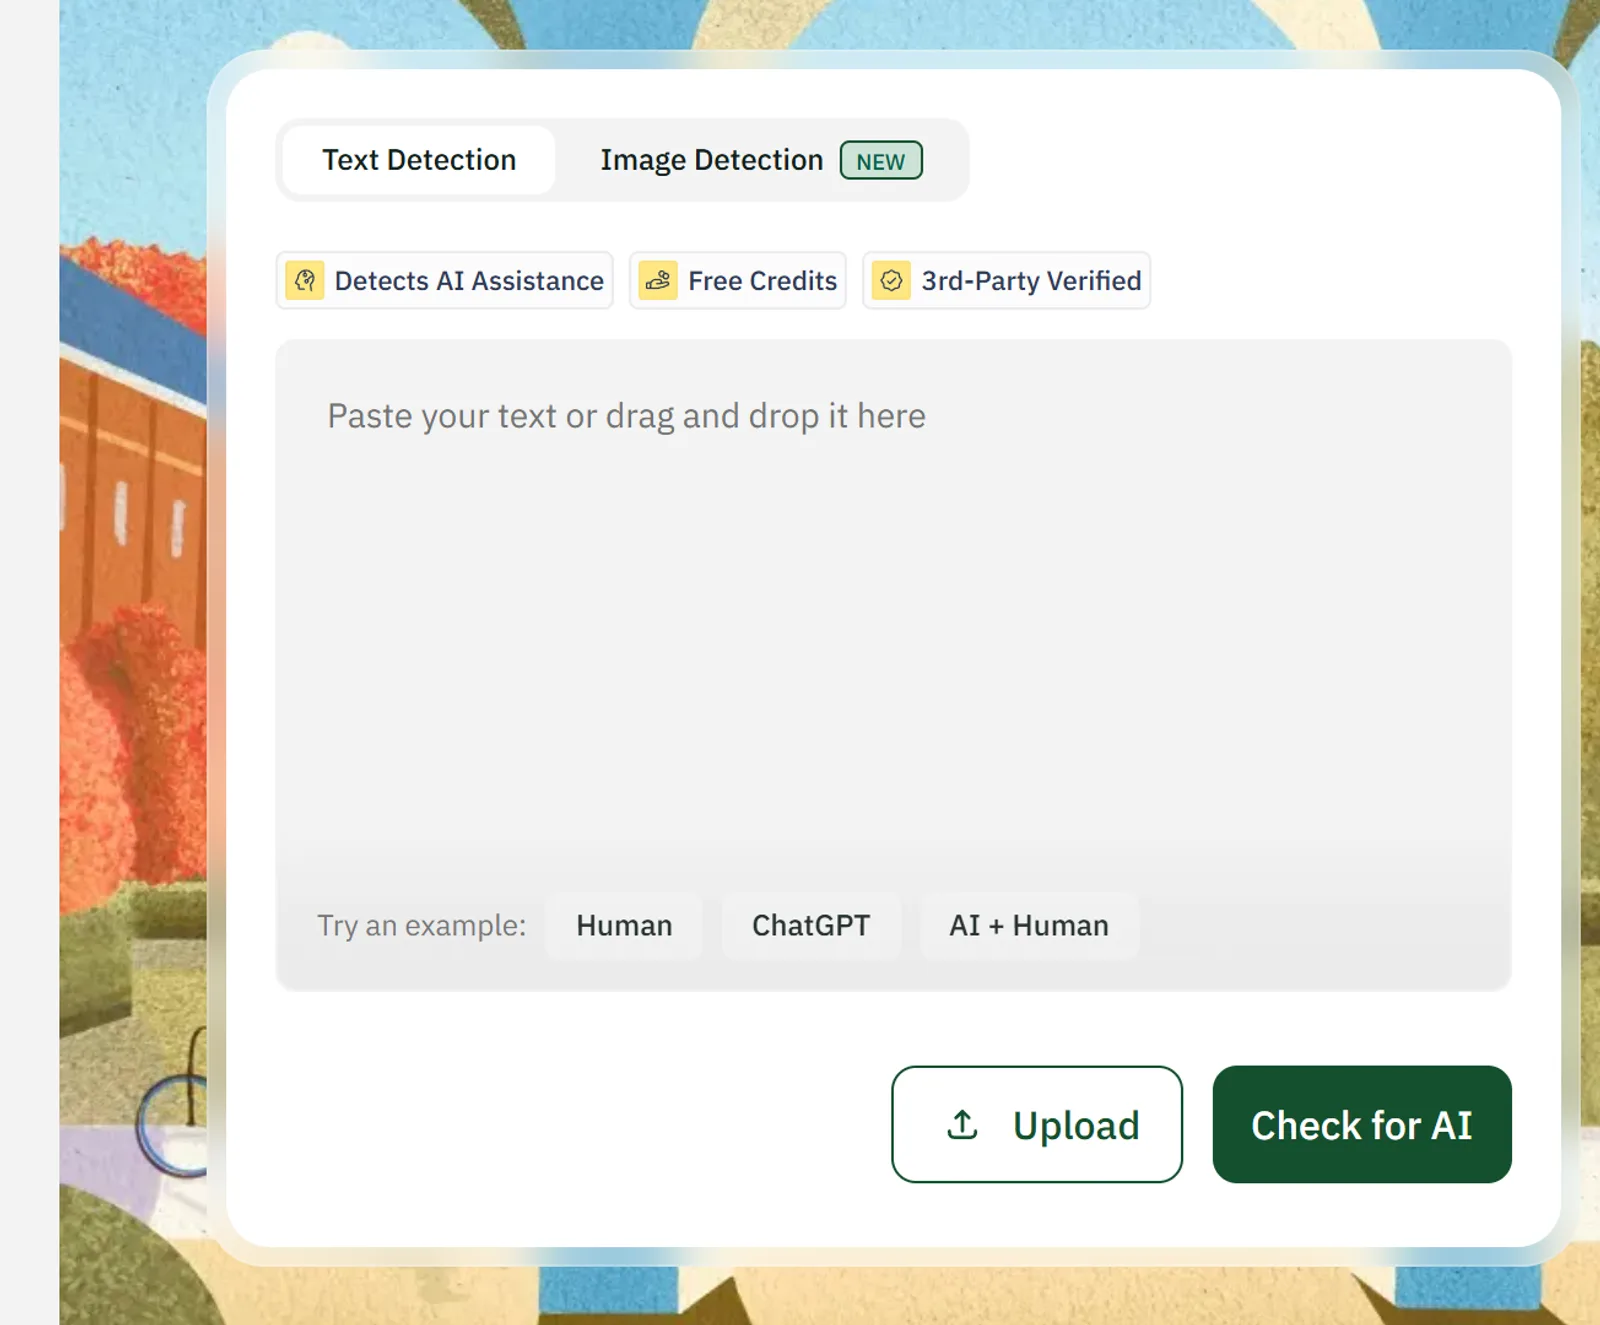
Pangram Labs于2023年在纽约州布鲁克林成立。其创始人在创建公司之前曾在Tesla和Google从事AI研究。产品线现已包括与AI检测器捆绑的抄袭检测器、AI图像检测器以及浏览器扩展。此外,它还可与Gmail、Google Docs以及Canvas、Moodle、Google Classroom和Brightspace等学习管理系统集成。开发者还可通过API将AI检测能力嵌入自身应用。
Pangram最新模型Pangram 4至少需要输入50个词,并且在使用完整句子时表现最佳。简短回复和要点式内容给它的可用信息更少。每个结果都会为每个片段提供置信度等级(High、Medium或Low),并附带高亮片段,用于标记模型判定为AI-Generated、AI-Assisted或Human的句子。
“AI-Assisted”标签表示Pangram认为有人启动了写作,然后由AI进行编辑或润色。如果你对文本的部分内容使用了语法工具或AI改写器,即使你的想法与结构本身是自己的,这个标签也可能出现。在你把该标签视为问题之前,请先确认学校或雇主允许的AI编辑工具范围。
Pangram对其准确率的声明
Pangram的FAQ指出,该检测器准确率超过99%,误报率约为每1万次1次。它表示这一数据是在包含数千万份文档的公开数据集上计算得出。Pangram还会将其模型与26种AI系统进行基准测试,并报告在这些AI生成样本的整体群组上达到99.7%的准确率,而且会在每次重大模型发布后重新测试。
Pangram也会公布单个模型的准确率数据:
| AI模型 | Pangram的报告准确率 | 测试 |
|---|---|---|
| Claude Opus 5 | 99.8% | 2026年7月 |
| GPT-5.6 | 99.6% | 2026年7月 |
| Gemini 3 | 99.5% | 2026年7月 |
| Grok 4.3 | 99.4% | 2026年7月 |
这是 Pangram 自己的数字,基于其自身的测试集测得。其 Pangram 4 模型卡进一步细分了数据。在来自 26 个模型的 519,993 份英文 AI 生成样本中,Pangram 4 未能识别 0.34%,接近 99.7% 的标题数据。模型卡还列出了覆盖 18 种语言的多语言集的 1.24% 漏报率,因此 Pangram 对英文之外的 AI 文本识别得略不那么稳定。
Pangram 的误报率,按领域与语言划分
Pangram 的 FAQ 给出了单一的总体误报率,即每 10,000 中 1。Pangram 4 的模型卡报告了更具体的数值。以 FineWeb 数据集中的 1,000,000 份英文文档为例,Pangram 4 出现 41 处误报,误报率为 0.0041%,接近每 24,000 中 1。在包含 104 种语言、共 996,273 份文档的多语言集上,它出现 14 处误报,误报率为 0.0014%。
误报率会随领域而变化。Pangram 的模型卡列出了这些误报率:
| 领域 | 误报率 |
|---|---|
| 学术写作(英文) | 0.019% |
| 新闻(多语言) | 0.003% |
| 创意写作、长篇 | 0.000% |
| 生物医学研究论文 | 0.002% |
| 操作指南文章(多语言) | 0.016% |
| 电影剧本 | 0.010% |
| 诗歌 | 0.078% |
| 食谱 | 0.049% |
针对英文学术写作,Pangram 的模型卡给出的误报率为 0.019%,约为每 5,000 份文档 1 次。这比其总体数据更高,也是对学生与研究人员最重要的数字。规范性的学术文风遵循固定模式,而公式化文本正是 Pangram 自有数据表明误报更多的地方。
Pangram 在关于误报的博客文章中表示,在文本较短、未写成完整句子,或高度公式化时,误报率会升高,例如食谱和诗歌。它也表示,在诸如论文、评论与报告等篇幅更长、且更具原创性的写作中,误报率会保持较低,因为这类写作会给模型提供更多可供判断的信息。
语言也会影响结果。Pangram 的模型卡列出了对 24 种语言的官方支持。这些语言包括:英语、西班牙语、法语、葡萄牙语、阿拉伯语、中文(Chinese)、日语、韩语、俄语、土耳其语、匈牙利语、德语、荷兰语、瑞典语、罗马尼亚语、乌克兰语、波兰语、意大利语、捷克语、希腊语、印地语、波斯语、乌尔都语和越南语。其测得的误报率范围从如阿拉伯语、中文和日语这类语言的 0.0000%,到葡萄牙语的 0.0078% 以及乌克兰语的 0.0361%。但这些数值仍远低于每 1,000 中 1。Pangram 还表示,它可以推广到该列表之外的语言,并邀请用户提交请求以评估新语言。
Pangram 还发布了与其他检测器的对比。在来自芝加哥大学研究人员的产品评论数据上,它报告了自身的误报率为 0.5%,Originality.ai 为 1.7%,GPTZero 为 2.4%。这些是 Pangram 的数据,来自其自身博客。
Pangram 引用的外部研究
在一项 2025 年芝加哥大学 Booth 研究 中发现,领先的 AI 检测器会对超过 90% 的未编辑 AI 文本发出警报。多数检测器在文本经过 AI humanizer 处理后,识别到的比例会降到一半以下。Pangram 是被测试的四个检测器之一,另外还有 GPTZero、Originality.ai 以及开源检测器 RoBERTa。Pangram 表示,它是唯一一个在仍能检测出 AI 文本的同时,将误报率控制在 0.5% 以下的检测器。
Pangram 还引用了来自 Vrije Universiteit Brussel 的一项 2026 年 6 月研究。该研究在非母语英语作者撰写的 160 篇学术论文上测试了 Pangram、GPTZero、Turnitin 和 Copyleaks,并将样本分为人类撰写、AI 生成、混合以及经过 AI humanizer 处理的文本。Pangram 表示,在那项研究中,这四种工具都没有对人类撰写的论文发出警报。
一项 2025 年研究:Pangram 对比专家人类读者
Jenna Russell、Marzena Karpinska 和 Mohit Iyyer 于2025年的论文在 ACL 2025 发表。该研究测试了经常使用 AI 写作工具的人,能否像自动检测器一样准确地识别 AI 生成文本。五位自述经常使用 LLM 来进行自身写作的标注者,阅读了 300 篇英文非虚构文章。该数据集将人工撰写文本与来自 GPT-4o、Claude 和 o1-Pro 的文本混合在一起,其中也包含部分经过 humanizer 的文章。由这五位标注者进行的多数投票,仅将 300 篇文章中的 1 篇错误分类。
该论文将这组人工评测与五种自动检测器进行对比:Pangram、GPTZero、Binoculars、Fast-DetectGPT 和 RADAR。研究人员运行了两个 Pangram 模型,包括其基础检测器以及另一个名为 Pangram Humanizers 的独立模型,该模型专门用于检测经过 AI humanizer 的文本。Pangram Humanizers 是唯一能够与专家小组结果相匹配的检测器,平均真阳性率为 99.3%,在测试集上的平均假阳性率为 2.7%。在同一测试中,Pangram 的基础模型平均真阳性率达到 98.0%,假阳性率为 2%。
2.7% 的假阳性率高于 Pangram 在其自身评估中报告的“约 1/10,000”。本次测试使用的文章数量远少于 Pangram 在其他地方引用的规模,只有 300 篇而非数百万篇。论文还仅使用 Pangram 的“Human”和“AI-Generated”标签对其进行评分,并未因其标注了中性的“Possibly AI”而给予加分。Pangram 和 GPTZero 都为研究人员提供 API credits,用于运行此次测试。
Pangram 如何检测 AI 写作
Pangram 表示它不使用困惑度(perplexity)或突发性(burstiness),这两个是许多较早期 AI 检测器依赖的信号。困惑度衡量语言模型对每个词的可预测程度,而突发性衡量这种可预测性在整篇文档中变化了多少。我们在自己的文章中也解释了两者,见AI 检测中的困惑度(perplexity)。
Pangram 认为,基于困惑度的检测器会在任何语言模型在训练中记住的文本上误报,包括《Declaration of Independence》(《独立宣言》)以及 Wikipedia 的大量内容。模型会用非常低的困惑度去学习并预测被记住的文本,无论这些内容是谁写的。Pangram 还表示,相比非母语英语写作,基于困惑度的方法在非母语写作上具有更高的假阳性率,因为更简单的句子结构也同样更容易被预测。我们在一篇文章中也讨论了相同的非母语英语写作者的假阳性模式,并查看其他检测器的情况。
Pangram 的做法是直接在大规模人工文本与 AI 文本集合上训练一个深度学习模型。它使用一种称为“hard negative mining”的方法,用于寻找恰好与 AI 输出相似的人类写作。Pangram 以 token 级别处理完整文档。它会为每个片段标注 Human、AI-Assisted 或 AI-Generated,并给出一个连续分数,表示该片段看起来有多像 AI 写作。Pangram 表示,随着训练数据不断增加,模型表现会随之提升。
Pangram vs GPTZero、Copyleaks 和 Turnitin
Pangram、GPTZero 和 Copyleaks 对任何注册用户开放。Turnitin 只能通过学校或出版方账户使用,个人测试参与者通常只有在授课教师转交之后,才会看到 Turnitin 分数。
| 检测器 | 访问方式 | 供应商自身关于假阳性的说法 | 免费方案 |
|---|---|---|---|
| Pangram | 开放注册 | 约 1/10,000(总体) | 每天 2,000 words |
| GPTZero | 开放注册 | 约 1% | 每次扫描 10,000 characters |
| Copyleaks | 开放注册 | 约 0.2% | 有限次数的免费扫描 |
| Turnitin | 仅限学校与出版方 | 学术写作 0.51% | 不提供给个人使用 |
我们已分别介绍了这些检测器:参见GPTZero 准确吗?独立测试揭示的结果(2026)、Copyleaks 能检测 AI 吗?准确性与应该怎么做以及Turnitin 能在 2026 年检测“人性化”AI 文本吗?。表格中的误报数据均来自各家公司的自身声明,Pangram及其他供应商亦如此。
Pangram是一款独立的检测器。Grammarly和Scribbr将AI检测作为其写作工具的一部分,我们也分别查看了Grammarly AI检测器和Scribbr AI检测器。
定价与免费方案限制
Pangram的免费计划无需付款方式。每日可扫描2,000个词,并包含每日3次图片检测扫描。这还包括使用OCR的文件上传、浏览器扩展、Google Docs集成以及API访问,支持超过20种语言。
| 方案 | 价格 | 新增内容 |
|---|---|---|
| 免费 | US$0/月 | 每天2,000词,图片每天3次扫描 |
| 个人 | US$20/月,按年计费 | 每月300,000词,每月100次图片扫描,查重检测,Gmail集成 |
| 专业版 | US$65/月,按年计费 | 个人版的5倍词数与图片扫描次数,并另含每月US$200的API额度 |
个人版计划在启动US$20每月收费之前提供7天免费试用。按年计费可比按月费率每年节省US$60。专业版计划会在试用之外直接按US$65收费,而非通过试用开始,并且按年计费可节省每年US$240。Pangram还为团队提供单独的商务定价,需在其定价页面选择“Business”选项卡后查看。
谁在使用Pangram
学校和大学构成Pangram最大客户群。其LMS集成可直接连接到Canvas、Moodle、Google Classroom和Brightspace。教师可以在不离开其原本用于批改的工作平台的情况下,在学生提交旁边查看一项Pangram结果。
出版机构、律所和人力资源团队会因不同目的使用Pangram:核查已提交的手稿、在案件中审阅文件,或筛查应聘者材料。API让这些机构能够将Pangram的检测嵌入到自身的内部工具中。Gmail与Google Docs集成让一名用户在不离开收件箱或文档的情况下检查文本。
对于学生而言,这通常意味着Pangram分数会出现在与你教师用于打分与反馈的同一个仪表盘内。它不是你需要自行申请的单独报告。如果你的学校通过LMS使用Pangram,请向你的授课老师或部门询问:哪些分数被视为需要关注,以及接下来会发生什么。
如果Pangram结果确实标记了你的写作,那么你自己草稿过程的记录所能证明的内容往往比只争论分数本身更有分量。我们在单独的文章中进一步讨论:流程即为新证明以及如何申诉错误的AI检测标记(学生与研究者操作指南)。
如果AI帮助撰写了你论文的一部分,我们的academic humanizer会用你自己的写作声音重写那一部分。引文、专业术语与数字会保持与你写的一模一样,且该工具的设计目标是针对它接触到的段落将AI分数降下来。
常见问题
Q: Pangram准确吗?
Pangram表示其准确率超过99%,并引用了外部研究,结果与其相似。其自身的模型卡显示:当文本少于50词,以及在英语之外的某些语言中,准确率会更低。
Q: Pangram的误报率是多少?
Pangram的常见问题(FAQ)给出的总体比例约为万分之一。其Pangram 4模型卡报告了更具体的数值0.0041%,约为万分之24,且在对1000000份英文文档进行测量时得到该结果。该比例会随领域和语言而变化。
Q: Pangram与GPTZero相比如何?
Pangram表示其误报率约为万分之一,而GPTZero在RADAR基准测试中的数值约为1%。两者都提供免费方案并可公开注册。我们在文中覆盖了GPTZero的自有数据:GPTZero准确性评测。
Q: Pangram与Turnitin相比如何?
Turnitin只能通过学校或出版方账户使用,而任何人都可以直接注册Pangram。Pangram引用了Turnitin自身白皮书中关于学术写作的0.51%误报率,并报告了其自身更低的误报率。
Q: Pangram与Copyleaks相比如何?
Copyleaks表示其误报率约为0.2%,而Pangram报告了其自身更低的误报率。两者都提供免费扫描,我们也在Copyleaks 能检测 AI 吗?准确性与应该怎么做中介绍了Copyleaks。
Q: Pangram如何检测AI写作?
Pangram使用经过训练的深度学习模型,来区分人类文本与AI文本。它不使用困惑度(perplexity)和突发性(burstiness),而这两项正是许多较旧检测器依赖的指标。它会将文档的每个片段标注为Human、AI-Assisted或AI-Generated,并为结果提供置信度水平。
Q: Pangram的AI检测能免费使用吗?
是的,Free方案无需支付任何费用方式,并且每天包含2,000词的文本扫描,以及3次图片扫描。付费方案起价为每月US$20,按年计费,包含每月300,000词以及抄袭检测。
Q: Pangram能检测经过AI humanizer处理的文本吗?
Pangram表示可以,并将2025年Chicago Booth的研究作为支持。由于检测器和AI humanizer都会经常更新,因此对AI humanizer处理过的文本所得结果可能会随时间变化。
Q: 关于Pangram,Maryland大学的研究发现了什么?
一篇2025年来自Maryland大学的论文发现,Pangram的人类化感知模型Pangram Humanizers,是唯一一种能够与由五位专家人类读者组成的小组达到一致匹配的自动检测器。双方在300篇测试文章上的平均真实正例率均为99.3%。在这项特定测试中,Pangram的误报率为2.7%,明显高于其从自身更大规模评估中报告的万分之一。
Q: 是谁在制作Pangram?
Pangram Labs是Pangram背后的公司。该公司于2023年在美国纽约Brooklyn成立,由来自Tesla和Google的前AI研究人员创立。该公司还与其文本检测器一起销售抄袭检测器、AI图片检测器,并提供API访问。
使用你自己的表达方式改写AI辅助的学术草稿,同时保留你写入的引文、技术术语和数字原样不变。
Dana 是 ProofreaderPro 的内容创作者,负责日常博客和写作业务。 她撰写有关在线编辑平台如何运作的文章,每天处理客户消息,并获得了五星级的满意度评分。