
Humaniseur d’IA pour les chercheurs espagnols rédigeant en anglais
Humaniseur d’IA pour les chercheurs espagnols. Réduisez les faux signalements de détection d’IA sur un anglais influencé par l’espagnol, tout en conservant le sens et les citations, et en déclarant votre usage de manière transparente.

L’Espagne fait partie des principaux producteurs de recherche en Europe, se classant régulièrement parmi les 10 à 12 meilleurs contributeurs mondiaux en volume de publications. Presque l’ensemble de ces travaux parvient à ses lecteurs en anglais, langue seconde pour la plupart des personnes qui les rédigent. C’est précisément dans cet écart, entre la pensée en espagnol et la publication en anglais, que s’inscrit un humaniseur d’IA pour les chercheurs espagnols.
Voici le problème que personne n’avait anticipé. Les détecteurs de textes générés par IA sont désormais intégrés aux outils qui filtrent les thèses et les soumissions à des revues. Ils ont été conçus pour repérer un texte « machine », mais ils signalent régulièrement comme IA une écriture humaine, soignée et correcte, produite par des non-natifs anglophones. Votre style n’est pas le souci : c’est sa prévisibilité.
Un chercheur à Madrid ou à Barcelone qui rédige en espagnol, traduit, puis affine pour produire un anglais académique clair peut se retrouver perçu comme plus « mécanisé » qu’un locuteur natif imprudent qui n’aurait jamais utilisé d’outil linguistique. Cet article vise à combler cet écart de façon explicite : améliorer votre propre brouillon, conserver votre sens et vos citations, et déclarer votre usage de l’IA comme l’exigent votre université et votre revue.
Un humanizador de texto de IA para investigadores españoles
Notre humanizador de texto de IA aide les chercheurs espagnols à publier en anglais sans que leur rédaction soignée soit confondue avec un texte généré par une machine. Il conserve votre signification, votre terminologie technique et vos citations, et fait varier le rythme ainsi que le choix des mots que le détecteur interprète comme automatiques.
En termes simples, l’outil retravaille le rythme et le choix lexical de votre brouillon afin que cette prose soignée de langue seconde ait moins de chances d’être mal lue, tandis que votre argument et vos références restent exactement là où vous les avez placés. Il est conçu pour un travail réel réalisé par des auteurs réels, et non pour déguiser quoi que ce soit.
Humanisez aussi directement votre espagnol, pas seulement votre anglais
Vous n’avez pas besoin de passer à l’anglais avant d’humaniser votre travail. Collez un extrait en espagnol et ProofreaderPro détecte automatiquement la langue, puis l’achemine vers un modèle sensible à l’espagnol qui conserve accents, terminologie et citations exactement tels qu’ils apparaissent. En tant que humanizador de texto de IA, il fonctionne sur votre brouillon en espagnol de la même manière que sur votre anglais, en préservant le sens tout en rendant l’expression plus naturelle. La détection couvre plus de soixante langues : l’espagnol est réécrit en espagnol, et non « aplati » en anglais.
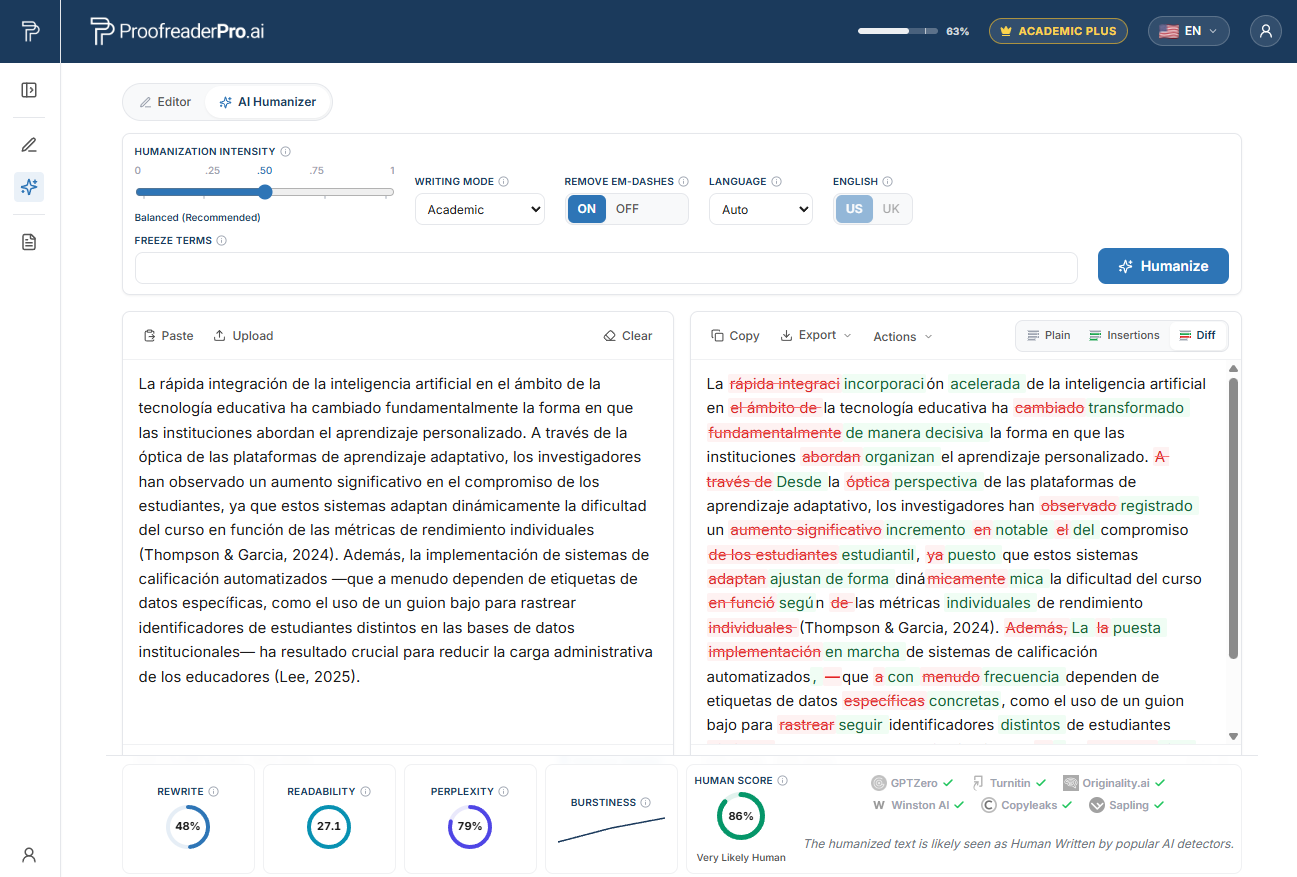
Le ProofreaderPro AI Humanizer réécrivant un texte académique en espagnol. Le diff avant/après conserve votre sens et vos citations, et les vérifications du détecteur confirment une lecture naturelle et humaine.
Pourquoi les chercheurs espagnols sont-ils signalés par les détecteurs d’IA ?
La preuve la plus claire provient d’une étude de 2023 de Stanford, menée par Liang et ses collègues, publiée dans la revue Cell Press Patterns, sous le titre « GPT detectors are biased against non-native English writers. » L’équipe a fait passer des essais rédigés par des humains, à partir d’un TOEFL, à sept détecteurs largement utilisés.
Les résultats devraient inquiéter quiconque publie dans une langue seconde. En moyenne, environ 61% des essais non natifs ont été signalés comme « IA », contre environ 5% pour les rédacteurs natifs anglophones. Près d’un essai non natif sur cinq, soit environ 19,8%, a été signalé unanimement par l’ensemble des détecteurs. Tous les essais ont été rédigés par des humains.
Le mécanisme s’appelle la perplexité : une mesure de la surprise que provoquent, dans un modèle de langage, les choix de mots pour chaque segment. Les rédacteurs rigoureux en langue seconde privilégient des mots courants et des formulations standard, prévisibles, ce qui produit une faible perplexité, interprétée par le détecteur comme un texte « machine ». Les habitudes mêmes qui rendent l’anglais des chercheurs espagnols clair et correct sont celles que ces outils ont été entraînés à signaler. Nous détaillons l’ensemble du mécanisme dans notre guide : pourquoi les détecteurs d’IA signalent les auteurs non natifs.
Les schémas propres à la langue espagnole à l’origine de faux signalements
L’espagnol est une langue romane, et ses schémas se répercutent en anglais de manière parfaitement correcte, mais avec une régularité très marquée. C’est cette régularité qui piège. Voici ceux que nous observons le plus souvent dans les manuscrits d’auteurs espagnols.
Faux amis. « Actual » et « actually » sont utilisés à la place de « current » et « currently » (en espagnol, « actual » signifie « courant »), « realize » remplace « carry out » (realizar), « assist » remplace « attend » (asistir) et « sensible » remplace « sensitive ». Chaque substitution est standard et facile à apprendre, ce qui explique précisément pourquoi la lecture peut paraître prévisible.
Surutilisation des articles avec des noms abstraits. L’espagnol place des articles définis devant des noms génériques ; ainsi, « the research shows », « the science » et « the society » apparaissent là où l’anglais supprime l’article. Il s’agit d’un schéma régulier, guidé par des règles, et c’est cette cohérence qui abaisse la perplexité.
Phrases longues, avec beaucoup de propositions subordonnées. Le style académique roman privilégie de longues phrases périodiques, avec des propositions relatives empilées. Elles sont grammaticalement correctes, mais leur cadence régulière, clause après clause, semble « lisse » à un détecteur.
Transfert de prépositions. « Depend of » (depender de), « consist on » (consistir en), « different to » et « in relation with » proviennent directement du gouvernement des prépositions en espagnol. C’est précis, systématique, et donc facile pour un modèle à prédire.
Forte nominalisation et ordre des mots. Des constructions comme « the realization of the analysis of » empilent des noms abstraits dans une forme fixe. En ajoutant une surutilisation des relatives « which » et en ouvrant beaucoup de phrases par un « On the other hand » calqué, le texte devient remarquablement régulier.
Aucune de ces caractéristiques n’est une erreur de pensée. Ce sont des constructions correctes, soignées et standard, et c’est précisément cette standardisation que le détecteur interprète comme une faible perplexité ; or une faible perplexité est ce qu’il associe au texte « machine ».
Contexte : détection d’IA et Turnitin en Espagne
L’avancement de carrière des universitaires espagnols dépend des sexenios de investigación : une évaluation de la recherche sur six ans menée via l’ANECA et la CNEAI. Elle récompense les articles publiés dans des revues listées dans le Journal Citation Reports (Web of Science) et Scopus. Ce système crée une pression constante pour que les chercheurs espagnols publient dans des revues anglophones à fort impact, où des détecteurs les attendent désormais.
En Espagne, les thèses sont déposées dans des dépôts institutionnels tels que TDX et dans le registre national TESEO, et un contrôle de similarité avec Turnitin ou iThenticate est routine avant ce stade. De plus en plus, les mêmes plateformes affichent un indicateur d’IA en parallèle du score de similarité.
Il est important de maintenir cet indicateur en proportion. En 2023, Vanderbilt a désactivé le détecteur d’IA de Turnitin, en invoquant des faux positifs et un biais contre les auteurs non natifs, comme l’ont fait Michigan State, UT Austin, Northwestern, Pittsburgh, SMU et Waterloo. Turnitin supprime les scores dans la plage 1 à 19% et met en garde contre le fait de se fier uniquement au score pour des décisions liées à l’intégrité. Un signalement par un détecteur constitue une affirmation à contester, pas un verdict. De plus en plus, financeurs et revues demandent une déclaration claire et factuelle de la manière dont l’IA a été utilisée, plutôt qu’un pourcentage supposé.
Protégez votre anglais soigneux contre un faux signalement d’IA
Humanisez votre brouillon assisté par IA, en gardant chaque citation et terme technique à sa place, puis divulguez votre utilisation de l’IA comme votre revue vous le demande.
Essayez gratuitement le HumanizerGrandes universités espagnoles et où apparaissent les vérifications d’IA
La recherche espagnole est répartie entre un solide système d’universités publiques, et ces institutions analysent thèses et manuscrits pour la similarité, souvent avec Turnitin, et accordent désormais aussi un poids accru aux indicateurs d’IA :
- Universitat de Barcelona (UB), Barcelone
- Universidad Autónoma de Madrid (UAM), Madrid
- Universidad Complutense de Madrid (UCM), Madrid
- Universitat Autònoma de Barcelona (UAB), Barcelone
- Universitat de València (UV), Valence
- Universidad de Granada (UGR), Grenade
- Universidad Politécnica de Madrid (UPM), Madrid
- Universitat Politècnica de València (UPV), Valence
- Universidad de Sevilla (US), Séville
- Universidad del País Vasco / Euskal Herriko Unibertsitatea (UPV/EHU), Bilbao
- Universidad de Salamanca (USAL), Salamanque
- Universitat Pompeu Fabra (UPF), Barcelone
- Universidad de Navarra (UNAV), Pampelune
- Universidad de Zaragoza (UNIZAR), Saragosse
Que votre thèse soit examinée à l’UB, à l’UAM ou à l’UNIZAR, l’étape de filtrage est largement la même, tout comme le risque que l’anglais soigné de langue seconde soit mal interprété.
Comment fonctionne l’humaniseur d’IA pour les chercheurs espagnols
Le processus est simple : il vous fait rester dans les règles. Rédigez votre article de la manière qui vous permet de penser au mieux, souvent en espagnol d’abord, puis traduisez. Corrigez la grammaire pour que le sens soit exact ; si vous souhaitez une seconde passe sur l’anglais lui-même, notre guide sur la relecture assistée par l’IA pour les chercheurs espagnols détaille cette étape. Ce n’est qu’ensuite que vous humanisez votre propre prose assistée par IA, afin que l’écriture soignée et à faible perplexité ait moins de chances d’être mal lue.
C’est cette dernière étape que notre AI humanizer réalise. Il préserve votre sens, votre terminologie technique et vos citations, et fait varier le rythme ainsi que le choix des mots que le détecteur interprète comme une cadence « machine ». Il prend en charge plus de 60 langues : il achemine les textes non anglophones vers un modèle tenant compte de la langue, tout en conservant intacte la structure des phrases et le sens.
Nous sommes attentifs à ce que nous affirmons. L’humaniseur réécrit le texte produit par IA sous une forme plus naturelle et humaine : cela réduit le signal d’IA et améliore vos chances face à des détecteurs exigeants, testés contre les principaux détecteurs. Il atteint aussi plus de 96% sur la grammaire des textes académiques. Il s’agit de résultats issus de tests, pas de garanties. Les détecteurs sont réentraînés tous les quelques mois ; nous ne promettons donc jamais un chiffre ni une méthode pour « contourner » quoi que ce soit.
Ensuite, vous déclarez. Ajoutez une déclaration d’usage de l’IA au format exigé par votre institution et votre revue cible : ainsi, l’outil protège votre écriture soignée sans dissimuler la façon dont elle a été produite. Ce module s’insère dans notre plateforme centrale d’humaniseurs d’IA multilingues et s’associe à notre plateforme d’édition académique globale si vous souhaitez une couche d’édition humaine en complément.
Organismes locaux de financement, revues et attentes en matière de déclaration d’IA
Les financements concurrentiels en Espagne transitent par l’Agencia Estatal de Investigación (AEI) et le Ministerio de Ciencia, Innovación y Universidades, tandis que le Consejo Superior de Investigaciones Científicas (CSIC) est la plus grande organisation publique de recherche du pays. Les postes universitaires sont accrédités par l’ANECA, et la FECYT attribue un label de qualité aux revues scientifiques espagnoles : l’indexation et la qualité linguistique pèsent donc réellement dans une trajectoire académique en Espagne.
Du côté de la publication, les chercheurs espagnols visent des revues indexées dans Web of Science (JCR) et Scopus, avec, selon certains domaines, l’importance d’indices nationaux et disciplinaires. Les thèses atteignent TDX et le registre TESEO. Au fil de ces instances, la déclaration d’un usage de l’IA passe d’optionnel à attendue. La posture prudente est la même partout : utilisez les outils sur votre propre travail, conservez vos citations exactement, et indiquez clairement comment l’IA a aidé. Passez cette dernière étape dans l’humaniseur et vous protégez l’écriture sans la dénaturer.
Foire aux questions
Q : L’utilisation d’un humaniseur d’IA pour les chercheurs espagnols est-elle considérée comme de la triche ?
Non, à condition de l’utiliser sur votre propre brouillon assisté par IA puis de le déclarer. L’outil reformule le rythme de l’écriture que vous avez déjà produite, en conservant votre sens et vos citations : ainsi, un anglais soigné de langue seconde n’est pas mal interprété comme un texte « machine ». Déclarer votre usage de l’IA dans le format exigé par votre revue ou votre université, c’est ce qui maintient l’ensemble du processus dans les règles d’intégrité.
Q : Un humanizador de texto de IA modifiera-t-il mes citations ou mes termes techniques ?
Non. L’humaniseur est conçu pour préserver la terminologie technique, les références et la structure de votre argument, tout en faisant varier le choix des mots et la cadence. Vos clés de citation, vos figures et votre vocabulaire spécialisé restent exactement à l’endroit où vous les avez placés : les modifier ferait échouer l’objectif.
Q : Pourquoi mon anglais correct est-il signalé comme IA dès le départ ?
Parce que de nombreux détecteurs calculent la perplexité, c’est-à-dire le degré de prédictibilité de vos choix de mots. Les auteurs espagnols attentifs utilisent des mots courants et des formulations standard, ce qui produit une faible perplexité, interprétée comme un texte « machine ». Dans l’étude de Stanford, environ 61% des essais non natifs rédigés par des humains ont été signalés, contre environ 5% pour les auteurs natifs : un signalement sur votre travail est donc fréquent et contestable.
Q : Quels taux de réussite l’humaniseur a-t-il réellement atteints ?
Testé avec les principaux détecteurs, il réécrit un texte issu de l’IA sous une forme plus naturelle et humaine : cela réduit le signal d’IA et améliore ses chances contre les détecteurs difficiles, tout en conservant une forte exactitude grammaticale sur les textes académiques. Ce sont des résultats de test, pas des garanties. Les détecteurs se réentraînent souvent ; nous décrivons donc ce que nous avons mesuré plutôt que de promettre un résultat fixe.
Q : Ma thèse sera soumise à Turnitin à l’université. Que dois-je faire ?
Considérez l’indicateur d’IA comme un seul signal, pas comme un verdict. Rédigez dans la langue qui vous permet de penser au mieux, vérifiez la précision, humanisez votre propre brouillon pour réduire la probabilité d’un faux signalement, puis joignez une déclaration claire d’usage de l’IA. Si un signalement apparaît malgré tout, vous disposez des éléments montrant votre processus de rédaction pour le contester.
Un humaniseur sensible à la langue, qui préserve votre sens, votre terminologie et vos citations tout en réduisant les faux signaux IA qui touchent les auteurs espagnols attentifs.

Moe est un ingénieur NLP avec un PhD en traitement du langage naturel. Ses recherches portent sur la linguistique informatique, l'analyse de texte et l'apprentissage automatique, et elles ont directement alimenté les modèles d'édition et d'humanisation derrière ProofreaderPro. Il écrit sur la partie du processus que la plupart des gens ne voient jamais : comment un modèle de langage lit une phrase, la note et décide quoi changer.


