
Humaniseur IA pour des chercheurs kazakhophones rédigeant en anglais
Humaniseur IA pour chercheurs kazakhophones. Réduisez les faux signalements liés à la détection d’IA sur un anglais influencé par le kazakh et le russe, tout en conservant le sens et les citations, et en divulguant honnêtement.

Le Kazakhstan produit environ 7 600 articles indexés dans Scopus chaque année et se classe autour de la 64e place mondiale pour la production de recherche, un chiffre qui progresse rapidement, car aujourd’hui les carrières en dépendent. Un doctorant ne peut pas défendre une thèse sans au moins une publication Scopus assortie d’un facteur d’impact positif. Un maître de conférences (dotsent) en exige deux, et un professeur titulaire trois. Presque tous ces articles doivent être rédigés en anglais. Un humaniseur IA pour chercheurs kazakhophones existe pour une raison étroite et bien réelle : un anglais soigné, écrit par un locuteur kazakh ou russe, est de plus en plus souvent interprété par des détecteurs automatisés comme du texte produit par une machine, et cette mauvaise lecture peut vous coûter une soumission.
Le Kazakhstan obtient 427 au EF English Proficiency Index, ce qui le place au 103e rang dans la catégorie « Very Low Proficiency ». La plupart des chercheurs ont été formés principalement en kazakh ou en russe, puis ont appris l’anglais plus tard, souvent en autodidacte. Comprendre des articles en anglais est une compétence. Produire un manuscrit prêt à être publié, conforme aux attentes de relecteurs internationaux, en est une autre, bien plus exigeante, et le soutien à la recherche du pays n’a pas encore rattrapé le mandat « publiez ou périssez ».
Voici le piège. Lorsqu’un scientifique kazakh écrit un anglais propre, standard et corrigé comme dans les manuels, c’est précisément la prévisibilité de cette prose que le détecteur interprète comme « générée ». Les habitudes qui rendent l’écriture d’une langue seconde claire sont exactement celles que les détecteurs ont été entraînés à signaler. Ce n’est pas un problème propre au Kazakhstan, mais ici la réalité trilingue le rend plus net.
Қазақстандық зерттеушілерге арналған AI мәтінін адамдандыру
ProofreaderPro.ai vous aide : notre humaniseur permet aux chercheurs kazakhophones de publier un anglais soigné et naturel dans des revues internationales sans être signalés à tort comme du contenu généré par une IA. Il fonctionne sur votre brouillon assisté par IA, conserve le sens et les citations tels quels, et se lit naturellement pour un relecteur humain.
La recherche au Kazakhstan s’appuie sur deux langues scientifiques, pas une seule. Le kazakh (Қазақ тілі) est la langue d’État, tandis que le russe (русский язык) reste une langue de travail de la science dans la plupart des laboratoires et des facultés plus anciennes. Bon nombre de chercheurs formulent leur raisonnement en russe ou en kazakh, traduisent ensuite, puis polissent en anglais. Notre humaniseur intervient à la fin de cette chaîne, une fois le sens stabilisé, pour protéger un travail légitime contre un faux positif.
Rédiger en kazakh ou en russe ? L’humaniseur détecte chacun des deux
Les chercheurs kazakhophones travaillent souvent en kazakh ou en russe avant de rédiger en anglais, et l’humaniseur prend en charge les deux directement. Collez un texte en kazakh et ProofreaderPro reconnaît automatiquement l’écriture cyrillique, puis l’achemine vers un modèle sensible à la langue qui conserve votre terminologie et vos citations exactement telles qu’elles sont écrites. Grâce à AI мәтінін адамдандыру, votre brouillon kazakh est humanisé aussi facilement que votre anglais, sans traduction préalable. Et comme la détection couvre plus de soixante langues, un brouillon en russe est reconnu et humanisé avec la même facilité.
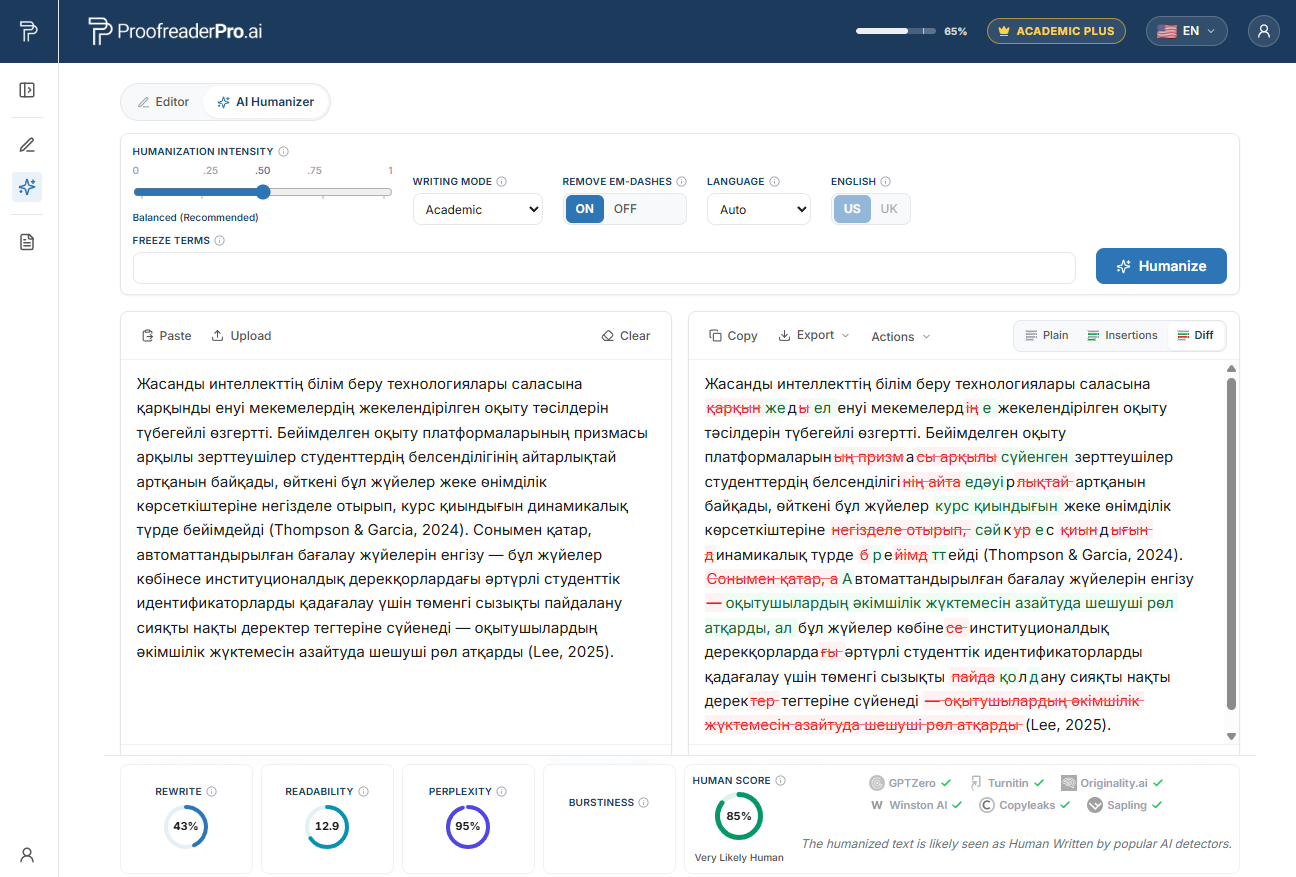
Le ProofreaderPro AI Humanizer réécrivant un texte académique kazakh. Le diff avant/après préserve le sens et les citations, et les vérifications de détecteur confirment une lecture naturelle et humaine.
Pourquoi les chercheurs kazakhophones sont-ils plus souvent signalés par les détecteurs d’IA ?
En 2023, une équipe de Stanford dirigée par Weixin Liang a publié une étude dans la revue Cell Press Patterns intitulée « GPT detectors are biased against non-native English writers ». Ils ont fait passer des essais rédigés par des humains (TOEFL) à sept détecteurs largement utilisés. En moyenne, environ 61 % des essais d’apprenants non natifs étaient signalés comme IA, contre environ 5 % pour les rédacteurs anglophones natifs. Près d’un essai sur cinq parmi les non natifs (environ 19,8 %) a été signalé sans ambiguïté par chaque détecteur. Tous les essais étaient rédigés par des humains.
Le mécanisme tient à la perplexité. Beaucoup de détecteurs évaluent à quel point chaque prochain mot est « surprenant » pour un modèle de langage. Un rédacteur soigneux en langue seconde choisit des mots courants et des formulations standard, prévisibles, ce qui produit une faible perplexité ; l’ensemble est alors lu comme du texte de machine. Un chercheur kazakh qui a entraîné un anglais formel pour éviter les erreurs finit par produire exactement la prose fluide et peu variable que le détecteur traite comme un signal d’alarme. Nous expliquons le mécanisme complet dans pourquoi les détecteurs d’IA signalent les rédacteurs non natifs.
Les schémas du kazakh et du russe en langue maternelle à l’origine des faux signaux
La situation linguistique est ici particulière : la plupart des chercheurs subissent à la fois l’interférence de deux langues typologiquement distinctes. Le kazakh est une langue turcique, agglutinante, et avec l’ordre Sujet-Objet-Verbe. Le russe est une langue slave dotée d’un système de cas riche. Aucune des deux ne comporte d’articles. L’enjeu ci-dessous n’est pas de dire que ces schémas sont des erreurs dont il faudrait avoir honte. C’est que les versions corrigées et soigneuses de ces structures sont un anglais standard, à faible perplexité, que le détecteur lit précisément comme du contenu « généré ».
Discipline de l’article. Ni le kazakh ni le russe n’ont de « a », « an » ou « the », de sorte que les auteurs kazakhophones apprennent le système des articles comme une règle abstraite, puis l’appliquent de manière très constante. « We conducted an experiment to measure the temperature of the solution » est correct comme dans un manuel, et cette régularité typographique du manuel est exactement ce qui obtient une faible perplexité.
Ordre SOV, puis sur-correction. Le kazakh place le verbe en dernier (« Men kitapty oqydym », littéralement « I book-the read »). Les auteurs qui savent que l’anglais suit un ordre SVO ont tendance à reconstruire les phrases dans un ordre propre et canonique pour se mettre à l’abri. Une architecture uniforme et bien formée des phrases apparaît comme prévisible pour un détecteur.
Restauration du copule depuis le russe. En russe, l’expression « to be » disparaît au présent (« Eta metod effektiven », « this method [is] effective »). Les auteurs kazakhophones apprennent à insérer la copule partout : « This method is effective for detecting outliers ». C’est correct, et uniformément rythmé.
Prépositions apprises comme paires fixes. Le russe utilise des cas là où l’anglais emploie des prépositions ; les auteurs mémorisent donc « depends on », « consists of », « results in » et « participates in » comme des expressions figées, puis les déploient de manière uniforme. Les combinaisons collocationnelles constantes sont encore une fois un texte à faible variation.
Groupes nominaux non « empilés ». Le kazakh empile le sens par le biais de suffixes. Les auteurs attentifs le démêlent en anglais mesuré (« an analysis of the efficiency of the temperature control system »). Le résultat est grammatical, formel et fluide.
Régularité des temps. Comme aucune des deux langues ne correspond proprement aux temps et à l’aspect en anglais, les auteurs standardisent : passé simple pour les méthodes, present perfect pour la pertinence continue. La standardisation réduit la surprise, et une surprise réduite est exactement ce que le détecteur sanctionne.
Aucune de ces constructions n’est incorrecte. Ce sont les marques d’un rédacteur discipliné en langue seconde, et un processus d’évaluation équitable ne devrait jamais traiter cette discipline comme une preuve de triche.
Contexte IA de détection et Turnitin au Kazakhstan
Les thèses et soumissions en revue provenant du Kazakhstan sont généralement contrôlées avec Turnitin ou iThenticate pour la similarité, et les indicateurs d’IA circulent désormais avec ces scores de similarité. Les universités kazakhophones se sont fortement appuyées sur la publication internationale, de sorte que les outils de filtrage importés avec cette dynamique font de plus en plus partie du flux de travail lors de la soutenance et au moment de la soumission.
Il est utile d’être clair sur ce que mesurent ces scores. Turnitin lui-même supprime les scores d’IA dans la plage 1 à 19 % (en affichant un astérisque plutôt qu’un nombre) et avertit que le score ne doit pas être utilisé à lui seul pour une décision relative à l’intégrité. Vanderbilt a désactivé le détecteur d’IA de Turnitin en 2023, invoquant des faux positifs et un biais contre les auteurs non natifs, et Michigan State, UT Austin, Northwestern, Pittsburgh, SMU et Waterloo ont pris des mesures similaires. Un signalement de détecteur est une allégation à contester, pas un verdict.
Parallèlelement, financeurs et revues demandent de plus en plus aux auteurs de divulguer la manière dont ils ont utilisé des outils d’IA. Ces deux faits ne sont pas en contradiction. La voie la plus simple consiste à écrire un travail réel, à le protéger contre les faux signaux, puis à divulguer votre usage d’outil de manière transparente.
Protégez un anglais soigné contre un faux signalement d’IA
Humanisez votre propre brouillon assisté par IA, conservez votre sens, vos citations et vos termes techniques, puis divulguez l’utilisation de votre outil comme l’exige votre revue. Conçu pour les locuteurs du kazakh et du russe qui publient pour Scopus.
Essayez gratuitement le HumanizerGrandes universités kazakhophones et où apparaissent les contrôles IA
La production scientifique est concentrée dans un petit nombre d’établissements phares, dont la majorité se trouve à Astana, Almaty, ainsi que dans quelques centres régionaux. Chacun de ces écrans contrôle les thèses et les manuscrits pour la similarité et les indicateurs d’IA dans le cadre de la soutenance et de la soumission.
- Nazarbayev University (NU), Astana, l’université phare en enseignement en anglais, dotée de partenariats internationaux
- Al-Farabi Kazakh National University (KazNU), Almaty, la plus ancienne et la plus grande université nationale, et l’un des principaux producteurs Scopus
- Satbayev University (Kazakh National Research and Technical University), Almaty, la principale université technique
- L.N. Gumilyov Eurasian National University (ENU), Astana, forte en sciences naturelles et en ingénierie
- Kazakh-British Technical University (KBTU), Almaty, partiellement en enseignement en anglais, pétrole et TI
- KIMEP University, Almaty, enseignement en anglais en entreprise, économie et droit
- Karaganda University (Ye.A. Buketov Karaganda University), Karaganda, chimie, physique et éducation
- South Kazakhstan University (M. Auezov South Kazakhstan University), Shymkent, génie chimique et sciences agricoles
- Turan University, Almaty, université privée dont la production de recherche progresse
- International Information Technology University (IITU), Almaty, informatique et technologies numériques
Les chercheurs de Nazarbayev University ont généralement l’anglais le plus solide ; toutefois, même là, un manuscrit soigné peut déclencher un signal IA. Dans les établissements à dominante kazakhienne et à dominante russe, où l’anglais est une langue acquise plus tard, le risque de faux positif est plus élevé précisément parce que l’écriture est aussi systématiquement correcte.
Comment fonctionne l’humaniseur IA pour chercheurs kazakhophones
Le flux de travail est clair et simple. Rédigez votre article, d’abord en russe ou en kazakh si c’est là que se développe votre raisonnement, puis traduisez-le en anglais. Corrigez la grammaire afin que le sens corresponde exactement à ce que vous souhaitez. Exécutez ensuite votre propre anglais assisté par IA dans l’humaniseur pour que la prose soignée, peu variable, ait moins de chances d’être mal interprétée par un détecteur. Vos citations (APA, MLA, Chicago, IEEE, Vancouver), vos nombres et votre terminologie technique sont préservés. Ce qui change, ce sont le rythme et le choix des mots : l’humaniseur fait varier la cadence, rompt les schémas répétitifs et supprime les signes du type tirets cadratin isolés.
Testé contre les principaux détecteurs, notre humaniseur de texte réécrit le texte d’IA sous une forme plus naturellement humaine, ce qui diminue le signal d’IA et améliore ses chances face à des détecteurs exigeants, tout en maintenant une grande exactitude grammaticale sur les textes académiques. Ce sont des résultats issus de tests, pas des garanties. Les détecteurs se réentraînent tous les quelques mois ; nous ne promettons donc jamais un chiffre et nous ne prétendons jamais que votre texte sera « 100 % indétectable ». L’objectif est l’équité pour un travail réel, pas un tour.
Ensuite, divulguez. Ajoutez une déclaration d’usage d’IA dans le format exigé par votre institution et la revue cible. Humaniser votre propre brouillon et divulguer l’usage de votre outil ne sont pas des oppositions : ensemble, ils vous maintiennent dans les règles d’intégrité tout en protégeant une rédaction authentiquement en langue seconde contre un faux signal. Si vous cherchez les mécanismes généraux à travers les langues, consultez le centre hub d’humaniseur IA multilingue. Si votre manuscrit a besoin d’être corrigé sur la grammaire et la structure avant d’être humanisé, cela relève de l’édition académique pour chercheurs kazakhophones.
Organismes locaux de financement, revues et attentes en matière de divulgation d’IA
Le Ministère de la Science et de l’Enseignement supérieur fixe et resserre périodiquement les exigences de publication Scopus qui conditionnent chaque échelon de la progression académique, et la National Academy of Sciences of the Republic of Kazakhstan ancre une grande partie de la production multidisciplinaire du pays. De nombreuses universités proposent des primes financières pour les articles Scopus, ce qui augmente l’enjeu de chaque soumission et rend un rejet de bureau motivé par la langue particulièrement coûteux.
Les revues nationales se tournent vers l’anglais et vers une indexation internationale. Parmi les titres notables figurent la Eurasian Journal of Mathematical and Computer Applications, la Central Asian Journal of Medical Hypotheses and Ethics, la Chemical Bulletin of Kazakh National University (Al-Farabi KazNU), la Eurasian Physical Technical Journal, la International Journal of Biology and Chemistry (Al-Farabi KazNU) et les Reports of the National Academy of Sciences of the Republic of Kazakhstan. Que vous visiez ces revues ou une revue internationale Q1, la qualité de l’anglais constitue la porte commune, et davantage d’entre elles exigent désormais une note explicite sur toute assistance par IA.
Notre recommandation reste la même : humanisez votre propre brouillon avec le humaniseur de texte, conservez vos citations exactement, et rédigez une déclaration de divulgation claire. C’est la version de ce flux de travail qui résiste à un relecteur, à un superviseur et à votre propre conscience.
Questions fréquentes
Q : L’usage d’un humaniseur IA pour chercheurs kazakhophones est-il considéré comme de la triche ?
Non, pas si vous l’utilisez de manière responsable. Vous humanisez votre propre brouillon assisté par IA, vous conservez le sens et les citations, et vous divulguez votre usage d’IA dans le format exigé par votre institution et votre revue. Il s’agit d’un support linguistique qui protège un travail réel, et non d’une manière de dissimuler un contenu fabriqué ou de faire passer pour le vôtre l’écriture de quelqu’un d’autre.
Q : L’humaniseur garantit-il que mon article passe Turnitin ou GPTZero ?
Non. Testé contre les principaux détecteurs, il réécrit le texte d’IA sous une forme plus naturellement humaine, ce qui diminue le signal d’IA et améliore ses chances face à des détecteurs exigeants, tout en conservant une forte exactitude grammaticale sur les textes académiques. Ce sont des résultats de tests, pas des promesses. Les détecteurs se réentraînent souvent, de sorte qu’aucun outil crédible ne peut garantir un score ni affirmer que votre texte sera 100 % indétectable.
Q : Fonctionne-t-il sur un anglais influencé par le kazakh et le russe ?
Oui. L’humaniseur prend en charge plus de 60 langues et fait passer une prose influencée par une langue non anglaise dans un modèle sensible à la langue qui préserve la structure des phrases et le sens. Pour les locuteurs kazakh et russophones bilingues, il fait varier le rythme fluide et peu « surprenant » que les détecteurs interprètent à tort, tout en conservant votre ton académique et vos termes techniques.
Q : Pourquoi les auteurs kazakhophones attentifs sont-ils plus souvent signalés que les auteurs négligents ?
Parce que les détecteurs évaluent la prévisibilité, pas la qualité. Une étude de Stanford a révélé qu’environ 61 % des essais non natifs rédigés par des humains étaient signalés comme IA, contre environ 5 % pour les auteurs natifs. L’anglais discipliné, standard et corrigé des articles qu’un bon chercheur kazakh produit est exactement le texte à faible perplexité que le détecteur traite comme généré par une machine.
Q : Que dois-je faire si mon manuscrit est signalé après que je l’ai humanisé et divulgué ?
Traitez le signalement comme une allégation à contester, pas comme un verdict. Turnitin lui-même indique que son score ne doit pas être utilisé seul pour des décisions relatives à l’intégrité, et plusieurs universités ont désactivé la détection d’IA en raison de faux positifs. Conservez vos brouillons et vos notes, partagez votre déclaration de divulgation, et expliquez votre flux de travail au relecteur ou à la commission.
Un humanizer tenant compte de la langue pour les locuteurs du kazakh et du russe, pour varier le rythme que les détecteurs interprètent mal, préserver le sens et les références, puis divulguer votre utilisation de l’IA avec confiance.

Moe est un ingénieur NLP avec un PhD en traitement du langage naturel. Ses recherches portent sur la linguistique informatique, l'analyse de texte et l'apprentissage automatique, et elles ont directement alimenté les modèles d'édition et d'humanisation derrière ProofreaderPro. Il écrit sur la partie du processus que la plupart des gens ne voient jamais : comment un modèle de langage lit une phrase, la note et décide quoi changer.


