
Humanizer d’IA pour les chercheurs tchèques qui rédigent en anglais
Humanizer d’IA pour les chercheurs tchèques. Réduisez les signalements erronés de détection d’IA sur un anglais influencé par le tchèque, tout en conservant le sens et les citations, et en déclarant votre démarche de manière honnête.

La Tchéquie pèse plus lourd que ce que sa taille pourrait laisser croire. Petit pays, vaste base de recherche : elle occupe une véritable stature internationale en physique, chimie, sciences des matériaux et sciences de la vie, une large part de ce travail étant ancrée dans l’Académie des sciences de la République tchèque. Presque tout ce travail parvient au monde en anglais, bien que la réflexion et les premières versions soient, pour la plupart, menées et rédigées d’abord en tchèque.
C’est précisément dans cet écart entre la langue dans laquelle vous raisonnez et la langue dans laquelle vous publiez que les ennuis commencent. Un humanizer d’IA pour les chercheurs tchèques existe pour une raison très concrète : un anglais soigné et correct rédigé par un scientifique tchèque est aujourd’hui lu à tort comme un texte produit par une machine par des détecteurs automatisés. Et un seul signalement erroné sur un article irréprochable peut vous coûter une soumission, une note, ou la réputation que vous avez mis des années à construire.
La partie inconfortable, c’est que les habitudes qui rendent l’anglais tchèque suffisamment clair pour être publié, formulations standard, vocabulaire courant, structures de phrases prévisibles, sont précisément les habitudes que l’on a entraînées à interpréter comme suspectes dans un détecteur d’IA.
Humanizace AI textu pro české výzkumníky publikující v angličtině
Notre humanizace AI textu aide les chercheurs tchèques à publier en anglais sans que leur travail soigneusement rédigé soit injustement étiqueté par les détecteurs comme s’il avait été produit par une machine. L’objectif est de préserver le sens, la terminologie scientifique et les citations.
Dit simplement : notre outil agit sur l’anglais que vous avez déjà rédigé ou esquissé avec l’aide de l’IA, conserve votre argumentation et vos références intactes, et remodèle le rythme afin qu’un détecteur le juge moins souvent à tort. Il a été conçu pour de la recherche réelle, pas pour dissimuler un travail que vous n’avez pas fait. Vous pouvez l’essayer sur notre humanizer avec un paragraphe issu de votre propre recherche avant de lui confier l’ensemble d’un manuscrit.
Rédiger en tchèque ? Il est détecté automatiquement et humanisé directement
Les chercheurs tchèques rédigent souvent dans leur langue d’origine avant de passer à l’anglais, et l’humanizer a été construit pour cela. Collez un texte en tchèque : ProofreaderPro détecte la langue de lui-même, puis le fait passer par un modèle sensible au tchèque qui conserve exactement les háček et les autres diacritiques, votre terminologie et vos citations. Grâce à l’humanizace AI textu, votre brouillon tchèque est humanisé avec la même facilité que votre anglais, sans traduction préalable. La même détection couvre plus de soixante langues, chacune réécrite avec sa propre voix.
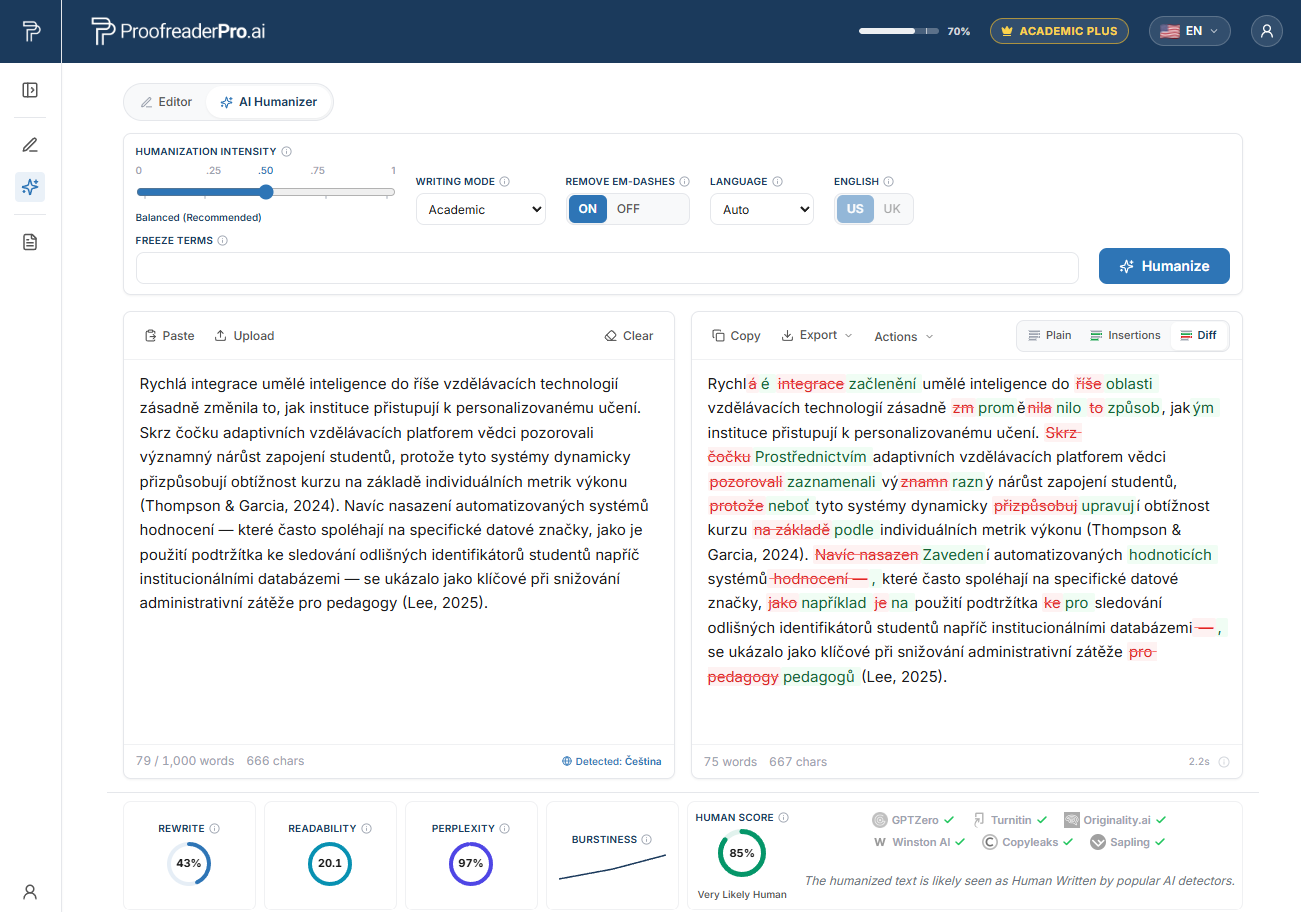
Le ProofreaderPro AI Humanizer réécrivant un texte académique en tchèque. La comparaison avant/après conserve votre sens et vos citations, et les vérifications du détecteur confirment une lecture naturelle et humaine.
Pourquoi les chercheurs tchèques se font-ils signaler par les détecteurs d’IA ?
En 2023, une équipe de Stanford menée par Weixin Liang a publié une étude dans la revue Cell Press Patterns, dont le titre dit tout : « GPT detectors are biased against non-native English writers ». Les chercheurs ont pris des essais TOEFL rédigés entièrement par des humains, puis les ont fait passer dans sept détecteurs d’IA largement utilisés.
Le résultat devrait inquiéter toute personne qui écrit l’anglais comme langue seconde. En moyenne, environ 61 % des essais non natifs ont été signalés comme produits par une IA, contre environ 5 % pour les essais d’auteurs natifs de l’anglais. Près d’un essai sur cinq non natifs, soit environ 19,8 %, a été signalé unanimement par chaque détecteur. Aucun de ces textes n’a été rédigé par une machine.
Le mécanisme s’appelle la perplexité. De nombreux détecteurs évaluent à quel point chaque choix de mot est « surprenant » pour un modèle de langue. Un auteur natif confiant prend des risques, utilise des expressions idiomatiques et varie la formulation dans des manières qu’un modèle juge imprévisibles, ce qui se lit comme du « humain ». Un chercheur tchèque attentif fait l’inverse : il choisit le mot sûr, la construction standard, la structure de phrase répétée dans chaque cours d’anglais. Cette prudence produit une faible perplexité. Or, une faible perplexité, c’est ce qu’un détecteur interprète comme un texte de machine. Nous expliquons le mécanisme complet dans pourquoi les détecteurs d’IA signalent les auteurs non natifs.
Les schémas de langue tchèque, en première langue, à l’origine des faux signalements
Le tchèque et l’anglais reposent sur des grammaires différentes, et les points de désaccord laissent des « traces » dans votre anglais. Il ne s’agit d’erreurs de réflexion : ce sont des traces standard et prévisibles d’un esprit tchéqu e écrivant un anglais soigné, et leur régularité même est ce que le détecteur perçoit comme une perplexité faible.
Des articles qui apparaissent puis disparaissent. Le tchèque ne possède pas de « the » ou de « a ». Les articles en anglais sont alors omis, ajoutés ou échangés : vous écrivez « result was significant » ou « we performed the analysis of the data ». Une fois qu’un éditeur harmonise ces éléments, les phrases environnantes deviennent souvent encore plus « standard de manuel », ce qui augmente le risque de signalement plutôt que de le réduire.
L’aspect qui se substitue au temps. La grammaire tchèque s’appuie sur l’opposition d’aspect perfectif/imperfectif plutôt que sur le système des temps de l’anglais. Le perfect versus simple past ressort de manière incohérente, et la version corrigée a tendance à se rapprocher du choix de temps le plus conventionnel que le modèle attend.
L’ordre des mots qui porte la mise en relief. Le tchèque s’appuie sur les terminaisons casuelles pour le sens, et sur l’ordre des mots pour l’accentuation : la structure informationnelle de l’anglais peut alors transférer de façon maladroite. Une fois l’ensemble « lissé » en un anglais standard sujet-verbe-objet, la phrase perd précisément l’imprévisibilité que le détecteur lit comme du texte humain.
Des noms comptables qui passent au pluriel. « Informations », « researches », « an advice », « evidences ». Cela fait sens en tchèque et se rencontre fréquemment dans des brouillons tchèque-anglais ; une fois la formulation fixée, elle atterrit dans le registre sur lequel les détecteurs ont été entraînés.
Les prépositions et l’absence d’auxiliaires. Les prépositions se transfèrent directement depuis le tchèque, et l’auxiliaire « do » ou « does » disparaît dans les questions et les négations. Corrigées, ces constructions deviennent propres et génériques, précisément le profil qui se lit comme une perplexité faible.
Le contexte de la détection d’IA et de Turnitin en Tchéquie
Les thèses et les soumissions aux revues en Tchéquie sont systématiquement contrôlées à la fois pour la similarité et pour la présence de texte produit par une IA. De nombreuses universités tchèques partagent une infrastructure nationale à cet effet : les systèmes Theses.cz et Odevzdej.cz, coordonnés par Masarykova univerzita, et Turnitin est largement utilisé en complément.
Les institutions tchèques ont également publié leurs propres recommandations sur l’IA générative, et la direction est claire : bailleurs de fonds et revues attendent de plus en plus que vous déclariez comment vous avez utilisé l’IA. Ce climat est raisonnable. Le problème n’est pas la déclaration, elle est facile et honnête. Le problème, c’est qu’un score de détecteur soit traité comme un verdict alors qu’en réalité il s’agit d’une estimation statistique qui se trompe le plus souvent, exactement, sur le texte non natif soigneusement rédigé que les chercheurs tchèques sont entraînés à produire.
Il est utile de se rappeler que même les éditeurs de détecteurs nuancent leurs affirmations. Turnitin réduit ses propres scores dans la plage basse et avertit qu’un nombre ne doit jamais être utilisé seul pour une décision d’intégrité. Plusieurs universités, dont Vanderbilt, sont allées plus loin et ont carrément désactivé leur détecteur d’IA, en invoquant des faux positifs et un biais contre les auteurs non natifs. Un signalement est une allégation à contester, pas une confession.
Protégez votre rédaction en anglais tchèque contre les signalements erronés liés à l’IA
Collez un paragraphe de votre prose universitaire, puis vérifiez comment le humanizer préserve votre sens et vos citations tout en réduisant le risque qu’un détecteur interprète mal un anglais soigné non natif.
Essayez gratuitement le HumanizerLes principales universités tchèques et l’endroit où apparaissent les contrôles d’IA
Si vous étudiez, enseignez ou soumettez en Tchéquie, votre travail passera par l’une de ces institutions, et toutes évaluent à la fois les thèses et les manuscrits pour la similarité, tout en accordant de plus en plus de poids aux indicateurs d’IA.
- Univerzita Karlova (Charles University), Prague
- České vysoké učení technické v Praze (ČVUT, Czech Technical University), Prague
- Masarykova univerzita (Masaryk University), Brno
- Univerzita Palackého v Olomouci (Palacký University), Olomouc
- Vysoké učení technické v Brně (VUT, Brno University of Technology), Brno
- Vysoká škola chemicko-technologická v Praze (VŠCHT, University of Chemistry and Technology), Prague
- Vysoká škola báňská, Technická univerzita Ostrava (VŠB-TUO), Ostrava
- Mendelova univerzita v Brně (Mendel University), Brno
- Jihočeská univerzita v Českých Budějovicích (University of South Bohemia), České Budějovice
- Univerzita Pardubice, Pardubice
Les enjeux diffèrent selon le document. Un manuscrit de revue refusé vous coûte des mois. Une thèse signalée à Univerzita Karlova ou Masarykova univerzita peut déclencher une audience où votre intégrité, plutôt que votre grammaire, est mise en cause. C’est le mauvais débat à avoir en cas de faux positif.
Comment l’humanizer d’IA pour les chercheurs tchèques fonctionne
Un processus honnête est simple, et la déclaration en constitue le cœur, plutôt qu’un élément périphérique.
Commencez par ce que vous maîtrisez le mieux. Rédigez en tchèque si c’est ainsi que vous pensez le plus efficacement, puis traduisez, ou rédigez directement en anglais avec une assistance de l’IA. D’abord, assurez la justesse de la science. Ensuite, corrigez la grammaire pour que le sens soit précis. Ce n’est qu’après cela que vous faites passer le texte dans l’humanizer d’IA pour les chercheurs tchèques : il remodèle le rythme et le choix des mots pour que votre anglais soigné et standard soit moins susceptible d’être mal interprété par un détecteur, tout en conservant exactement votre sens, votre terminologie et vos citations telles que vous les avez rédigés.
À quoi pouvez-vous vous attendre ? Lors de nos propres tests, l’humanizer réduit de manière substantielle la fréquence à laquelle un anglais non natif soigneusement rédigé est mal lu par les principaux détecteurs, dont Turnitin, Originality.ai et GPTZero, sans toucher à votre argumentation. Nous présentons cela comme ce que nous avons observé en test, et non comme une promesse. Les détecteurs se réentraînent tous les quelques mois, et aucun outil honnête ne peut promettre un caractère 100 % indétectable. Quiconque garantit le contraire vous vend quelque chose.
Le texte non anglais compte aussi. Comme l’humanizer prend en charge plus de 60 langues et fait passer les éléments non anglais par un modèle sensible à la langue, vous pouvez travailler sur des brouillons tchèques ou des notes multilingues sans que l’outil aplanisse la structure de vos phrases. Cette section « Humanizer » s’insère dans notre hub d’humanizer d’IA multilingue, et elle s’associe naturellement à une édition pratique issue de notre hub d’édition académique globale lorsque le manuscrit nécessite aussi un regard humain.
Vient ensuite l’étape qui maintient l’ensemble dans l’honnêteté : déclarez votre usage de l’IA dans le format exigé par votre institution et par la revue cible. Humaniser votre propre brouillon protège une rédaction claire contre un signalement injuste. Déclarer votre méthode vous maintient dans les règles. Vous faites les deux, et vous n’avez rien à cacher.
Organismes locaux de financement, revues et attentes en matière de déclaration de l’IA
Le financement de la recherche tchèque passe principalement par trois organismes, et chacun attend de plus en plus de transparence quant à l’usage de l’IA. GAČR (Grantová agentura České republiky, la Fondation des sciences tchèques) finance la recherche fondamentale. TAČR (Technologická agentura České republiky, l’Agence technologique) finance la recherche appliquée. AV ČR (Akademie věd České republiky, l’Académie des sciences de la République tchèque) gère les instituts nationaux d’où provient une large part de la production du pays.
Côté publication, la pression va dans une seule direction. L’évaluation nationale et les budgets institutionnels récompensent la publication dans des revues indexées par Web of Science et Scopus, et les résultats sont communiqués au registre national des informations R&D, RIV. Cela récompense la publication en anglais, ce qui vous renvoie directement au problème des faux signalements abordé par cet article.
Rappelons ce que les chiffres indiquent déjà sur cette barrière. Les locuteurs non natifs de l’anglais font face à des taux de refus environ 2,5 fois plus élevés que les locuteurs natifs, passent environ 51 % de temps en plus à rédiger leurs articles et quelque 91 % de temps en plus à les lire, et reçoivent environ 12,5 fois plus de demandes de révision liées à la qualité de la langue. Moins de 7 % des revues acceptent tout simplement des soumissions en langue non anglaise. Le système demande aux chercheurs tchèques de concourir en anglais, puis pénalise l’anglais soigné que cette concurrence produit. Humaniser votre propre brouillon, conserver vos citations et déclarer votre méthode est une réponse équitable à une configuration injuste, et non un moyen d’y échapper. Utilisez l’humanizer comme un outil au sein de ce processus honnête.
Questions fréquentes
Q : Utiliser un humanizer d’IA pour les chercheurs tchèques, est-ce considéré comme de la triche ?
Non, pas si vous l’utilisez honnêtement. Vous remodelez le rythme de votre propre brouillon assisté par l’IA, en conservant votre sens et vos citations, puis vous déclarez votre usage de l’IA de la manière exigée par votre institution et votre revue. Il s’agit d’une retouche linguistique plus de la transparence, pas d’une tromperie. Cela devient un problème seulement si vous tentez de faire passer pour votre travail un travail que vous n’avez pas fait, ou si vous dissimulez un usage que l’on vous a demandé de déclarer.
Q : L’humanizer va-t-il modifier mes termes techniques ou mes citations ?
Non. L’outil est conçu pour préserver le sens académique, la terminologie spécialisée et les marqueurs de références tout en faisant varier le rythme des phrases et le choix des mots. Votre chimie reste de la chimie, et vos citations restent en place. Vous devez tout de même relire la version finale, car vous demeurez l’auteur responsable de chaque mot.
Q : Pouvez-vous garantir que mon article passera Turnitin ou GPTZero ?
Non, et vous devriez vous méfier de toute personne qui prétend le faire. Les détecteurs se réentraînent en continu, de sorte qu’aucun outil honnête ne peut promettre d’être 100 % indétectable. Ce que nous pouvons dire, c’est qu’en test, l’humanisation d’un anglais non natif soigneusement rédigé réduit de manière substantielle la fréquence à laquelle les principaux détecteurs le lisent à tort, tout en conservant votre sens intact.
Q : Pourquoi mon anglais-tchèque correct est-il signalé en premier lieu ?
Parce que l’écriture soignée en langue seconde tend à être faible en perplexité. Vous choisissez des mots sûrs et des constructions standard, et les détecteurs interprètent cette prévisibilité comme du texte produit par une machine. L’étude de Stanford a montré que des essais rédigés par des non-natifs humains sont signalés comme IA bien plus souvent que ceux d’auteurs natifs : cela indique que le biais se situe dans le détecteur, pas dans votre écriture.
Q : Dois-je encore informer mon université ou ma revue que j’ai utilisé de l’IA ?
Oui, chaque fois qu’ils le demandent, et cela arrive de plus en plus souvent. Humaniser votre brouillon vise la justice, pas la dissimulation : la déclaration est le point clé, plutôt qu’une échappatoire. Indiquez clairement comment vous avez utilisé l’IA pour rédiger et éditer, et vous restez du bon côté à la fois des règles d’intégrité et de votre conscience.
Réduisez les signalements erronés liés à l’IA sur un anglais tchèque soigné, tout en conservant votre sens, votre terminologie et vos citations, puis divulguez votre utilisation de l’IA avec assurance.

Moe est un ingénieur NLP avec un PhD en traitement du langage naturel. Ses recherches portent sur la linguistique informatique, l'analyse de texte et l'apprentissage automatique, et elles ont directement alimenté les modèles d'édition et d'humanisation derrière ProofreaderPro. Il écrit sur la partie du processus que la plupart des gens ne voient jamais : comment un modèle de langage lit une phrase, la note et décide quoi changer.


