
英語で執筆するトルコ研究者のためのAI人間化(Humanizer)
トルコ研究者向けのAI人間化。トルコの影響を受けた英語における誤ったAI検出フラグを減らし、意味と引用を維持しつつ、正直に開示します。

トルコは毎年、Web of Scienceに収録される論文を約10万本生み出しており、その大半は208の大学に所属する約20万人の研究者(学術関係者)によって執筆されています。こうした成果のほとんどは英語で発表される必要があります。というのも、トルコの高等教育評議会であるYOK(Council of Higher Education)が、教員の昇進をScopusおよびWeb of Scienceへの掲載実績に直接結び付けているからです。トルコ研究者のためのAI人間化(humanizer)が存在する本当の理由は1つだけです。つまり、第二言語話者によって丁寧で正確に書かれた英語が、AI検出器によって機械文として誤読されることが増えており、その誤読が、実際に人間が書いた論文の進行を止めてしまうことがある、という点です。
プレッシャーは構造的です。助教授(docentlik)の試験では、SCI-indexed論文が1本あたり最大30点で採点され、英語圏の国際ジャーナルに掲載されない研究者は前進できません。そのため、トルコの研究者は常に英語で執筆しており、初稿を早めるためにChatGPTのようなツールの助けを借りることも少なくありません。
落とし穴はここにあります。明快で標準的な教科書調の英語で書く場合、またはAI支援の下書きを磨き上げた場合でも、検出器がその結果を機械生成としてフラグ付けすることがあります。そのフラグはしばしば誤りです。本ガイドでは、なぜこの問題がトルコの著者に特有の形で起きるのか、そして何かを隠すことなく自分の成果を守る方法を解説します。
Türk Araştırmacılar İçin Yapay Zeka İnsanlaştırıcı
このAI人間化(humanizer)は、トルコの研究者が英語で出版できるよう支援するために設計されています。しかし目的はコピペ(盗用)ではありません。自分の文章に自然なリズムを与え、そして不当なAIフラグから作品を守ることが目的です。
平たく言えば、この人間化ツールは、あなた自身のAI支援による文章を言い換えて、自然な変化をもった英語として読めるようにしながら、意味・用語・引用はあなたが置いた場所にそのまま保持することで、トルコ研究者の英語出版を助けます。これは捏造された文章を“隠す”ための手段ではなく、実在する作業のための公平性を担保するツールです。
トルコ語で下書きしますか? humanizerがそれを直接検出して書き換えます
英語に翻訳してからではなく、トルコ語の下書きを人間化できます。文章を貼り付ければ、ProofreaderProが言語を自動検出し、その後、あなたの文章にある点付き/点なしの文字、接尾辞、引用を尊重する「トルコ語対応のモデル」を介して処理します。yapay zeka insanlaştırıcıとして、このツールはトルコ語の文体のリズムを変化させつつ、すべての用語と参照をそのまま保ちます。自動検出は60以上の言語にまたがるため、トルコ語はトルコ語として扱われます。
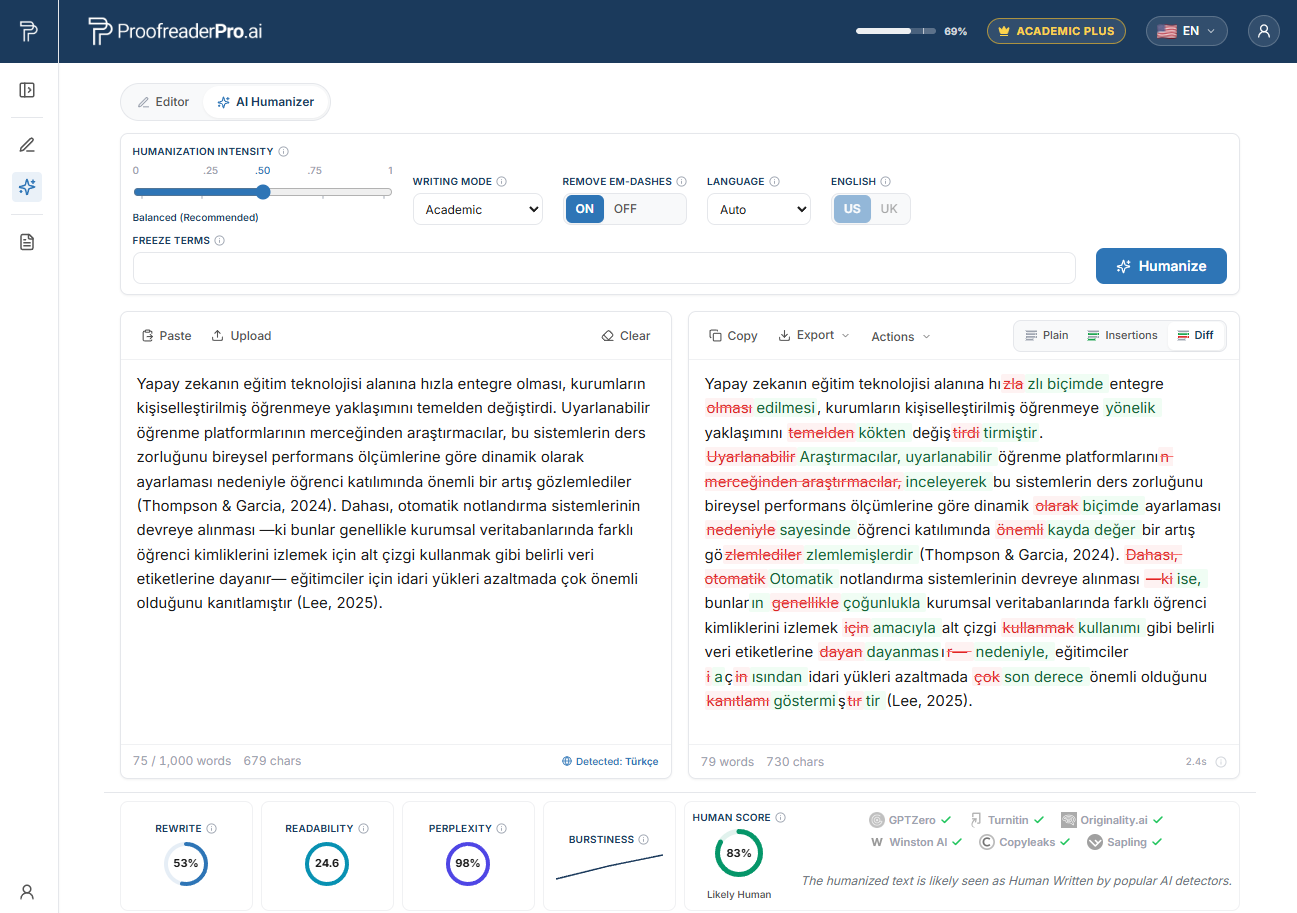
トルコの学術文を再構成するProofreaderPro AI Humanizer。前後の差分(diff)により意味と引用が維持され、検出チェックによって自然な人間の読み取りが確認できます。
なぜトルコ研究者はAI検出器でフラグ付けされるのか
最も明確な根拠は、梁(Liang)らによる2023年のスタンフォード研究です。同研究は、Cell Pressの雑誌Patternsに「"GPT detectors are biased against non-native English writers."」という題で掲載されました。研究チームは、人間が書いたTOEFLのエッセイを、広く使われている7種類の検出器にかけました。
この結果は、第二言語で書く人にとって不安材料になるはずです。非母語(non-native)のエッセイでは平均で約61%がAIとしてフラグ付けされたのに対し、母語(native)の英語筆者では約5%でした。さらに、非母語エッセイの約5分の1(約19.8%)は、すべての検出器で一致してフラグ付けされています。すべてのエッセイは人間によって書かれました。
この仕組みは「パープレキシティ(perplexity)」と呼ばれます。多くの検出器は、各単語の選択が言語モデルにとってどれほど“意外”か(驚きの度合い)をスコア化します。丁寧な第二言語の書き手は、よくある単語や標準的で予測可能な言い回しを用いがちです。その結果、パープレキシティが低くなり、機械文のように読まれてしまいます。トルコ研究者の英語が明確かつ正確になるための習慣は、まさに検出器がフラグ付けするよう学習されてきた習慣そのものです。この失敗パターンについては、why AI detectors flag non-native writersでより詳しく説明します。
偽フラグの背後にあるトルコ語(母語)話者のパターン
トルコ語は膠着的(agglutinative)で、冠詞の仕組みがなく、前置詞の代わりに後置詞(postpositions)を用い、語順は主語、目的語、動詞(subject-object-verb)です。トルコ語話者が慎重に英語を書くとき、彼らが自分で訓練してきた修正は、検出器が罰する「平板で標準化されたレジスター」へ文章を押し寄せることがよくあります。これは誤りではありません。訓練された第二言語の書き手が示す特徴です。
冠詞の規律は“平板さ”として読まれる。 トルコ語には不定冠詞が1種類("bir")のみで、定冠詞はありません。トルコ語話者は、"the" と "a/an" を意図的かつ一貫して挿入することを学ぶため、冠詞の使い方が教科書のように整っていきます。この非常に規則的な使用は、パープレキシティを下げます。
前置詞への過度な注意がリズムを平坦にする。 トルコ語は後置詞的な接尾辞を使うため、著者が最も安全で標準的な前置詞("related to," "depend on," "interested in")へと修正しすぎてしまいがちです。言い回しの揺れ(idiomatic variation)よりも、無難で標準的な選択が優先されます。安全で標準的であることは、まさに検出器が「予測可能」として読み取るものです。
再構成された語順が均一化する。 トルコ語では動詞が文末に置かれ、関係節(relative clauses)が名詞の前に来ます。英語で自然に聞こえるようにするため、著者はすべての文を、きれいな主語、動詞、目的語の順(subject-verb-object)に組み替えます。論文全体にわたって構文が均一で“行儀よく”整っていると、統計的に機械のように見えます。
コピュラ(be動詞)と動詞の精度。 トルコ語では "to be" の扱いが異なり、また "do" と "make" はどちらも "yapmak" に翻訳されます。これらの違いをしっかり訓練している著者は、動詞選択を一貫して慎重に行うため、別の低変動サインになります。
名詞処理の単純化。 トルコ語では複数形を自由に作るため、著者は数えられない名詞を厳密に管理することを学び、"informations" や "equipments" のような誤りを避けます。結果として、驚きが少ない慎重で標準的な使い方になります。
絡まりをほどいた節(Untangled clauses)。 トルコ語の膠着(agglutination)は、密な意味を長い構造に詰め込むため、慎重な著者はそれを短く整った英語の文へ分解します。短くて整っていることは読みやすく、同時にパープレキシティも低くなります。
トルコにおけるAI検出とTurnitinの文脈
トルコでは、学位論文やジャーナル投稿は、類似性(similarity)の観点でTurnitinまたはiThenticateによってスクリーニングされることが一般的で、さらにAI指標についても確認されるようになっています。トルコの大学は論文承認の一部として、長年にわたり類似性チェックを利用してきましたが、いまではAIのシグナルも同じワークフローに組み込まれています。
ただ、これらのAIスコアがどれほど争点化しているかを知っておくと役に立ちます。2023年にVanderbiltは、誤検知と非母語話者に対するバイアスを理由にTurnitinのAI検出器を無効化しました。同様の対応は、Michigan State、UT Austin、Northwestern、Pittsburgh、SMU、Waterlooでも行われています。Turnitin自身も、スコアを1〜19%の範囲では抑制し、数値ではなくアスタリスクを表示することで示しており、またそのスコアだけを用いて信頼性(integrity)の判断をしてはいけないと警告しています。
これは争うための主張であり、判決ではありません。「学生が“Turnitinを訴えて勝った”」ということはありません。本当の争いは、フラグがどのように使われたかをめぐって学校側と関係者の間で起きていました。トルコの著者にとっての実践的な教訓は、あなた自身の本物の執筆における誤フラグの可能性を減らすことです。ツールの利用を明確に開示すれば、争いの余地を減らせます。
AIによる誤検知フラグから英語を守りましょう
慎重なトルコ語から英語への書き換えを自然な読み心地にします。引用と意味を保持したうえで、開示し、自信をもって提出してください。
Humanizer を無料でお試しトルコの主要大学と、AIチェックがどこに登場するか
以下はいずれもトルコの主要な研究機関で、YOKの規則に基づき、教員の昇進のためには英語による出版が求められています。また、すべてが論文(theses)や原稿(manuscripts)を類似性およびAIシグナルの観点でスクリーニングします。
- Middle East Technical University / Orta Doğu Teknik Üniversitesi (ODTÜ)、アンカラ。世界で最高水準のランキングを誇り、工学、自然科学、建築に強みがあります。
- Istanbul Technical University / İstanbul Teknik Üniversitesi (İTÜ)、イスタンブール。工学・技術分野で世界トップクラスに入り、トルコでも最古の技術系大学の一つです。
- Boğaziçi University / Boğaziçi Üniversitesi、イスタンブール。英語による授業が中心で、工学・科学・社会科学に強みがあります。
- Hacettepe University / Hacettepe Üniversitesi、アンカラ。医学、保健科学、工学に加え、トルコでも最大級の研究大学の一つです。
- Istanbul University / İstanbul Üniversitesi、イスタンブール。トルコ最古の大学で、あらゆる分野に幅広く対応しています。
- Ankara University / Ankara Üniversitesi、アンカラ。法学、医学、社会科学に強みがあります。
- Gazi University / Gazi Üniversitesi、アンカラ。教育、工学、保健科学。
- Ege University / Ege Üniversitesi、イズミル。農学、医学、自然科学。
- Koç University / Koç Üniversitesi、イスタンブール。強い学際的な科学プロファイルを持つ、研究集約型の私立機関です。
- Sabancı University / Sabancı Üniversitesi、イスタンブール。国際的な強いプロファイルを備え、工学、自然科学、社会科学に強みがあります。
- Bilkent University / İhsan Doğramacı Bilkent Üniversitesi、アンカラ。トルコ初の私立大学で、ナノテクノロジーと材料科学で知られています。
これらの全体を通じて、QS Europeのトップ500に23のトルコ大学が登場します。共通点は、論文や原稿が受理される前に類似性とAIのスクリーニングを通過することです。したがって、誤フラグから丁寧な執筆を守ることは、これらすべての場面で重要になります。
トルコ研究者のためのAI人間化(humanizer)の仕組み
ワークフローは明確でシンプルであり、あなたを所属機関のルールの範囲内に保ちます。
まず、下書きを作成します。トルコ語で書いて学術英語に翻訳してもよいし、AI支援を用いて英語で直接下書きしても構いません。最初に母語で考えることは、より明確な主張(argument)につながることが多いからです。
次に、文法を校正します。冠詞の使い方、前置詞、語順が正しくなるように整えるのが目的です。求められるのは「正しい英語」であって、「問題を消す」ことではありません。
第三に、あなた自身のAI支援による文章をtext humanizerにかけます。リズムや語彙の選び方を変化させ、反復的なカデンツや紛れ込んだダッシュ(em dashes)を取り除くことで、丁寧でパープレキシティの低い第二言語の文章が誤って機械文として読まれる可能性を下げます。意味、技術的な用語、そしてすべての引用はそのまま保たれます。このツールは、60以上の言語にわたって文の構造と意味を保持できる、言語対応のモデルに非英語テキストをルーティングします(トルコ語を含む)。
以下は、テストが示していることを率直に述べます。主要な検出器に対してテストしたところ、人間らしい声(genuinely human voice)へとAI表現を作り替えることで、AIスコアが下がり、厳格な検出器に対してテキストがより通りやすくなる一方で、学術文における文法の正確さは高く保たれます。これらはテスト結果であり、保証ではありません。検出器は数か月ごとに再学習されるため、「100%検出不能」や検出回避を確実に行える方法を信頼できるツールはありません。
第四に、そしてこの手順は任意ではありません。所属機関や投稿先ジャーナルが求める形式で、AIの利用を開示します。自分自身の下書きを人間化したうえで開示することが、信頼性(integrity)のルールの範囲内に留まりつつ、誤フラグからあなたの成果を守ることになります。これは、トルコの研究者向けアカデミック編集で説明される「人間による編集」の道筋とも一致しており、言語ごとにこのアプローチを扱うより広い多言語AI人間化(multilingual AI humanizer hub)の中に位置付けられます。
地方(現地)助成団体、ジャーナル、そしてAI開示への期待
トルコの研究資金と評価は、いくつかの中核的機関を通じて運用されています。YOKは大学院プログラムに対して最低限の出版要件を定めています。docentlikの称号は、Inter-University Council(UAK)によって全国的に管理されています。TUBITAKのUBYTプログラムは、国際的にインデックスされたジャーナルでの出版に対する直接的な財政インセンティブを提供し、TUBITAK ULAKBIMはDergiParkのホスティング基盤とともにTRDizinという全国のインデックス・プラットフォームを運営しています。
TUBITAKはまた、11本のダイヤモンド方式(diamond)のオープンアクセスジャーナルも出版しており、いずれもScopusにインデックスされています。代表的なタイトルには、Turkish Journal of Medical Sciences、Turkish Journal of Chemistry、Turkish Journal of Mathematics、Turkish Journal of Physics、Turkish Journal of Biology、Turkish Journal of Earth Sciences、Turkish Journal of Electrical Engineering and Computer Sciences、Turkish Journal of Agriculture and Forestryが含まれます。これらはいずれも、そしてより広いTRDizinのエコシステム全体として、少なくとも英語の原稿または英語要旨を求めるのが一般的です。
資金提供者(ファンダー)やジャーナルは、著者に対してAIツールを「使用したか」「どのように使用したか」をより頻繁に尋ねるようになっています。安全な姿勢は、まずあなた自身の下書きを人間化することで明確さと公平性を確保し、そのうえで短く正確な開示文を書くことです。本物の原稿でなおフラグが立つ場合は、それを争点として捉え、慌てるよりもあなたの下書きと開示内容を提示して対応してください。
よくある質問(FAQ)
Q: トルコ研究者向けのAI人間化(humanizer)の利用は、いわゆる不正(cheating)と見なされますか?
いいえ、責任ある使い方をする場合には違います。あなた自身のAI支援による下書きを人間らしく整え、意味と引用を保持したうえで、所属機関やジャーナルが求める形でAIの利用を開示します。これは捏造された文章を隠すためではなく、実在する作業に対する公平性のためのステップです。
Q: この人間化(humanizer)は、私の論文がTurnitinやGPTZeroを通ることを保証しますか?
いいえ、真面目なツールにそんな保証はできません。また、そうした主張をするものは信用しないでください。主要な検出器に対するテストでは、私たちの人間化はAI文をより自然な人間の形へ作り替えるため、AIシグナルが下がり、厳しい検出器に対する通過の可能性が高まります。ただし検出器は数か月ごとに再学習されます。私たちはテスト済みの結果を報告しますが、「100%検出不能な出力を保証する」ような約束はしません。
Q: なぜ、私の丁寧な学術英語が最初からAIとしてフラグ付けされるのですか?
多くの検出器は、パープレキシティ(perplexity)をスコア化し、その意味で「単語の選択がどれほど予測可能か」を見ています。きれいで標準的な教科書調の英語を書くトルコ語話者は、パープレキシティの低い文章を作りやすく、その結果、機械生成のように読まれてしまいます。スタンフォードの研究では、人間が書いた非母語エッセイの約61%がフラグ付けされていたのに対し、母語話者では約5%でした。
Q: humanizerは、私の引用や技術用語をそのまま維持しますか?
はい。このツールはリズムや語彙の選び方を変え、反復的なカデンツを取り除きますが、あなたの意味、分野に特化した用語、そしてすべての引用は保持します。検出器が誤って判断しがちな「表面」を整えつつ、主張の本質(substance)を守るために作られています。
Q: 私は最初にトルコ語で書きます。このワークフローは使えますか?
はい。まずトルコ語で主張(argument)を書き、それを学術英語に翻訳し、文法を校正したうえで、英語出力を人間化します。humanizerは言語に対応しており、60以上の言語にわたって文の構造を保持するため、このパイプラインはトルコ語で考える人にとっても適性が高いです。
自然なリズムになるように、トルコ語から英語へのAI支援原稿を書き直します。引用、用語、意味は保持。主要な検出器でテスト済み。完全な開示を推奨します。

Moe は、自然言語処理の PhD を持つ NLP エンジニアです。 彼の研究は計算言語学、テキスト分析、機械学習をカバーしており、それは ProofreaderPro の背後にある編集および人間化モデルに直接反映されています。 彼は、ほとんどの人が目にすることのないプロセスの部分、つまり言語モデルがどのように文を読み取り、スコアを付け、何を変更するかを決定するかについて書いています。


