Filigrane OpenAI, SynthID et Claude : comparaison des filigranes pour le texte
OpenAI filigrane-t-il son texte, existe-t-il un outil public de vérification des filigranes OpenAI, et en quoi SynthID et le filigrane de Claude diffèrent-ils, comparés pour les auteurs universitaires.
OpenAI, Google et Anthropic ont tous construit la même technologie : un filigrane statistique pour le texte généré par AI. OpenAI a tenu sa version en réserve pendant des années et l'a commencée à déployer, sous le nom textGrain, en octobre 2026. Google a intégré SynthID dans Gemini et a publié la méthode. Anthropic a rendu le filigrane de Claude obligatoire pour chaque utilisateur en août 2026. Si vous rédigez avec une assistance par AI, sous quelque forme que ce soit, ces trois choix influencent désormais la façon dont vos documents sont évalués.
Le filigranage est passé d'un sujet de recherche aux actualités grand public le 11 août 2026, quand Anthropic a annoncé que chaque nouveau modèle Claude marque la sortie de son texte. Nous avons détaillé cette annonce dans notre explication du filigrane de Claude. Ce guide donne le tableau complet : ce qu'est un filigrane de texte, comment chacun des trois grands laboratoires l'a implémenté ou retenu, et ce que chaque système prouve au sujet d'un texte.
Qu'est-ce qu'un filigrane de texte par AI ?
Un filigrane de texte par AI est un motif statistique caché dans les choix de mots du texte généré, déposé au moment de la génération afin qu'un détecteur disposant de la bonne clé puisse ensuite vérifier que le texte provient d'un système d'AI précis. Ce n'est pas un libellé visible, ce n'est pas un caractère caché, et ce n'est pas non plus des métadonnées attachées à un fichier. La marque réside dans les mots eux-mêmes.
Cette distinction compte, car le terme "filigrane" est utilisé de façon lâche pour trois choses différentes :
| ce que c'est | où cela se trouve | résiste-t-il au copier-coller ? | |
|---|---|---|---|
| Filigrane statistique | Un biais dans les mots que le modèle sélectionne | Le texte lui-même | Oui |
| Métadonnées de fichier (C2PA) | Une étiquette de provenance signée | Le conteneur du fichier | Non, la copie en texte brut la supprime |
| Caractères à largeur nulle | Unicode invisible inséré dans le texte | Entre les caractères visibles | Non, supprimé de façon triviale |
Le filigranage statistique est le seul des trois à survivre à la copie, au collage, à la réécriture manuelle puis au changement de document, ainsi qu’à la conversion de format. C’est pourquoi les trois principaux laboratoires y ont convergé pour le texte, et pourquoi les « supprimeurs de filigranes » qui retirent les caractères invisibles ne font rien contre lui. Notre page supprimeur de filigrane Claude gratuit documente ce mode d’échec avec des sources.
Comment le filigranage statistique fonctionne-t-il réellement ?
À chaque étape de la rédaction d’une phrase, un modèle de langage choisit entre plusieurs mots presque équivalents, et un filigrane charge discrètement ces dés. La recette de base a été publiée par Kirchenbauer et ses collègues à l’Université du Maryland en janvier 2023, dans Un filigrane pour les grands modèles de langage (ICML 2023). Voilà comment cela fonctionne :
- Avant qu’un mot ne soit choisi, une clé secrète dérivée des mots précédents découpe le vocabulaire en un ensemble privilégié et un ensemble neutre.
- Le modèle oriente son choix vers l’ensemble privilégié. « Suggest » au lieu de « indicate ». « Across » au lieu de « among ». Chaque choix pris isolément paraît totalement naturel.
- Un détecteur qui détient la clé compte à quelle fréquence le texte tombe dans les ensembles privilégiés. L’écriture humaine atteint le taux attendu par hasard. Le texte filigrané l’atteint bien trop souvent, et un test statistique signale l’écart.
Aucun mot pris seul n’est une preuve de quoi que ce soit. Le signal n’apparaît que sur des dizaines ou des centaines de choix, c’est pourquoi les passages plus longs se prêtent mieux aux tests que les courts, et c’est aussi pourquoi la détection est toujours probabiliste plutôt qu’un tampon oui/non.
Le système de production de Google DeepMind, publié dans Nature en octobre 2024 sous le titre Watermarkage évolutif pour identifier les sorties des grands modèles de langage, l’a affinée avec une technique appelée tournament sampling, qui préserve suffisamment la qualité du texte pour permettre une exécution silencieuse au sein d’un produit grand public à grande échelle. Cet article compte au-delà de Google : c’est la base publiée vers laquelle Anthropic renvoie pour l’implémentation de Claude.
La principale faiblesse avait été publiée avant la plupart des déploiements. En mars 2023, Krishna et ses collègues ont montré dans La paraphrase contourne les détecteurs de texte généré par IA (NeurIPS 2023) que la régénération de la formulation d’un passage fait s’effondrer la détection, quelle que soit la méthode, filigranage inclus. Le signal vit dans la séquence exacte de tokens et nulle part ailleurs, de sorte que toute réécriture de la séquence, y compris par un éditeur humain, réécrit aussi la preuve. Chaque fournisseur qui expédie aujourd’hui un filigrane indique cette limite dans sa propre documentation.
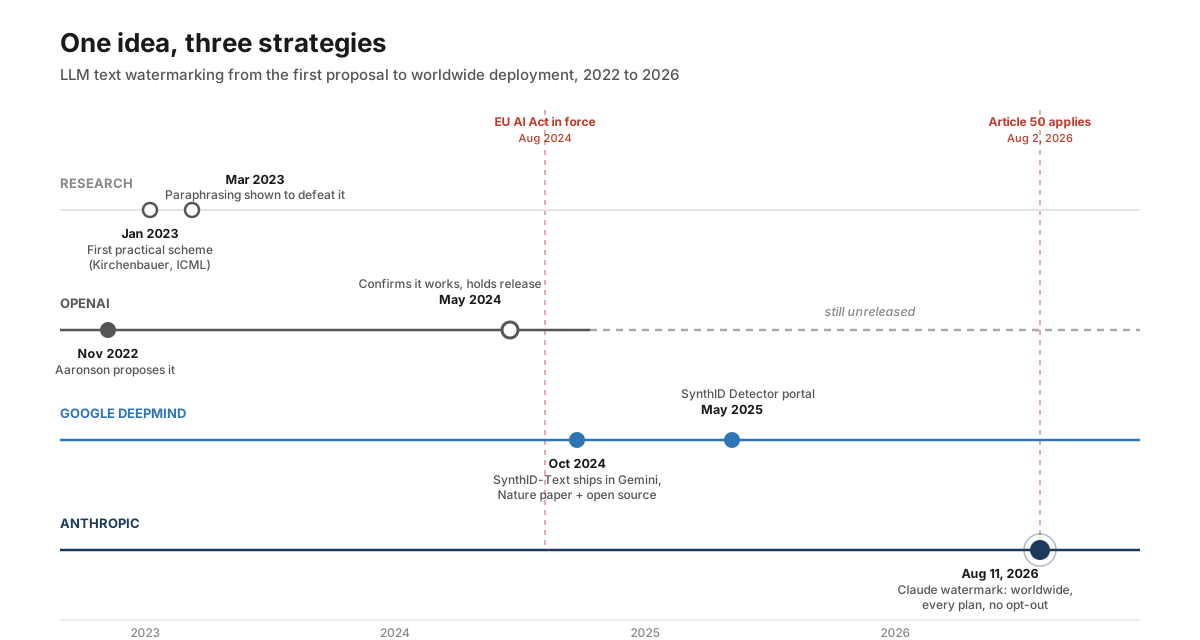
OpenAI : la société qui l’a inventé et l’a déployé en dernier
OpenAI avait un filigrane de texte fonctionnel depuis des années et a choisi de ne pas le publier avant octobre 2026. Scott Aaronson, alors chargé de la sécurité chez OpenAI, a d’abord décrit l’idée publiquement dans une conférence de novembre 2022. La méthode biaise les choix du modèle entre des mots presque équivalents à l’aide d’une fonction cryptographique secrète, de sorte que le texte lui-même indique d’où il vient. Cette conférence est plus ancienne que tous les systèmes déployés.
En mai 2024, OpenAI a décrit l’état du projet dans sa mise à jour sur la provenance, Comprendre l’origine de ce que nous voyons et entendons en ligne. L’entreprise a indiqué que sa méthode de filigranage du texte était précise et efficace sur de petites modifications, mais qu’elle retenait le déploiement au moment de l’annonce, le temps d’évaluer les compromis. Deux des risques qu’OpenAI a cités concernent directement les rédacteurs académiques :
- Contournement facile. Reformuler ou traduire le texte efface la marque, exactement comme la recherche de 2023 l’avait prédit. Un filigran qui repère surtout les personnes qui ignorent qu’il existe constitue un outil de contrôle faible.
- Impact disproportionné sur les personnes non natives de l’anglais. OpenAI a déclaré que le filigranage pouvait stigmatiser l’usage légitime de l’IA comme aide à l’écriture pour les personnes qui rédigent dans une deuxième langue. Notre article sur pourquoi les détecteurs d’IA signalent les auteurs non natifs aborde le même problème du point de vue des détecteurs.
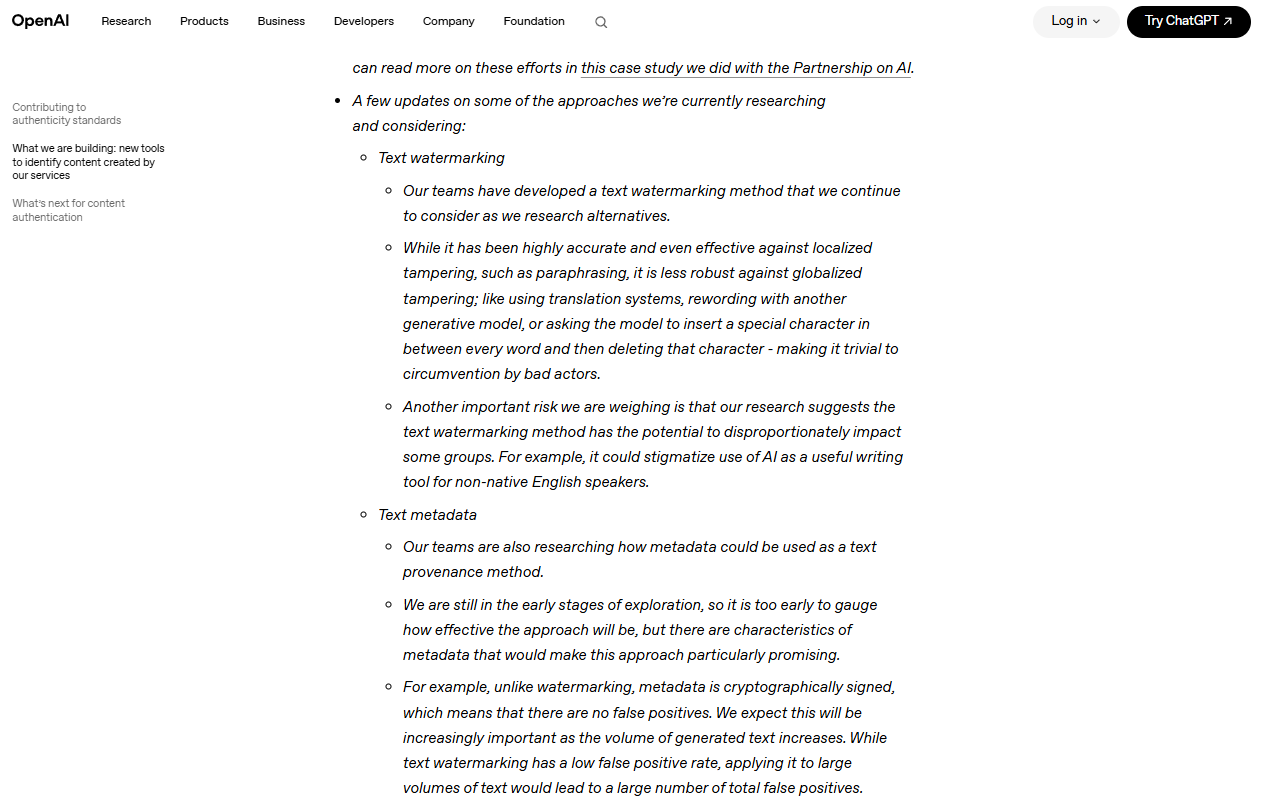
Mise à jour sur la provenance 2024 d’OpenAI : la méthode fonctionne et l’entreprise liste les raisons pour lesquelles elle l’a retenue à l’époque.
Pour les images et l’audio, OpenAI a emprunté une autre voie : des métadonnées de provenance C2PA dans les sorties de DALL-E et de Sora, c’est une étiquette au niveau du fichier, plutôt qu’une marque dans le contenu. Pour le texte, la sortie de ChatGPT n’avait aucun filigran jusqu’en octobre 2026. L’entreprise à l’origine de la technologie a été la dernière des trois à la déployer.
OpenAI filigrane-t-il le texte aujourd’hui ?
Oui, OpenAI a commencé à filigraner certains contenus textuels le 5 octobre 2026, en réponse à l’Act de l’UE sur l’IA. Son annonce présente un filigran de texte appelé textGrain, qui ajoute un signal statistique invisible aux choix de mots du modèle. Le déploiement se fait en trois volets, et le filigran n’est pas un réglage par défaut global :
- Les clients d’API, partout, peuvent activer la sortie filigranée pour certains modèles. Elle reste désactivée par défaut.
- Au cours des semaines suivantes, les sorties textuelles éligibles de ChatGPT et de Codex dans l’Union européenne reçoivent le filigran, sur tous les forfaits.
- Les chercheurs approuvés et les organisations d’experts peuvent demander l’accès au détecteur de filigran de texte.
OpenAI affirme que textGrain correspond ou dépasse les autres méthodes qu’il a testées, y compris SynthID de Google pour le texte. L’entreprise a aussi publié les endroits où la détection s’affaiblit. À un taux de faux positifs de 1 %, le détecteur identifie le filigran dans environ 80 % des passages de 200 jetons et environ 95 % des passages de 400 jetons sur des contenus liés à la psychologie. La détection est bien plus faible pour les mathématiques, où la marge de manœuvre dans le choix des mots est moindre.
La modification affaiblit le signal rapidement. Sur des passages de 400 jetons, remplacer 10 % des mots par des synonymes réduit la détection d’environ 92 % à 66 %, et remplacer 25 % la fait passer à 17 %.
OpenAI a aussi vérifié si le filigran modifie la qualité des réponses sur Astra, son modèle le plus récent, et indique qu’il n’a observé aucune différence significative. Voici quatre de ses bancs d’essai publiés :
| Banc d’essai | Sans filigran (Astra) | Avec filigran (Astra) |
|---|---|---|
| Artificial Analysis Intelligence Index | 49,57 points | 49,76 points |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
Pour les étudiants, la date compte. Le texte de ChatGPT rédigé avant le déploiement, ou en dehors de l’Union européenne sans le paramètre API activé, n’a aucun filigran d’OpenAI. Notre guide de Turnitin Clarity expliqué explique comment les établissements mettent en place, entre-temps, leurs propres politiques d’usage de l’IA.
Y a-t-il un vérificateur public de filigran OpenAI ?
Il n’existe pas encore de vérificateur public OpenAI pour le texte. L’outil gratuit d’OpenAI vérification tool analyse les fichiers image et audio pour vérifier les informations C2PA Content Credentials et pour repérer un filigrane SynthID. OpenAI intègre ce filigrane dans les images et contenus audio pris en charge. OpenAI indique que l’outil ne prend pas en charge le texte.
Pour le texte, OpenAI donne accès à des détecteurs au cas par cas à des chercheurs approuvés et à des organisations d’experts, via son formulaire Content Provenance API. L’entreprise affirme qu’elle ne rend pas le détecteur de texte public au lancement en raison du risque de filigranes manqués et de faux positifs. Le détecteur indique s’il détecte un filigrane OpenAI, mais il n’identifie pas l’utilisateur et n’affiche pas ses prompts.
| Ce que vous voulez vérifier | Outil | Qui peut l’utiliser |
|---|---|---|
| Un fichier image ou audio OpenAI | L’outil de vérification d’OpenAI | Tout le monde, gratuitement |
| Sortie texte d’OpenAI (textGrain) | Détecteur de filigrane de texte d’OpenAI | Chercheurs approuvés et organisations d’experts, sur demande |
| Sortie texte de Claude | Détecteur de filigrane Claude | Organisations éligibles, sur demande (voir notre guide sur le filigrane Claude) |
OpenAI précise aussi ce qu’un résultat ne peut pas vous dire. Un filigrane détecté ne mesure pas la part de contribution d’une personne, et il ne dit pas qui a écrit ou utilisé le texte. L’absence de filigrane ne prouve pas non plus une paternité humaine, car le texte peut être trop court, modifié, traduit ou provenir d’un modèle non pris en charge.
Google: le premier à déployer, puis a divulgué la méthode
Google DeepMind a d’abord expédié, a publié la méthode intégralement, puis a ouvert la technique. Son système, SynthID, a commencé comme filigrane pour les images en 2023 et s’est étendu au texte en 2024. Au moment de la publication du papier Nature en octobre 2024, SynthID-Text était déjà en production dans Gemini, ce qui en faisait le premier filigrane statistique de texte déployé à l’échelle grand public.
SynthID couvre le texte, les images, l’audio et la vidéo, et est opérationnel dans la sortie texte de Gemini depuis octobre 2024.
Google a ensuite publié l’implémentation en open source sur Hugging Face, permettant à tout développeur d’appliquer le même schéma de filigrane à ses propres modèles. En mai 2025, il a annoncé le SynthID Detector, un portail de vérification où le contenu peut être contrôlé pour les marques SynthID dans le texte, les images, l’audio et la vidéo.
Il y a une limite de portée qui compte: SynthID ne marque et ne détecte que les contenus issus des propres modèles de Google. Il ne dit rien sur la sortie de ChatGPT ou de Claude, et un balayage SynthID sans alerte ne signifie pas que le texte a été écrit par un humain. Cela veut dire que les modèles de Google ne l’ont pas rédigé, ce qui constitue une affirmation beaucoup plus restrictive.
Anthropic: le dernier à bouger, avec la politique la plus stricte
Anthropic a déployé la dernière solution, avec la couverture obligatoire la plus large. Chaque modèle Claude lancé le 2 août 2026 ou après intègre un filigrane statistique dans sa sortie de texte, dans le monde entier, pour tous les forfaits, sans possibilité de désactivation. L’entreprise décrit le mécanisme dans son explicatif, Comment fonctionne le filigrane de texte de Claude, et le périmètre de la politique dans son article du centre d’aide, Comment Claude marque du contenu généré par IA : l’API Claude, claude.ai, Claude Code, Claude Cowork et Claude Tag sont tous couverts. Les modèles lancés avant la date limite sont en période de transition, et Anthropic indique qu’il ajoute aussi une prise en charge du marquage pour ces modèles. En plus de la marque statistique, les fichiers générés par Claude portent également des métadonnées C2PA, un deuxième système distinct, que la copie en texte brut fait disparaître.
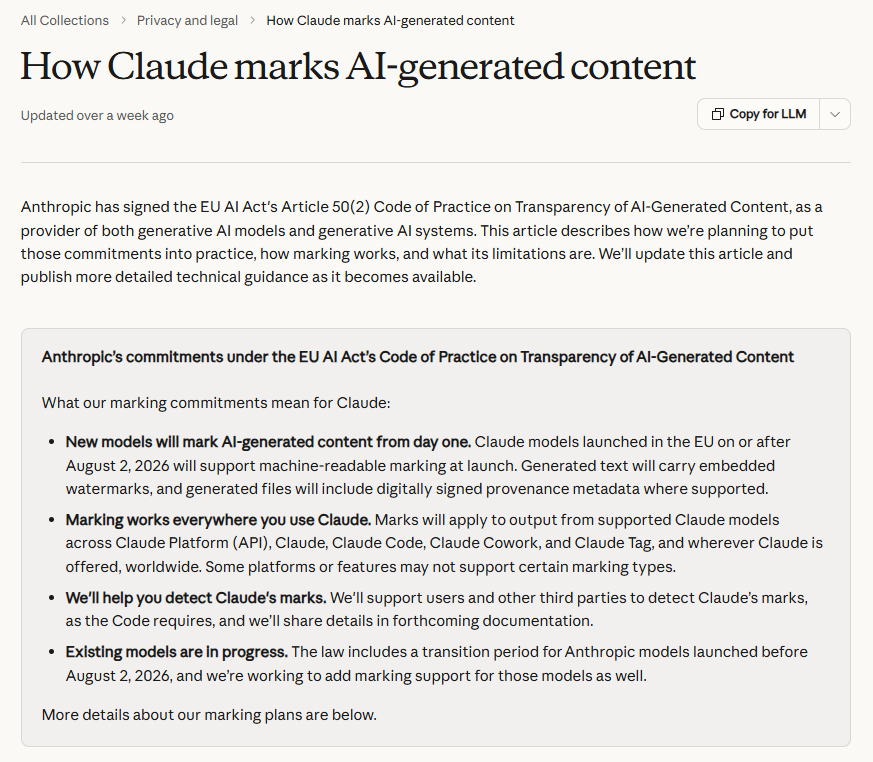
La politique dans les propres termes d’Anthropic: chaque nouveau modèle, chaque plateforme, dans le monde entier, les anciens modèles étant ajoutés.
La documentation d’Anthropic indique directement les limites. La détection est probabiliste. L’annotation ne peut pas distinguer un document qu’un Claude a rédigé d’un document qu’un humain a rédigé et que Claude a légèrement modifié. Une réécriture complète la supprime. Nous avons tout passé en revue, y compris ce qu’une détection positive prouve réellement et quoi faire si votre propre texte est annoté, dans le guide dédié sur les filigranes Claude.
Le calendrier suit la réglementation. Anthropic a signé le Code de pratique Article 50(2) sur la transparence des contenus générés par l’IA sous le règlement IA de l’UE, qui impose aux fournisseurs de systèmes d’IA générative de veiller à ce que les sorties soient « annotées dans un format lisible par machine et détectables comme artificiellement générées ». Ces obligations de transparence sont devenues applicables le 2 août 2026: la date limite exacte dans la politique de modèle d’Anthropic, soit neuf jours avant l’annonce publique. Anthropic a choisi de se conformer à l’échelle mondiale plutôt que de maintenir un comportement distinct pour le trafic destiné à l’UE. Google était déjà conforme par conception. La sortie de texte non annotée d’OpenAI est la question de conformité ouverte pour 2027.
Les trois approches, côte à côte
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| Filigrane textuel déployé? | Oui (textGrain, déploiement dans l’UE à partir du 5 octobre 2026) | Oui (Gemini, depuis octobre 2024) | Oui (modèles Claude à partir du 2 août 2026) |
| Technique | textGrain, un signal statistique dans les choix de mots | Échantillonnage par tournoi SynthID | Marque d’échantillonnage statistique, style SynthID |
| Couverture | Texte éligible ChatGPT et Codex dans l’UE; option d’activation via API dans le monde entier | Modèles Google uniquement | Tous les nouveaux modèles Claude; anciens modèles en transition |
| Désactivation | Désactivé par défaut dans l’API | Non | Non |
| Détecteur public | Non | Portail de détection SynthID (2025) | Prévu, pas encore publié |
| Schéma publié? | Cours de présentation uniquement | Article Nature + code source ouvert | Explication, fondée sur des travaux publiés |
| Métadonnées de fichier (C2PA) | Oui, pour les images et l'audio | Oui, sur tous les supports | Oui, sur les fichiers générés |
| Limites déclarées | Contournement, stigmatisation liée à l'anglais langue seconde (ESL) | Portée limitée à ses propres modèles | Probabiliste, les modifications brouillent la paternité |
Le schéma à travers les colonnes: OpenAI considère le filigrane de texte comme un problème de politique encore non résolu, Google comme une infrastructure à standardiser, et Anthropic comme une obligation de conformité à mettre en œuvre intégralement.
Ce que cela implique pour les chercheurs et les rédacteurs académiques
Les conséquences pratiques dépendent des outils qui touchent votre texte. Si vous rédigez avec ChatGPT, votre texte ne porte aucun filigrane aujourd'hui. Si vous rédigez avec Gemini, il porte un marquage SynthID que seul le détecteur de Google peut lire. Si vous rédigez ou modifiez avec un modèle Claude actuel, il porte le marquage d'Anthropic, et il n'existe aucun paramètre pour désactiver cela.
Trois choses à connaître pour les rédacteurs académiques:
Un filigrane identifie un outil, pas un auteur. Chaque fournisseur le précise dans sa propre documentation, et cela vaut la peine d'être répété, car les politiques institutionnelles ne font pas toujours la distinction. Le texte peut être marqué parce qu'un IA l'a rédigé, parce qu'une IA a corrigé deux phrases, ou parce qu'un paragraphe marqué a été cité. Si votre institution effectue des contrôles de filigranes, ce que le contrôle prouve, c'est qu'un modèle précis a touché le texte à un moment donné, et rien de plus. Notre guide sur contester un faux signal de détection d'IA explique comment faire valoir cet argument quand c'est important.
Les filigranes et les détecteurs d'IA sont des technologies différentes, avec des modes de défaillance différents. Des détecteurs comme Turnitin ou GPTZero évaluent à partir du style statistique, avec les problèmes de précision que nous avons documentés. La détection de filigrane est un test fondé sur une clé, avec un taux très faible de faux positifs sur du texte humain non marqué. L'asymétrie s'inverse pour les faux négatifs: un contrôle de filigrane manque tout texte d'IA issu d'un modèle qui n'appose pas de filigrane, ce qui inclut aujourd'hui tous les modèles de ChatGPT.
La divulgation reste votre meilleure position. Le filigranage rend l'usage silencieux d'IA plus risqué et l'usage divulgué d'IA plus sûr, parce qu'un workflow divulgué n'a rien à craindre d'un marquage positif. La plupart des revues et universités ont désormais des politiques explicites sur l'usage de l'IA; notre politique d'usage de l'IA explique comment nous traçons ces limites pour nos propres outils, et c'est un modèle raisonnable de ce qu'est un usage transparent.
Ce qui supprime un filigrane de texte, et ce qui ne le supprime pas
La réécriture le supprime; la mise en forme ne le fait pas. La copie, le collage, le changement de polices, la conversion entre formats de fichiers et la suppression de caractères invisibles laissent tous un filigrane statistique entièrement intact, car la marque se trouve dans les choix de mots. Ce qui le supprime est tout ce qui régénère la formulation: une modification profonde par un humain, une traduction ou une paraphrase véritable, comme le travail sur la robustesse de NeurIPS 2023 l’a établi avant que l’une de ces systèmes ne soit mise sur le marché.
Les deux sens comptent ici. Le marquage qui disparaît ne rend pas le texte vôtre, et le marquage qui subsiste ne prouve pas que le texte n’est pas le vôtre. Un brouillon généré par l'IA reformulé reste un document assisté par IA, auquel les règles de divulgation de votre établissement s'appliquent. Notre humanizer d'IA reformule des brouillons assistés par IA dans un registre académique naturel, et comme ce processus régénère la séquence de jetons, les marques statistiques n'y survivent pas. Pour Claude en particulier, le suppresseur de filigrane Claude réexprime chaque phrase avec un vocabulaire neuf tout en conservant les faits, les chiffres et les citations inchangés. Ce qu'aucun outil ne peut modifier, en revanche, c’est ce que vous devez à votre lecteur: la transparence sur la façon dont le document a été produit.
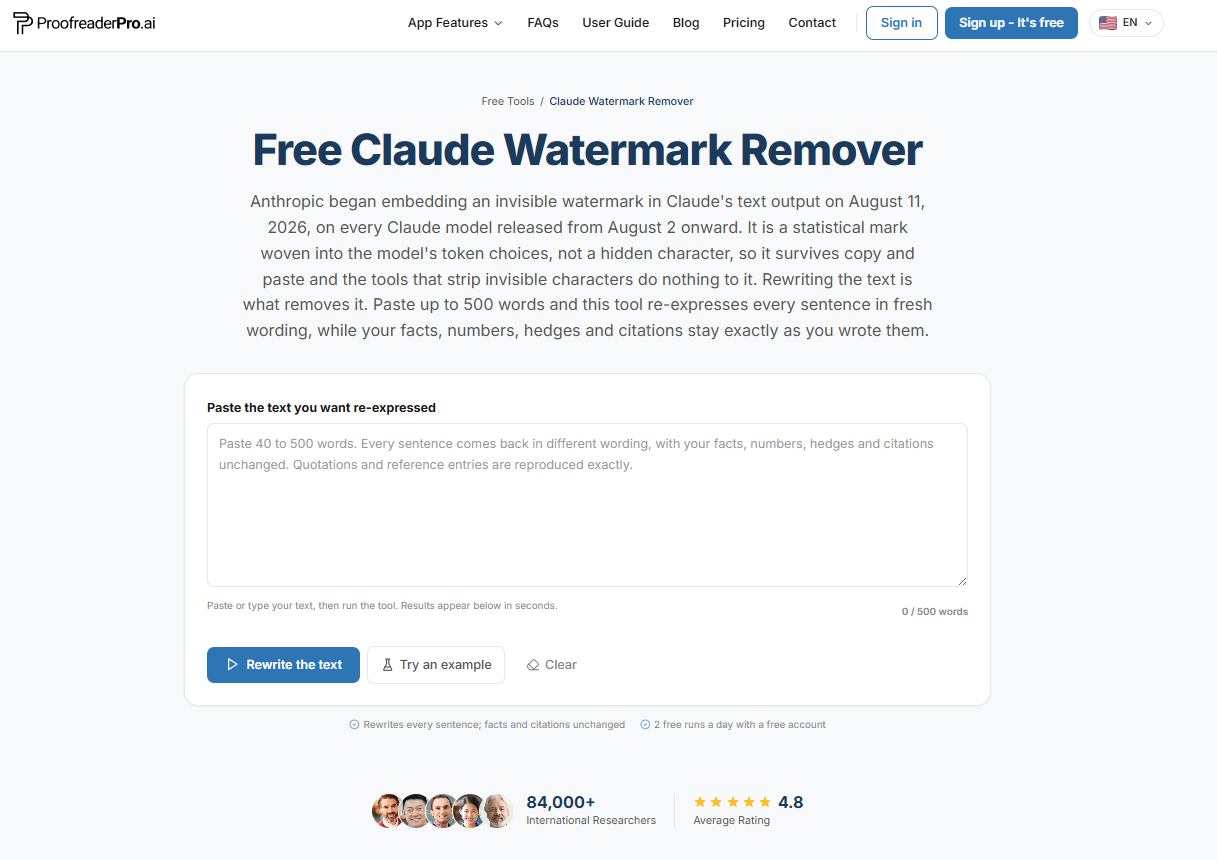
La réécriture est la seule opération qui supprime une marque statistique, et c’est précisément ce que fait cet outil, phrase par phrase.
Vers où cela va ensuite
Surveillez trois points jusqu’en 2027. D'abord, si OpenAI pousse textGrain au-delà de l’UE: cela a commencé là-bas, car l’application, dans l’UE, de l’article 50 exige des marques sur les textes d’IA, lisibles par machine. Ensuite, si les détecteurs convergent. Si chaque grand laboratoire appose des filigranes selon un schéma publié, les universités peuvent vérifier les clés au lieu de deviner à partir du style d’écriture, ce qui améliorerait la situation par rapport à la détection sujette aux faux positifs. Troisièmement, si les marques deviennent compatibles. Aujourd’hui, trois laboratoires utilisent trois marques différentes, et aucune vérification unique ne les couvre toutes. C2PA comble ce manque pour les fichiers, mais rien ne le comble pour le texte brut.
ChatGPT appose-t-il un filigrane sur son texte ?
Oui, en partie, depuis le 5 octobre 2026. OpenAI a commencé à ajouter son filigrane textGrain aux textes ChatGPT et Codex éligibles dans l’Union européenne, et les clients API, partout ailleurs, peuvent l’activer. Le filigrane est un signal statistique dans les choix de mots, sans caractères cachés. OpenAI applique aussi les métadonnées de provenance C2PA aux fichiers médias DALL-E et Sora, qui constituent un système distinct, au niveau du fichier.
Google Gemini appose-t-il un filigrane sur son texte ?
Oui. Les sorties de Gemini portent le filigrane SynthID-Text de Google DeepMind depuis octobre 2024. Il s’agit d’une marque statistique dans les choix de mots, invisible pour les lecteurs et vérifiable via le SynthID Detector de Google. Il s’applique uniquement aux modèles de Google aussi: un résultat SynthID négatif ne dit donc rien sur le texte provenant d’autres systèmes d’IA.
Claude appose-t-il un filigrane sur son texte ?
Oui. Chaque modèle Claude lancé le 2 août 2026 ou après intègre un filigrane statistique dans sa sortie de texte, sur toutes les plateformes et formules, sans option de désactivation, et les fichiers générés par Claude portent en plus des métadonnées C2PA. Les modèles lancés avant cette date ne marquent pas encore leur sortie: Anthropic indique qu’il ajoute la prise en charge du marquage à ces modèles pendant une période de transition. Tous les détails complets figurent dans notre explicateur sur le filigrane de Claude.
Les universités peuvent-elles détecter les filigranes d’IA ?
Seulement avec la coopération du fournisseur, car la détection exige la clé du fournisseur. Google propose un portail de détection public pour le contenu SynthID. Anthropic indique que la prise en charge de la détection pour les utilisateurs et les tiers est prévue, mais qu’elle n’a pas encore publié de détecteur public. À l’heure actuelle, aucune suite de plagiat grand public ne peut vérifier des filigranes statistiques provenant de n’importe quel laboratoire; l’« identification de l’IA » institutionnelle signifie donc encore aujourd’hui un jugement fondé sur le style, et non une vérification des filigranes.
Le filigranage par IA est-il exigé par la loi ?
Dans l'UE, oui, effectivement. L'article 50(2) de l'AI Act de l'UE impose aux fournisseurs d'IA générative de veiller à ce que les sorties soient marquées dans un format lisible par machine et détectables comme artificiellement générées, avec des obligations de transparence applicables à partir du 2 août 2026. Anthropic a signé le Code de pratique associé et a choisi une conformité à l'échelle mondiale. La question à surveiller en 2027 est la manière dont les régulateurs traiteront le filigrane de texte non publié d'OpenAI.
Les filigranes d'IA survivent-ils à la traduction ?
Non. Un filigrane statistique vit dans la séquence exacte de mots que le modèle a choisie, et la traduction remplace chaque mot. Il en va de même pour la paraphrase approfondie et les modifications humaines importantes. Cette limite est documentée dans la littérature évaluée par des pairs et reconnue par chaque fournisseur qui déploie un filigrane.
Existe-t-il un outil public de vérification du filigrane OpenAI pour le texte ?
Non, l'outil de vérification public d'OpenAI ne vérifie que les fichiers image et audio, pour les métadonnées C2PA et les filigranes SynthID. OpenAI indique qu'il ne prend pas en charge le texte. Son détecteur de filigrane de texte n'est accessible qu'à des chercheurs et organisations expertes approuvés, au cas par cas.
Qu'est-ce que textGrain ?
textGrain est le filigrane de texte d'OpenAI, annoncé le 5 octobre 2026. Il ajoute un signal statistique invisible aux choix de mots du modèle, de sorte que la marque fait partie des mots, sans caractères cachés ni métadonnées de fichier. OpenAI affirme qu'il égalait ou dépassait les autres méthodes qu'il a testées, y compris SynthID pour le texte, et que l'édition l'affaiblit.
Les chercheurs peuvent-ils demander l'accès au détecteur de filigrane de texte d'OpenAI ?
Oui, les chercheurs approuvés et les organisations expertes peuvent demander l'accès via le formulaire de l'API de Content Provenance d'OpenAI. OpenAI accorde l'accès au cas par cas dans le cadre du Code de pratique de l'UE. L'entreprise indique qu'elle réévaluera un accès plus large à mesure que la technologie et les preuves évolueront.
Sources
- Anthropic, Comment fonctionne le filigrane de texte de Claude, août 2026
- Centre d'aide Anthropic, Comment Claude marque le contenu généré par IA, 2026
- OpenAI, Comprendre la source de ce que nous voyons et entend en ligne, mai 2024
- Google DeepMind, SynthID
- Dathathri et al., Filigranage scalable pour identifier les sorties de grands modèles de langage, Nature, octobre 2024
- Google, Annonce du détecteur SynthID, mai 2025
- Hugging Face, Présentation de SynthID Text, octobre 2024
- Kirchenbauer et al., Un filigrane pour les grands modèles de langage, ICML 2023
- Krishna et al., La reformulation élude les détecteurs de texte généré par IA, NeurIPS 2023
- Scott Aaronson, Mon cours sur la sécurité de l'IA pour UT Effective Altruism, novembre 2022
- Union européenne, AI Act, article 50
- C2PA, Coalition pour la provenance et l'authenticité des contenus
Dana est créatrice de contenu chez ProofreaderPro, où elle gère le blog et les opérations de rédaction quotidiennes. Elle rédige les articles sur le fonctionnement de la plateforme d'édition en ligne et traite quotidiennement les messages des clients, avec un score de satisfaction de cinq étoiles à afficher.