
Humaniseur d’IA pour les chercheurs bangladais qui rédigent en anglais
Humaniseur d’IA pour les chercheurs bangladais. Réduisez les faux signaux de détection d’IA sur un anglais influencé par le bengali : conservez le sens et les citations, et faites une divulgation honnête.

La Bangladesh se classe au 54e rang mondial pour la production de recherche, et fait partie des producteurs de recherche les plus dynamiques en Asie. Ses chercheurs ont comptabilisé 18 613 publications en 2025, soit une hausse de 20,76 % qui a dépassé à la fois l’Inde et le Pakistan. Derrière ce chiffre se trouvent 51 704 titulaires de doctorat et 55 universités publiques, le tout sous pression pour publier dans des revues internationales en anglais.
Voici le piège dont peu de gens vous avertissent. Le Bangladesh obtient 506 points à l’EF English Proficiency Index, au sein de la tranche « Faible maîtrise », et le bengali (bangla) diffère de l’anglais au niveau structurel. Un humaniseur d’IA pour les chercheurs bangladais existe pour une raison bien réelle : un anglais seconde langue, soigneusement standard, est désormais lu à tort comme du texte généré par des détecteurs d’IA. Cette méprise entraîne des rejets de bureau, très concrets, pour des auteurs bien réels.
Ce guide porte sur l’équité, non sur le déguisement. Nous avons conçu notre humaniseur pour protéger votre propre écriture, vos propres résultats et vos propres citations, afin qu’un score de probabilité ne puisse pas supplanter silencieusement un article qui vous a demandé des mois de travail.
Humaniseur d’IA pour les chercheurs bangladais (humanizer for Bangladeshi researchers)
L’humaniseur d’IA aide les chercheurs bangladais à publier dans des revues internationales en anglais, tout en conservant le sens et les citations intacts. (Our AI humanizer helps Bangladeshi researchers publish in international English-language journals while keeping meaning and citations intact.)
Si vous rédigez à l’Université de Dacca, à la BUET, ou dans l’une des 110 universités privées du pays, le goulot d’étranglement de la rédaction est bien réel. Vous produisez une recherche solide, vous traduisez le raisonnement en anglais, puis vous faites face à un second lecteur que vous n’avez jamais choisi : un détecteur automatisé d’IA. Notre humaniseur s’intercale entre votre brouillon final et ce détecteur, en lissant les schémas mécaniques d’une prose non native soignée, sans toucher à votre argument.
Il prend en charge le bengali (বাংলা) et plus de 60 autres langues, en acheminant le texte non anglais via un modèle sensible à la langue, qui préserve la structure des phrases ainsi que la terminologie technique.
Rédiger en bengali ? L’humaniseur le détecte et le réécrit aussi
Tous les brouillons ne commencent pas en anglais, et l’humaniseur n’en a pas besoin. Collez du texte en bengali : ProofreaderPro reconnaît le script de lui-même, puis l’achemine vers un modèle sensible à la langue qui conserve votre terminologie et vos citations telles qu’elles sont écrites. En tant qu’এআই হিউম্যানাইজার, il réécrit directement votre prose bengalie, afin que vous puissiez humaniser avant de traduire, plutôt qu’après. La même logique de détection couvre plus de soixante langues, chacune réécrite comme elle-même.
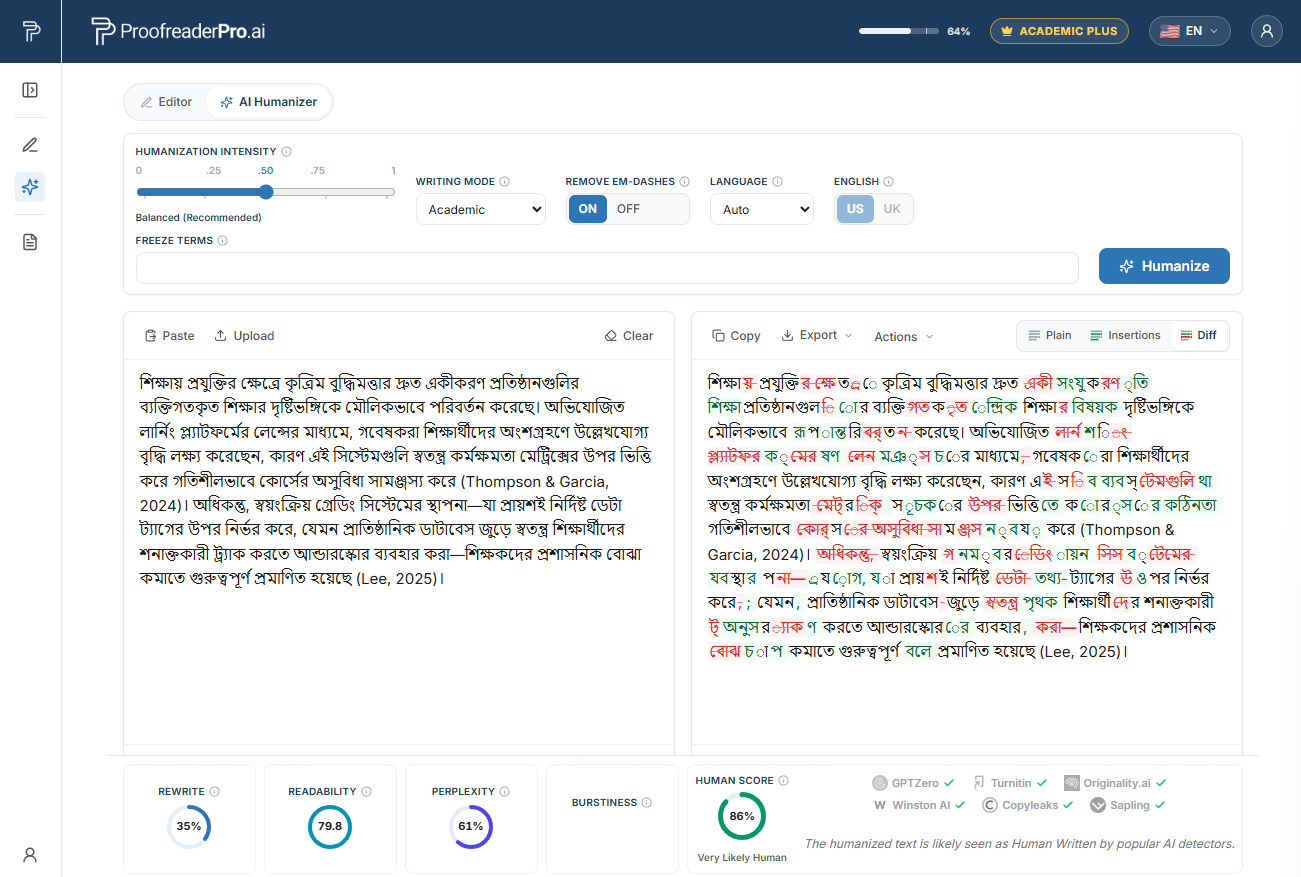
Le ProofreaderPro AI Humanizer réécrit un texte académique bengali. La comparaison avant/après préserve le sens et les citations, tandis que les contrôles du détecteur confirment une lecture naturelle et humaine.
Pourquoi les chercheurs bangladais sont plus souvent signalés par les détecteurs d’IA
En 2023, des chercheurs de Stanford, menés par Weixin Liang, ont publié une étude dans la revue Cell Press Patterns intitulée « GPT detectors are biased against non-native English writers. » Ils ont soumis des essais TOEFL rédigés par des humains à sept détecteurs couramment utilisés. En moyenne, environ 61 % des essais non natifs ont été signalés comme étant de l’IA, contre environ 5 % pour des auteurs anglophones natifs. Près d’un essai sur cinq de rédacteurs non natifs, soit environ 19,8 %, a été signalé à l’unanimité par l’ensemble des détecteurs. Chaque essai a été rédigé par un humain.
La cause tient à une métrique appelée « perplexity » (perplexité). De nombreux détecteurs évaluent à quel point chaque choix de mot est « surprenant » pour un modèle de langue. Lorsque vous rédigez avec soin dans une langue seconde, vous privilégiez des mots courants et des formulations standard, prévisibles. Cela produit une faible perplexité, et une faible perplexité est lue comme du texte généré par une machine. Les habitudes qui rendent la prose académique bangladaise claire et correcte sont précisément celles que ces outils ont été entraînés à sanctionner.
Lisez le mécanisme complet dans notre article explicatif sur pourquoi les détecteurs d’IA signalent les auteurs non natifs en anglais. La version courte : un score de détecteur est une affirmation contestable, pas un verdict à accepter.
Les schémas du bengali comme langue première à l’origine des faux signaux
Le bengali est une langue indo-aryenne dont la structure diverge de l’anglais de manière bien documentée. Les schémas de transfert ci-dessous ne sont pas des indices d’un anglais faible. Ce sont des constructions systématiques et soigneusement établies ; et cette régularité même est ce que le détecteur interprète comme du texte à faible perplexité, de type « machine ».
Gestion des articles. Le bengali ne possède aucun système d’articles : pas d’équivalent direct de « the », « a » ou « an ». Les recherches sur l’écriture bengali-anglais montrent que l’omission d’articles explique environ 30,93 % des erreurs et l’insertion inutile environ 26,25 %, soit, à deux, plus de la moitié de toutes les erreurs grammaticales. Lorsqu’un auteur corrige trop en adoptant un motif d’articles uniforme et bien rangé, la prose devient statistiquement lisse : exactement la surface que les détecteurs associent à du texte généré.
Prépositions issues du transfert des postpositions. Le bengali place des particules après le nom (par exemple, « tebiler upore » correspond à « table on-top-of »). Les auteurs standardisent alors les prépositions anglaises d’une manière constante et « sûre ». La cohérence est une bonne grammaire, et, malheureusement, aussi un signal de faible perplexité.
Résidu de l’ordre SOV. Le bengali suit un ordre Sujet-Objet-Verbe (« Ami boi porlam » signifie « I book read »). Les auteurs avancés atténuent l’affichage explicite du SOV, mais compensent par un rythme de propositions régulier et mesuré. Cette régularité « aplatit » la burstiness que les détecteurs attendent d’une prose humaine.
Schémas de la copule. Le bengali omet souvent la copule (par exemple, « Se shikkhok » constitue une phrase complète pour « She is a teacher »). Les auteurs qui s’entraînent à insérer systématiquement chaque « is », « are », « was » et « were » tendent à produire des structures de phrases uniformes, propres comme des cadres de manuels ; elles sont, là encore, lues comme prévisibles par un modèle.
Chacun de ces éléments correspond à une écriture correcte et délibérée. Le problème ne vient pas de votre anglais. Le problème, c’est un détecteur qui confond minutie et automatisation.
Contexte de la détection d’IA et de Turnitin au Bangladesh
Les thèses, mémoires et soumissions de revues au Bangladesh sont fréquemment soumis à Turnitin ou à iThenticate, à la fois pour détecter la similarité et pour repérer des indicateurs d’IA. Dans le cadre du dispositif d’avancement de l’Université (UGC, University Grants Commission), le corps enseignant doit publier de manière régulière dans des revues indexées Scopus et Web of Science ; ainsi, la plupart des chercheurs passent ces contrôles à répétition au fil de leur carrière, et non une seule fois.
Il est utile de savoir à quel point ces scores d’IA sont déjà contestés. En 2023, Vanderbilt a désactivé le détecteur d’IA de Turnitin, invoquant des faux positifs et un biais contre les auteurs non natifs. Michigan State, UT Austin, Northwestern, Pittsburgh, SMU et Waterloo ont pris des mesures similaires. De son côté, Turnitin réduit la visibilité des scores dans la plage de 1 à 19 % (en affichant un astérisque plutôt qu’un nombre) et avertit que son score ne devrait pas être utilisé seul pour des décisions d’intégrité.
Aucun de ces points ne signifie qu’un signal est inoffensif. Un superviseur ou un éditeur peut tout de même agir sur un signal. Cela veut dire que la bonne réponse consiste d’abord à rendre une rédaction non native soignée moins susceptible d’être mal lue, puis à divulguer votre usage de l’IA de manière ouverte, plutôt que de débattre après coup.
Protégez vos recherches du Bangladesh contre les faux signaux AI
Humanisez votre brouillon assisté par l’IA, conservez votre intention et vos citations, puis divulguez votre utilisation de l’IA comme votre revue le demande. Testé contre les principaux détecteurs, avec une grande précision grammaticale.
Essayez gratuitement le HumanizerGrandes universités du Bangladesh et où apparaissent les contrôles d’IA
La production de recherche se concentre sur un ensemble relativement restreint d’institutions, toutes soumises aux critères d’avancement fondés sur la publication de l’UGC, et toutes procédant au filtrage des thèses et des manuscrits pour la similarité et les indicateurs d’IA.
- Université de Dacca (DU / ঢাকা বিশ্ববিদ্যালয়), Dhaka. La plus ancienne université et la mieux classée, forte en sciences naturelles, pharmacie et sciences sociales.
- Bangladesh University of Engineering and Technology (BUET / বুয়েট), Dhaka. L’institution d’ingénierie de référence : leader en génie civil, électrique, informatique et chimique.
- BRAC University, Dhaka. Une université privée de premier plan, avec une production solide en santé publique, études de développement et informatique.
- North South University, Dhaka. La première université privée du pays, avec une recherche en croissance en commerce, ingénierie et sciences de la santé.
- University of Rajshahi, Rajshahi. La deuxième plus ancienne université (fondée en 1953), solide en sciences appliquées, agriculture et sciences humaines.
- University of Chittagong, Chittagong. Une grande université publique, forte en sciences marines, sylviculture et sciences sociales.
- Jahangirnagar University, Savar, Dhaka. Connue pour la recherche sur la biodiversité, la physique et les mathématiques.
- Khulna University of Engineering and Technology (KUET), Khulna. Production d’ingénierie en croissance dans les domaines du génie civil, mécanique et électrique.
- Bangladesh Agricultural University (BAU), Mymensingh. L’institution de recherche agricole de référence : leader en sciences des cultures, médecine vétérinaire et pêche.
- Daffodil International University, Dhaka. Une université privée à forte production, active dans l’informatique, l’ingénierie et les sciences de la santé.
- Chittagong University of Engineering and Technology (CUET), Chittagong. Recherche en ingénierie solide, avec un réseau de collaboration internationale en croissance.
- American International University-Bangladesh (AIUB), Dhaka. Une université privée avec une production notable en ingénierie, informatique et sciences économiques.
Dans chacune de ces institutions, la même réalité s’impose : votre manuscrit passe un contrôle d’IA avant qu’un humain ne décide de sa suite. Protéger une écriture soignée à cette étape est une nécessité pratique, et non un raccourci.
Comment fonctionne l’humaniseur d’IA pour les chercheurs bangladais
L’humaniseur d’IA pour les chercheurs bangladais suit un processus, et l’ordre compte.
D’abord, rédigez. Si votre raisonnement coule plus naturellement en bengali, écrivez-le en bengali puis traduisez, ou rédigez directement en anglais avec l’aide d’un assistant IA pour franchir la barrière de la page blanche. Ensuite, relisez la grammaire : un humaniseur n’est pas un correcteur grammatical. Troisièmement, faites passer votre prose assistée par IA dans le text humanizer. Il varie le rythme et le choix des mots, brise la cadence répétitive et supprime les tirets cadratin isolés, tout en préservant votre sens, votre terminologie technique et chaque citation exactement comme elles sont écrites.
Notre humaniseur transforme le texte généré par IA en une forme humaine plus naturelle, lisible comme humaine dans Turnitin, Originality.ai et GPTZero, tout en conservant une grande précision grammaticale pour les textes académiques. Nous ne garantissons pas ces résultats, mais ils proviennent de tests. Veuillez noter que les détecteurs se réentraînent toutes les quelques mois : nous ne promettons donc jamais « 100 % indétectable » et nous ne présentons pas cela comme une méthode pour contourner quoi que ce soit.
Puis vient l’étape qui vous maintient dans les règles : divulguez votre usage de l’IA dans le format exigé par votre institution et votre revue cible. Humaniser votre propre brouillon pour survivre à un détecteur biaisé est légitime. Cacher un travail fabriqué ne l’est pas, et ce n’est pas l’objectif de cet outil. C’est le même principe que celui derrière l’édition académique pour les chercheurs bangladais, la contrepartie éditoriale de ce guide, et il s’inscrit dans notre plus vaste hub d’humanisation d’IA multilingue qui couvre des chercheurs dans des dizaines de pays.
Organismes de financement locaux, revues et attentes en matière de divulgation de l’IA
Au Bangladesh, le financement de la recherche passe principalement par la University Grants Commission (UGC), par des subventions internes et des cellules de recherche à l’université, par la Bangladesh Academy of Sciences et par des partenaires internationaux de développement. Le ministère de l’Éducation et le ministère des Sciences et de la Technologie encouragent tous deux la publication internationale dans le cadre de la stratégie de développement Vision 2041, même si les dépenses nationales en R&D restent inférieures à 0,5 % du PIB. Lorsque les budgets sont aussi contraints, chaque rejet de bureau fondé sur la langue gaspille des financements rares ; c’est précisément pour cela que la protection linguistique est une mesure d’efficacité, et non un luxe.
Côté revues, le Bangladesh abrite un paysage en expansion, indexé via BanglaJOL (Bangladesh Journals Online), qui recense 142 revues nationales. Parmi les titres marquants figurent le Journal of Health, Population, and Nutrition (classé Q1, la revue la plus à fort impact du pays), le Journal of Naval Architecture and Marine Engineering (Q2, publié par BUET), Bangladesh Journal of Pharmacology, Bangladesh Journal of Medical Science, le Journal of Bangladesh Academy of Sciences et le Dhaka University Journal of Science. En parallèle, les cibles internationales indexées au titre des critères de l’UGC demeurent Scopus et Web of Science.
Les financeurs et les revues demandent de plus en plus aux auteurs d’indiquer s’ils ont utilisé des outils d’IA, et comment. Traitez cette demande comme normale et répondez clairement. Une ligne de divulgation explicite, associée à un brouillon humanisé qui se lit comme celui du chercheur attentif que vous êtes, constitue la combinaison qui vous aide à la fois à rester crédible et à respecter les règles. Si un signal est malgré tout déclenché, notre humaniseur conserve la trace claire dont vous avez besoin pour répondre, et vous pouvez faire passer chaque révision dans le text humanizer sans que des frais s’accumulent au mot.
Foire aux questions
Q : L’humaniseur d’IA pour les chercheurs bangladais aide-t-il mon article à passer Turnitin ?
Testé sur les principaux détecteurs, notre humaniseur réécrit les textes générés par IA sous une forme plus naturelle et humaine, ce qui réduit le signal d’IA et améliore ses chances face à des détecteurs plus stricts. Ce sont des résultats de tests, pas des garanties : les détecteurs se réentraînent toutes les quelques mois. L’objectif est d’empêcher que l’anglais soigneusement influencé par le bengali soit mal lu, et non de promettre un score fixe.
Q : L’utilisation d’un humaniseur d’IA sur mon propre brouillon est-elle considérée comme de la triche ?
Non, tant que vous humanisez votre propre écriture assistée par IA, en conservant vos résultats et vos citations réels, puis en divulguant votre usage de l’IA comme l’exigent votre institution et votre revue. L’outil est conçu pour protéger une écriture authentiquement non native contre les détecteurs biaisés, et non pour dissimuler un travail fabriqué ou emprunté.
Q : L’humaniseur va-t-il modifier mes citations ou mes termes techniques ?
Non. Il préserve votre sens, votre terminologie propre à votre discipline et vos références (APA, MLA, Chicago, IEEE) exactement comme vous les avez écrites. Il varie le rythme et le choix des mots et supprime la cadence répétitive, de sorte que l’argument reste le vôtre tout en se lisant de manière plus naturelle.
Q : Pourquoi les chercheurs bangladais sont-ils davantage signalés que les locuteurs natifs ?
Une étude de Stanford (2023) a révélé que les détecteurs signalent environ 61 % des essais non natifs rédigés par des humains comme étant de l’IA, contre environ 5 % pour les rédacteurs natifs, parce que la prose soignée en seconde langue a une faible perplexité. Des caractéristiques du bengali, comme une grammaire sans articles et des formulations régulières standardisées, rendent votre écriture prévisible pour un modèle ; le détecteur s’y trompe en l’interprétant comme de l’automatisation.
Q : L’humaniseur fonctionne-t-il pour des textes rédigés en bengali ?
Oui. Il prend en charge le bengali (বাংলা) et plus de 60 langues via un modèle sensible à la langue. Si vous rédigez en bengali puis traduisez en anglais, ou si vous écrivez directement en anglais avec de l’aide de l’IA, vous pouvez humaniser le résultat tout en conservant intactes la structure et le sens.
Conservez votre intention et vos citations, lissez les schémas non natifs soignés qui déclenchent les détecteurs AI, puis divulguez votre utilisation de l’IA. Testé contre Turnitin, GPTZero et Originality.ai, avec une grande précision grammaticale.

Moe est un ingénieur NLP avec un PhD en traitement du langage naturel. Ses recherches portent sur la linguistique informatique, l'analyse de texte et l'apprentissage automatique, et elles ont directement alimenté les modèles d'édition et d'humanisation derrière ProofreaderPro. Il écrit sur la partie du processus que la plupart des gens ne voient jamais : comment un modèle de langage lit une phrase, la note et décide quoi changer.


