
انسانساز هوش مصنوعی برای پژوهشگران چکی که به انگلیسی مینویسند
انسانساز هوش مصنوعی برای پژوهشگران چکی. برای انگلیسیِ تحتتأثیر زبان چکی، هشدارهای خطای تشخیص هوش مصنوعی را کاهش دهید؛ معنا و استنادها را حفظ کنید و صادقانه شفافسازی کنید.

چکیا بیش از وزن خود میدرخشد. کشوری کوچک با یک پایگاه پژوهشی بزرگ، جایگاه واقعی بینالمللی در فیزیک، شیمی، علوم مواد و علوم زیستی دارد؛ بخش بزرگی از این جایگاه بهواسطه «آکادمی علوم چک» (Czech Academy of Sciences) پشتیبانی میشود. تقریباً همهٔ این کارها به جهان در زبان انگلیسی میرسد، حتی اگر بیشتر آنها در زبان چکی اندیشیده و نخست پیشنویس شوند.
این فاصله میان زبانی که با آن استدلال میکنید و زبانی که در آن منتشر میکنید دقیقاً همانجایی است که دردسر شروع میشود. «انسانساز هوش مصنوعی» برای پژوهشگران چکی دلیل روشنی دارد: انگلیسیِ دقیق و درستِ نوشتهشده توسط یک دانشمند چکی اکنون توسط سامانههای تشخیص خودکار، بهعنوان متنِ ماشینی خوانده میشود، و یک «پرچمِ اشتباه» روی یک مقالهٔ پاک میتواند برای شما هزینهای جدی داشته باشد، از ارسال مقاله گرفته تا نمره و حتی اعتباری که سالها برای ساختنش صرف کردهاید.
بخش ناخوشایند ماجرا این است. عادتهایی که انگلیسیِ چک-محور را بهاندازهای روشن و قابل انتشار میکند، عبارات استاندارد، واژگان رایج، و الگوهای قابل پیشبینیِ جمله، همان عادتهایی هستند که یک «تشخیصدهندهٔ هوش مصنوعی» دقیقاً برای مشکوکدیدن آنها آموزش دیده است.
Humanizace AI textu pro české výzkumníky publikující v angličtině
انسانسازی متنِ هوش مصنوعی ما به پژوهشگران چکی کمک میکند تا در انگلیسی منتشر کنند، بدون آنکه کارِ دقیقِ آنها بهنادرستی توسط سامانههای تشخیص، «نوشتهشده با ماشین» برچسب بخورد. هدف این است که معنا، اصطلاحات تخصصی و استنادها حفظ شوند.
به زبان ساده: ابزار ما روی انگلیسیای کار میکند که از پیش نوشتهاید یا با کمک هوش مصنوعی پیشنویس کردهاید، استدلال و منابع شما را دستنخورده نگه میدارد و آهنگ متن را بازشکل میدهد تا احتمال خطای تشخیصدهنده کمتر شود. این ابزار برای پژوهش واقعی ساخته شده است، نه برای پنهانکردن کاری که انجام ندادهاید. میتوانید آن را قبل از اعتماد به یک نسخهٔ کامل از مقاله، روی انسانساز ما با یک پاراگراف از نوشتهٔ خودتان امتحان کنید.
آیا نوشتن به زبان چک است؟ به طور خودکار تشخیص داده میشود و مستقیماً انسانیسازی میگردد
پژوهشگران چکی اغلب پیش از ورود به انگلیسی، در زبان اول خود پیشنویس تهیه میکنند و انسانساز نیز دقیقاً برای همین طراحی شده است. متن چکی را جایگذاری کنید؛ ProofreaderPro زبان را بهطور خودکار تشخیص میدهد و سپس آن را از مسیر یک مدلِ آگاه از چکی عبور میدهد؛ بهطوریکه «háček» و دیگر نشانههای اعراب، اصطلاحات شما و استنادها دقیقاً سر جای خود باقی میمانند. از طریق humanizace AI textu، پیشنویس چکی شما به همانقدر آسانی که متن انگلیسی انسانسازی میشود انسانسازی میگردد، بدون آنکه ابتدا چیزی ترجمه شود. این تشخیص بیش از شصت زبان را پوشش میدهد و هر متن در صدای خودش بازنویسی میشود.
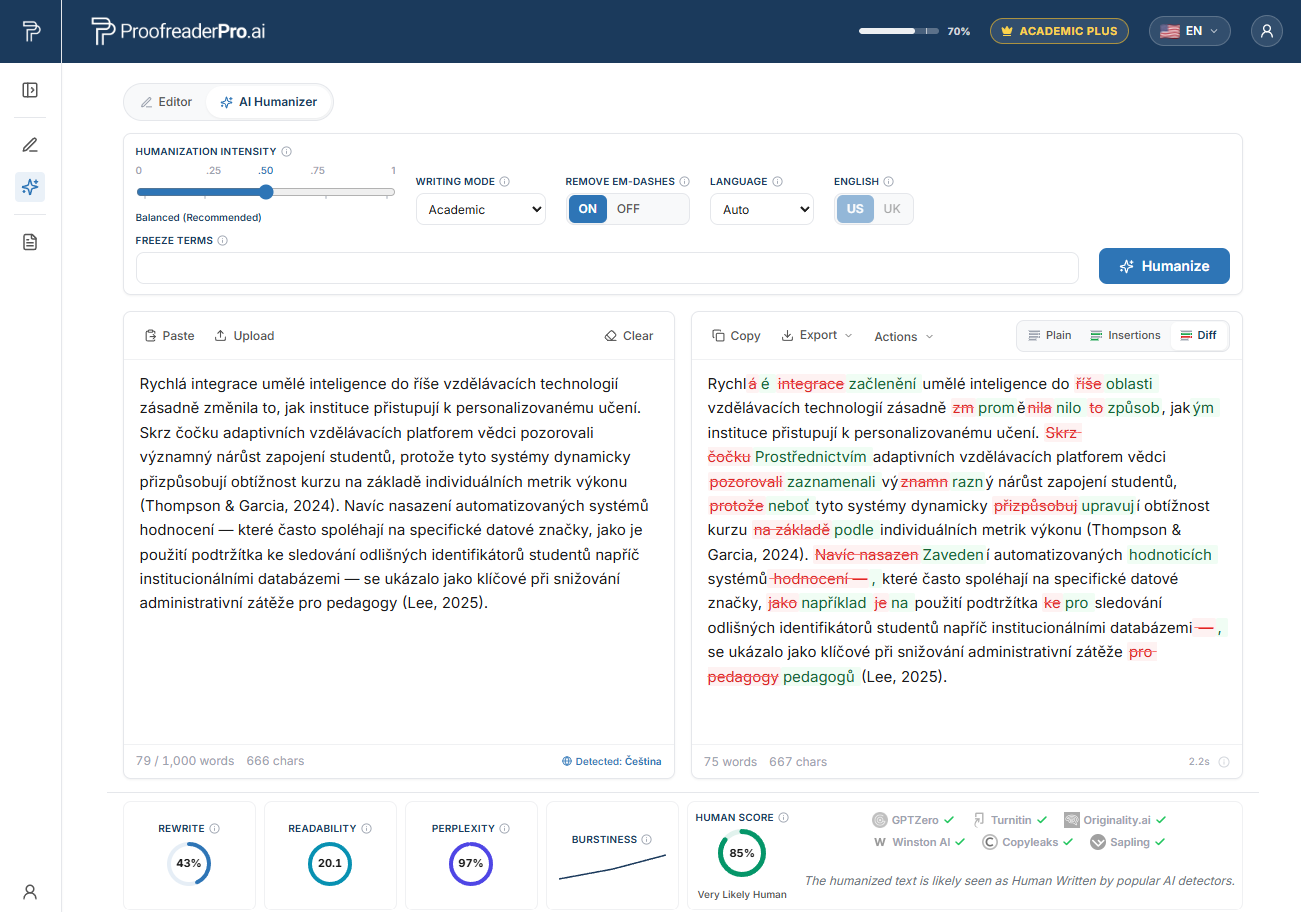
ProofreaderPro AI Humanizer در حال بازنویسی متن آکادمیک چکی. تفاوت «قبل و بعد» معنا و استنادهای شما را حفظ میکند و بررسیهای تشخیص، خوانش طبیعی و انسانی را تأیید میکند.
چرا پژوهشگران چکی توسط سامانههای تشخیص هوش مصنوعی پرچم میخورند
در سال 2023، تیمی در استنفورد به رهبری Weixin Liang مطالعهای را در ژورنال Patterns (منتشرشده توسط Cell Press) با عنوانی منتشر کرد که همهچیز را میگوید: "GPT detectors are biased against non-native English writers." پژوهشگران مقالههای TOEFL را که کاملاً توسط انسان نوشته شده بود برداشتند و آنها را از میان هفت تشخیصدهندهٔ هوش مصنوعیِ پرکاربرد عبور دادند.
نتیجه باید برای هر کسی که انگلیسی را بهعنوان زبان دوم مینویسد نگرانکننده باشد. بهطور میانگین، حدود 61% از مقالههای غیربومی بهعنوان متن تولیدشده توسط هوش مصنوعی پرچم شدند؛ در حالی که این رقم برای مقالههای نویسندگان انگلیسیزبان بومی حدود 5% بود. تقریباً از هر پنج مقالهٔ غیربومی، یکی (حدود 19.8%) توسط تکتک تشخیصدهندهها بهصورت همزمان (بهطور یکصدا) پرچم شد. هیچیک از این متنها توسط ماشین نوشته نشده بود.
مکانیسم «perplexity» نام دارد. بسیاری از تشخیصدهندهها نمره میدهند که انتخاب هر کلمه چقدر برای یک مدل زبانی «غیرمنتظره» است. یک نویسندهٔ مطمئنِ بومی ریسک میکند، از اصطلاحات رایج استفاده میکند و عباراتی را بهکار میگیرد که مدل برایش غیرقابلپیشبینی است؛ همین امر خوانش «انسانی» ایجاد میکند. پژوهشگر دقیقِ چکی برعکس عمل میکند: کلمهٔ امن را انتخاب میکند، ساختار استاندارد را بهکار میبرد و قالب جملهای را تکرار میکند که در همهٔ کلاسهای انگلیسی آموخته شده است. این احتیاط، perplexity پایین تولید میکند و perplexity پایین همان چیزی است که یک تشخیصدهنده آن را «متن ماشینی» میخواند. ما مکانیسم کامل را در اینجا توضیح میدهیم که چرا تشخیصدهندههای هوش مصنوعی نویسندگان غیربومی را پرچم میزنند.
الگوهای زبان اول چکی پشتِ «پرچمهای اشتباه»
چکی و انگلیسی از نظر دستور زبان تفاوتهایی دارند و جاهایی که با هم ناسازگارند، ردهایی در انگلیسی شما برجای میگذارند. هیچیک از اینها خطاهایِ ناشی از فکرِ نادرست نیستند. آنها ردهای قابل پیشبینی و استانداردِ ذهنِ یک نویسندهٔ چکیاند که انگلیسیِ دقیق مینویسد، و همین منظمبودنِ آنهاست که تشخیصدهنده را به perplexity پایین امتیازدهی میکند.
مقالههایی که ظاهر میشوند و ناپدید میشوند. در چکی «the» یا «a» وجود ندارد. مقالههای انگلیسی حذف، اضافه یا جابهجا میشوند، بنابراین شما مینویسید «result was significant» یا «we performed the analysis of the data». وقتی یک ویرایشگر اینها را مرتب میکند، جملههای پیرامون اغلب حتی استانداردتر از قبل میشوند؛ و این بهجای کاهش، ریسک پرچم شدن را بالا میبرد.
Aspect بهجای tense. دستور زبان چکی بر «جنبهٔ کامل/ناکامل» (perfective و imperfective aspect) استوار است، نه بر نظام «زمان دستوری» انگلیسی. خروجیِ «گذشتهٔ کامل» در برابر «گذشتهٔ ساده» ناسازگار درمیآید و نسخهٔ اصلاحشده معمولاً به سمت متداولترین انتخاب زمان دستوری میجهد؛ همان چیزی که یک مدل انتظارش را دارد.
ترتیب واژگان که تأکید را حمل میکند. چکی بر «پسوندهای حالت/حرف اضافهٔ اسمی» برای معنا و بر «ترتیب واژگان» برای برجستهسازی (استرس/تأکید) تکیه دارد؛ بنابراین ساختار اطلاعرسانی در انگلیسی ممکن است ناموزون منتقل شود. وقتی این موارد در انگلیسیِ استانداردِ فاعل-مفعول-فعل نرمسازی میشوند، جمله دقیقاً همان غیرقابلپیشبینیای را از دست میدهد که تشخیصدهنده آن را «انسانی» میخواند.
اسمهای قابلشمارش که جمع بسته میشوند. "Informations"، "researches"، "an advice"، "evidences". اینها در چکی منطقیاند و در پیشنویسهای چکی-انگلیسی رایج. و وقتی عبارتها یکدست اصلاح میشوند، دقیقاً در همان رژیستر/دامنهای مینشینند که تشخیصدهندهها برایش آموزش دیدهاند.
حرف اضافهها و نبودِ یار فعلهای کمکی. حرف اضافهها دقیقاً از چکی منتقل میشوند و حرف کمکی «do» یا «does» در سؤالها و جملات منفی حذف میشود. وقتی این ساختارها اصلاح میشوند، تمیز و عمومی به نظر میرسند، و دقیقاً همین پروفایل است که به عنوان perplexity پایین خوانده میشود.
زمینهٔ تشخیص هوش مصنوعی و Turnitin در چکیا
تزها و ارسالهای ژورنالی در چکیا بهطور روتین هم برای «شباهت» و هم برای «متنِ تولیدشده توسط هوش مصنوعی» غربال میشوند. بسیاری از دانشگاههای چکی یک زیرساخت ملی مشترک دارند: سامانههای Theses.cz و Odevzdej.cz که توسط Masarykova univerzita هماهنگ میشوند و Turnitin نیز در کنار آنها بهطور گسترده استفاده میشود.
نهادهای چکی دستورالعملهای خودشان را دربارهٔ هوش مصنوعی مولد منتشر کردهاند و جهت حرکت روشن است: تأمینکنندگان بودجه و ژورنالها بهطور فزاینده از شما انتظار دارند افشا کنید چگونه از هوش مصنوعی استفاده کردهاید. این فضا منطقی است. مشکل، افشا نیست، چیزی آسان و صادقانه. مشکل جایی است که نمرهٔ یک تشخیصدهنده مثل یک «حکم» با شما رفتار میکند، در حالی که در واقع یک حدس آماری است که غالباً دقیقاً روی همان نثرِ دقیقِ غیربومیِ چکی که پژوهشگران آموزش میبینند تولید شود، خطا میکند.
کمک میکند به یاد بیاورید حتی خودِ فروشندگان تشخیصدهنده هم محافظهکارانه عمل میکنند. Turnitin نمرههای خودش را در بازهٔ پایین سرکوب میکند و هشدار میدهد که یک عدد نباید بهتنهایی برای تصمیم دربارهٔ سلامت/یکپارچگی استفاده شود. چند دانشگاه، از جمله Vanderbilt، حتی یک قدم جلوتر رفتند و تشخیصدهندهٔ هوش مصنوعی را بهطور کامل خاموش کردند و به «مثبتهای کاذب» و سوگیری علیه نویسندگان غیربومی اشاره کردند. یک پرچم، ادعایی برای به چالش کشیدن است، نه اعتراف.
نگارش انگلیسیِ چکی خود را در برابر پرچم گذاری های نادرست AI محافظت کنید
یک پاراگراف از نثر پژوهشی خود را بارگذاری کنید و ببینید چگونه Humanizer معنا و استنادات شما را حفظ می کند و در عین حال احتمال اینکه یک آشکارساز، انگلیسی دقیقِ غیر بومی را نادرست تفسیر کند، کاهش می دهد.
نسخه رایگان Humanizer را امتحان کنیدبرترین دانشگاههای چکی و اینکه بررسیهای هوش مصنوعی کجا ظاهر میشوند
اگر در چکیا تحصیل میکنید، تدریس میکنید یا مقاله ارسال میکنید، کار شما از یکی از این نهادها عبور خواهد کرد و همهٔ آنها هم برای شباهت و هم بهطور فزاینده برای نشانههای هوش مصنوعی، تزها و دستنوشتهها را غربال میکنند.
- Univerzita Karlova (Charles University)، پراگ
- České vysoké učení technické v Praze (ČVUT, Czech Technical University)، پراگ
- Masarykova univerzita (Masaryk University)، برنو
- Univerzita Palackého v Olomouci (Palacký University)، اولوموک
- Vysoké učení technické v Brně (VUT, Brno University of Technology)، برنو
- Vysoká škola chemicko-technologická v Praze (VŠCHT, University of Chemistry and Technology)، پراگ
- Vysoká škola báňská, Technická univerzita Ostrava (VŠB-TUO)، اُستراوا
- Mendelova univerzita v Brně (Mendel University)، برنو
- Jihočeská univerzita v Českých Budějovicích (University of South Bohemia)، České Budějovice
- Univerzita Pardubice، Pardubice
میزان ریسک بسته به نوع سند متفاوت است. یک دستنوشتهٔ ژورنالی ردشده، ماهها برای شما هزینه دارد. یک تز که در Univerzita Karlova یا Masarykova univerzita پرچم بخورد میتواند جلسۀ استماع را فعال کند؛ جلسهای که در آن اعتبار شما، نه دستور زبانتان، به محکمه میرود. این گفتوگوی اشتباه است که دربارهٔ یک مثبتِ کاذب داشته باشید.
نحوهٔ کار انسانساز هوش مصنوعی برای پژوهشگران چکی
روند کاریِ صادقانه ساده است و شفافسازی در مرکز آن قرار دارد، نه در حاشیه.
از جایی شروع کنید که قویتر هستید. اگر بهترین طرز فکر شما این است که ابتدا در چکی پیشنویس تهیه کنید، همان کار را انجام دهید؛ سپس ترجمه کنید یا با کمک هوش مصنوعی مستقیماً در انگلیسی پیشنویس بسازید. ابتدا علم را درست کنید. بعد دستور زبان را اصلاح کنید تا معنا دقیق باشد. تنها پس از آن، متن را از مسیر انسانساز هوش مصنوعی برای پژوهشگران چکی عبور دهید؛ ابزار آهنگ و انتخاب واژگان را تغییر شکل میدهد تا انگلیسیِ دقیق و استاندارد شما کمتر توسط یک تشخیصدهنده اشتباه خوانده شود، در حالی که معنا، اصطلاحات و استنادهای شما دقیقاً همانطور که نوشتهاید باقی میمانند.
چه انتظاری میتوانید داشته باشید؟ در آزمونهای خود ما، انسانساز بهطور قابل توجه دفعاتی را که انگلیسیِ دقیقِ غیربومی توسط تشخیصدهندههای اصلی، از جمله Turnitin، Originality.ai و GPTZero، اشتباه خوانده میشود کاهش میدهد، بدون اینکه استدلال شما تغییر کند. ما این را «آنچه در آزمون دیدهایم» توصیف میکنیم، نه بهعنوان یک وعده. تشخیصدهندهها هر چند ماه یکبار بازآموزی میشوند و هیچ ابزار صادقی نمیتواند قول بدهد 100% غیرقابلتشخیص است. هر کسی که چنین تضمینی میدهد، دارد چیزی را به شما میفروشد.
متنهای غیرانگلیسی نیز در اینجا اهمیت دارد. چون انسانساز از بیش از 60 زبان پشتیبانی میکند و متنهای غیرانگلیسی را از مسیر یک مدلِ آگاه به زبان عبور میدهد، میتوانید روی پیشنویسهای چکی یا یادداشتهای دو/چندزبانه کار کنید، بدون اینکه ابزار ساختار جمله را تخت و یکدست کند. این بخش درونِ هاب انسانساز هوش مصنوعی چندزبانهٔ ما قرار دارد و بهصورت طبیعی با ویرایشِ عملی از هاب ویرایش آکادمیک جهانی ما جفت میشود، وقتی یک مقاله به نگاهِ انسانی هم نیاز داشته باشد.
سپس مرحلهای میآید که کل ماجرا را صادقانه نگه میدارد: استفادهٔ خود از هوش مصنوعی را با فرمتی که نهاد آموزشی و ژورنال هدف شما میخواهد، افشا کنید. انسانسازی پیشنویس خودتان، نوشتار روشن را از یک برچسب ناعادلانه محافظت میکند. افشای روش، شما را داخل چارچوب قوانین نگه میدارد. هر دو را انجام میدهید و چیزی برای پنهان کردن ندارید.
نهادهای تأمین مالی محلی، ژورنالها و انتظارات افشای هوش مصنوعی
بودجهٔ پژوهش در چکیا عمدتاً از سه نهاد میگذرد و هرکدام بهطور فزاینده شفافیت دربارهٔ استفاده از هوش مصنوعی را انتظار دارند. GAČR (Grantová agentura České republiky, the Czech Science Foundation) پژوهش پایه را تأمین مالی میکند. TAČR (Technologická agentura České republiky, the Technology Agency) پژوهش کاربردی را پوشش میدهد. AV ČR (Akademie věd České republiky, the Czech Academy of Sciences) نهادهای ملی را اداره میکند؛ جایی که بخش بزرگی از خروجی کشور از همانجا سرچشمه میگیرد.
در سمت انتشار هم، فشارها در یک جهت است. ارزیابی ملی و بودجههای سازمانی، خروجی در ژورنالهای نمایهشده در Web of Science و Scopus را پاداش میدهد و نتایج در ثبت ملی اطلاعات R&D، یعنی RIV گزارش میشود. این پاداش، انتشارِ انگلیسیزبان را تقویت میکند، و همان حلقهٔ شما را مستقیم به مشکل «پرچمِ کاذب» برمیگرداند؛ مشکلی که این مقاله با آن شروع شد.
به یاد بیاورید که اعداد خودشان دربارهٔ این سد چه میگویند. سخنگویان غیرانگلیسیزبان نرخ رد شدنشان حدود 2.5 برابر بیشتر از بومیهاست، تقریباً 51% زمان بیشتری صرف نوشتن مقالههایشان و حدود 91% زمان بیشتری صرف خواندن آنها میکنند و حدود 12.5 برابر درخواستِ بازنگری مرتبط با کیفیت زبان دریافت میکنند. کمتر از 7% از ژورنالها حتی بهطور کلی پذیرای ارسالهای غیرانگلیسی هستند. نظام از پژوهشگران چکی میخواهد در انگلیسی رقابت کنند، سپس انگلیسیِ دقیقِ تولیدشده توسط این رقابت را مجازات میکند. انسانسازی پیشنویس خودتان، حفظ استنادها و افشای روش، پاسخِ عادلانه به یک چیدمان ناعادلانه است، نه راهی دور زدن آن. از انسانساز بهعنوان یکی از ابزارها در همین روند کاریِ صادقانه استفاده کنید.
پرسشهای متداول
س: آیا استفاده از یک انسانساز هوش مصنوعی برای پژوهشگران چکی نوعی تقلب محسوب میشود؟
نه، وقتی صادقانه از آن استفاده میکنید. شما ریتمِ پیشنویسِ کمکگرفته با هوش مصنوعیِ خودتان را بازشکل میدهید، معنا و استنادها را حفظ میکنید و سپس استفادهٔ خود از هوش مصنوعی را همانطور که نهاد آموزشی و ژورنال لازم میدانند افشا میکنید. این یعنی «ویرایش زبانی» همراه با شفافیت، نه فریب. فقط زمانی مشکل ایجاد میشود که بخواهید کاری را که انجام ندادهاید جا بزنید یا از استفادهای که از شما خواسته شده اعلام کنید، پنهانکاری کنید.
س: آیا انسانساز اصطلاحات فنی یا استنادهای مرا تغییر میدهد؟
نه. این ابزار ساخته شده تا معناهای آکادمیک، اصطلاحات تخصصی و نشانگرهای ارجاع را حفظ کند، در حالی که ریتم جمله و انتخاب واژگان را متغیر میسازد. شیمی شما شیمی میماند و استنادها در جای خود باقی میمانند. با این حال باید نسخهٔ نهایی را هم ویرایش/بازبینی کنید، چون همچنان نویسندهٔ مسئولِ هر کلمه هستید.
س: آیا میتوانید تضمین کنید مقالهٔ من Turnitin یا GPTZero را رد نمیکند/پاس میکند؟
نه، و باید به هر کسی که این را تضمین میکند بیاعتماد باشید. تشخیصدهندهها دائماً بازآموزی میشوند، بنابراین هیچ ابزار صادقی نمیتواند قول بدهد 100% غیرقابلتشخیص است. آنچه میشود گفت این است که در آزمونهای ما، انسانسازی انگلیسیِ دقیقِ غیربومی بهطور قابل توجه باعث میشود دفعاتی که تشخیصدهندههای اصلی آن را اشتباه میخوانند کمتر شود، در حالی که معنا دستنخورده میماند.
س: چرا انگلیسی-چکیِ درستِ من از همان ابتدا پرچم میخورد؟
چون نوشتنِ دقیق در زبان دوم معمولاً perplexity پایین دارد. شما کلمههای امن و ساختارهای استاندارد انتخاب میکنید و تشخیصدهندهها این پیشبینیپذیری را بهعنوان متنِ تولیدشده توسط ماشین تفسیر میکنند. مطالعهٔ استنفورد نشان داد مقالههای نوشتهشده توسط انسان اما با انگلیسیِ غیربومی، بسیار بیشتر از مقالههای نویسندگان بومی پرچم میشوند؛ و همین نشان میدهد سوگیری در تشخیصدهنده است، نه در نوشتار شما.
س: آیا هنوز هم باید به دانشگاه یا ژورنالمان بگویم که از هوش مصنوعی استفاده کردهام؟
بله، هر زمان که از شما بخواهند، و بهطور فزاینده بیشتر هم میخواهند. انسانسازی پیشنویس یعنی انصاف، نه پنهانکاری؛ پس نقطهٔ اصلی افشا است نه پیدا کردن راهگریز. روشن بگویید در مرحلهٔ پیشنویسسازی و ویرایش چگونه از هوش مصنوعی استفاده کردهاید و در چارچوب درستِ هم قوانین یکپارچگی و هم وجدان خود میمانید.
پرچم گذاری های نادرست AI را برای انگلیسیِ چکیِ دقیق کاهش دهید، در حالی که معنا، اصطلاحات و استنادات را حفظ می کنید، سپس استفاده از AI را با اعتماد به نفس افشا کنید.

Moe یک مهندس NLP با PhD در پردازش زبان طبیعی است. تحقیقات او زبانشناسی محاسباتی، تجزیه و تحلیل متن و یادگیری ماشین را پوشش میدهد و مستقیماً به مدلهای ویرایش و انسانیسازی پشت ProofreaderPro وارد میشود. او در مورد بخشی از فرآیند می نویسد که اکثر مردم هرگز نمی بینند: چگونه یک مدل زبان جمله ای را می خواند، آن را نمره می دهد و تصمیم می گیرد چه چیزی را تغییر دهد.


