
انسانساز هوش مصنوعی برای پژوهشگران مجارستانی که به انگلیسی مینویسند
انسانساز هوش مصنوعی برای پژوهشگران مجارستانی. کاهش هشدارهای کاذبِ تشخیص هوش مصنوعی در انگلیسیِ تحتتأثیر مجارستانی؛ بدون تغییر معنا و استنادات، و با افشای صادقانه.

مجارستان در علم بیش از وزن جمعیتیاش میدرخشد. کشوری با کمتر از ده میلیون نفر جمعیت، توانسته است مجموعهای چشمگیر از ریاضیدانان، فیزیکدانان، شیمیدانان و دانشمندان علوم زیستی پرورش دهد؛ و این سنت هنوز هم در خروجی دانشگاههای این کشور دیده میشود. کارها اما به زبان انگلیسی نوشته میشوند. تقریباً هر پژوهشگری در بوداپست یا سگد ابتدا در ذهنش مجارستانی مینویسد و میاندیشد، سپس استدلال را به زبانی دوم منتقل میکند که تقریباً هیچیک از دستور زبان آن را ندارد. دقیقاً همین فاصله ترجمه است که «انسانسازِ هوش مصنوعی برای پژوهشگران مجارستانی» جایگاه خود را پیدا میکند، چون انگلیسیِ دقیقِ مجارستانی-انگلیسی اکنون بهعنوان متنِ ماشینی خوانده میشود.
بخش ناخوشایند ماجرا اینجاست. هرچه انگلیسیتان پاکتر و استانداردتر باشد، احتمال پرچمزنیِ یک سامانه تشخیص هوش مصنوعی بیشتر میشود. مدلی که متن را بر اساس این امتیاز میسنجد که هر کلمه تا چه حد «غیرمنتظره» است، عبارتپردازیِ منضبط و قابلپیشبینی شما را بهعنوان نشانهای از نویسندگیِ ماشینی تلقی میکند. پاداشی که برای نوشتنِ روشن در زبان دومِ دشوار میگیرید، یک اتهامِ نادرست است.
ما انسانسازمان را برای همین مسئله ساختیم: محافظت از کار واقعیِ پژوهشگران واقعی، نه پنهان کردن میانبُرهای هیچکس. این راهنما توضیح میدهد انسانساز چگونه در یک فرایند انتشار صادقانه برای پژوهشگران مجارستانی جا میگیرد.
انسانسازیِ متنِ مبتنی بر هوش مصنوعی برای پژوهشگران مجارستانی
انسانسازیِ متنِ مبتنی بر هوش مصنوعی یعنی متنی که با کمکِ هوش مصنوعی نوشته شده، با حفظ معنا، اصطلاحات تخصصی و ارجاعات، ریتمی انسانیتر پیدا کند. Our tool is built for Hungarian academics who draft in their own language and then publish in English.
نکته این نیست که چیزی را استتار کنیم. نکته این است که یک جمله انگلیسیِ دقیق و استاندارد که توسط یک پژوهشگر مجارستانی نوشته شده نباید صرفاً به این دلیل مشکوک تلقی شود که دقیق و استاندارد است. این «پرچمِ کاذب» همان چیزی است که humanizer متنی برای کاهش آن طراحی شده است.
پیشنویس را به مجارستانی مینویسید؟ انسانساز آن را مستقیم تشخیص میدهد و بازنویسی میکند
میتوانید یک پیشنویس مجارستانی را بدون ترجمه کردن به انگلیسیِ پیش از آن «انسانسازی» کنید. متنتان را وارد کنید و ProofreaderPro زبان را بهطور خودکار تشخیص میدهد، سپس آن را از مسیر یک مدلِ آگاه به زبان مجارستانی عبور میدهد؛ مدلی که به مصوتهای کشیده، صورتهای الحاقی (agglutinated) و ارجاعات داخل متن شما احترام میگذارد. انسانسازیِ AI-szöveg ریتمِ نثر مجارستانی را تغییر میدهد، اما هر اصطلاح و هر ارجاع را دستنخورده نگه میدارد. تشخیص خودکار از بیش از شصت زبان پشتیبانی میکند، بنابراین مجارستانی بهعنوان مجارستانی در نظر گرفته میشود، نه اینکه به شکل انگلیسیِ بازآراییشده تبدیل شود.
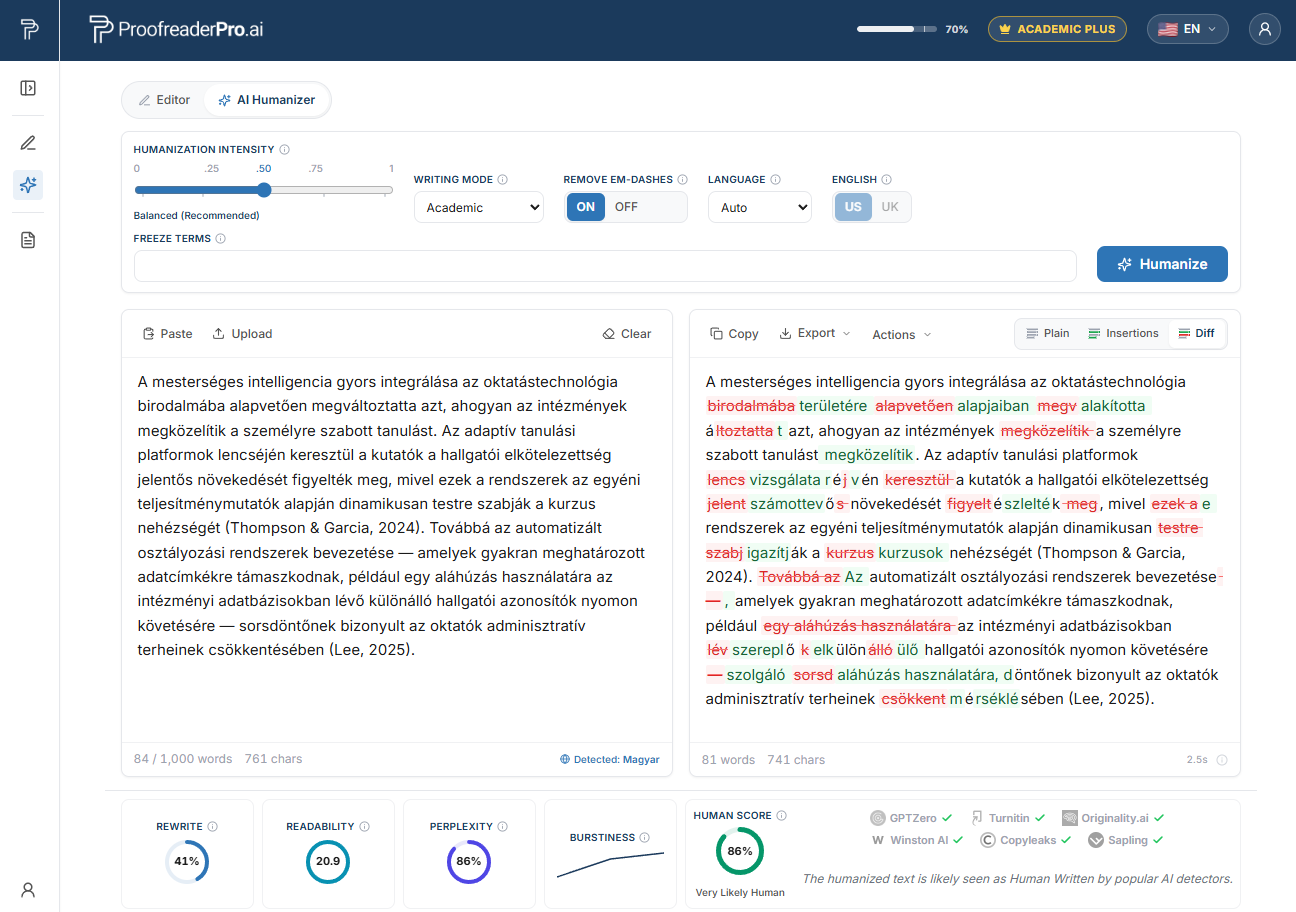
انسانساز هوش مصنوعی ProofreaderPro در حال بازنویسی متن آکادمیک مجارستانی. اختلافِ «قبل و بعد» معنا و استنادات شما را حفظ میکند و بررسیهای تشخیص، تأیید میکند که متن، خوانش طبیعیِ انسانی دارد.
چرا پژوهشگران مجارستانی توسط سامانههای تشخیص هوش مصنوعی پرچمزنی میشوند
در سال ۲۰۲۳، یک گروه پژوهشی در دانشگاه استنفورد به سرپرستی Weixin Liang، هفت تشخیصدهنده GPT رایج را روی مقالههایی که انسانها نوشته بودند آزمود. این مقالهها از آزمون TOEFL آمده بودند، بنابراین همه آنها نویسنده انسانی داشتند که اتفاقاً نویسندهای غیرمادریِ انگلیسی بود. به طور میانگین، حدود ۶۱٪ از این مقالهها بهعنوان تولیدشده توسط هوش مصنوعی پرچم خوردند. در مقالههای نوشتهشده توسط انگلیسیزبانانِ بومی، این رقم حدود ۵٪ بود. نزدیک به یکپنجم از مقالههای غیرمادری، حدود ۱۹.۸٪، توسط همهٔ تکتکِ تشخیصدهندهها بهطور اتفاقی و یکصدا پرچم خورد.
این را دوباره بخوانید. نوشتار انسانی، بیش از ده برابر بیشتر از حالت معمول پرچم میخورد؛ صرفاً چون انگلیسی زبان دومِ نویسنده بود.
سازوکار این موضوع را «حیرتپذیری» (perplexity) مینامند. بسیاری از تشخیصدهندهها تخمین میزنند انتخابهای واژگانی شما برای یک مدل زبانی تا چه حد قابل پیشبینی است. وقتی در یک زبان دوم مینویسید، به سراغ گزینههای امن، رایج و درست میروید؛ چون این همان کاری است که نویسندگان دقیق انجام میدهند. «امن و رایج» یعنی حیرتپذیری پایین، و حیرتپذیری پایین دقیقاً همان اثرانگشتی است که این ابزارها برای خواندن بهعنوان متنِ ماشینی آموزش دیدهاند. ما سازوکار کامل را در چرا تشخیصدهندههای هوش مصنوعی نویسندگان غیرمادری را پرچم میزنند باز میکنیم، اما نسخه کوتاهش بیرحمانه است: عادتهایی که نثر شما را روشن میکنند همان عادتهایی هستند که آن را پرچم میزنند.
الگوهای زبان اولِ مجارستانی پشتِ پرچمهای کاذب
مجارستانی یک زبان اورالی است که با زبانهای هندواروپاییِ پیرامون خود نسبت ندارد و منطق آن واقعاً با انگلیسی متفاوت است. همین تفاوت ردهایی در نوشتار مجارستانی-انگلیسی باقی میگذارد. هیچیک از این ردها خطای هوش نیستند. سایهٔ یک دستور زبان کاملاً متفاوتاند و وقتی در انگلیسیِ تمیز و یکدست صاف میشوند، برای یک تشخیصدهنده تخت و قابلپیشبینی به نظر میرسند.
یک ضمیر برای he و she. مجارستانی یک ضمیر سومشخصی دارد و از نظر دستوری جنسیت ندارد؛ بنابراین «he» و «she» در انگلیسی جابهجا میشوند. نویسندگانی که این موضوع را اصلاح میکنند معمولاً گزینهٔ امنتر را بیش از حد به کار میبرند یا جملهها را حول «the author» و «the participant» بازسازی میکنند که نتیجهاش نثری بسیار یکنواخت و با کمترین تغییرات است.
حالتدادنِ متفاوتِ مقالهها. مجارستانی از مقالهها استفاده میکند (a, az, egy)، اما آنها را با منطقی متفاوت از انگلیسی جای میدهد. مقالههای معرفه (definite) و نکره (indefinite) حذف یا اضافه میشوند و اصلاحِ دقیق معمولاً همان مقالهٔ رایج و استانداردِ کتابهای درسی است که هر بار انتخاب میشود. «استاندارد» دقیقاً همان چیزی است که نمرهای شبیه متنِ ماشینی تولید میکند.
الحاقگرایی و نامسازیِ سنگین. مجارستانی معنا را با انباشتن پسوندها بر یک ریشه میسازد. وقتی این عادت به انگلیسی منتقل میشود، به صورت عبارات اسمیِ متراکم و زنجیرههای طولانیِ نامسازیشده درمیآید («the implementation of the optimisation of...») که هم از نظر دستوری کاملاً درستاند و هم از نظر ریتم یکنواخت و تکنوا. تشخیصدهندهها شیفتگی خاصی به یکنواختی دارند.
ترتیب کلماتِ برجستهمحورِ موضوع. مجارستانی موضوع و کانونِ توجهِ جمله را پیشِ چشم قرار میدهد، بنابراین تأکید در جایی مینشیند که برای خوانندهٔ انگلیسی انتظارش را ندارد. وقتی نویسنده این را به انگلیسیِ ساده با ترتیب رایجِ فاعل-مفعول-فعل (subject-verb-object) نرمال میکند، نتیجه درست، مرتب و قابلپیشبینی میشود.
نداشتنِ نشانگر زمانِ آینده و یک سامانهٔ متفاوتِ وجه (aspect). مجارستانی آینده را به شکل دیگری علامتگذاری میکند و وجه را هم به شیوهٔ خاص خودش مدیریت میکند؛ بنابراین انتخابهای زمان در انگلیسی بهصورت نامنظم بیرون میآید و سپس به سمت خنثیترین و رایجترین زمان اصلاح میشود. بار دیگر، امنترین زمان همان زمان با کمترین حیرتپذیری است.
پسحروف اضافه به جای پیشحروف اضافه. مجارستانی نشانههای رابطهای را بعد از اسم میآورد، و همین باعث لغزشهای مربوط به preposition در انگلیسی میشود. اصلاح این لغزشها یعنی هر بار سراغ همان پیشحرف اضافهٔ استاندارد رفتن، و «استاندارد» چیزی است که یک تشخیصدهنده آن را تولیدشده تلقی میکند.
رومانیایی-انگلیسی دقیق خود را از خطاهای نادرست محافظت کنید
پیش نویس خود را که با کمک AI تهیه کرده اید انسانی تر کنید، همه استنادها، اصطلاحات و یافته ها را بدون تغییر نگه دارید، سپس با اطمینان، ابزارهای خود را افشا کنید.
نسخه رایگان Humanizer را امتحان کنیدبافتِ تشخیص هوش مصنوعی در مجارستان و Turnitin
پایاننامهها و ارسالهای مقاله از نهادهای مجارستانی بهطور روتین برای شباهت متنی غربال میشوند؛ اغلب با Turnitin یا یک سامانهٔ مشابه، و نشانههای هوش مصنوعی بهطور فزاینده در همان غربالگری ادغام میشوند. اینک بخشی عادی از فرایند دفاع از دکتری و بررسی دستنوشته است، نه یک قدم استثنایی.
بد نیست محدودیتهای این ابزارها را هم در نظر داشته باشید. چند دانشگاه بزرگ خارج از کشور، از جمله Vanderbilt، تشخیصدهندهٔ نوشتنِ مبتنی بر هوش مصنوعیِ Turnitin را به دلیل موارد مثبتِ کاذب و بایاس علیه نویسندگان غیرمادری خاموش کردهاند، و خودِ Turnitin نیز پایینترین نمرههایش را سرکوب میکند و هشدار میدهد که تعدادِ آنها هرگز نباید بهتنهایی یک پروندهٔ سلامتِ علمی (integrity) را تعیین کند. نمرهٔ یک تشخیصدهنده یک ادعاست که اجازه دارید آن را به چالش بکشید، نه یک حکم.
نهادهای مجارستانی راهنماییهای خود را دربارهٔ هوش مصنوعیِ مولد منتشر کردهاند، و تأمینکنندگان مالی و مجلات بهطور فزاینده انتظار دارند نویسندگان افشا کنند که این ابزارها چگونه استفاده شدهاند. پاسخِ صادقانه پنهان کردن چیزی نیست. هدف این است که مسئولانه بنویسید و ویرایش کنید، سپس ابزارهایی را که به آنها تکیه کردهاید اعلام کنید.
دانشگاههای بزرگ مجارستان و اینکه بررسیهای هوش مصنوعی کجا دیده میشود
غربالگری برای شباهت و نشانههای هوش مصنوعی در سراسر نظام آموزش عالی مجارستان دیده میشود؛ از مدارس دکتری تا دفاتر ویراستاری مجلات. مؤسسههای زیر در میان پژوهشمحورترینهای کشور هستند و پایاننامهها و دستنوشتههایشان از این بررسیها عبور میکند:
- Eötvös Loránd Tudományegyetem (Eötvös Loránd University, ELTE)، بوداپست
- Semmelweis Egyetem (Semmelweis University)، بوداپست؛ یک دانشکدهٔ پزشکی بزرگ
- Szegedi Tudományegyetem (University of Szeged)، سگد
- Debreceni Egyetem (University of Debrecen)، دبْرِسن
- Budapesti Műszaki és Gazdaságtudományi Egyetem (Budapest University of Technology and Economics, BME)، بوداپست
- Budapesti Corvinus Egyetem (Corvinus University of Budapest)، بوداپست
- Pécsi Tudományegyetem (University of Pécs)، پچ
- Pázmány Péter Katolikus Egyetem (Pázmány Péter Catholic University)، بوداپست
- Óbudai Egyetem (Óbuda University)، بوداپست
چه کارتان پایاننامهای باشد که در ELTE از آن دفاع میشود، چه یک دستنوشتهٔ بالینی از Semmelweis، همان الگو برقرار است: انگلیسیِ مجارستانی-انگلیسیِ استاندارد و دقیق، متنی است که احتمال بیشتری دارد پرچمِ مبتنی بر perplexity را فعال کند.
انسانساز هوش مصنوعی برای پژوهشگران مجارستانی چگونه کار میکند
فرایندی که ما پیشنهاد میکنیم ساده است و مهمتر از آن، صادقانه. این فرایند سه مرحله دارد.
نخست، پیشنویس. مقالهتان را همانطور بنویسید که سریعترین راه برای منتقل کردنِ فکر شما به صفحه است. برای بسیاری از پژوهشگران مجارستانی، این یعنی پیشنویس را به مجارستانی بنویسند و سپس ترجمه کنند، یا مستقیم به انگلیسی با کمکِ هوش مصنوعی بنویسند. هر کدام باشد، قابل قبول است.
دوم، جوهره را ویرایش میکنیم. دستور زبان، اصطلاحات و استدلال را اصلاح کنید تا علم درست باشد. اگر خودِ زبان نیاز به یک بازخوانی دقیق داشته باشد، مرکز ویرایش آکادمیک سراسری ما این بخش را پوشش میدهد.
سوم، پیشنویسِ خودتان را انسانسازی کنید. اینجاست که humanizer متنی وارد میشود. طول جمله و ریتم را متغیر میکند، یکنواختیِ کادنسِ مونوتونِ نثر مجارستانی-انگلیسیِ الحاقگرا را میشکند و آن خطچینها (em dash) و ساختارهای تکراریِ پراکنده را که هم ابزارهای هوش مصنوعی و هم عادتهای زبانِ دوم از پشت سر میگذارند حذف میکند. نکتهٔ کلیدی این است که معنا، واژگان تخصصی و هر استناد شما را حفظ میکند. متنهای منبعِ غیرانگلیسی از مسیر یک مدلِ آگاه به زبان عبور میکند و ابزار از بیش از شصت زبان پشتیبانی میکند.
این به چه چیزی میانجامد؟ در آزمونهای خودمان، انسانسازیِ یک پیشنویسِ دقیقِ غیرمادری بهطور چشمگیری دفعاتی را که تشخیصدهندههای اصلی آن را بهعنوان نوشتهٔ ماشینی اشتباه میخوانند کاهش میدهد، در حالی که معنای آکادمیک حفظ میشود. ما این را بهعنوان چیزی که «در آزمونهای خود دیدهایم» توصیف میکنیم، نه بهعنوان یک وعده. هیچ ابزار صادقی نمیتواند اینجا نتیجه را تضمین کند، چون تشخیصدهندهها هر چند ماه یک بار دوباره آموزش میبینند و هر سرویسی که ادعا کند «صددرصد غیرقابل تشخیص» است، چیزی را به شما میفروشد که قادر به تحویل آن نیست.
مرحلهٔ آخر: افشا. یک بیانیهٔ استفاده از هوش مصنوعی با فرمت موردنیاز دانشگاه و ژورنال هدف اضافه کنید. انسانسازیِ نوشتهٔ مبتنی بر هوش مصنوعیِ خودتان و سپس اعلام آن، یک ترفند نیست. یعنی کاری میکنید تا تلاشِ دقیق شما بر اساس ارزشهای واقعیاش قضاوت شود، نه اینکه به خاطر «جرمِ روشن بودن در زبان دوم» پرچم بخورد. برای تصویر گستردهتر دربارهٔ زبان در کشورهای مختلف، به هاب انسانساز چندزبانهٔ هوش مصنوعی ما مراجعه کنید.
نهادهای تأمین مالی محلی، مجلات، و انتظارهای افشای استفاده از هوش مصنوعی
پژوهش رقابتی در مجارستان عمدتاً از طریق NKFIH (Nemzeti Kutatási, Fejlesztési és Innovációs Hivatal, the National Research, Development and Innovation Office) تأمین مالی میشود؛ و MTA (Magyar Tudományos Akadémia, the Hungarian Academy of Sciences) بهعنوان آکادمی ملی و HUN-REN (the Hungarian Research Network) که مؤسسههای عمومی پژوهشی را اداره میکند. همهٔ آنها خروجی منتشرشده و نمایهشده را پاداش میدهند، و همین باعث میشود فشار یکنواختی روی پژوهشگران برای انتشار به انگلیسی حفظ شود.
این خروجی در مجلاتِ نمایهشده در Web of Science و Scopus سنجیده میشود و در MTMT (Magyar Tudományos Művek Tára, the Hungarian Scientific Bibliography) ثبت میگردد؛ پایگاه دادهٔ ملیِ انتشار. فرهنگ ارزیابی پاداش نشر بینالمللی و انگلیسیزبان میدهد، و این دقیقاً همان فشاری است که پژوهشگران مجارستانی را به سمت نثر پاک، استاندارد و صیقلی سوق میدهد؛ نثری که تشخیصدهندهها آن را به اشتباه میخوانند.
انتظار میرود افشای استفاده از هوش مصنوعی در گزارشهای گرنت و همچنین ارسال مقاله به مجلات رایجتر شود. آن را یک رویهٔ عادی بدانید. شفاف بگویید از کدام ابزار استفاده کردهاید و چگونه، دادهها و استنادات را صادقانه نگه دارید، و از محدودهٔ قوانین با خیال راحت عبور میکنید؛ در حالی که متن خودتان را در برابر پرچمهای ناعادلانه دفاع میکنید.
پرسشهای متداول
س: آیا انسانساز هوش مصنوعی برای پژوهشگران مجارستانی، استنادات یا اصطلاحات فنی مرا تغییر میدهد؟
خیر. انسانساز طوری ساخته شده است که معنا، اصطلاحات تخصصیِ مرتبط با رشته شما، و هر ارجاع را دقیقاً همانطور که نوشتهاید حفظ کند. ریتم و عبارت را تغییر میدهد، نه علم یا منابع شما.
س: آیا هر ابزار دیگری میتواند تضمین کند مقالهام از هر تشخیصدهندهٔ هوش مصنوعی عبور میکند؟
نه، و باید به هر کسی که چنین ادعایی دارد بیاعتماد باشید. تشخیصدهندهها بهطور منظم دوباره آموزش میبینند، بنابراین هیچ خدمت صادقانهای نمیتواند قول دهد که «۱۰۰٪ غیرقابل تشخیص» است. چیزی که میتوانیم بگوییم این است که در آزمونهای خودمان، انسانسازیِ نثر دقیقِ غیرمادری بهطور قابل توجهی دفعاتی را که آن را اشتباه بهعنوان نوشتهٔ ماشینی میخوانند کاهش میدهد.
س: آیا انسانسازیِ پیشنویس خودم شکلی از تقلب است؟
اینطور نیست، به شرطی که شما روی نوشتهٔ مبتنی بر هوش مصنوعیِ خودتان کار میکنید، یافتهها را صادقانه نگه میدارید، و استفاده از ابزار را مطابق با الزام دانشگاه و ژورنال افشا میکنید. هدف، انصاف برای کارِ واقعی است، نه پنهانکاری.
س: چرا انگلیسیِ روشنِ من پرچمزنی میشود، وقتی نوشتار ضعیفتر اینطور نمیشود؟
چون بسیاری از تشخیصدهندهها بر «قابلپیشبینی بودن» امتیاز میدهند. نویسندگانِ دقیق در زبان دوم به سراغ ساختارهای امن، استاندارد و درست میروند؛ این یعنی متنِ دارای حیرتپذیری پایین تولید میشود و حیرتپذیری پایین دقیقاً همان الگویی است که این ابزارها آن را با نوشتهٔ ماشینی مرتبط میدانند. وضوح شما علیهتان کار میکند.
س: من ابتدا به مجارستانی مینویسم. آیا ابزار آن را مدیریت میکند؟
بله. متنهای غیرانگلیسی از مسیر یک مدلِ آگاه به زبان عبور میکند که ساختار جمله و معنا را در بیش از شصت زبان حفظ میکند؛ بنابراین میتوانید ابتدا به مجارستانی پیشنویس بنویسید، سپس ترجمه کنید، و بعد نسخهٔ انگلیسی را انسانسازی کنید، بدون اینکه استدلال خود را از دست بدهید.
پیش نویس دقیق خود که با کمک AI تهیه کرده اید، رومانیایی-انگلیسی را به نثر آکادمیک طبیعی تبدیل کنید، همه استنادها و یافته ها را حفظ کنید، سپس با اطمینان، استفاده از AI خود را افشا کنید.

Moe یک مهندس NLP با PhD در پردازش زبان طبیعی است. تحقیقات او زبانشناسی محاسباتی، تجزیه و تحلیل متن و یادگیری ماشین را پوشش میدهد و مستقیماً به مدلهای ویرایش و انسانیسازی پشت ProofreaderPro وارد میشود. او در مورد بخشی از فرآیند می نویسد که اکثر مردم هرگز نمی بینند: چگونه یک مدل زبان جمله ای را می خواند، آن را نمره می دهد و تصمیم می گیرد چه چیزی را تغییر دهد.


