واترمارک OpenAI، SynthID و Claude: مقایسه واترمارک های متنی
آیا متنِ OpenAI واترمارک می شود، آیا یک ابزار عمومیِ بررسی واترمارک OpenAI وجود دارد، و تفاوت واترمارک SynthID و واترمارک Claude چیست؛ مقایسه برای نویسندگان آکادمیک.
OpenAI، Google و Anthropic همگی فناوری مشابهی ساخته اند: یک واترمارک آماری برای متنِ تولیدشده توسط AI. OpenAI نسخه خود را سال ها نگه داشت و سرانجام در اکتبر 2026 آن را به صورت متنGrain منتشر و راه اندازی کرد. Google SynthID را داخل Gemini قرار داد و روش را منتشر کرد. Anthropic در آگوست 2026 واترمارک Claude را برای هر کاربر اجباری کرد. اگر با هر نوع کمک AI بنویسید، این سه تصمیم اکنون تعیین می کند که اسناد شما چگونه قضاوت می شوند.
واترمارکینگ از یک موضوع پژوهشی به خبر رایج تبدیل شد در 11 آگوست 2026، زمانی که Anthropic اعلام کرد هر مدل جدید Claude خروجی متنی خود را واترمارک می کند. ما این اعلام را در جزئیات در مقاله توضیح دهنده واترمارک Claude پوشش دادیم. این راهنما تصویر کامل را ارائه می دهد: واترمارک متنی چیست، هر یک از سه آزمایشگاه بزرگ آن را چگونه پیاده سازی یا پنهان کرده اند، و هر سامانه چه چیزی را درباره یک متن ثابت می کند.
واترمارک متنیِ AI چیست؟
واترمارک متنیِ AI یک الگوی آماریِ پنهان شده در گزینش های واژگانی متن تولیدشده است؛ الگو در لحظه تولید کاشته می شود تا بعدا یک تشخیص دهنده با داشتن کلید درست بتواند تأیید کند که متن از یک سامانه AI مشخص آمده است. این یک برچسبِ قابل مشاهده نیست، یک نویسه پنهان هم نیست، و یک فراداده متصل به فایل هم نیست. این نشان در خودِ واژه ها زندگی می کند.
این تفاوت مهم است، چون اصطلاح "واترمارک" به شکل سست برای سه چیز متفاوت به کار می رود:
| این چیست | کجا قرار دارد | آیا در کپی و پیست زنده می ماند؟ | |
|---|---|---|---|
| واترمارک آماری | سوگیری ای که باعث می شود مدل واژه ها را انتخاب کند | خودِ متن | بله |
| فراداده فایل (C2PA) | یک برچسبِ منشأِ دارای امضا | ظرفِ فایل | نه، کپی ساده به صورت متنی آن را از بین می برد |
| حروف با عرض صفر | یونیکد نامرئی داخل متن وارد می شود | بین نویسه های قابل مشاهده | نه، به شکل ساده و پیش پا افتاده حذف می شود |
واترمارک گذاری آماری تنها گزینه از میان این سه مورد است که در کپی، پیست، تایپ مجدد و تبدیل فرمت به یک سند جدید هم دوام می آورد. به همین دلیل هر سه آزمایشگاه بزرگ برای متن به آن رسیدند و به همین دلیل «حذف کننده های واترمارک» که حروف نامرئی را پاک می کنند، در برابر آن هیچ کاری نمی کنند. صفحه حذف کننده واترمارک Claude به صورت رایگان ماجرا و حالت شکست را با منابع توضیح می دهد.
واترمارک گذاری آماری عملا چگونه کار می کند؟
در هر مرحله از نوشتن یک جمله، یک مدل زبانی بین چندین واژه تقریبا هم ارز یکی را انتخاب می کند و humanizer به آرامی «تاس ها» را بارگذاری می کند. دستورالعمل پایه را Kirchenbauer و همکارانش در دانشگاه Maryland در ژانویه 2023 منتشر کردند، در A Watermark for Large Language Models (ICML 2023). این گونه کار می کند:
- قبل از انتخاب هر کلمه، یک کلید محرمانه که از کلمات پیشین استخراج شده است، واژگان را به دو مجموعه ترجیح داده شده و یک مجموعه خنثی تقسیم می کند.
- مدل انتخاب خود را به سمت مجموعه ترجیح داده شده سوق می دهد. «Suggest» به جای «indicate». «Across» به جای «among». هر انتخاب به صورت جداگانه کاملا طبیعی به نظر می رسد.
- یک آشکارساز که کلید را در اختیار دارد، می شمارد متن چند بار در مجموعه های ترجیح داده شده می افتد. نوشتار انسانی به صورت تصادفی به نرخ مورد انتظار می رسد. متن واترمارک شده خیلی بیشتر از حد انتظار به آن می رسد و یک آزمون آماری اختلاف را پرچم گذاری می کند.
هیچ یک از کلمات به تنهایی نشانه چیزی نیست. سیگنال فقط در میان ده ها یا صد ها انتخاب خودش را نشان می دهد. برای همین متن های طولانی تر برای آزمایش آسان ترند و برای همین تشخیص همیشه به صورت احتمالی است، نه یک برچسب بله یا خیر.
سامانه تولیدی Google DeepMind که در اکتبر 2024 در Nature با عنوان Scalable watermarking for identifying large language model outputs منتشر شد، آن را با روشی به نام tournament sampling اصلاح کرد؛ روشی که کیفیت متن را آنقدر خوب حفظ می کند که بتواند بی سر و صدا و در مقیاس بالا داخل یک محصول مصرفی اجرا شود. این مقاله فقط برای Google اهمیت ندارد. این همان مبنای منتشر شده ای است که Anthropic برای پیاده سازی Claude به آن اشاره می کند.
ضعف اصلی این بود که پیش از بیشتر استقرارها منتشر شده بود. در مارس 2023، Krishna و همکارانش در Paraphrasing evades detectors of AI-generated text (NeurIPS 2023) نشان دادند که بازنویسی واژگان یک بخش، تشخیص را در میان روش ها از هم می پاشد، واترمارک گذاری هم شامل آن است. سیگنال در توالی دقیق توکن ها زندگی می کند و هیچ جای دیگری. بنابراین هر چیزی که آن توالی را بازنویسی کند، حتی یک ویرایشگر انسانی، شواهد را از بین می برد. هر فروشنده ای که امروز واترمارک عرضه می کند، این محدودیت را در مستندات خودش ذکر می کند.
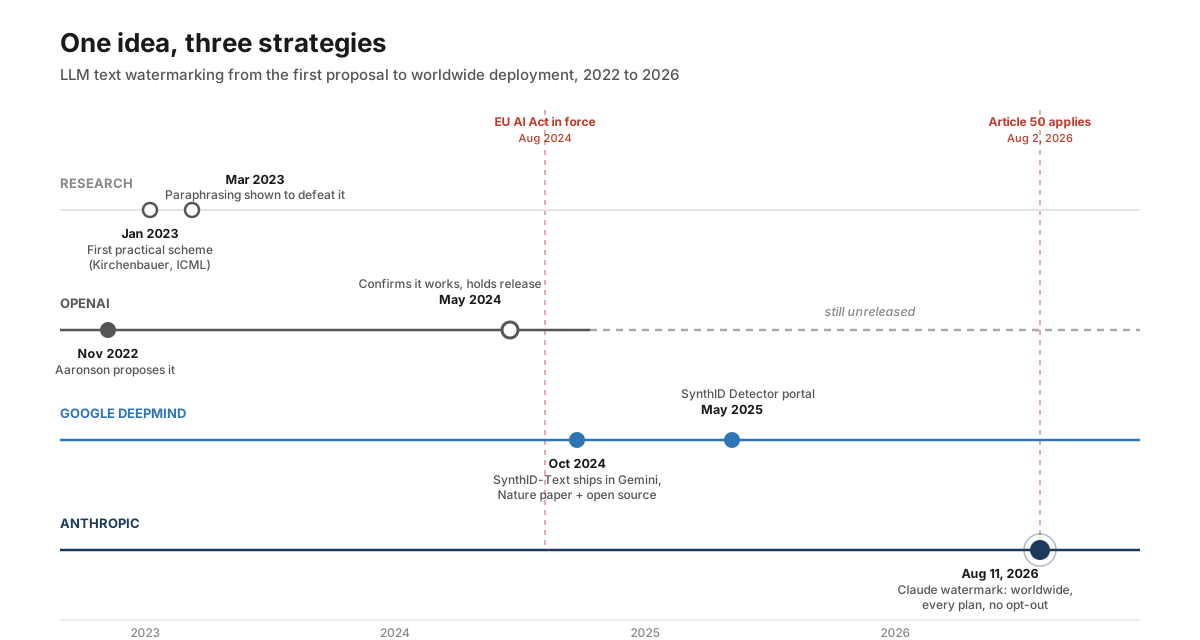
OpenAI: شرکت سازنده آن که آخرین بار آن را عرضه کرد
OpenAI سال ها یک واترمارک متنیِ عملیاتی داشت و تا اکتبر 2026 تصمیم نگرفت آن را منتشر کند. Scott Aaronson که در آن زمان روی ایمنی در OpenAI کار می کرد، نخست ایده را در عموم در یک سخنرانی نوامبر 2022 شرح داد. این روش انتخاب های مدل را بین واژه های تقریبا هم ارز با یک تابع رمزنگاری محرمانه بایاس می کند، بنابراین خودِ متن نشان می دهد منشاء آن کجا بوده است. این سخنرانی از هر سامانه ای که به کار گرفته شده قدیمی تر است.
در مه 2024، OpenAI در به روزرسانی منشأ (provenance) توضیح داد که وضعیت پروژه چگونه پیش میرود و منشأ آنچه را میبینیم و میشنویم آنلاین. این شرکت گفت روش نشانه گذاری متنی آن در ویرایشهای کوچک دقیق و مؤثر است، اما انتشار را نگه داشته بود تا پیامدهای مبادله را بسنجد. دو مورد از ریسکهایی که OpenAI نام برد، به طور مستقیم برای نویسندگان آکادمیک اهمیت دارد:
- دور زدن آسان. بازنویسی یا ترجمه متن، آن نشانه را حذف میکند، دقیقاً همانطور که پژوهش سال 2023 پیش بینی کرده بود. یک واترمارک که بیشتر افرادی را هدف قرار میدهد که نمیدانند چنین چیزی وجود دارد، ابزار اجرای ضعیفی است.
- تأثیر نامتناسب بر انگلیسی زبانان غیرمادری. OpenAI اعلام کرد که واترمارکینگ میتواند استفاده مشروع از AI را به عنوان کمک نوشتاری برای افرادی که در زبان دوم مینویسند، انگزنی کند. مقاله ما درباره چرا آشکارسازهای AI به نویسندگان غیرمادری برچسب میزنند همین مشکل را از زاویه آشکارسازها هم پوشش میدهد.
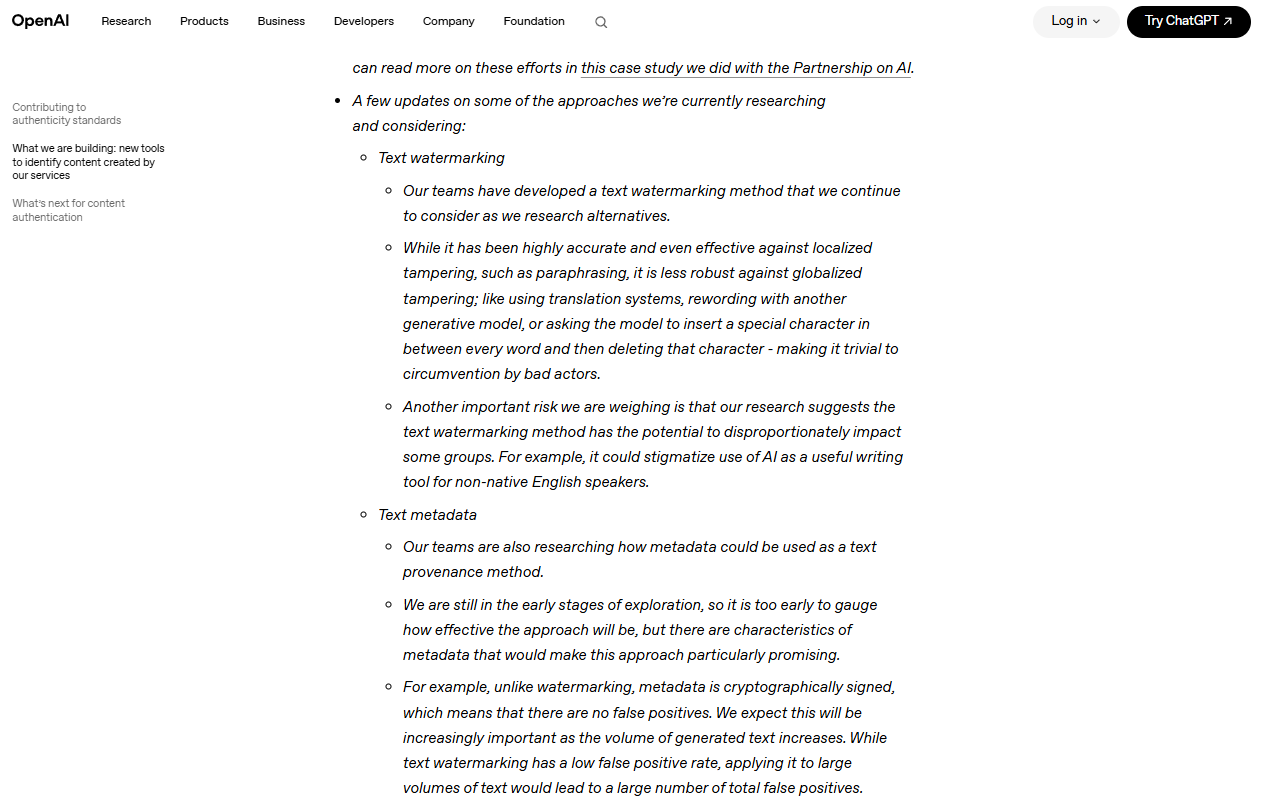
به روزرسانی منشأ 2024 OpenAI: این روش کار میکند، و شرکت فهرست میکند که چرا همان زمان انتشار را عقب انداخت.
برای تصاویر و صدا، OpenAI مسیر دیگری رفت: فراداده منشأ C2PA در خروجیهای DALL-E و Sora که برچسبی در سطح فایل است، نه یک نشانه داخل محتوا. برای متن، خروجی ChatGPT تا اکتبر 2026 واترمارک نداشت. شرکتی که این فناوری را پیشنهاد داد، آخرینِ این سه شرکت بود که آن را مستقر کرد.
آیا OpenAI اکنون متن را واترمارک میکند؟
بله، OpenAI از 5 اکتبر 2026 شروع کرد به واترمارک کردن بخشی از متن، در پاسخ به EU AI Act. این اعلامیه یک واترمارک متنی با نام textGrain معرفی میکند که یک سیگنال آماری نامرئی به انتخابهای واژگانی مدل اضافه میکند. رونمایی در سه بخش انجام میشود و واترمارک یک تنظیم پیش فرضِ فراگیر نیست:
- مشتریان API در هرجای دنیا میتوانند خروجی واترمارک شده را برای بعضی مدلها روشن کنند. این گزینه به صورت پیش فرض خاموش است.
- در هفتههای بعد، خروجی متنی واجد شرایط ChatGPT و Codex در اتحادیه اروپا واترمارک را دریافت میکند، در تمام پلنها.
- محققان تایید شده و سازمانهای متخصص میتوانند برای دریافت دسترسی به آشکارساز واترمارک متنی درخواست بدهند.
OpenAI میگوید textGrain با یا بهتر از روشهای دیگرِ آزمایش شدهاش تطابق داشته است، از جمله SynthID متنِ گوگل. همچنین جایی را منتشر کرد که در آن تشخیص ضعیفتر میشود. در نرخ خطای مثبت کاذب 1%، آشکارساز واترمارک را در حدود 80% از قطعههای 200 توکنی و حدود 95% از قطعههای 400 توکنی در محتوای حوزه روانشناسی شناسایی کرد. تشخیص برای ریاضیات خیلی پایینتر بود، چون آزادی در انتخاب واژه کمتر است.
ویرایش، سیگنال را سریع تضعیف میکند. در قطعههای 400 توکنی، جایگزین کردن 10% از کلمات با مترادفها تشخیص را از حدود 92% به 66% کاهش داد و جایگزین کردن 25% آن را به 17% رساند.
OpenAI همچنین بررسی کرده است که آیا واترمارک سیگنالِ پاسخها را روی Astra، جدیدترین مدلش، تغییر میدهد یا نه و میگوید تفاوت معناداری مشاهده نکرده است. اینها چهار نمونه از بنچمارکهایی هستند که منتشر کرده است:
| بنچمارک | بدون واترمارک (Astra) | با واترمارک (Astra) |
|---|---|---|
| شاخص هوشمندی مصنوعی Artificial Analysis Intelligence Index | 49.57 امتیاز | 49.76 امتیاز |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
برای دانشجویان، تاریخ مهم است. متن ChatGPT نوشته شده قبل از زمان انتشار، یا خارج از EU بدون تنظیم API، هیچ واترمارک OpenAI ندارد. راهنمای ما برای توضیح Turnitin Clarity توضیح میدهد مدارس در این فاصله چگونه سیاستهای خود درباره استفاده از AI را تنظیم میکنند.
آیا یک ابزار بررسی عمومیِ واترمارک OpenAI وجود دارد؟
هنوز هیچ ابزار بررسی عمومی از OpenAI برای متون وجود ندارد. ابزار رایگانِ ابزار راستی آزمایی محتوا را برای Content Credentials مبتنی بر C2PA و همچنین برای یک واترمارک SynthID بررسی می کند. OpenAI این واترمارک را در تصاویر و فایل های صوتی پشتیبانی شده جاسازی می کند. OpenAI می گوید این ابزار از متن پشتیبانی نمی کند.
برای متن، OpenAI دسترسیِ این بخشِ تشخیص را مورد به مورد و برای پژوهشگران تاییدشده و سازمان های تخصصی فراهم می کند؛ از طریق فرم فرم Content Provenance API. همچنین می گوید در زمان عرضه عمومیِ ابزارِ تشخیص، آن را عمومی نمی کند چون خطرِ از دست رفتن واترمارک ها و نیز خطای مثبت کاذب وجود دارد. این تشخیص می گوید آیا واترمارک OpenAI را پیدا کرده است یا نه، و نه هویت کاربر را مشخص می کند و نه پرامپت های او را نشان می دهد.
| آنچه می خواهید بررسی کنید | ابزار | چه کسانی می توانند از آن استفاده کنند |
|---|---|---|
| یک فایل تصویر یا صوتِ OpenAI | ابزار بررسیِ OpenAI | هر کسی، رایگان |
| خروجی متنیِ OpenAI (textGrain) | تشخیص دهنده واترمارک متنیِ OpenAI | پژوهشگران تاییدشده و سازمان های تخصصی، با درخواست |
| خروجی متنیِ Claude | Claude Watermark Detector | سازمان های واجد شرایط، با درخواست (راهنمای واترمارک Claude ما را ببینید: واترمارک Claude از Anthropic، توضیح داده شد (2026)) |
OpenAI همچنین درباره اینکه نتیجه چه چیزهایی را نمی تواند به شما بگوید شفاف است. یک واترمارکِ تشخیص داده شده میزان مشارکتِ یک نفر را اندازه گیری نمی کند و مشخص نمی کند چه کسی متن را نوشته یا از آن استفاده کرده است. نبودِ واترمارک هم ثابت نمی کند که متن حتما توسط انسان نوشته شده است، چون متن ممکن است خیلی کوتاه باشد، ویرایش یا ترجمه شده باشد یا از یک مدل پشتیبانی نشده آمده باشد.
گوگل: اول منتشر کرد، بعد دستور را در اختیار همه گذاشت
Google DeepMind ابتدا کار را انجام داد، سپس کامل منتشر کرد و بعد روش را عمومی کرد. سامانه آن، SynthID، ابتدا در سال 2023 به عنوان یک واترمارک برای تصاویر شروع شد و در سال 2024 به متن هم گسترش یافت. تا زمانی که مقاله Nature در اکتبر 2024 منتشر شد، SynthID-Text از قبل در محیط تولید داخل Gemini در حال اجرا بود؛ بنابراین نخستین واترمارک آماریِ متن بود که در مقیاس مصرف کننده مستقر شد.
SynthID متن، تصاویر، صوت و ویدئو را پوشش می دهد و از اکتبر 2024 در خروجی متنی Gemini فعال است.
سپس گوگل پیاده سازی را به شکل open-source on Hugging Face منتشر کرد و به هر توسعه دهنده اجازه داد همان طرح واترمارک گذاری را روی مدل های خودش اعمال کند. در ماه می 2025، SynthID Detector را اعلام کرد. این یک پورتال تایید است که در آن می توان محتوا را از نظر نشان های SynthID در متن، تصاویر، صوت و ویدئو بررسی کرد.
یک محدودیت در حوزه کار مهم است: SynthID فقط محتوا را علامت گذاری می کند و فقط محتوای تولید شده توسط مدل های خودِ گوگل را شناسایی می کند. چیزی درباره خروجیِ ChatGPT یا Claude نمی گوید، و یک اسکن تمیزِ SynthID به این معنا نیست که متن توسط انسان نوشته شده است. یعنی مدل های گوگل آن را ننوشته اند، که ادعایی بسیار محدودتر است.
Anthropic: آخرین حرکت، سخت گیرانه ترین سیاست
Anthropic جدیدترین زمان را برای استقرار انتخاب کرد، با گسترده ترین پوشش اجباری. هر مدل Claude که در تاریخ یا بعد از 2 آگوست 2026 عرضه شود، یک واترمارک آماری را در خروجی متنی خود، در سراسر جهان و در هر پلن، بدون امکان انصراف (opt-out) جاسازی می کند. این شرکت سازوکار را در توضیح دهنده خود، نحوه کار واترمارک متنی Claude، و دامنه سیاست را در مقاله بخش راهنمای خود، نحوه نشانه گذاری محتوای تولیدشده توسط هوش مصنوعی توسط Claude شرح می دهد: Claude API، claude.ai، Claude Code، Claude Cowork و Claude Tag همگی تحت پوشش هستند. مدل هایی که پیش از زمان تعیین شده (cutoff) عرضه شده اند وارد یک دوره گذار می شوند، و Anthropic می گوید در حال اضافه کردن قابلیت نشانه گذاری برای آن ها نیز هست. در کنار علامت آماری، فایل های تولید شده توسط Claude همچنین دارای متادیتای C2PA هستند، یک سیستم دوم و جداگانه که کپی کردنِ متن ساده آن را از بین می برد.
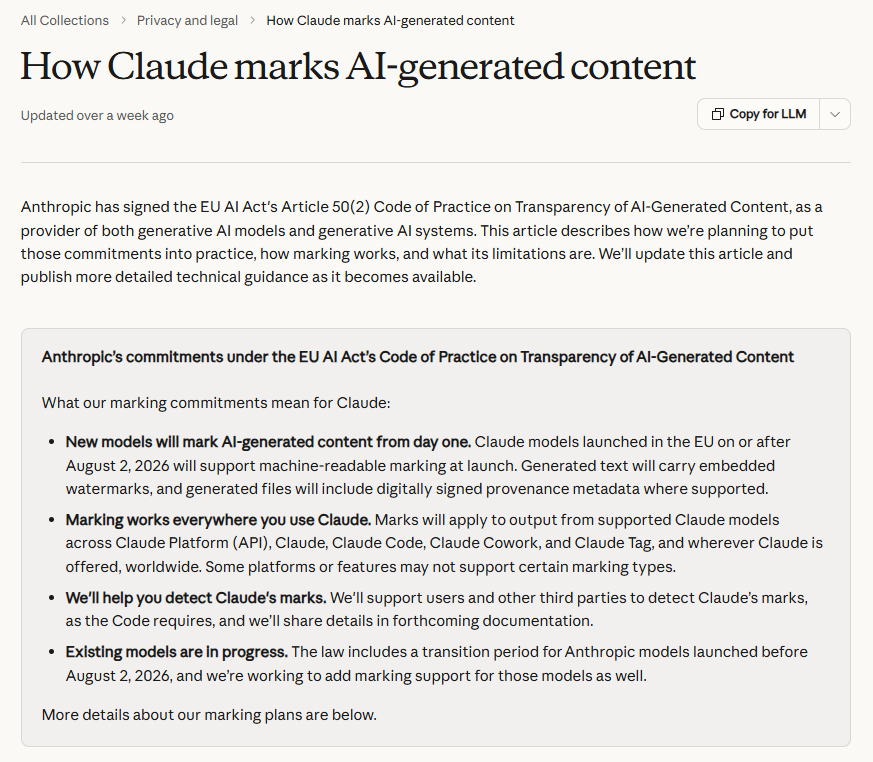
این سیاست به زبان خود Anthropic این است: هر مدل جدید، هر پلتفرم، در سراسر جهان، با این شرط که مدلهای قدیمیتر به تدریج اضافه میشوند.
مستندات Anthropic محدودیتها را صریح بیان میکند. تشخیص احتمالی است. نشانه نمیتواند یک سندی را که Claude نوشته از سندی که یک انسان نوشته و Claude آن را کمی ویرایش کرده تشخیص دهد. یک بازنویسی کامل آن را حذف میکند. ما همه چیز را از جمله اینکه یک تشخیص مثبت دقیقا چه چیزی را ثابت میکند و اگر نوشته خودتان نشانهگذاری شد چه کار باید بکنید، قدم به قدم بررسی کردیم، در راهنمای اختصاصی واترمارک Claude.
زمانبندی از مقررات پیروی میکند. Anthropic کد آیین رفتار ماده 50(2) درباره شفافیت محتوای تولیدشده توسط هوش مصنوعی را در قانون AI اروپا امضا کرده است که از ارائه دهندگان سامانه های هوش مصنوعی مولد میخواهد اطمینان حاصل کنند خروجی ها "در قالبی قابل خواندن توسط ماشین نشانه گذاری شده اند و به عنوان محتوای دست ساز به طور مصنوعی قابل تشخیص هستند." این تعهدات شفافیت از 2 اوت 2026 لازم الاجرا شد: تاریخ دقیق قطع در سیاست مدل Anthropic، نه روز پیش از اعلام عمومی. Anthropic به جای نگه داشتن رفتار جداگانه برای ترافیک اتحادیه اروپا، تصمیم گرفت در سطح جهانی پایبند باشد. Google از پیش به صورت طراحی شده مطابق بود. خروجی متنی بدون نشانه OpenAI پرسش باز درباره انطباق برای سال 2027 است.
سه رویکرد، کنار هم
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| آیا واترمارک متنی مستقر شده است؟ | بله (textGrain، اجرای اتحادیه اروپا از 5 اکتبر 2026) | بله (Gemini، از اکتبر 2024) | بله (مدلهای Claude از 2 آگوست 2026) |
| فناوری | textGrain، یک سیگنال آماری در انتخاب واژگان | نمونهگیری با تورنمنت SynthID-Text | نشانهگذاری مبتنی بر نمونهگیری آماری، سبک SynthID |
| پوشش | متنهای واجد شرایط ChatGPT و Codex در اتحادیه اروپا؛ گزینه فعالسازی در API در سراسر جهان | مدلهای Google فقط | تمام مدلهای جدید Claude؛ مدلهای قدیمیتر در دوره انتقال |
| امکان غیرفعالسازی | به صورت پیشفرض در API خاموش | خیر | خیر |
| تشخیصدهنده عمومی | خیر | پرتال SynthID Detector (2025) | برنامهریزی شده، هنوز منتشر نشده است |
| آیا طرح منتشر شده است؟ | فقط سخنرانیهای مفهومی | مقاله Nature + متن باز | توضیح دهنده، بر اساس پژوهش های منتشر شده |
| فراداده فایل (C2PA) | بله، تصاویر و صدا | بله، در رسانه های مختلف | بله، روی فایل های تولید شده |
| محدودیت های اعلام شده | دور زدن، انگ ESL | حوزه محدود به مدل های خودشان | تصادفی و احتمالی، ویرایش ها مرز نویسندگی را مخدوش می کنند |
الگو در ستون ها این است که: OpenAI واترمارک متنی را یک مسئله سیاست گذاری حل نشده می بیند، Google آن را زیرساختی برای استانداردسازی تلقی می کند، و Anthropic آن را یک تعهد انطباق می داند که باید کامل اجرا شود.
این برای پژوهشگران و نویسندگان دانشگاهی چه معنایی دارد
پیامدهای عملی به این بستگی دارد که کدام ابزار به متن شما دست می زنند. اگر با ChatGPT پیش نویس بنویسید، متن امروز واترمارک ندارد. اگر با Gemini پیش نویس بنویسید، آن یک نشانه SynthID دارد که فقط آشکارساز Google می تواند بخواند. اگر با یک مدل فعلی Claude پیش نویس بنویسید یا ویرایش کنید، آن نشانه Anthropic را دارد و هیچ تنظیمی وجود ندارد که آن را خاموش کند.
سه نکته ای که نویسندگان دانشگاهی باید بدانند:
یک واترمارک یک ابزار را شناسایی می کند، نه یک نویسنده. هر فروشنده این را در مستندات خودش بیان می کند و تکرار آن ارزشمند است، چون سیاست های سازمانی همیشه این تمایز را روشن نمی کنند. متن ممکن است علامت گذاری شود چون یک AI آن را نوشته است، چون یک AI دو جمله از آن را ویرایشِ کپی ادیت کرده است، یا چون یک پاراگرافِ علامت دار نقل قول شده است. اگر سازمان شما بررسی های واترمارک را اجرا می کند، چیزی که بررسی ثابت می کند این است که یک مدل مشخص در مقطعی به آن متن دست زده است، و نه بیشتر. راهنمای ما درباره درخواست تجدیدنظر برای ثبت نادرست پرچم تشخیص AI توضیح می دهد چگونه وقتی لازم است این استدلال را مطرح کنید.
واترمارک ها و آشکارسازهای AI فناوری های متفاوتی با حالت های شکست متفاوت هستند. آشکارسازهایی مانند Turnitin یا GPTZero با حدس از روی سبک آماری عمل می کنند، با مشکلات دقتی که ما مستند کرده ایم. تشخیص واترمارک یک آزمون مبتنی بر کلید است که نرخ مثبت کاذب آن در متن انسانیِ بدون علامت بسیار پایین است. اما نامتقارن بودن در مورد منفی کاذب است: یک بررسی واترمارک هر متن AI از یک مدل بدون واترمارک را از دست می دهد، و این امروز شامل همه ChatGPT است.
افشای واقعیت همچنان قوی ترین موضع شماست. واترمارک گذاری ریسک استفاده خاموش از AI را بالاتر می برد، و استفاده افشاشده از AI را امن تر می کند، چون یک فرایند افشاشده از علامت مثبت چیزی برای ترس ندارد. بیشتر مجله ها و دانشگاه ها اکنون سیاست های صریحی برای استفاده از AI دارند؛ سیاست استفاده از AI ما توضیح می دهد چگونه آن خطوط را در ابزارهای خودمان ترسیم می کنیم، و این یک الگوی منطقی برای آن چیزی است که استفاده شفاف به نظر می رسد.
چه چیزی یک واترمارک متنی را حذف می کند و چه چیزی حذف نمی کند
بازنویسی آن را حذف می کند؛ قالب بندی آن را حذف نمی کند. کپی کردن، پیست کردن، تغییر فونت، تبدیل بین فرمت های فایل، و حذف کاراکترهای نامرئی همه واترمارک آماری را کاملا دست نخورده باقی می گذارند، چون نشان در انتخاب های واژگانی است. چیزی که آن را حذف می کند هر چیزی است که متن را دوباره تولید کند: یک ویرایش عمیق انسانی، یک ترجمه، یا یک بازنویسی واقعی. همان کار پژوهشی استحکام NeurIPS 2023 نشان داد که این سیستم ها قبل از عرضه شدن، این موضوع را ثابت کرده بودند.
هر دو جهت اهمیت دارد. از بین رفتنِ برچسب به این معنا نیست که متن از آنِ شماست، و باقی ماندنِ برچسب هم به این معنا نیست که متن از آنِ شما نیست. یک پیش نویس بازنویسی شده توسط AI همچنان یک سند با کمک AI است که مقررات افشای مؤسسه شما شامل آن می شود. humanizer هوش مصنوعی پیش نویس های دارای کمک AI را به یک لحن طبیعی و دانشگاهی بازنویسی می کند و چون این فرایند توالی نشانه ها را دوباره تولید می کند، برچسب های آماری از آن دوام نمی آورند. به طور مشخص برای متن های Claude، حذف کننده واترمارک رایگان Claude هر جمله را با واژگان تازه بازتعریف می کند، در حالی که واقعیت ها، اعداد و ارجاعات بدون تغییر باقی می مانند. چیزی که هیچ ابزار نتواند تغییر بدهد این است که شما چه تعهدی در قبال خواننده دارید: شفافیت درباره این که سند چگونه ساخته شده است.
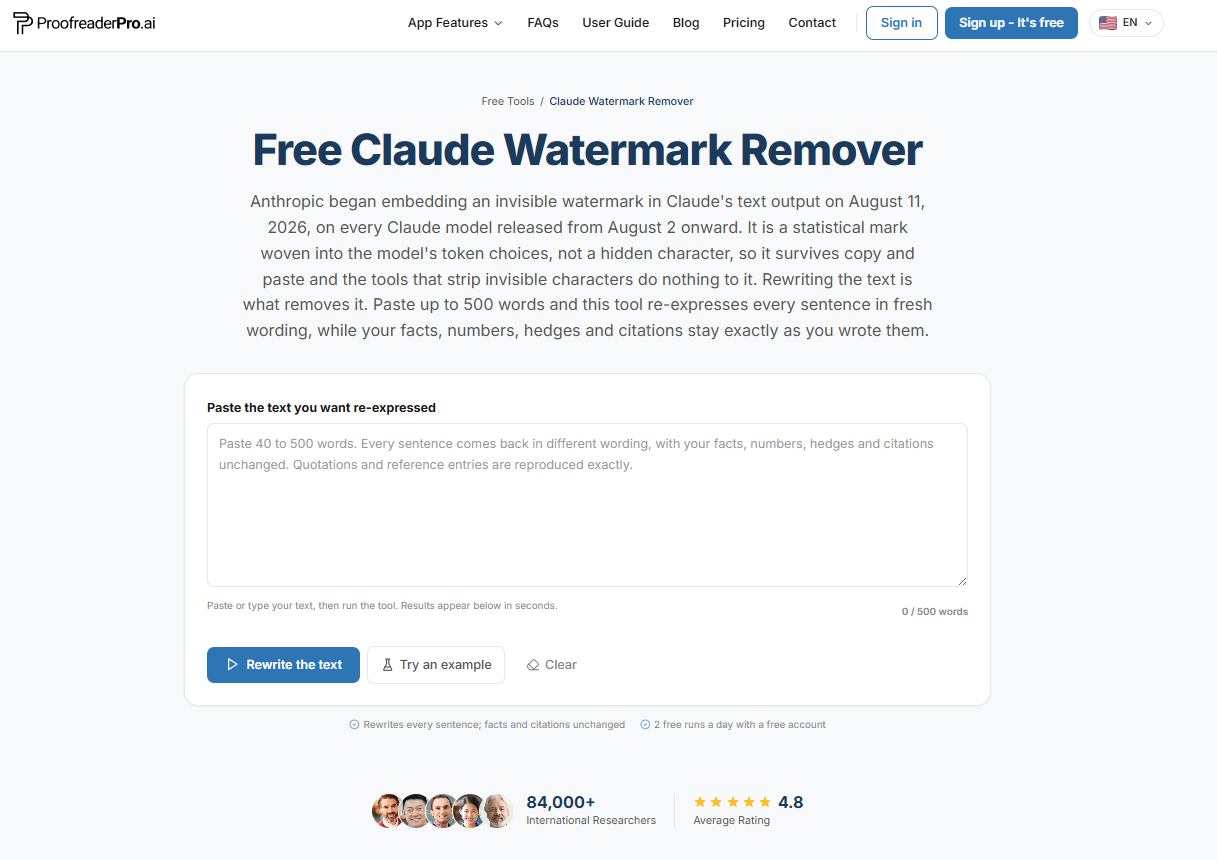
بازنویسی تنها عملیاتی است که یک برچسب آماری را حذف می کند، و همین کاری است که این ابزار، جمله به جمله انجام می دهد.
این بعد به کجا می رود
سه مورد را تا سال 2027 زیر نظر بگیرید. اول، این که آیا OpenAI متنGrain را فراتر از اتحادیه اروپا می برد یا نه. این کار از آن جا شروع شد، چون اجرای مقررات اتحادیه اروپا درباره ماده 50 مستلزم برچسب های قابل خواندن توسط ماشین روی متن های AI است. دوم، این که آیا سامانه های تشخیص به همگرا می رسند یا نه. اگر هر آزمایشگاه بزرگ با یک الگوی منتشر شده واترمارک بگذارد، دانشگاه ها می توانند کلیدها را بررسی کنند و به جای حدس از روی سبک نوشتار عمل کنند، که این بهبود می دهد نسبت به تشخیص هایی که مستعد خطای مثبت کاذب هستند. سوم، این که آیا برچسب ها با هم سازگار می شوند یا نه. امروز سه آزمایشگاه از سه نوع برچسب متفاوت استفاده می کنند و هیچ بررسی واحدی همه آن ها را پوشش نمی دهد. C2PA این شکاف را برای فایل ها پر می کند؛ اما هنوز چیزی آن را برای متن خام پر نکرده است.
آیا ChatGPT روی متنش واترمارک می گذارد؟
بله، تا حدی از تاریخ 5 اکتبر 2026. OpenAI شروع کرده است به اضافه کردن واترمارک textGrain به متن های ChatGPT و Codex واجد شرایط در اتحادیه اروپا، و مشتریان API در هر جای دنیا می توانند آن را فعال کنند. واترمارک یک سیگنال آماری در انتخاب واژه ها است و هیچ کاراکتر پنهانی در آن وجود ندارد. OpenAI همچنین متادیتای منشأ C2PA را روی فایل های رسانه ای DALL-E و Sora اعمال می کند که یک سامانه جداگانه و در سطح فایل است.
آیا Google Gemini روی متنش واترمارک می گذارد؟
بله. خروجی Gemini از اکتبر 2024 واترمارک SynthID-Text متعلق به Google DeepMind را داشته است. این یک برچسب آماری در انتخاب واژه هاست، برای خوانندگان نامرئی است و از طریق ابزار تشخیص SynthID گوگل قابل بررسی است. این واترمارک فقط روی مدل های خودِ Google اعمال می شود، بنابراین نتیجه منفی SynthID درباره متنِ سیستم های AI دیگر چیزی نمی گوید.
آیا Claude روی متنش واترمارک می گذارد؟
بله. هر مدل Claude که در تاریخ یا بعد از 2 آگوست 2026 راه اندازی شده باشد، یک واترمارک آماری را در خروجی متنش جاسازی می کند، در هر پلتفرم و هر پلن، بدون امکان غیرفعال سازی، و فایل های تولیدشده توسط Claude همچنین متادیتای C2PA را در بر دارند. مدل هایی که قبل از این تاریخ راه اندازی شده اند هنوز خروجی خود را برچسب گذاری نمی کنند. Anthropic می گوید در طول یک دوره گذار در حال اضافه کردن قابلیت برچسب گذاری به آن ها است. جزئیات کامل در توضیح دهنده واترمارک Claude ما آمده است.
آیا دانشگاه ها می توانند واترمارک های AI را تشخیص دهند؟
فقط با همکاری خودِ فروشنده، چون تشخیص به کلیدِ فروشنده نیاز دارد. Google یک پورتال تشخیص عمومی برای محتوای SynthID ارائه می دهد. Anthropic می گوید پشتیبانی تشخیص برای کاربران و اشخاص ثالث برنامه ریزی شده، اما هنوز یک ابزار تشخیص عمومی منتشر نکرده است. هیچ مجموعه رایجِ بررسی سرقت ادبی نمی تواند در حال حاضر واترمارک های آماری را از هیچ آزمایشگاهی تأیید کند، بنابراین «تشخیص AI» نهادی امروز همچنان یعنی حدس بر اساس سبک، نه راستی آزمایی واترمارک.
آیا واترمارکینگِ AI طبق قانون الزامی است؟
در اتحادیه اروپا، بله، عملا. ماده 50(2) قانون AI اتحادیه اروپا از ارائه دهندگان هوش مصنوعی مولد می خواهد اطمینان حاصل کنند که خروجی ها در قالبی قابل خواندن توسط ماشین علامت گذاری شده و به عنوان تولید مصنوعی قابل تشخیص باشند، و الزامات شفافیت از 2 اوت 2026 قابل اعمال است. Anthropic کد اخلاقی مرتبط را امضا کرد و برای رعایت در سراسر جهان انتخاب کرد. این که نهادهای ناظر در سال 2027 با متن علامت گذاری نشده منتشرنشده OpenAI چگونه برخورد خواهند کرد، پرسشی است که باید زیر نظر داشت.
آیا واترمارک های AI در ترجمه دوام می آورند؟
خیر. واترمارک آماری در توالی دقیق کلماتی زندگی می کند که مدل انتخاب کرده است، و ترجمه هر کلمه را جایگزین می کند. همین موضوع درباره بازنویسی عمیق و ویرایش سنگین انسانی نیز صدق می کند. این محدودیت در ادبیات علمی داوری شده مستند شده و توسط هر فروشنده ای که واترمارک را ارائه می کند پذیرفته شده است.
آیا برای متن، یک ابزار بررسی واترمارک عمومی OpenAI وجود دارد؟
خیر. ابزار عمومی تایید OpenAI فقط فایل های تصویر و صوت را بررسی می کند، برای فراداده های C2PA و واترمارک های SynthID. OpenAI می گوید از متن پشتیبانی نمی کند. آشکارساز واترمارک متنی آن فقط برای پژوهشگران تاییدشده و سازمان های خبره به صورت موردی و به شرط تایید در دسترس است.
textGrain چیست؟
textGrain واترمارک متنی OpenAI است که 5 اکتبر 2026 اعلام شد. به انتخاب های واژگانی مدل یک نشانه آماری نامرئی اضافه می کند، بنابراین این علامت بخشی از خودِ کلمات است و هیچ کاراکتر پنهان یا فراداده مربوط به فایل وجود ندارد. OpenAI می گوید با روش های دیگر که آزمایش کرده، همسان یا بهتر عمل کرده است، از جمله SynthID برای متن، و این که ویرایش آن را تضعیف می کند.
آیا پژوهشگران می توانند برای دسترسی به آشکارساز واترمارک متنی OpenAI درخواست دهند؟
بله. پژوهشگران تاییدشده و سازمان های خبره می توانند از طریق فرم API منشأ محتوا در OpenAI درخواست دهند. OpenAI دسترسی را به صورت موردی و ذیل کد اخلاقی اتحادیه اروپا اعطا می کند. این شرکت می گوید با توسعه فناوری و شواهد، دسترسی گسترده تر را دوباره بررسی خواهد کرد.
منابع
- Anthropic، نحوه کار واترمارک متنی Claude، آگوست 2026
- مرکز راهنمای Anthropic، نحوه نشانه گذاری محتوای تولیدشده توسط AI توسط Claude، 2026
- OpenAI، درک منشأ آنچه آنلاین می بینیم و می شنویم، مه 2024
- Google DeepMind، SynthID
- Dathathri و همکاران، واترمارک گذاری مقیاس پذیر برای شناسایی خروجی های مدل های زبانی بزرگ، Nature، اکتبر 2024
- Google، اعلام آشکارساز SynthID، مه 2025
- Hugging Face، معرفی SynthID Text، اکتبر 2024
- Kirchenbauer و همکاران، A Watermark for Large Language Models، ICML 2023
- Krishna و همکاران، بازنویسی از سامانه های تشخیص متن تولیدشده با هوش مصنوعی فرار می کند، NeurIPS 2023
- Scott Aaronson، سخنرانی من درباره ایمنی AI برای UT: مؤثر آلتروئیسم، نوامبر 2022
- اتحادیه اروپا، قانون AI، ماده 50
- C2PA, اتحاد برای منشأ و اصالت محتوا
دانا یک تولید کننده محتوا در ProofreaderPro است، جایی که او وبلاگ روزانه و عملیات نوشتن را اداره می کند. او مقالاتی را در مورد نحوه عملکرد پلتفرم ویرایش آنلاین می نویسد و هر روز با پیام های مشتری رسیدگی می کند و امتیاز رضایت پنج ستاره را نشان می دهد.