
如何降低AI检测分数:面向研究者的实用指南
逐步指南,帮助将AI检测分数降至15%以下。经测试的方法可降低GPTZero、ZeroGPT和Copyleaks中的AI占比。

如果你使用了像 ChatGPT、Claude、Gemini 或 Deepseek 这样的 AI 模型来协助撰写研究论文,那么你的 AI 分数在 Turnitin 或 GPTZero 这类常见 AI 检测工具上很可能会很高。本文将指导你如何把 AI 检测分数降回到适合提交的水平。
以下是能将你的 AI 百分比降至安全范围的确切流程。
五个步骤一览
- 用两个检测器检查你的草稿,并记录哪些段落被标记出来。
- 用你自己的表达手动改写被标记的段落,重点改变结构,而不是替换词语。
- 使用一款学术型 humanizer 处理顽固段落,同时保留引文和术语。
- 用最初使用的同样检测器重新检查整篇文档。
- 设定一个现实的目标并在此止步,低于 15% 是可以实现的,而 0% 并非必要。
下面的各部分将详细介绍每一步,包括当人类撰写的文本也被标记时该怎么做。
你的 AI 检测分数实际衡量的是什么
在开始修正这个分数之前,你需要理解它的含义。像 Turnitin、GPTZero、Originality.ai 和 Copyleaks 这样的 AI 检测器,会分析你的文本中是否存在 AI 生成写作中常见的统计模式。
这些模式包括低 perplexity, 低 burstiness, 以及段落节奏的高一致性。人类写作往往比较杂乱, 句长不一, 选词出人意料, 偶尔会跑题。AI 写作则往往更流畅, 更均匀, 更可预测。
你的 AI detection score 并不是在衡量你是否使用了 AI。它衡量的是你的文本是否呈现出与 AI 输出相关的模式。这是一个重要区别, 因为大量人类撰写的文本也会触发这些相同的模式, 尤其是正式的学术写作, 其结构本就比日常散文更有组织性, 也更可预测。
一些检测器还会权衡的第三个信号是词汇分布。模型偏好在其训练数据中统计上更常见的词语, 而人类作者则会使用带有个人特征的词汇, 也就是他们反复使用的术语, 偏爱的非常规词, 以及在意想不到的位置使用的学科术语。
大学级检测器,逐一来看
了解你面对的是哪一种检测器,会改变你解读分数的方式。以下这些,才是机构和客户在 2026 年实际使用的工具,它们各自衡量什么,以及什么才算安全结果。无论是哪种工具,都应把任何分数视为需要复核的信号,而不是证据, 在一项被广泛引用的 Stanford 研究中,主流检测器把 61% 的非英语母语者论文标记为 AI 写作。
| 检测器 | 使用方 | 需要了解的要点 |
|---|---|---|
| Turnitin | 大学,机构级部署 | 低于 20% 显示为 *%,实际目标是 20% 以下 |
| GPTZero | 教育者和学生 | 高亮被标记的句子,目标是 15% 以下且没有连续高亮 |
| Originality.ai | 出版商、机构、客户 | 仅付费,判定激进,更新频繁 |
| Copyleaks | 通过 LMS 集成的大学 | 多语言,公布的误报率低于 1% |
| Winston AI | 教育者和内容团队 | 支持 OCR 输入,99.98% 的宣称应当作营销话术看待 |
| ZeroGPT | 学生用作免费初筛 | 分数波动很大,单独使用绝不能作为结论 |
| Pangram | 学术诚信办公室 | 独立研究中误报率不高于 0.5% |
| Scribbr AI Detector | 提交前的学生 | 准确率在 70% 高段到 80% 中段,是筛查而非证据 |
| Sapling | 商务和客服团队 | 一项同行评审研究发现 90% 的人类样本被标记 |
Turnitin
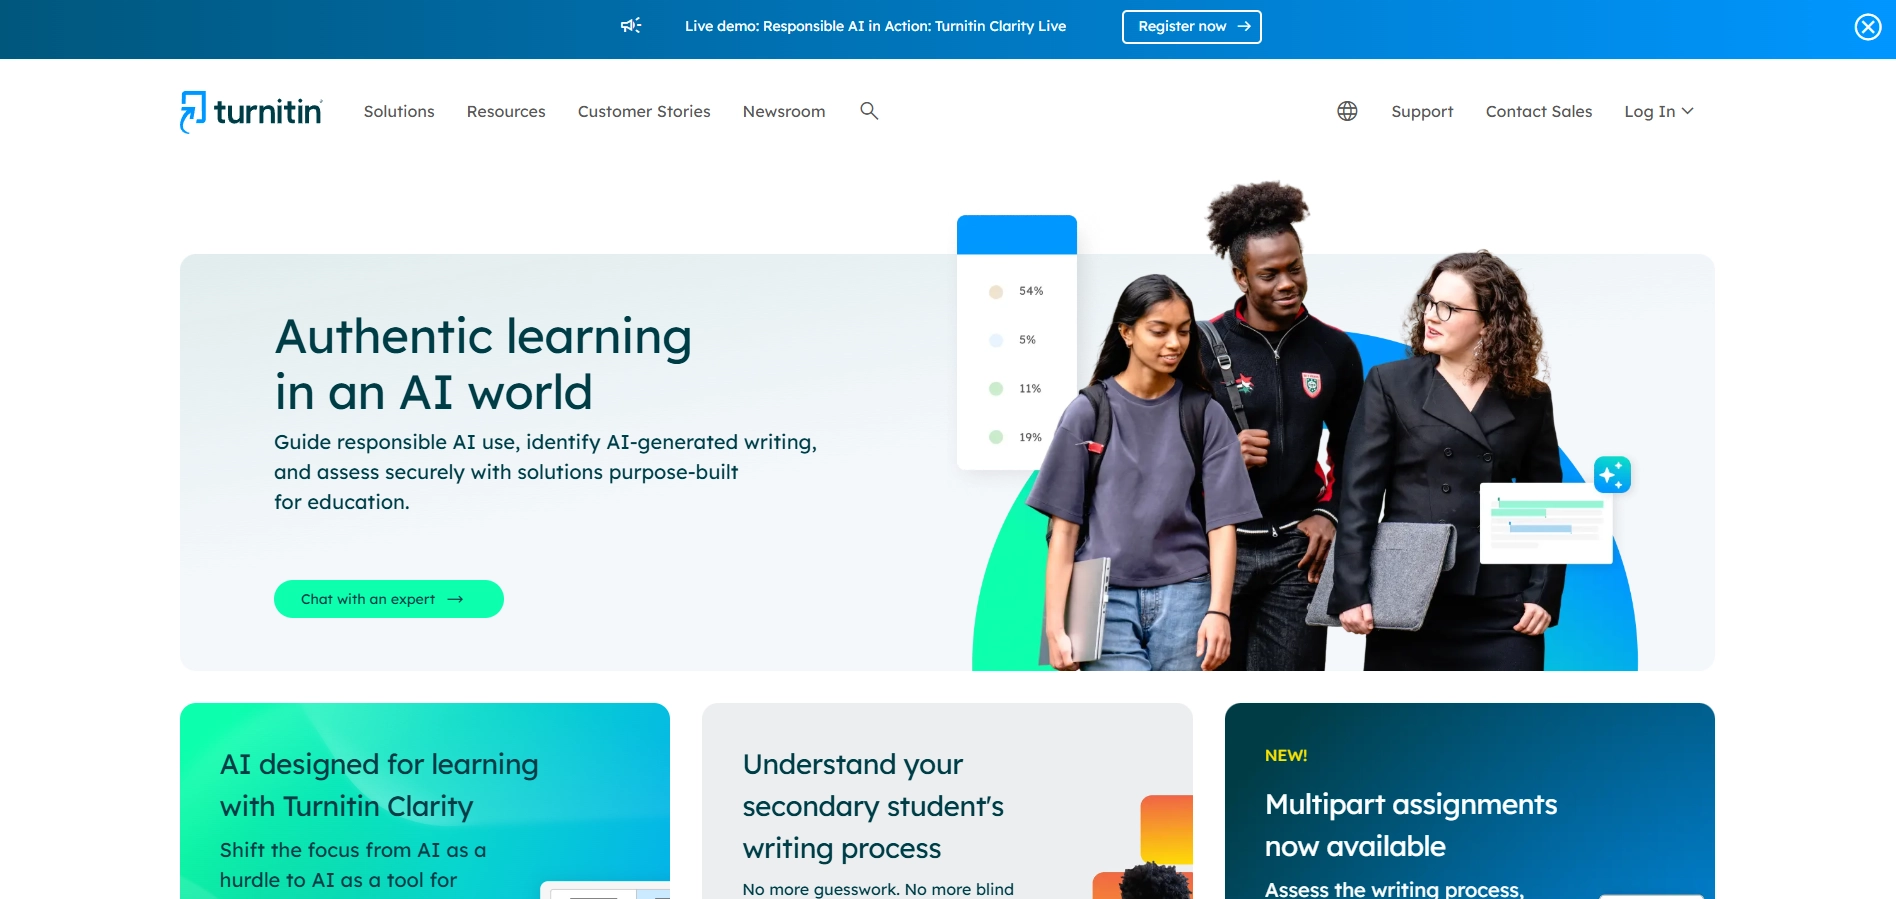
大学里的默认选择。Turnitin 的 AI 写作检测内置在同一个平台中,该平台同时运行相似度报告,并且按机构范围授权,因此学生不能自行购买访问权限,在提交前自己检查。它会对文档分段,并单独评估这些文字有多大程度像是 AI 生成,而不是相似度分数。两个显示规则很重要, 20% 及以上的分数会显示百分比并附带句子级高亮,而 1% 到 19% 之间的结果则会显示为 *%,不归属具体数字,因为 Turnitin 自身测试发现,20% 以下的误报更多。实际目标是保持在 20% 以下,也就是低于报告显示明确数字的阈值。由于误报担忧,几所大型大学已经停用了该功能,而 Turnitin 较新的 Clarity 产品则把证据更多转向你的写作过程。我们的 Turnitin Clarity 说明 和 Turnitin 分数指南 对两者都有详细介绍。
GPTZero
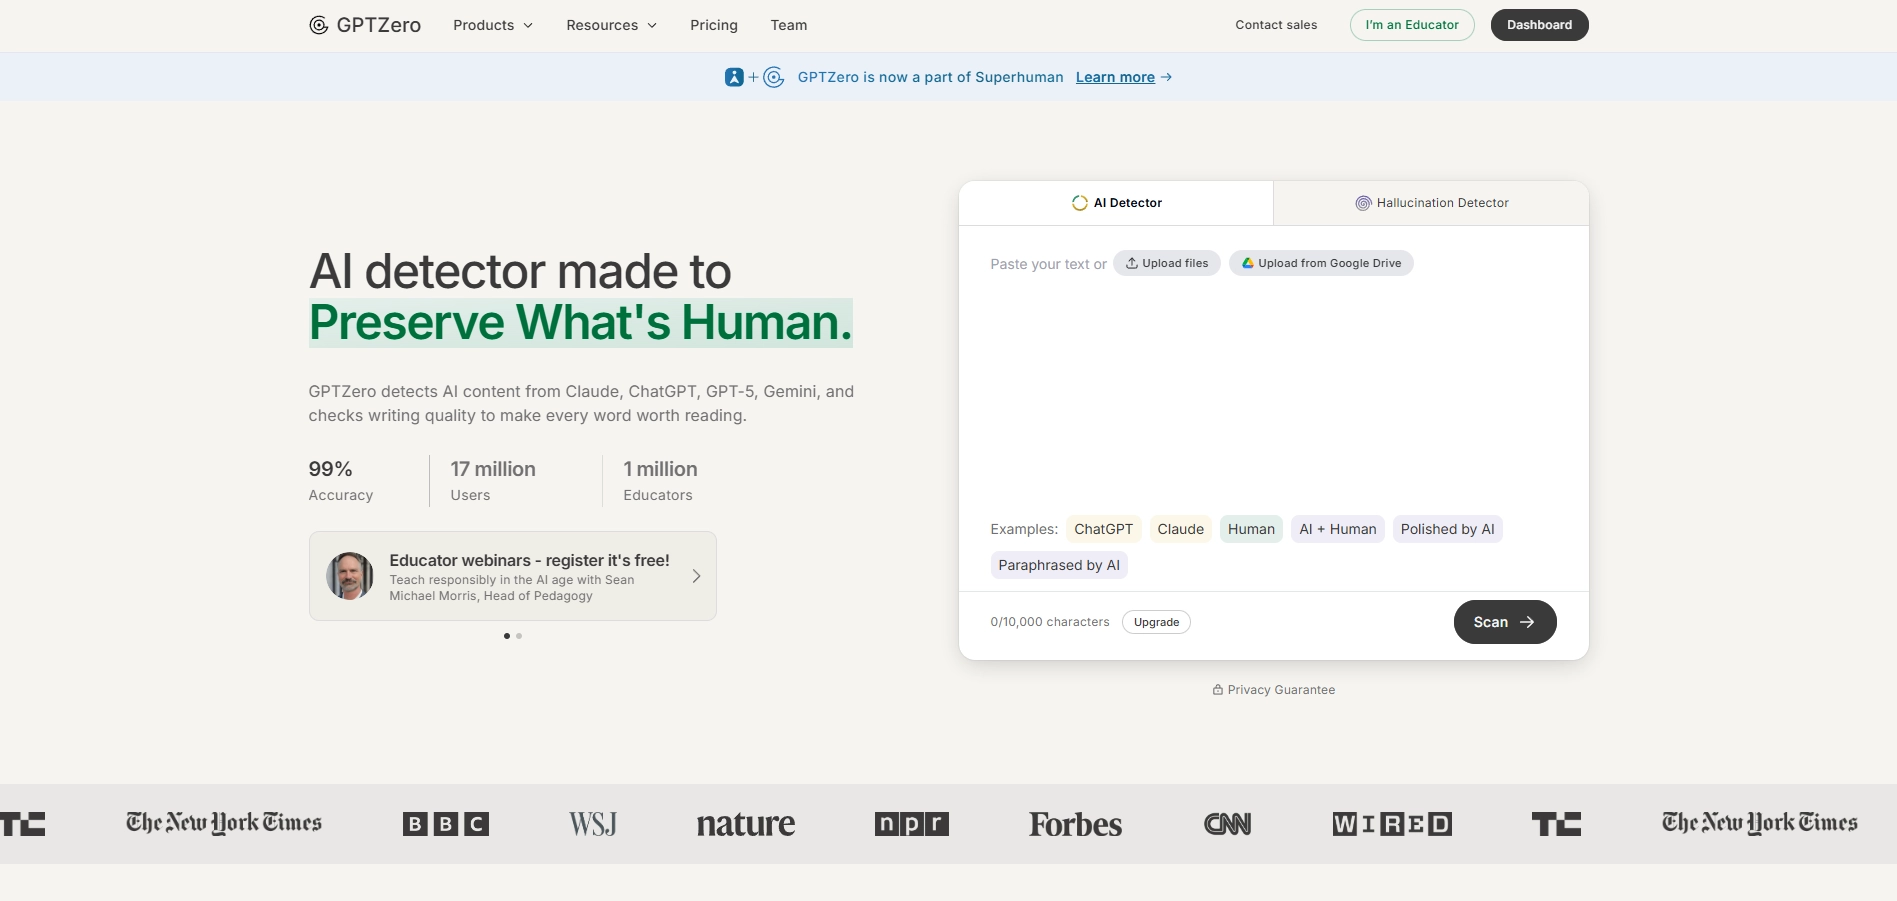
最知名的独立检测器,面向教育场景。GPTZero 直接衡量 perplexity 和 burstiness,并高亮它认为是机器写成的单个句子,这使它成为本指南中定向改写流程最有用的工具。教师使用它的课堂仪表板,学生则用免费层作预检。它在基准测试中对未经编辑的模型输出表现良好,但当文本经过真正修改后效果会减弱。目标是低于 15%,且不要出现连续句子被高亮的片段。我们的 GPTZero 分数指南 解释了它的特殊之处。
Originality.ai
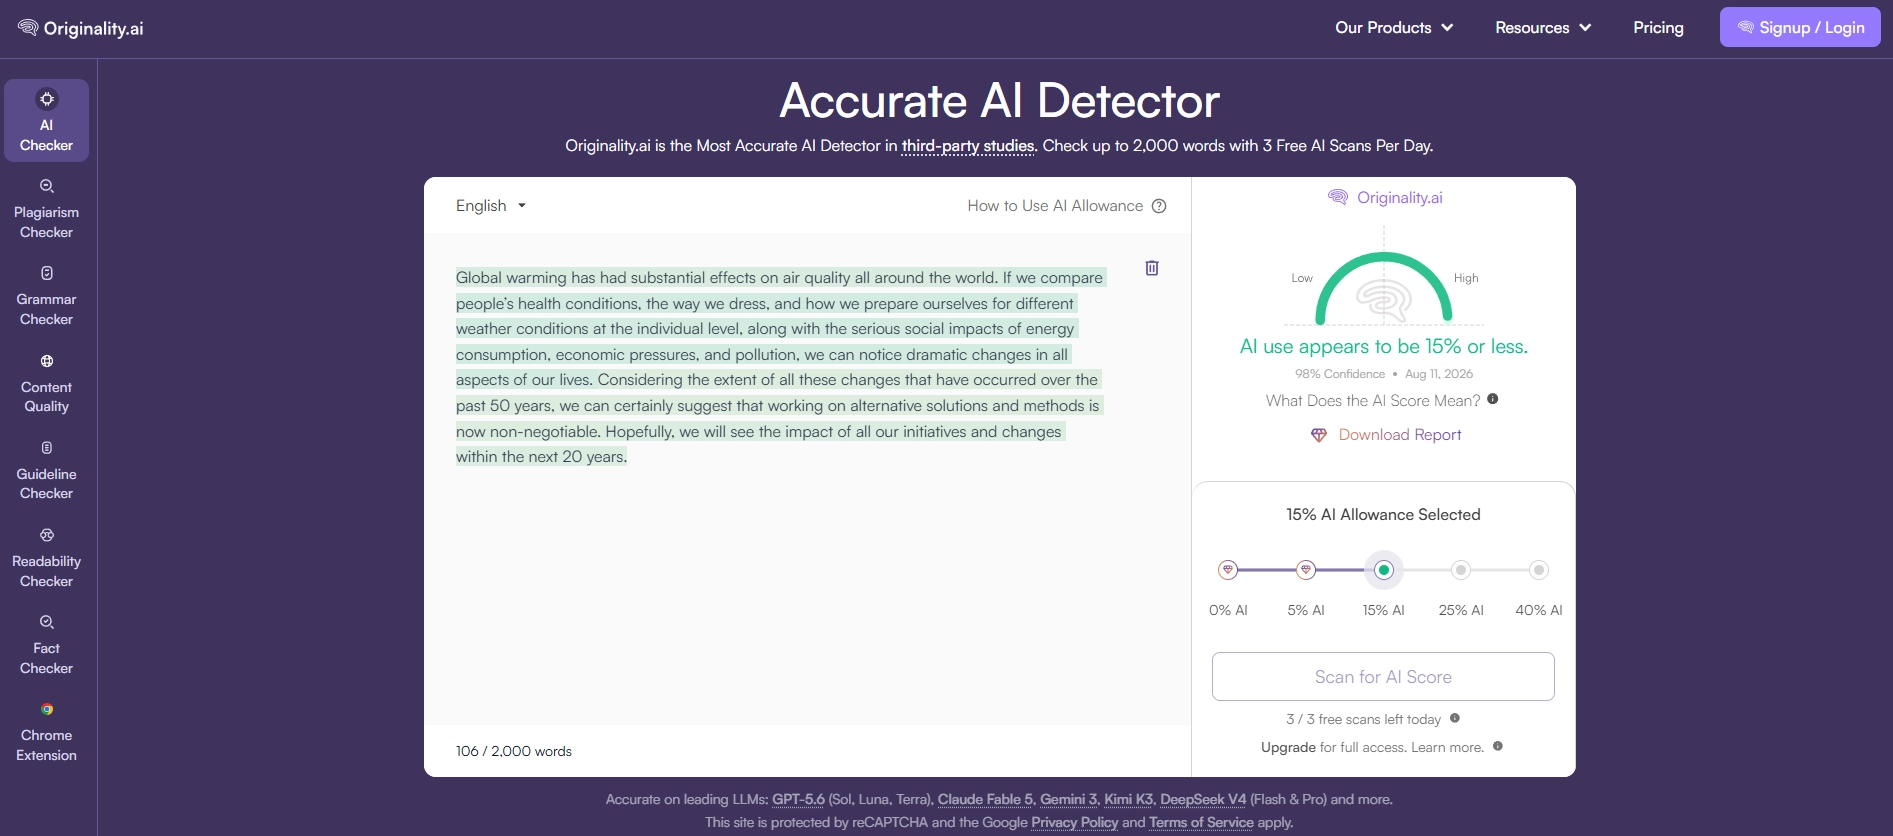
这是自由职业和出版行业的检测器,而不是课堂上的工具。代理机构、编辑和网站所有者会把整篇文章和整站内容交给它检测,而红色分数可能会让写作者的报酬被搁置。它仅支持付费,模型更新频繁,而且判断偏严格, 它能抓到比多数竞品更多的 AI 文本,但代价是对干净文本的误判也更多。如果客户用它筛查,请保留你自己的报告,并争取一个明确的人类判定。我们在 Originality.ai 分数指南 中讨论了争议处理和修改策略。
Copyleaks
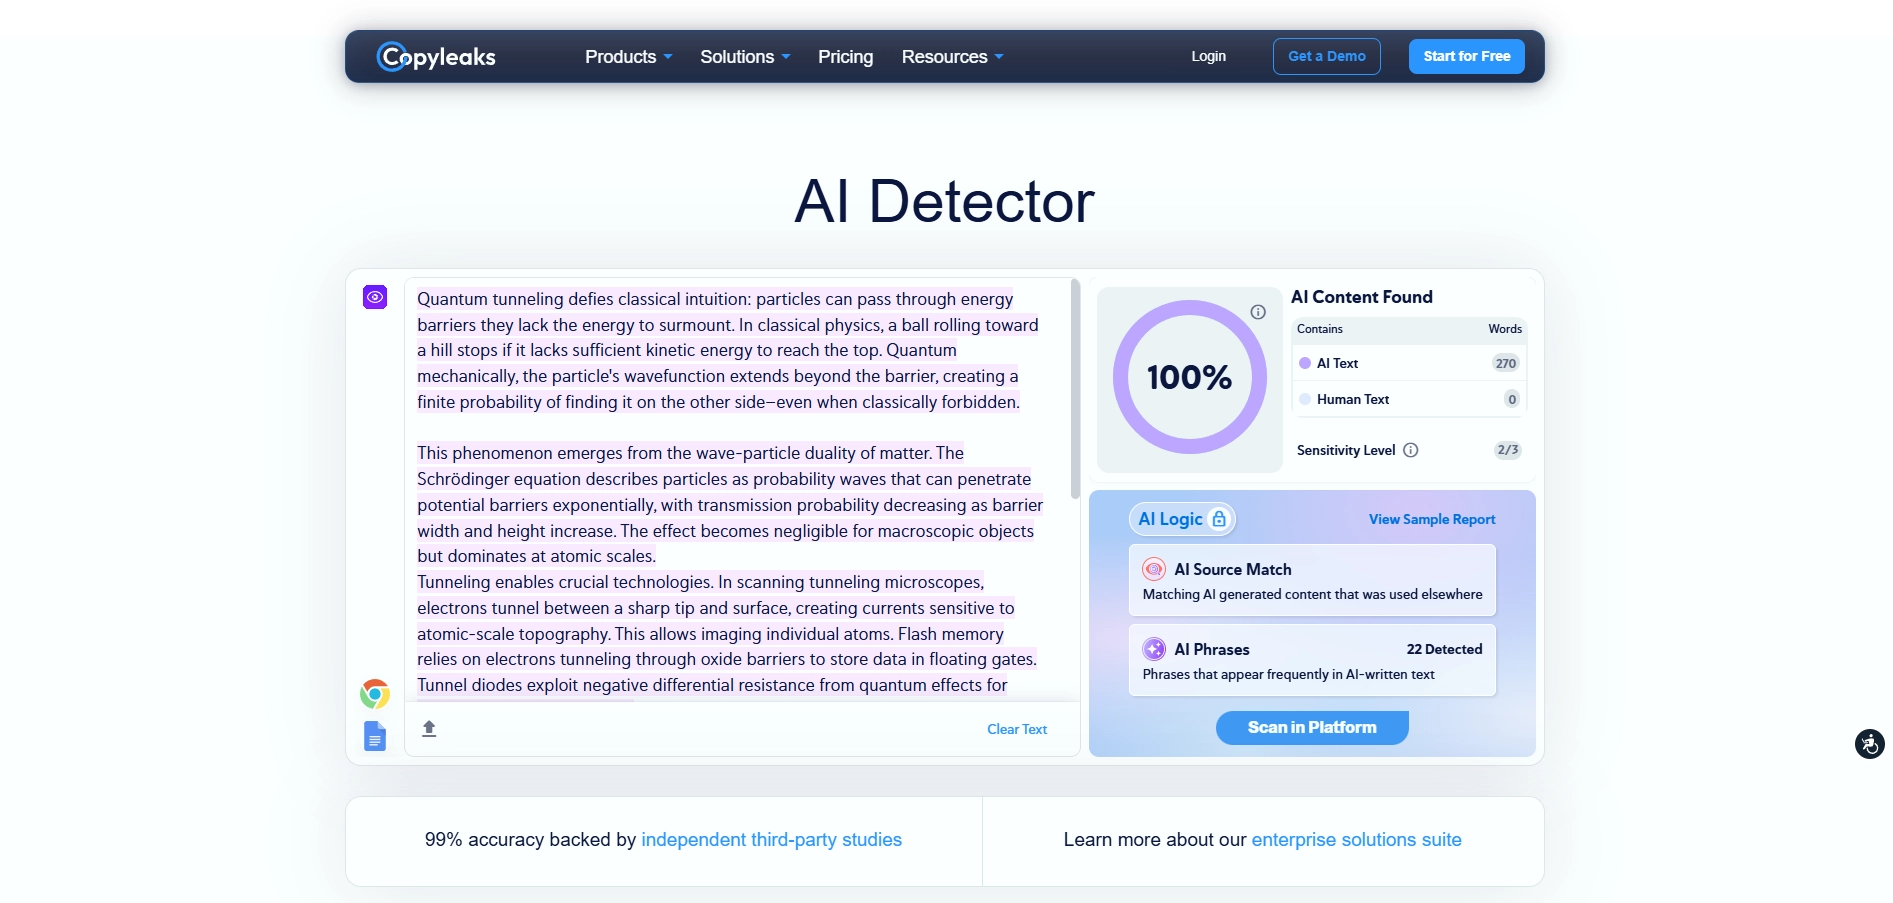
企业级首选。Copyleaks 可接入 Canvas、Moodle 和 Blackboard 等学习管理系统,支持多语言检测,并提供灵敏度模式以及让采购团队放心的合规认证。其公开的误报率低于 1%,在主流工具中属于最低之一。那些不运行 Turnitin 的大学,常常会运行 Copyleaks。我们的 Copyleaks 说明 解释了对一个标记应信任到什么程度。
Winston AI
宣传为 99.98% 准确率,但你应将这个数字视为营销而非测量,因为独立测试呈现的是更为温和的结果。Winston 真正的差异化在于输入处理, 它运行 OCR,因此教师可以扫描手写或打印的作业,以及文档照片。它面向教育者和内容团队销售。应把它的百分比结果当作任何单一工具的结果一样看待,并用第二个检测器核实。参见我们的 Winston AI 准确率分析。
ZeroGPT
大多数学生最先尝试的免费、无需登录工具。它在同一段文本上的分数波动很大,因此只适合做粗略初筛,别无更多用途。你自己写的内容得到较高的 ZeroGPT 分数很常见,这并不意味着 Turnitin 或 Copyleaks 也会这样判断。如果 ZeroGPT 标记了你,请先用另外两个校准更好的工具重新测试,再去改动任何一个词。我们的 ZeroGPT 准确率评测 解释了它的数值为何会飘移。
Pangram
新一代中最强的一个。在一项独立的 University of Chicago 研究中,Pangram 是唯一一个既能可靠检测 AI 文本,又能将误报控制在 0.5% 或以下的检测器,而且即使文本经过 humanizers 处理,其准确率依然稳定。它正在学术诚信办公室和编辑团队中获得更多采用,这些团队此前在其他地方被误报伤过。如果你的作品要面对 Pangram,唯一可靠的方法就是本指南所教的方法, 用你自己的声音进行真正的结构性改写。
Scribbr AI Detector
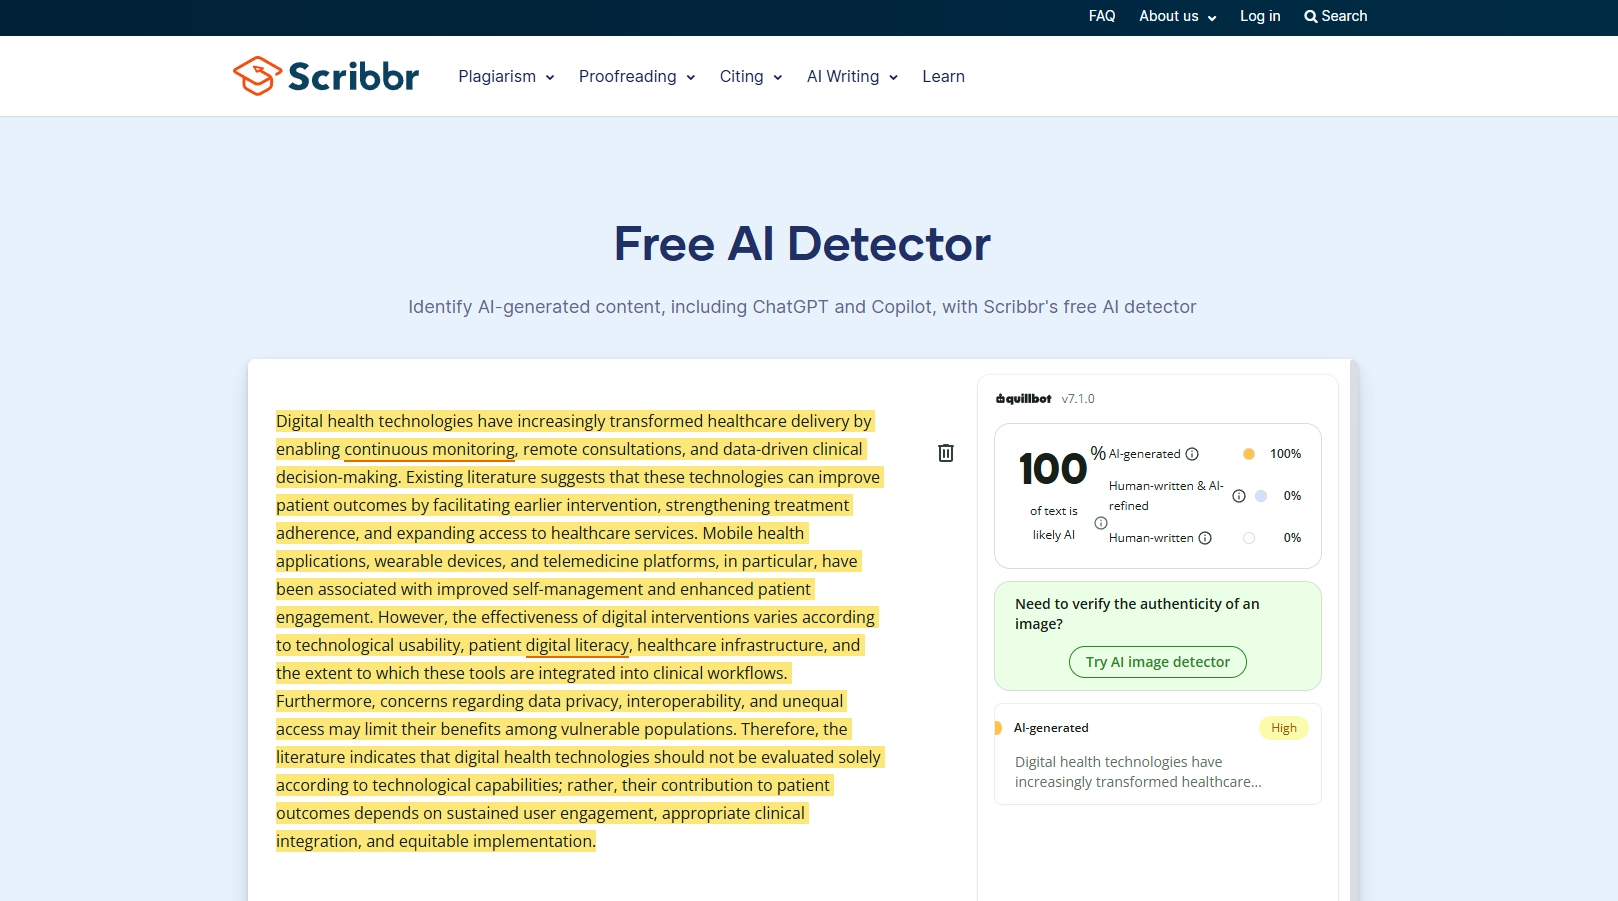
来自同名编辑公司的免费、面向学生的检测器,同时也提供付费层级。它在准确率测试中大致落在 70% 多到 80% 多的区间,因此适合作为提交前的方便筛查,但不足以作为任何诚信判断的坚实依据。把它当作第一意见,然后再用更强的工具确认。
Sapling
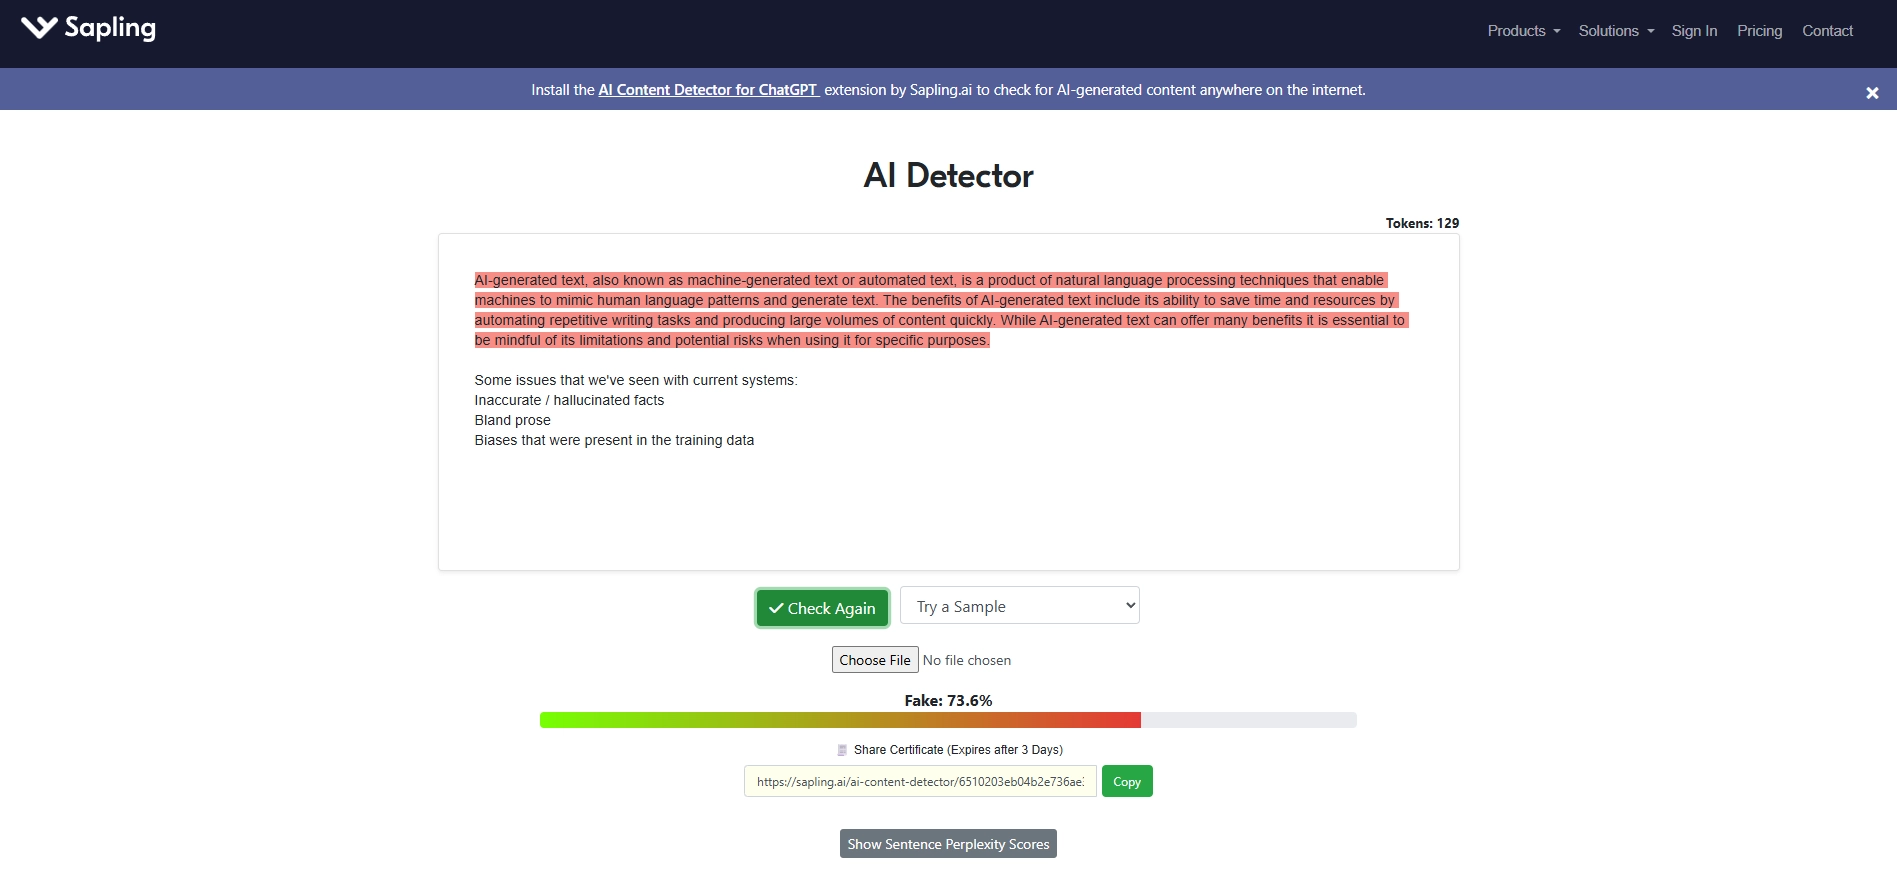
它面向商业和客服文本,而不是学术写作,而且是一个很有用的反面案例, 它宣传最高可达 97% 的准确率,但一项同行评审研究发现,它把 90% 的真实人类写作样本标记成了 AI。如果来自这类工具的分数曾被用来对付你,这就是你需要了解的研究。也正因为如此,本指南才会反复强调同一条规则, 没有任何单一检测器的数字可以作为证据。
第 1 步:识别哪些部分被标记
不要重写整篇论文。那是在浪费时间,而且很可能会让情况更糟。
相反,把你的文本放进一个能够按句子或按段落分析的检测器。GPTZero 的句子级高亮在这里尤其有用。它会准确显示哪些段落被标记为可能由 AI 生成。
根据我们的经验,AI 检测得分在一篇论文中很少是均匀分布的。你通常会发现,有 2-3 个部分在驱动大部分得分,通常是引言、文献综述,或结构高度化的方法描述。这些才是你应该重点关注的部分。
把你的文本复制到检测器中。记下被标记的段落。那就是你的重点清单。
第 2 步:手动改写被标记的段落
这是你能够采取的、降低 AI 检测分数最有效的单一步骤,而且没有任何捷径可走。
把每一段被标记的内容都重新改写一遍。不要修改现有文本。打开一个空白文档,用你自己的措辞写出同样的意思。这会迫使你打破检测器正在捕捉的统计模式。
有三种具体有效的技巧:
有意变化句子长度。 AI 文本往往会稳定地使用 15-25 个词的句子。可以穿插一些短句。然后接上一句更长的句子,把想法展开得更充分,并加入一个或两个从属从句。仅靠这种变化,就能显著降低段落的 AI 分数。
加入个人学术语气。 在合适的地方,加入缓和语气词("this may suggest")、限定语("with the qualification that"),或者与你所在学科相关的专业表述。AI 往往使用泛化的学术英语,而你的领域有其自身的惯例,应该加以运用。
重组内容,而不只是改写措辞。 如果 AI 生成的版本用编号格式列出了三个要点,就把它们合并成流畅的散文。如果它采用的是“主题句加证据”的结构,尝试先给出证据,再逐步引出结论。结构层面的调整,比逐词替换更有效。
第 3 步:为顽固段落使用 AI 人性化工具
有些段落很难靠手工改写来解决,尤其是方法部分中带有固定程序性语言的内容,或者以统计报告为基础的结果部分。这些段落本身就具有结构化和可预测的特点,因此无论是否由 AI 撰写,检测器都可能将其标记出来。
对于这些段落, AI 文本人性化工具 可以提供帮助。一个好的 humanizer 会在保持技术准确性的同时,引入句子结构和措辞上的自然变化。
关键在于“好”。大多数 humanizer 会删去你的技术词汇,并把引文弄得一团糟。请选择专为学术文本设计的工具,也就是那种能够理解 "p < 0.05" 是一个统计表达,而不是需要修正的笔误的工具。我们关于 将 AI 文本人性化用于学术写作 的指南,介绍了如何在不损害质量的前提下选择和使用这些工具。
第 4 步: 使用多个检测器重新检查
在重写并人性化处理之后,请将你的修订文本至少通过三种不同的检测器进行测试。我们建议使用 GPTZero、ZeroGPT 和 Copyleaks,因为它们采用不同的模型,并且能够捕捉不同的模式。
为什么要用三个? 因为没有任何单一检测器具有权威性。一段在 GPTZero 上得分 5% 的文字,在 ZeroGPT 上可能得分 30%。你的教授可能会使用其中任何一个, 或者完全不同的工具。通过检查多个检测器,你就能覆盖更广的范围。
如果你的文本在这三个检测器上的得分都低于 15%, 那么它就处于安全区间。如果某个检测器仍然标记了某一部分, 就回到该具体段落, 并应用第 2 步中的手动改写技巧。
什么不起作用
一些常见策略并不可靠,还有一些会让分数更差。
- 同义词替换式改写工具只是在保留 AI 典型句式结构的同时替换词语,而这正是检测器实际衡量的内容。经过一轮换词后,分数往往会升高。
- 字符技巧, 如不可见的 Unicode、形似字母、额外空格, 在现代检测器分析之前就会被规范化处理掉,而且有些检测器甚至会将这种操控本身标记出来。
- 通过另一种语言再翻译回来会损害意义和引文,同时仍然保留机器典型的节奏。
- 故意拼写错误会降低稿件质量,但不会改变检测器所读取的统计模式。
结构性修订是唯一能够改变检测器所衡量内容的方法, 即句子节奏、词语可预测性和段落形态。人工重写和 academic humanization 都能做到这一点,区别只在于速度。
按部分重点关注,逐段处理
论文的不同部分会以不同方式触发标记,因此把重写时间花在最关键的地方。
摘要。 往往是最容易被标记的部分,因为它本身就密集且具有公式化特征。要变化句子结构,并避免连续三句都以“This study,”、“This paper,”或“This research,”开头,这种模式是 AI 很容易使用的。
引言。 这里适合加入个人定位式表述。比如,“We became interested in this question when...” 或 “The gap became apparent during our review of...” 第一人称叙述元素对模型来说很难自然生成,也更像人类作者的写作。
方法。 这一部分本来就具有公式化特征,因此在困惑度评分中自然较低。这也是 AI 检测最不可靠、而评分者最期待严格遵循惯例的地方。重点应放在准确性上,而不是“人性化”。
结果。 用具体数字报告特定发现。“Participants in the treatment group showed a mean improvement of 3.7 points (SD = 1.2, p = 0.003)”读起来更像人写的。泛泛的总结则更像 AI。
讨论。 你的解释性声音在这里最重要。要处理相互矛盾的发现,具体而非笼统地承认局限,并将结果与你更广泛的研究计划联系起来。这些元素需要真正的专业能力,也会读起来更像真实的人类写作。
为什么一些人工撰写的文本会被标记, 误报
这里有一件让大多数人感到意外的事, 完全由人类撰写的文本也会经常触发 AI 检测器。
我们自己测试过这一点。我们选取了五段完全由人类研究人员撰写的内容, 完全没有任何 AI 参与, 然后将它们分别输入 GPTZero, ZeroGPT 和 Copyleaks。所有段落的平均 AI 得分为 18%。其中一个方法部分尽管是由一位拥有十年经验的博士后手写完成, 仍被评为 34% AI。
误报之所以会发生, 是因为学术写作与 AI 输出共享一些结构性特征。二者都倾向于正式语域, 稳定的段落结构, 以及学科内可预测的词汇。检测器无法区分“这听起来像 AI, 因为它是 AI 写的”与“这听起来像 AI, 因为它是正式的学术散文”。
这就是为什么为一个中等程度的 AI 得分而惊慌是适得其反的。即使是完全原创的作品, 出现一定程度的检测结果也很正常。若想更深入了解这些工具实际有多可靠, 请参见我们的2026 年 AI 检测准确性分析。
Grammarly、QuillBot 和其他编辑工具会提高你的 AI 分数吗?
会,而且这常常让人措手不及,因为草稿一开始完全是人写的。这些工具改变的,正是检测器所衡量的内容。
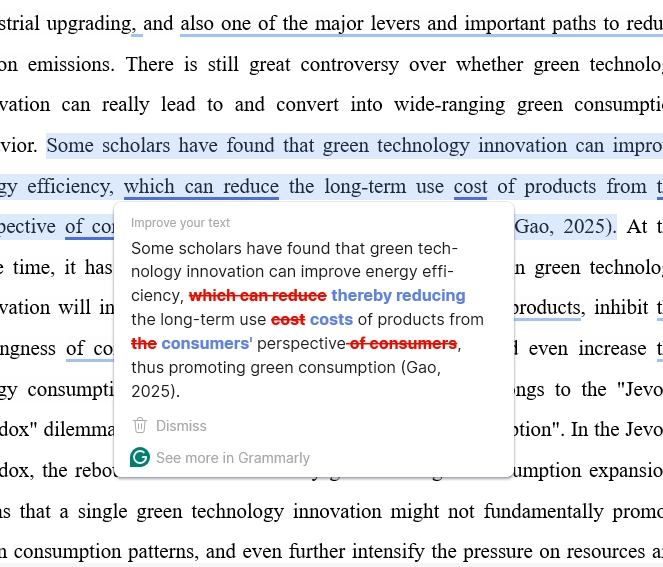
下面的截图显示了 Grammarly 正在处理一篇人写的经济学手稿。它的建议把 "which can reduce" 替换为 "thereby reducing", 并把 "the consumers' perspective" 重排为 "the perspective of consumers"。每一次替换在语法上都正确,而每一次替换都会把句子推向语言模型默认的那种流畅、正式的语域。
同样的审阅过程还建议用 "underscoring" 取代 "which highlights", 这也是学术写作中最容易被识别的 AI 典型词汇之一:
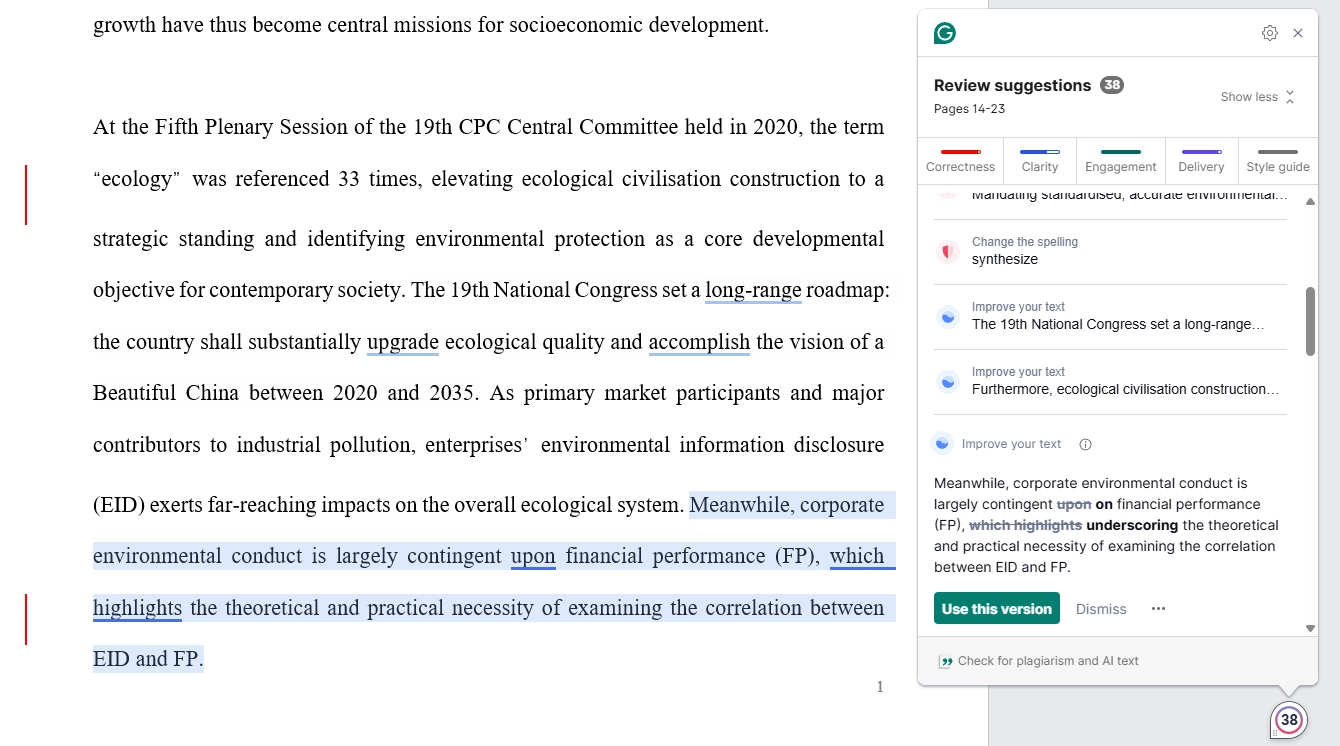
接受一条建议不会改变什么。接受几十条则会改变文档的统计特征, 句子节奏变得更统一,连接词更正式,而像 "thereby", "moreover", 和 "underscoring" 这样的词会不断累积。检测器就是给这种特征打分的,而且有些现在直接点名它。前面指南中展示过的 Scribbr 检测器,会为这类文本单独报告一个 "Human-written & AI-refined" 类别。QuillBot 的改写模式会进一步朝同一方向推进,因为把整句重写成某种固定风格,本来就是它的产品核心。
解决办法不是放弃编辑。而是使用一种能在不重塑你行文风格的情况下纠正错误的编辑器。ProofreaderPro 的 Light proofreading 模式之所以 detector safe,是因为它会把语法、拼写和标点修正为单独的跟踪更改,同时保留你的句子结构和用词不变,所以检测器所抓取的模式仍然是你的。请从 AI proofreader 进入,逐条查看每一处修改,你的分数反映的就是你的写作,而不是你的编辑工具。
现实的目标:低于 15%,而不是 0%
不要再试图达到 0%。这并不可实现,而且一味追求这一目标只会让你的写作变得更差。
0% 的 AI 分数要求文本极其零散且不可预测,以至于读起来会像拙劣的写作。检测器所寻找的统计模式,与清晰、结构良好的学术散文中的模式有很大重叠。消除所有检测信号,就意味着消除清晰性和结构。
对于学术写作来说,现实的目标是在多个检测器上都低于 15%。在这一水平下,你的文本会落在人类学术内容的正常范围内。大多数使用 AI 检测的机构会将阈值设为 20% 或更高,因为它们认识到,某种程度的模式匹配是不可避免的。
以下是我们推荐的工作流程:
- 撰写或生成你的初稿 - 无论你是如何完成的
- 用 GPTZero 运行检测,找出被标记的部分
- 手动改写得分最差的段落,使用上面的技巧
- 对顽固部分使用 text humanizer,这些部分难以通过手动改写解决
- 在三个检测器上重新检查 - GPTZero、ZeroGPT、Copyleaks
- 在三者上都将结果控制在 15% 以下,然后停止
低于 15% 的收益会递减。与其花时间追求更低的数值,不如把时间用在提升论文的实际内容和论证上。
下一次:先写作,后用 AI
从一开始就避免高分的最可靠方法,是反转典型的 AI 工作流程:先写出自己的初稿,再只用 AI 来润色。粗糙、不完美的人类初稿会带着你的句子节奏、用词选择和结构习惯,而 AI 的润色会让表面更平顺,却不会抹去这些更深层的模式。
- 根据你的笔记和研究先写一份粗略初稿,不要借助 AI
- 自己先从结构和论证上进行修改
- 让 AI 只处理具体任务:语法检查、句子清晰度、用词建议
- 审阅并调整 AI 建议,使其符合你的写作风格
- 最后通读一遍,确认文本读起来确实像你写的
从更长远来看,同样的习惯会建立最强的防线, 那就是一种独特的声音。广泛阅读你所在领域的文献,定期写作,并在思考完成后使用一个 AI 校对工具 进行润色。真正的人类写作具有模型无法复制的模式,而当文本属于你自己时,检测器也就无从捕捉。
伦理,直说
这两种情况有着实质性的区别。使用 AI 撰写一篇你声称是自己完成的论文,然后隐藏 AI 的参与,这是学术不端,而无论怎样人性化处理都无法改变这一点。将 AI 作为写作工具来帮助改进语法、清晰度和结构,然后确保输出不会被错误标记,这属于负责任地使用工具。判断标准在于智力贡献:观点、分析和论证必须属于你自己。如今,许多大学已将这一区别写入其 AI 政策,因此请检查你所在学校的规定,并在需要时披露工具使用情况。
常见问题
如何将我的 AI 百分比降到 20% 以下?
最有效的方法是手动改写被标记的部分。先用 GPTZero 这类句子级检测器检查你的文本,找出导致分数上升的具体段落,然后从头改写这些段落,不要只是做表面编辑。重点是改变句长、加入学科专门措辞,并重组段落。对于顽固部分,可以使用学术 AI humanizer。大多数学生通过一轮有针对性的改写,就能降到 20% 以下。
ZeroGPT 能检测出所有 AI 写作吗?
不能。ZeroGPT 和所有 AI 检测器一样,都有明显局限。根据独立测试,ZeroGPT 的准确率在 60-85% 之间,具体取决于文本类型以及生成它的 AI 模型。它对未经编辑的 GPT-3.5 输出表现更好,但对新模型生成的文本或经过人工修改的文本表现更差。它也会产生误报,把人类写作标记为 AI 生成,误报率在 5-15% 之间,取决于写作风格。任何 AI 检测器都不应被视为绝对可靠。
为什么即使是我自己写的,AI 分数还是很高?
在学术写作中,误报很常见,因为正式学术散文与 AI 生成文本共享一些统计特征, 比如句长一致、正式词汇、可预测的段落结构,以及主题句组织方式。方法部分和文献综述尤其容易出现误报,因为它们遵循严格的学科惯例。如果你确实是自己写的,应该记录你的写作过程,并与导师沟通,而不是为了骗过检测器去把原本不错的文字反复改坏。
大多数大学接受什么样的 AI 检测分数?
没有统一标准。不同院校之间,甚至同一所大学的不同院系之间,政策差异都很大。我们看到最常见的阈值范围是 15% 到 25%,不过有些机构会把任何高于 10% 的内容标记出来进行复核。许多大学根本不会设定硬性截止线, 它们把 AI 检测作为筛查工具,触发人工审核,而不是自动处罚。请查看你所在机构的具体政策,如果拿不准,最好在多个检测器中都把分数控制在 15% 以下。
同样的方法对 Turnitin 的 AI 分数也有效吗?
有效。Turnitin 的 AI 指标读取的也是与 GPTZero 和 Copyleaks 相同类别的统计模式,因此结构性改写会以同样方式影响它。关于 Turnitin 的具体细节,请参阅我们的 Turnitin humanizer 指南 和 Turnitin 分数指南。
在学术写作中规避 AI 检测是否符合伦理?
这取决于你如何使用 AI。如果你把 AI 作为写作辅助工具,用于语法检查、句子清晰度提升,或者组织你自己的想法,那么确保文本不会被错误标记是合理的。如果你用 AI 生成你声称属于自己知识劳动的内容,那么规避检测就是不诚实的。伦理问题在于思想本身,而不在于文本风格。请始终检查并遵守你所在机构关于 AI 使用的政策。
避免 AI 检测的最有效方法是什么?
先自己写出初稿,只把 AI 用于润色。以人类写作开始的文本,即使经过 AI 编辑,也会保留人类的写作模式。将这一点与有意的句长变化、个人写作风格注入,以及最后一次检测检查结合起来,能够产出持续通过 AI 检测器的文本。
AI 检测器对非英语文本有效吗?
用于非英语文本的 AI 检测器,其可靠性低于英文检测器。大多数商业检测器主要基于英语数据训练。如果你用其他语言写作,误报率可能更高,而且规避检测的策略也可能需要根据该语言的写作规范进行调整。
Turnitin 能检测 AI 辅助写作吗?
Turnitin 的 AI 检测会识别与 AI 生成一致的模式,但它无法区分 AI 生成文本和 AI 辅助文本。大部分由人类撰写、再由 AI 润色的文本仍然可能被标记。先自己写初稿,并显著改变句子结构,可以大幅降低误报。
在保留学术语气、引文和技术词汇的同时,降低 AI 检测评分。
Moe 是一名 NLP 工程师,拥有自然语言处理领域的 PhD 学位。 他的研究涵盖计算语言学、文本分析和机器学习,并直接反馈到 ProofreaderPro 背后的编辑和人性化模型中。 他写了大多数人从未见过的过程的一部分:语言模型如何读取句子、对其进行评分并决定更改哪些内容。


