OpenAI Watermark、SynthID 和 Claude:文本水印对比
OpenAI 会给文本加水印吗,是否有公开的 OpenAI 水印检测工具,以及 SynthID 和 Claude 的水印有何不同,为学术写作者做对比
OpenAI、Google 和 Anthropic 都已经构建了同一项技术:用于 AI 生成文本的统计水印。OpenAI 将其版本按下多年,并于 2026 年 10 月开始以 textGrain 的形式逐步推送。Google 已将 SynthID 集成到 Gemini 中,并发布了该方法。Anthropic 在 2026 年 8 月让 Claude 的水印对每位用户都变为必选。如果你以任何形式借助 AI 辅助写作,这三项决定现在都会共同影响你的文档如何被评判。
8月11日,2026年 Watermarking 从研究议题走向主流新闻,原因是 Anthropic 宣布:每一个新的 Claude 模型都会在其文本输出中做水印处理。我们在 Anthropic 的 Claude 水印,详解(2026) 中对这一公告进行了详细报道。本指南将为你呈现完整图景:什么是文本水印,它如何被三大实验室中的每一家实现或拒绝,以及每个系统能证明一段写作的哪些内容。
什么是 AI 文本水印?
AI 文本水印是隐藏在生成文本的 词语选择 中的一种统计模式,它会在生成的瞬间被植入。这样,持有正确密钥的检测器日后就能验证该文本确实来自某个特定的 AI 系统。它不是可见的标签,不是隐藏字符,也不是附加在文件上的元数据。水印就存在于这些词语本身。
这种区分很重要,因为“watermark”这个词在不同语境下经常被宽泛地用来指代三种不同的事物:
| 它是什么 | 它在哪运行 | 能在复制粘贴后仍然可用吗? | |
|---|---|---|---|
| 统计水印 | 模型选词中的偏差 | 文本本身 | 是 |
| 文件元数据(C2PA) | 带签名的溯源标签 | 文件容器 | 不,纯文本复制会把它抹掉 |
| 零宽字符 | 在文本中插入了不可见的 Unicode | 介于可见字符之间 | 不,轻易就能被剥离 |
三种方法里,只有统计水印在复制、粘贴、重新键入到新文档以及格式转换之后仍能幸存。正因为如此,三个主要实验室才都在文本领域收敛到它;也正因为如此,专门用于去除不可见字符的“水印移除器”对它毫无作用。我们的 免费 Claude 水印移除器 页面通过带有来源的内容记录了这种失效模式。
统计水印到底是如何工作的?
在写一句话的每一步,语言模型会在几个近似等价的词之间做选择,而水印会悄悄“加载”这些骰子的结果。由 Kirchenbauer 及其同事在 2023 年 1 月于马里兰大学发布的基础配方为 A Watermark for Large Language Models(ICML 2023)。它的工作方式如下:
- 在选择每个词之前,会用由前序词推导出的密钥,将词汇分成偏好集合和中性集合。
- 模型会把它的选择向偏好集合轻微“引导”。用“Suggest”而不是“indicate”。用“Across”而不是“among”。每一次单独的选择都看起来完全自然。
- 持有密钥的检测器会统计文本落在偏好集合的频率。人类写作只会因为偶然达到预期比率;而带水印的文本会频率高得多,统计检验会标记这种差异。
没有任何单个词能够证明什么。只有在几十次甚至上百次选择的层面上,信号才会显现。这也是为什么更长的段落更容易测试,也为什么检测始终是概率性的,而不是一个是或否的印章。
谷歌 DeepMind 的量产系统在 2024 年 10 月以 Nature 发表为 Scalable watermarking for identifying large language model outputs,并用一种称为“锦标赛采样”(tournament sampling)的技术加以改进。这项改进能很好地保住文本质量,使其足以在规模化的消费者产品中静默运行。该论文对谷歌之外同样重要,因为 Anthropic 在 Claude 的实现中所指向的就是它作为公开依据。
主要弱点在于,这一问题在多数部署之前就已被论文公开了。2023 年 3 月,Krishna 和团队在 Paraphrasing evades detectors of AI-generated text(NeurIPS 2023)中表明,对一段文字进行改写会让包括水印在内的多种检测方法都失效或大幅崩塌。信号只存在于精确的 token 序列之中,别处并不存在。因此,任何重写该序列的行为都会把证据改写掉,包括人类编辑在内。如今每一家发布水印的供应商,都在自己文档中声明了这一限制。
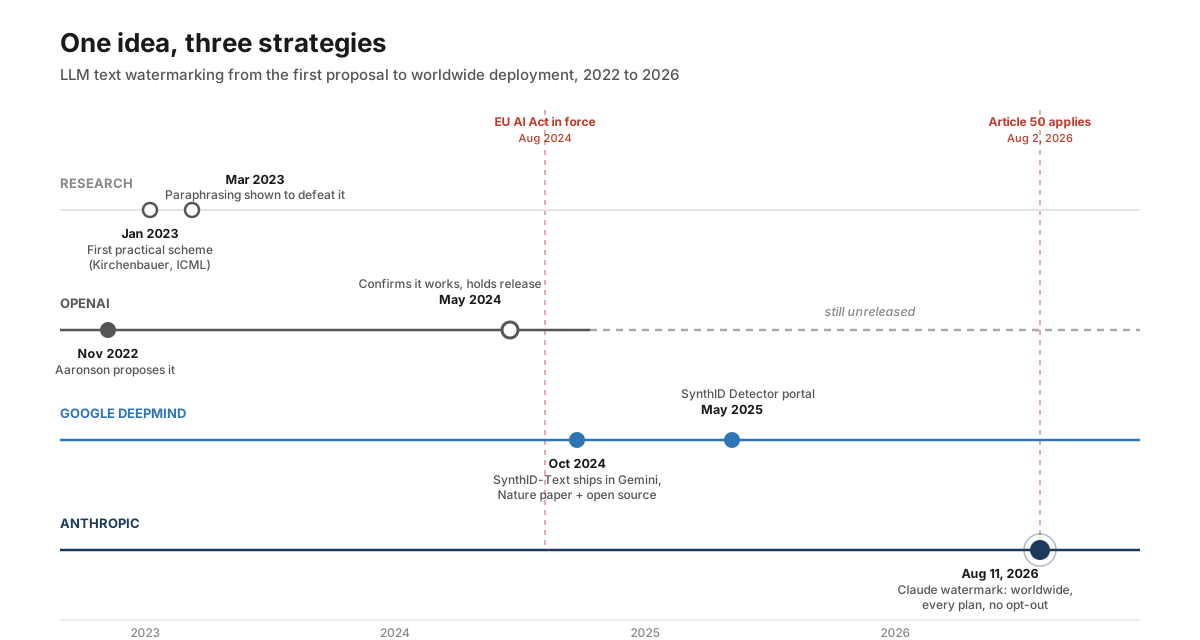
OpenAI:它发明了这一方案,并且最后才推出
OpenAI 拥有一套可运行的文字水印多年,但选择在 2026 年 10 月之前不发布。随后在 OpenAI 从事安全工作的 Scott Aaronson 曾在公开场合于 2022 年 11 月讲座 中最先描述这一想法。该方法通过一个秘密的密码学函数,在近似等价词之间对模型的选择做偏置,因此文本本身会显示其来源。该讲座的时间早于任何一个已部署系统。
2024年5月,OpenAI 在其溯源(provenance)更新中描述了该项目的进展状态, 了解我们在网上看到和听到内容的来源。该公司表示,其文本水印方法在小幅修改下准确且有效,但在权衡利弊后仍推迟了上线发布。OpenAI 提到的两项风险与学术写作者直接相关:
- 易于规避。 改写或翻译文本会移除水印,正如 2023 年的研究所预测。主要捕捉那些不知道水印存在的人,因此这是一种力度较弱的强制执行工具。
- 对非母语英语使用者造成不成比例的影响。 OpenAI 表示,水印可能会使得将 AI 作为写作辅助的合法使用在第二语言写作者中受到污名化。我们关于 为什么 AI 检测器会给非母语写作者贴标签 的文章,也从检测侧讨论了同样的问题。
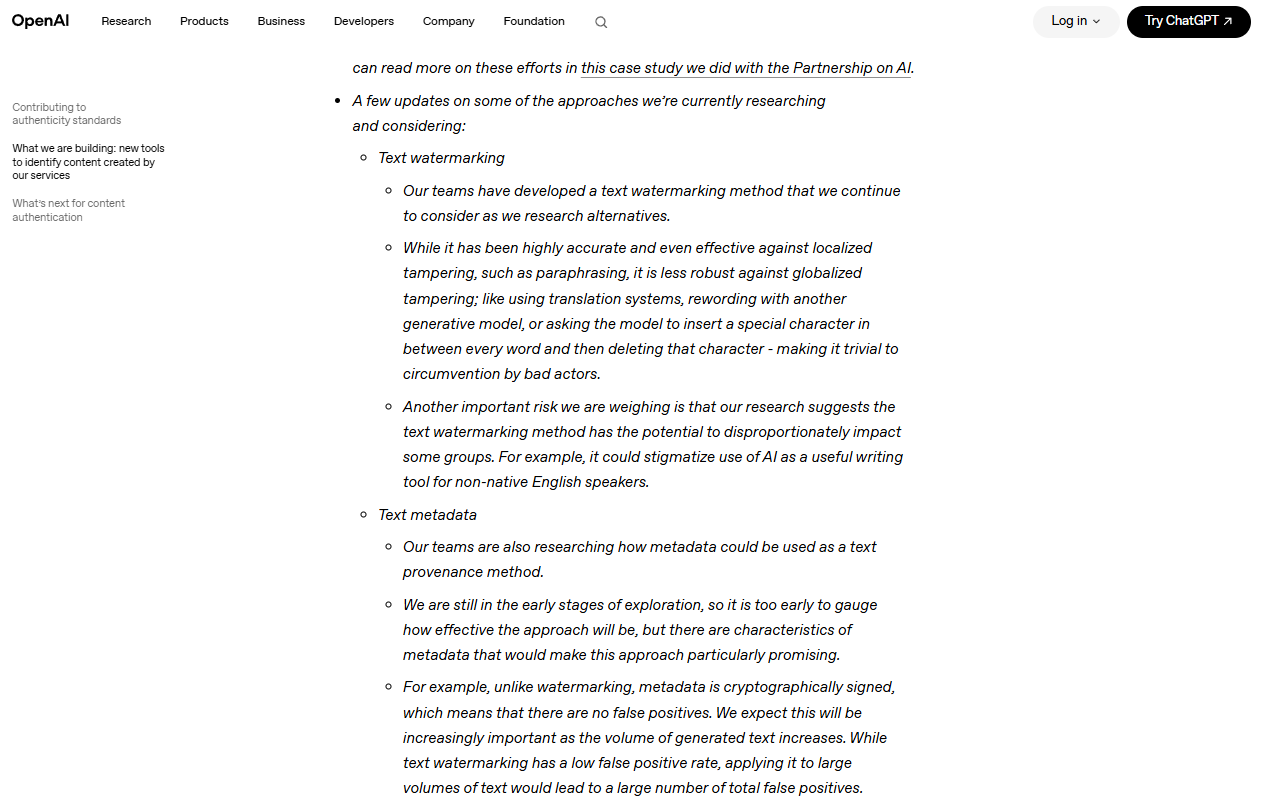
OpenAI 的 2024 年溯源更新:方法有效,而且公司列出了当时推迟上线的原因。
在图像和音频方面,OpenAI 走的是不同路线:在 DALL-E 和 Sora 的输出中使用 C2PA 溯源元数据。这是一种文件级标签,而不是内容内部的标记。至于文本,ChatGPT 的输出在 2026 年 10 月之前没有水印。提出这项技术的公司是三家公司里最后一个部署它的。
OpenAI 现在会给文本加水印吗?
是的。OpenAI 于 2026 年 10 月 5 日开始对部分文本进行水印,以回应欧盟 AI Act。其 公告 介绍了一种名为 textGrain 的文本水印,它会向模型的词选择添加不可见的统计信号。此次推广分为三个部分,而且水印并非默认对所有用户开启:
- 任何地方的 API 客户都可以为特定模型开启带水印的输出。默认情况下保持关闭。
- 在接下来的几周内,欧盟范围内符合条件的 ChatGPT 与 Codex 文本输出将获得水印,无论所选计划为何。
- 获批的研究人员以及专业组织可以申请获取文本水印检测器的访问权限。
OpenAI 表示,textGrain 的表现与或优于它测试的其他方法,包括 Google 针对文本的 SynthID。它还公布了检测何时会变弱。在 1% 的误报率下,检测器能在约 80% 的 200 词段落以及约 95% 的 400 词段落中识别出水印(心理学内容)。在数学领域的检测明显更低,因为词汇选择的自由度更小。
编辑会让信号很快变弱。在 400 词段落中,将 10% 的词替换为同义词会让检测从约 92% 降至 66%,替换 25% 则降至 17%。
OpenAI 还检查了该水印是否会在 Astra 上改变答案质量(Astra 是它最新的模型),并表示未看到有意义的差异。以下是它公布的四项基准测试:
| 基准测试 | 不带水印(Astra) | 带水印(Astra) |
|---|---|---|
| Artificial Analysis Intelligence Index | 49.57 分 | 49.76 分 |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
对学生而言,日期很重要。推广之前由 ChatGPT 生成的文本,或在未开启 API 设置的情况下不在欧盟内生成的文本,都不会有 OpenAI 水印。我们的指南 Turnitin Clarity 详解 介绍了学校在此期间如何制定自己的 AI 使用政策。
是否有公开的 OpenAI 水印检测器?
目前还没有公开的 OpenAI 文本水印检测器。OpenAI 的免费 验证工具 会检查图像和音频文件,以验证 C2PA Content Credentials 以及 SynthID 水印。OpenAI 在支持的图像和音频中嵌入 SynthID 水印。OpenAI 表示该工具不支持文本。
对于文本,OpenAI 会按个案向获批的研究人员和权威机构开放检测权限,并通过其 Content Provenance API 表单 提供。OpenAI 表示,若在发布之初就公开文本检测器,可能会因漏检水印和误报而带来风险,因此不会在启动时公开。该检测器会报告是否找到了 OpenAI 水印,但不会识别用户,也不会显示用户的提示词。
| 你想检查什么 | 工具 | 谁可以使用 |
|---|---|---|
| 一份 OpenAI 的图像或音频文件 | OpenAI 的验证工具 | 任何人,免费 |
| OpenAI 的文本输出(textGrain) | OpenAI 的文本水印检测器 | 获批的研究人员和权威机构,需申请 |
| Claude 的文本输出 | Claude 水印检测器 | 符合条件的机构,需申请(参见我们的 Claude 水印指南) |
OpenAI 也明确了它无法告诉你什么。检测到水印并不能衡量某个人贡献了多少,也无法识别是谁撰写或使用了这段文本。即使没检测到水印,也不能证明文本一定是人类作者写的,因为文本可能太短,可能被编辑、翻译,或来自不支持的模型。
Google:先推出再公开方案
Google DeepMind 率先完成,并在完全公开后将方法开放出来。它的系统 SynthID 最初是用于图像水印的方案,于 2023 年启动,随后在 2024 年扩展到文本。到 2024 年 10 月 Nature 论文发表时,SynthID-Text 已经在生产环境中运行于 Gemini 之内,这使它成为首个以消费者规模部署的统计型文本水印。
SynthID 覆盖文本、图像、音频和视频,并且自 2024 年 10 月起已在 Gemini 的文本输出中上线运行。
随后,Google 将实现方案作为 Hugging Face 上的开源项目 发布,让任何开发者都能将相同的水印方案应用到自己的模型中。2025 年 5 月,它又宣布了 SynthID Detector,一个验证门户,能够在文本、图像、音频和视频中检查内容是否带有 SynthID 标记。
有一个适用范围限制很关键:SynthID 只对 Google 自家模型生成的内容进行标记,并且只检测这些内容。它对 ChatGPT 或 Claude 的输出没有任何说明。一次干净的 SynthID 扫描也不能证明文本是人类撰写的。它只能说明:Google 的模型没有生成该文本,这个结论要狭窄得多。
Anthropic:最晚行动,政策最严格
Anthropic 的部署最晚,但覆盖范围最广。自 2026 年 8 月 2 日当天或之后发布的每一个 Claude 模型,都会在其文本输出中嵌入统计型水印,覆盖全球范围、所有套餐,并且没有选择退出。公司在其说明文中描述了这一机制,Claude 文本水印如何工作,并在帮助中心文章 Claude 如何标记 AI 生成内容 中说明政策适用范围:Claude API、claude.ai、Claude Code、Claude Cowork 和 Claude Tag 全都在覆盖范围内。截止日期之前发布的模型处于过渡期,Anthropic 表示也会为这些模型逐步加入标记支持。除了统计型标记外,Claude 生成的文件还会附带 C2PA 元数据,这是另一套独立系统,纯文本复制会导致其丢失。
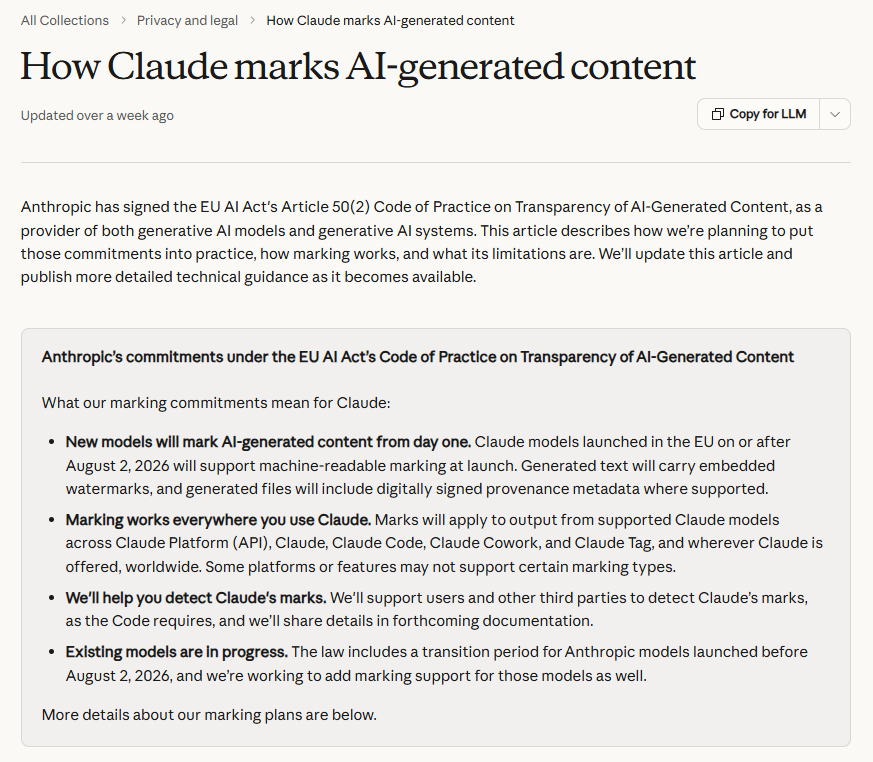
以 Anthropic 自己的表述为准:每一个新模型,每一个平台,全球范围内,较旧模型会被逐步加入。
Anthropic 的文档明确写出了限制:检测是概率性的。该标记无法区分一份由 Claude 编写的文档与一份由人类撰写但仅被 Claude 轻度编辑后的文档。彻底重写会消除它。我们把这些都逐一讲清楚,包括正向检测到底能证明什么,以及当你的写作被标记时该怎么办,见 专门的 Claude 水印指南.
时间安排遵循监管要求。Anthropic 已签署 EU AI Act 下的《第 50(2) 条透明度 AI 生成内容行为准则》,该准则要求生成式 AI 系统的提供者确保输出以“机器可读格式进行标记,并能够被识别为人工智能生成内容”。这些透明度义务自 2026 年 8 月 2 日起适用:即 Anthropic 模型政策中规定的精确截止日期,比公开公告早九天。Anthropic 选择在全球范围内遵从,而不是为欧盟流量维持不同的行为。Google 已通过设计实现合规。OpenAI 未标记的文本输出是否能在 2027 年实现合规,仍是一个公开合规问题。
三种方案并排对比
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| 部署了文本水印吗? | 是(textGrain,欧盟自 2026 年 10 月 5 日起推广) | 是(Gemini,自 2024 年 10 月起) | 是(Claude 模型自 2026 年 8 月 2 日起) |
| 技术 | textGrain,一种基于词语选择的统计信号 | SynthID-Text 竞赛式采样 | 统计采样标记,类似 SynthID |
| 覆盖范围 | 欧盟内符合条件的 ChatGPT 与 Codex 文本;API 全球范围内可选择启用 | 仅限 Google 模型 | 所有新的 Claude 模型;较旧模型处于过渡期 |
| 可关闭/退出 | API 默认关闭 | 否 | 否 |
| 公开检测器 | 否 | SynthID Detector 入口(2025) | 计划中,尚未发布 |
| 方案是否已公开? | 仅概念讲座 | Nature 论文 + 开源 | 解读,基于已发表的研究 |
| 文件元数据(C2PA) | 是的,针对图片和音频 | 是的,覆盖多种媒体 | 是的,针对生成文件 |
| 明确的局限 | 规避行为,ESL 污名 | 范围仅限于自家模型 | 概率性,编辑会模糊署名 |
专栏之间的共同点:OpenAI 将文本水印视为仍待解决的政策问题,Google 将其视为基础设施并推动标准化,Anthropic 则将其视为必须完整落地的合规义务。
这对研究人员和学术写作者意味着什么
实际后果取决于哪些工具接触了你的文本。如果你使用 ChatGPT 进行起草,那么你的文本在今天不会带有水印。如果你使用 Gemini 进行起草,那么它会带有 SynthID 标记,而且只有 Google 的检测器能读取。如果你使用当前版本的 Claude 模型进行起草或编辑,那么它会带有 Anthropic 的标记,并且没有任何设置能关闭这一点。
学术写作者需要知道的三件事:
水印用于识别工具,而不是识别作者。 每家供应商都会在其自身文档中声明这一点,而且值得反复强调,因为机构层面的政策并不总能区分开。文本可能会被标记,因为其中内容由 AI 起草,也可能因为 AI 对其中两句做了校订,或因为引用了某段被标记的文字。如果你的机构会进行水印检查,那么该检查证明的是某个特定模型在某个时间点接触过该文本,仅此而已。我们的指南 对错误的 AI 检测标记提出申诉 会说明在关键时刻如何据此展开论证。
水印和 AI 检测是两种不同技术,且失败方式各不相同。 像 Turnitin 或 GPTZero 这类检测器会根据统计写作风格作出猜测,也会存在我们已记录的 准确性问题。水印检测是一种基于密钥的测试,在未标记的人类文本上具有极低的误报率。对于漏报则呈现相反的不对称:水印检查会遗漏任何来自不进行水印标记的模型的 AI 文本。就目前而言,这包含所有 ChatGPT 的内容。
披露仍然是最强的立场。 水印会让“静默”使用 AI 的风险更高,而披露的 AI 使用更安全,因为披露的工作流程不必担心正向标记。如今,大多数期刊和大学都制定了明确的 AI 使用政策;我们的 AI 使用政策 解释了我们如何在自家工具之间划定界限,这也可以作为透明使用的合理范本。
移除文本水印的做法是什么,以及哪些做不到
重写可以移除,重新排版不行。复制、粘贴、更换字体、在文件格式之间转换,以及移除不可见字符,都不会让统计水印消失,因为水印存在于词语选择之中。能够移除它的,是任何会重新生成措辞的操作:深度的人工作业编辑、翻译,或真正的意写转述。正如在这些系统尚未推出之前,NeurIPS 2023 的稳健性研究 已经证明。
这里的两个方向都同样重要。标记消失并不意味着文本属于你,而标记仍然存在也不意味着文本不属于你。改写后的 AI 稿件仍然是一份由 AI 协助的文档,且你所在机构的披露规则同样适用。我们的 AI text humanizer 会将由 AI 协助的草稿改写为自然的学术表达,而且因为该过程会重新生成 token 序列,统计性标记不会在其中保留下来。针对 Claude 文本,具体来说,免费 Claude 水印移除工具 会在保持事实、数字和引用不变的同时,用全新的措辞重新表达每一句话。工具无法改变的只有一件事: 你对读者所负的责任,也就是如实披露该文档是如何生成的。
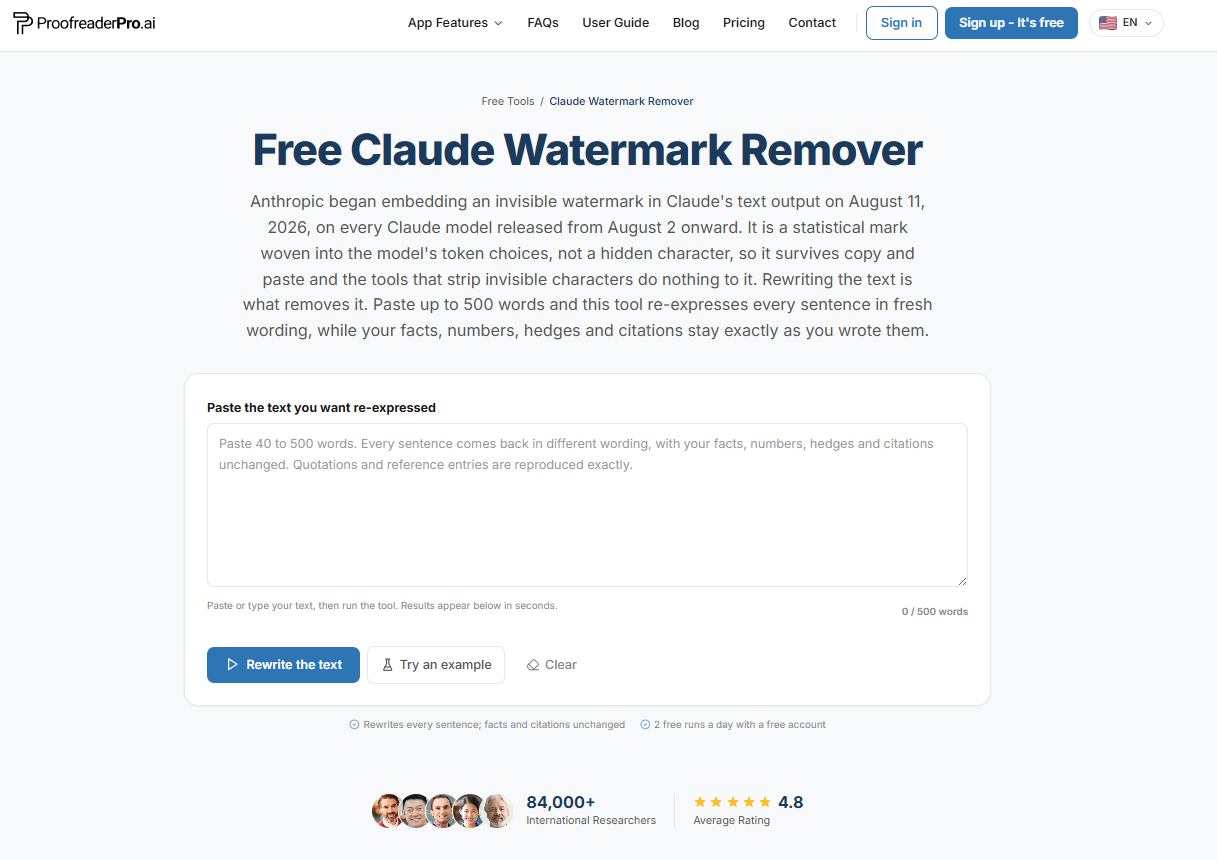
改写是唯一能移除统计性标记的操作,而这项工具逐句就做到了这一点。
下一步会发生什么
请在 2027 年之前持续关注三件事。第一,OpenAI 是否将 textGrain 推进到欧盟之外: 之所以从那里开始,是因为欧盟对《第 50 条》的执行要求在 AI 文本上使用可被机器读取的标记。第二,检测是否会收敛。如果每家主要实验室都用一个已发布的方案进行水印,大学就可以用密钥进行核验,而不是仅凭写作风格去猜测,这将比今天这种容易误报的 检测 更可靠。第三,标记是否会变得兼容。今天,三家实验室使用三种不同的标记方案,而且没有任何一个单独的校验流程能覆盖全部情况。C2PA 会弥补文件层面的空白,但目前尚无任何方案能覆盖原始文本。
ChatGPT 会给它的文本加水印吗?
是,部分情况下。自 2026 年 10 月 5 日起,OpenAI 开始向欧盟境内符合条件的 ChatGPT 和 Codex 文本加入 textGrain 水印,而任何地点的 API 客户都可以开启。该水印是一个出现在措辞选择中的统计信号,不包含隐藏字符。OpenAI 还会对 DALL-E 和 Sora 的媒体文件应用 C2PA 来源元数据,这是另一套针对文件级别的系统。
Google Gemini 会给它的文本加水印吗?
是。自 2024 年 10 月起,Gemini 输出一直携带 Google DeepMind 的 SynthID-Text 水印。这是一种出现在措辞选择中的统计性标记,对读者不可见,并可通过 Google 的 SynthID 检测器进行核验。它只适用于 Google 自家的模型,因此一次 SynthID 为否的结果并不能说明其他 AI 系统的文本。
Claude 会给它的文本加水印吗?
是。自 2026 年 8 月 2 日当天或之后发布的每个 Claude 模型起,它都会在其文本输出中嵌入统计性水印,并且适用于所有平台与套餐,没有可选择退出的选项。除此之外,Claude 生成的文件还会额外携带 C2PA 元数据。该日期之前发布的模型目前还不会标记其输出,Anthropic 表示它正在过渡期内为这些模型加入标记支持。全部细节见我们的 Claude 水印说明。
大学能检测 AI 水印吗?
只有在供应商合作的前提下,因为检测需要供应商的密钥。Google 为 SynthID 内容提供了一个公开的检测入口。Anthropic 表示,计划为用户与第三方提供检测支持,但目前尚未发布公开检测器。由于目前没有主流的查重套件能够从任何实验室验证统计性水印,因此今天机构所谓的“AI 检测”仍然主要是基于风格的猜测,而不是水印核验。
AI 水印是否需要依法要求?
在欧盟,基本上是的。欧盟《人工智能法案》(EU AI Act)第 50(2) 条要求生成式 AI 提供商确保输出以机器可读的格式进行标记,并且能够被识别为人工智能生成,同时适用的透明度义务将从 2026 年 8 月 2 日起生效。Anthropic 签署了相关《行为准则》(Code of Practice),并选择进行全球范围合规。2027 年值得关注的问题是:监管机构将如何看待 OpenAI 尚未发布的文本水印。
AI 水印能在翻译中存活吗?
不可以。统计型水印存在于模型所选择的那串确切单词之中,而翻译会替换每一个词。这同样适用于深度改写和大量人工编辑。该限制已在同行评审文献中有记录,并被发布水印的每一家厂商所承认。
是否有面向公众的 OpenAI 文本水印检测器?
没有。OpenAI 的公开验证工具只检查图像和音频文件,涵盖 C2PA 元数据和 SynthID 水印。OpenAI 表示它不支持文本。其文本水印检测器仅对获批的研究人员和专业机构开放,具体由个案决定。
textGrain 是什么?
textGrain 是 OpenAI 的文本水印,于 2026 年 10 月 5 日发布。它在模型对词的选择中加入不可见的统计信号,因此该标记成为词语本身的一部分,而不会包含隐藏字符或文件元数据。OpenAI 表示它在其测试中达到了或超过了其他方法(包括面向文本的 SynthID),并且它认为编辑会削弱水印强度。
研究人员能申请使用 OpenAI 的文本水印检测器吗?
可以。获批的研究人员和专业机构可以通过 OpenAI 的 Content Provenance API 表单申请。OpenAI 会在欧盟《行为准则》(Code of Practice)的框架下逐案授予访问权限。它表示,随着技术与证据的发展,将重新评估是否扩大访问范围。
来源
- Anthropic,Claude 的文本水印如何工作,2026 年 8 月
- Anthropic 帮助中心,Claude 如何标记 AI 生成内容,2026 年
- OpenAI,了解我们在网上所看到和听到内容的来源,2024 年 5 月
- Google DeepMind,SynthID
- Dathathri 等,用于识别大型语言模型输出的可扩展水印方法,Nature,2024 年 10 月
- Google,SynthID 检测器发布公告,2025 年 5 月
- Hugging Face,推出 SynthID Text,2024 年 10 月
- Kirchenbauer 等,大型语言模型的水印方法,ICML 2023
- Krishna 等,改写可绕过对 AI 生成文本的检测,NeurIPS 2023
- Scott Aaronson,我为 UT 有效利他主义做的 AI 安全讲座,2022 年 11 月
- 欧洲联盟,AI Act 第 50 条
- C2PA,内容溯源与真实性联盟
Dana 是 ProofreaderPro 的内容创作者,负责日常博客和写作业务。 她撰写有关在线编辑平台如何运作的文章,每天处理客户消息,并获得了五星级的满意度评分。