
Humanizer IA pour des chercheurs colombiens rédigeant en anglais
Humanizer IA pour des chercheurs colombiens. Réduisez les signalements erronés de détection d’IA sur un anglais influencé par l’espagnol : conservez le sens et les citations, et signalez honnêtement l’usage de l’IA.

Le pays produit environ 25 000 à 30 000 articles indexés dans Scopus par an, ce qui le place au rang mondial 45 à 50 en termes de production de connaissances scientifiques. Il y parvient grâce à un investissement en R&D d’environ 0,3 % du PIB, ce qui signifie que les scientifiques colombiens accomplissent beaucoup avec très peu. Et presque tout ce travail doit ensuite être publié dans des revues internationales rédigées en anglais.
C’est précisément là qu’un humanizer IA pour des chercheurs colombiens trouve sa place. Beaucoup d’universitaires ici lisent l’anglais avec aisance dans leur domaine, mais l’écrivent plus lentement. La Colombie se situe à 485 sur l’EF English Proficiency Index, au 69e rang mondial dans la catégorie « Moderate Proficiency » ; dans les manuscrits colombiens, l’anglais soigneux, standard et conforme aux règles des manuels est donc la norme.
Voici la partie inconfortable. Cette exactitude méticuleuse est exactement ce que les détecteurs d’IA interprètent comme une écriture automatisée. Une phrase propre, seconde langue, construite à partir de mots courants et de formulations prévisibles, peut déclencher le même signal qu’un texte collé depuis un chatbot. Le travail réel de chercheurs réels se retrouve piégé.
Le humanizador de texto de IA pour investigadores colombianos
Notre humanizador de texto de IA aide les investigadores colombianos à publier en inglés avec plus de sécurité. Il conserve le sens, la terminologia técnica et les citas de votre manuscrit, et réduit le risque qu’une rédaction soignée en deuxième langue soit confondue avec du texte généré par une machine.
En termes simples : vous écrivez la science, et le humanizer aide votre prose à sembler écrite par une personne, parce qu’elle l’est. Il ne fabrique pas de contenu et ne cache pas que vous avez utilisé des outils d’IA. Il protège votre écriture attentive contre un signal injuste, puis vous laisse décider de la divulgation.
L’objectif est la justesse pour un travail authentique, et non la dissimulation. Vous conservez vos citations, vous conservez vos résultats, et vous restez dans les règles d’intégrité définies par votre université et la revue visée.
Rédiger en espagnol ? Le humanizer le détecte et le réécrit aussi
Vous pouvez humaniser un brouillon espagnol sans le traduire d’abord en anglais. Collez votre texte : ProofreaderPro détecte automatiquement la langue, puis le fait passer par un modèle sensible à l’espagnol qui conserve les accents, la terminologia y las citas en place. En tant que humanizador de texto de IA, il modifie le rythme de votre prose espagnole tout en préservant chaque résultat et chaque référence. La détection automatique couvre plus de soixante langues ; ainsi, l’espagnol est traité comme de l’espagnol plutôt que d’être remodelé en anglais.
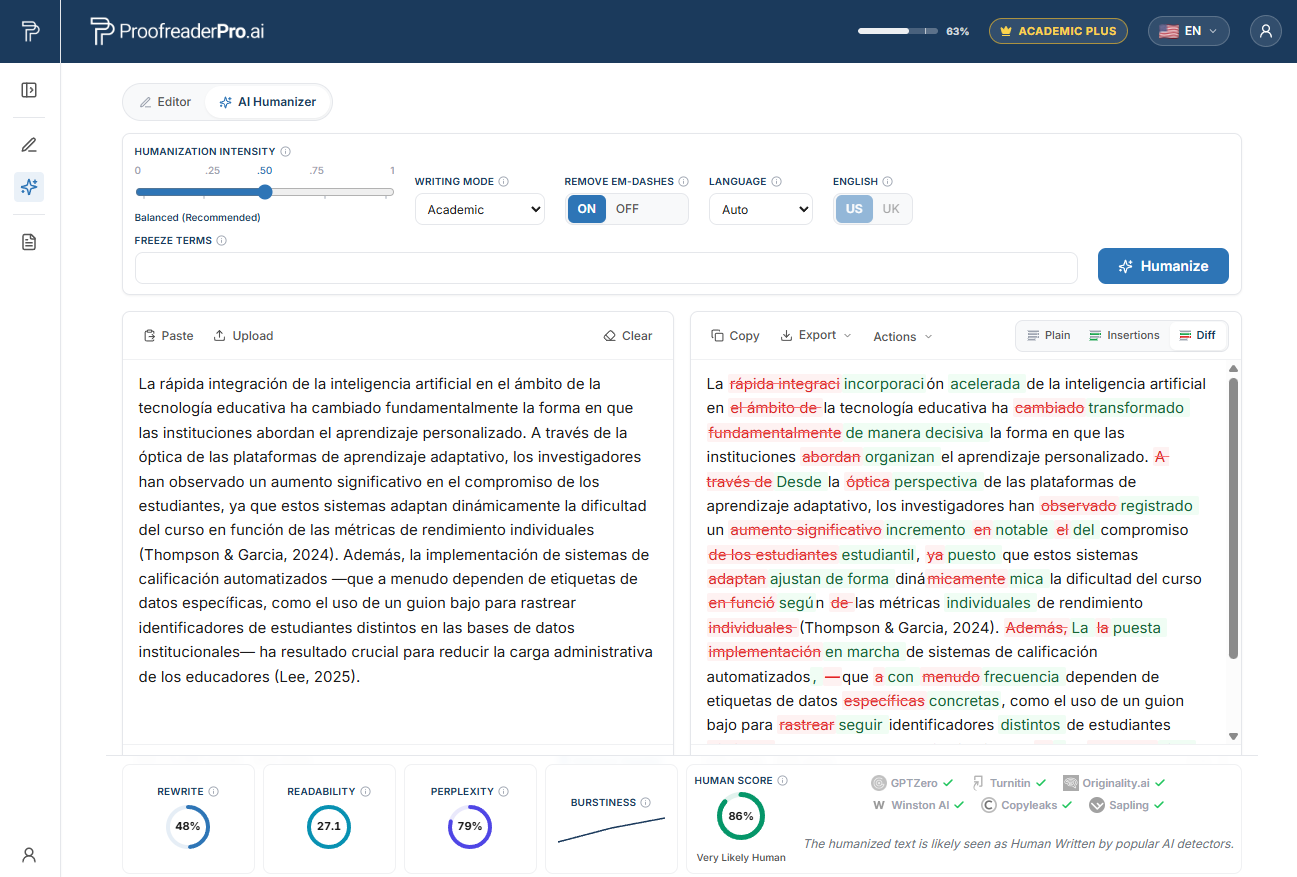
Le ProofreaderPro AI Humanizer réécrivant un texte académique en espagnol. La différence avant/après conserve votre sens et vos citations, et les vérifications du détecteur confirment une lecture naturelle et humaine.
Pourquoi des chercheurs colombiens sont signalés par des détecteurs d’IA
En 2023, une équipe de Stanford menée par Liang et ses collègues a publié une étude dans la revue Cell Press Patterns intitulée « GPT detectors are biased against non-native English writers ». Ils ont fait passer des dissertations TOEFL écrites par des humains à travers sept détecteurs largement utilisés. Chaque dissertation avait un auteur humain.
En moyenne, environ 61 % des dissertations non natives ont été signalées comme de l’IA, contre environ 5 % pour les auteurs natifs anglophones. Près d’un cinquième des dissertations non natives, soit environ 19,8 %, a été signalé par chacun des détecteurs à la fois. Ce n’étaient pas des textes générés par une IA : il s’agissait d’écritures humaines qui étaient simplement rigoureuses et standard.
Le mécanisme est la « perplexity ». De nombreux détecteurs évaluent à quel point le prochain mot est surprenant pour un modèle de langage. Les auteurs natifs et fluides dispersent des expressions idiomatiques et des tournures inhabituelles, ce qui augmente la perplexité. Les auteurs en deuxième langue choisissent le mot sûr, courant et correct, ce qui la réduit. Une faible perplexité se lit comme un texte produit par une machine. Nous avons rédigé une explication plus complète dans pourquoi les détecteurs d’IA signalent les auteurs non natifs, et elle correspond presque parfaitement aux universitaires hispanophones.
Les schémas en première langue espagnole à l’origine des faux signaux
Les hispanophones ne commettent pas d’erreurs aléatoires en anglais. Ils produisent des constructions systématiques et structurées, et plusieurs de ces schémas sont tout à fait corrects en anglais, tout en donnant l’impression d’être trop standard. Voici ceux qui font baisser la perplexité.
Discipline des articles avec des noms abstraits. L’espagnol utilise largement les articles définis ; un écrivain colombien réfléchit donc soigneusement à chaque « the » avant un nom abstrait. Lorsqu’il s’auto-corrige vers un anglais naturel (« poverty affects education » plutôt que « the poverty affects the education »), il se retrouve avec la formulation la plus simple possible. Correcte, soignée et à faible perplexité.
Placement des adjectifs. L’espagnol place les adjectifs après le nom (« resultados significativos »). Les auteurs qui inversent consciemment l’ordre en anglais tendent à choisir des constructions conservatrices et sans ambiguïté plutôt que de risquer une accumulation étrange de modificateurs. Un ordre des mots « safe » se lit comme prévisible pour un détecteur.
Éviter les faux amis. Comme « actual » signifie actuel, « realizar » veut dire accomplir/mettre en œuvre, « eventualmente » signifie occasionnellement, et « sensible » signifie sensible, les auteurs colombiens prudents apprennent à éviter le cognat risqué et à choisir à la place le verbe anglais le plus direct. Ce vocabulaire délibérément prudent est précisément le choix de mots courants qui abaisse la perplexité.
Prudence sur les temps. Le present perfect en espagnol (he analizado) ne correspond pas à l’anglais simple past. Les auteurs qui se sont entraînés à écrire « We collected the data in 2023 » produisent des phrases méthodologiques propres, conformes aux manuels. Le « textbook » est le problème ici, pas la grammaire.
Précision des prépositions. Après correction sur « consist in » versus « consist of », ou « depend of » versus « depend on », les chercheurs s’en tiennent strictement à la collocation standard à chaque fois. Cohérent, correct et prévisible.
Aucune de ces caractéristiques n’est une erreur que le détecteur parvient à repérer. Ce sont les marques d’un rédacteur discipliné en deuxième langue, et le détecteur ne peut pas distinguer la discipline d’une production machine.
Le contexte de la détection d’IA et de Turnitin en Colombie
Les thèses colombiennes et les soumissions aux revues sont souvent contrôlées avec Turnitin ou iThenticate pour la similarité textuelle, et ces deux plateformes affichent désormais des indicateurs de rédaction par IA en plus du score de similarité traditionnel. La plupart des universités colombiennes et leurs conseils éditoriaux font passer les manuscrits et les mémoires par l’un de ces systèmes avant une soutenance ou une décision éditoriale.
Il est toutefois utile de savoir à quel point le « score IA » est fragile. Vanderbilt a désactivé le détecteur d’IA de Turnitin en 2023, en citant des faux positifs et un biais contre les auteurs non natifs, et Michigan State, UT Austin, Northwestern, Pittsburgh, SMU et Waterloo ont pris des mesures similaires. Turnitin lui-même supprime les scores dans la plage de 1 à 19 %, en affichant un astérisque au lieu d’un nombre, et avertit que son score ne doit pas être utilisé seul pour décider d’un cas d’intégrité.
Ainsi, un signal est une affirmation que vous pouvez contester, et non un verdict. Dans le même temps, les financeurs et les revues demandent de plus en plus aux auteurs de divulguer comment ils ont utilisé des outils d’IA. La bonne démarche consiste à protéger l’écriture attentive contre un faux signal, tout en divulguant une aide réelle par IA, les deux en même temps.
Humanisez votre propre brouillon, conservez chaque citation
Protégez une rédaction espagnol vers anglais soignée contre une fausse alerte d’IA. Préservez votre intention, votre terminologie et vos références, puis divulguez votre utilisation de l’IA comme l’exige votre revue.
Essayez gratuitement le HumanizerLes principales universités colombiennes et où apparaissent les contrôles IA
La production de recherche en Colombie se concentre dans un ensemble d’universités publiques et privées bien connues, et chacune d’entre elles effectue des contrôles de similarité et d’indicateurs d’IA sur les thèses et les manuscrits avant l’obtention du diplôme ou la publication.
- Universidad Nacional de Colombia (UNAL), Bogota, la plus grande et la plus productive université de recherche du pays, avec des campus à Bogota, Medellin, Manizales et Palmira.
- Universidad de los Andes (Uniandes), Bogota, la première université privée du classement, forte en ingénierie, économie et physique.
- Universidad de Antioquia (UdeA), Medellin, une grande université publique avec de nombreux groupes de recherche classés par Minciencias.
- Pontificia Universidad Javeriana, Bogota et Cali, une université jésuite de premier plan avec une production étendue en médecine et sciences de l’environnement.
- Universidad del Valle (Univalle), Cali, la principale université publique du sud-ouest.
- Universidad Industrial de Santander (UIS), Bucaramanga, reconnue pour l’ingénierie, les sciences pétrolières et la chimie.
- Universidad EAFIT, Medellin, une université privée avec des programmes en croissance en ingénierie et sciences appliquées.
- Universidad del Norte (Uninorte), Barranquilla, la principale université privée de la côte caraïbe.
- Universidad de Caldas, Manizales, forte en sciences agricoles et en santé.
- Universidad del Cauca, Popayan, une université publique historique avec une capacité de recherche en développement.
- Escuela de Ingenieria de Antioquia (EIA), Medellin, une institution spécialisée en ingénierie et sciences biomédicales.
- Universidad del Rosario, Bogota, l’une des plus anciennes universités des Amériques, forte en droit, médecine et économie.
Dans chacune de ces institutions, la pression est la même : publier dans des revues internationales en langue anglaise afin de faire avancer une classification Minciencias. Cela rend un résultat équitable de détection d’IA un enjeu concret de carrière, plutôt qu’une question abstraite.
Comment le humanizer IA pour des chercheurs colombiens fonctionne
Le processus est simple, et rien n’implique de masquer votre travail. Voici comment fonctionne, en pratique, le humanizer IA pour des chercheurs colombiens.
D’abord, rédigez. Beaucoup de chercheurs ici pensent et construisent un plan en espagnol, où l’argument coule plus naturellement, puis traduisent en anglais. Cela convient. Ensuite, corrigez la grammaire, les choix d’articles, les faux amis et les prépositions, pour que la science soit propre. Troisièmement, faites passer votre brouillon assisté par IA par le humanizer de texte. Il fait varier votre rythme et votre choix de mots, élimine une cadence répétitive ainsi que des tirets isolés, et conserve exactement votre sens, vos termes techniques et vos citations à l’endroit où vous les placez.
Que pouvez-vous attendre du point de vue du détecteur ? Testé par rapport aux principaux détecteurs, notre humanizer réécrit le texte d’IA sous une forme plus naturelle et humaine : cela réduit le signal d’IA et améliore ses chances face à des détecteurs plus stricts, tout en maintenant une grande exactitude grammaticale sur le texte académique. Ce sont des résultats issus de tests, pas des garanties. Les détecteurs se réentraînent tous les quelques mois : nous décrivons donc ce que nous avons mesuré, sans jamais promettre de « contourner » quoi que ce soit ni affirmer qu’un texte est 100 % indétectable.
Ensuite, divulguez. Ajoutez la déclaration d’utilisation de l’IA exigée par votre institution et la revue visée. Humaniser votre propre prose attentive et divulguer votre usage de l’IA ne sont pas en contradiction. Ensemble, ils vous permettent de rester dans les règles d’intégrité, tout en protégeant une véritable écriture en deuxième langue contre un faux positif. Si vous souhaitez aussi une étape de relecture orientée vers le lecteur humain, notre édition académique pour des chercheurs colombiens couvre ce volet, et cet article s’inscrit dans notre vaste hub d’humanizers IA multilingues.
Organismes locaux de financement, revues et attentes en matière de divulgation de l’IA
Minciencias (Ministerio de Ciencia, Tecnologia e Innovacion) gère le système de classification des chercheurs en Colombie, en répartissant les universitaires en catégories Investigador Junior, Asociado, Senior et Emerito. Chaque niveau supérieur exige une publication soutenue dans des revues indexées, les productions Scopus et Web of Science étant les plus fortement pondérées. Les groupes de recherche Colciencias désormais administrés par Minciencias sont classés A1, A, B, C et D selon des indicateurs de productivité similaires, et le rang d’un groupe détermine son accès à un financement concurrentiel.
Comme la publication internationale constitue la « monnaie » de l’ensemble du système, l’anglais dans vos manuscrits, demandes de subvention et réponses aux évaluateurs doit être à la fois correct et naturel. Un faux signal d’IA sur une soumission peut bloquer précisément la publication dont une amélioration de classification dépend.
La situation en Colombie illustre à quel point le système est devenu « anglais d’abord ». Le pays dispose de certaines revues très réputées. Colombia Medica (Universidad del Valle) figure à la fois dans PubMed et Scopus. D’autres exemples incluent Revista Colombiana de Quimica (Universidad Nacional de Colombia), Ingenieria y Competitividad (Universidad del Valle), Revista Colombiana de Ciencias Pecuarias (Universidad de Antioquia), Universitas Scientiarum (Pontificia Universidad Javeriana) et Boletin de Investigaciones Marinas y Costeras (INVEMAR). Il y en a bien d’autres dans SciELO Colombia. Malgré leur utilisation de l’espagnol, la plupart exigent encore un anglais soigné pour soumettre et être sélectionné pour Scopus ou Web of Science.
Au fil de l’ensemble de ces financeurs et revues, la divulgation de l’usage de l’IA passe d’optionnelle à attendue. Prévoyez d’indiquer clairement votre utilisation de l’outil. Lancer le humanizer sur votre propre brouillon, puis divulguer cette utilisation, constitue la combinaison qui résiste à l’examen.
Foire aux questions
Q : L’utilisation d’un humanizer IA pour des chercheurs colombiens est-elle considérée comme de la triche ?
Non, tant que vous humanisez votre propre brouillon assisté par IA, puis divulguez votre usage de l’IA de la manière exigée par votre institution et la revue. L’outil préserve votre sens et vos citations, et aide une écriture soigneuse en deuxième langue à éviter un faux signal. Il ne sert pas à dissimuler un travail fabriqué ni à cacher que vous avez utilisé de l’IA.
Q : Le humanizer garantira-t-il que mon article passe Turnitin ou GPTZero ?
Non, et méfiez-vous de toute personne qui promet l’inverse. Testé par rapport aux principaux détecteurs, notre humanizer réécrit le texte d’IA sous une forme plus naturelle et humaine, ce qui réduit le signal d’IA et améliore ses chances face à des détecteurs difficiles, même si aucun outil ne peut garantir un résultat spécifique. Les détecteurs se réentraînent fréquemment : nous rapportons donc ce que nous avons mesuré, plutôt que de promettre un résultat.
Q : Pourquoi les détecteurs signalent-ils une rédaction académique soignée espagnol → anglais ?
Parce que de nombreux détecteurs évaluent la perplexity, c’est-à-dire le degré de prévisibilité de vos choix de mots. Les rédacteurs disciplinés en deuxième langue utilisent des mots courants et des formulations standard, ce qui se lit comme une faible perplexité et donc comme quelque chose de « machinal ». L’étude de Stanford a trouvé que des dissertations non natives écrites par des humains ont été signalées à environ 61 % contre environ 5 % pour les auteurs natifs, ce qui met clairement en évidence le biais.
Q : Le humanizer modifie-t-il mes citations ou mes termes techniques ?
Non. Il préserve vos références, votre terminologia spécifique à votre discipline et vos résultats, et ne fait varier que le rythme et le choix des mots. Vos citations APA, Vancouver, IEEE ou autres restent intactes : rien dans vos preuves ou votre attribution ne change.
Q : Puis-je rédiger d’abord en espagnol et tout de même utiliser le humanizer ?
Oui. De nombreux chercheurs colombiens planifient et raisonnent en espagnol, puis traduisent en anglais avant de finaliser et de peaufiner. Le humanizer agit sur votre brouillon en anglais après la traduction et la relecture : il lisse la prose tout en conservant intégralement l’argument que vous avez construit en espagnol.
Humanisez votre propre ébauche académique assistée par IA, préservez le sens et les citations, et protégez votre rédaction espagnol vers anglais soignée contre des signaux de détection d’IA injustes, puis divulguez-le avec assurance.

Moe est un ingénieur NLP avec un PhD en traitement du langage naturel. Ses recherches portent sur la linguistique informatique, l'analyse de texte et l'apprentissage automatique, et elles ont directement alimenté les modèles d'édition et d'humanisation derrière ProofreaderPro. Il écrit sur la partie du processus que la plupart des gens ne voient jamais : comment un modèle de langage lit une phrase, la note et décide quoi changer.


