
انسانیساز هوش مصنوعی برای پژوهشگران سریلانکایی که به انگلیسی مینویسند
انسانیساز هوش مصنوعی برای پژوهشگران سریلانکایی. کاهش پرچمهای نادرستِ تشخیص AI برای انگلیسیِ تحتتأثیر زبانهای سینالایی و تامیل؛ حفظ معنا و استنادها و همچنین افشای صادقانه.

سریلانکا در شاخص Nature Index رتبه ۹۸ را دارد؛ دارای ۱۷ دانشگاه ملی، ۶٬۰۶۴ پژوهشگر، و تنها یک نشریه نمایهشده در SCIE در داخل مرزهایش است. نتیجه این است که تقریباً هر مقالهای که برای ارتقای شغلی اهمیت دارد، باید از «مانع زبان» عبور کند؛ آن هم در قالبِ نشریهای که جای دیگری (و نه در خود سریلانکا) واقع شده و به زبان انگلیسی منتشر میکند. یک انسانیساز AI برای پژوهشگران سریلانکایی فقط به یک دلیل واقعی وجود دارد: انگلیسیِ دقیق و درستِ زبانِ دوم اکنون بهعنوان نوشتارِ ماشینی اشتباه خوانده میشود، و این موضوع برای افراد واقعی، انتشارهای واقعی را پرهزینه میکند.
مسئله بهسادگی این است. سریلانکا در مجموع امتیاز ۴۸۶ را در EF English Proficiency Index دارد و بهطور قاطع در بازه «مهارت پایین» قرار میگیرد. حدود ۱۰٪ از جمعیت کشور به انگلیسی مسلطاند. نرخ خطا برای سخنگویان سینالایی که تلاش میکنند متون آکادمیک انگلیسی بنویسند ۵۴٪ است. کسانی که به تامیل صحبت میکنند هم با الگوهای رایج در آن زبان، وضعیت بهتری ندارند. در بسیاری از موارد، علمِ پشت نوشتهها کاملاً درست است؛ مشکل در این است که انگلیسی روی ارسالها «گیر میکند».
حالا آشکارسازهای AI را هم به این فشار اضافه کنید. وقتی شما در انگلیسیِ ساده، استاندارد و قابل پیشبینی مینویسید، همان انگلیسیای که نویسندهای با زبان دوم آموزش میبیند تا به آن هدف بگیرد، یک آشکارساز میتواند بندهای واقعاً انسانیِ شما را بهعنوان تولید ماشینی علامت بزند. این راهنما توضیح میدهد چرا چنین اتفاقی میافتد، چگونه با سینالایی و تامیل همراستا میشود، و چطور پیشنویسِ خودِ کمکگرفته از AI را انسانیتر کنید، بدون آنکه چیزی را پنهان کنید.
ශ්රී ලාංකික පර්යේෂකයන් සඳහා AI පෙළ මානවකරණය
انسانیسازی متنِ AI به پژوهشگران سریلانکایی کمک میکند تا پژوهشهای خود را به زبان انگلیسی منتشر کنند.
In plain English: our text humanizer به پژوهشگران سراسر سریلانکا کمک میکند تا نثر آکادمیکِ طبیعیِ تحتتأثیر سینالایی یا تامیل را، بدون تغییر دادن یافتهها، اصطلاحات یا استنادهای شما، به انگلیسی طبیعی تبدیل کنند. این فرایند ریتم و انتخاب واژگان را تغییر میدهد تا نوشتار دقیقِ غیربومی کمتر بهعنوان خروجیِ ماشین اشتباه خوانده شود.
این موضوع برای پژوهشگران تامیلزبان نیز به یک اندازه مهم است؛ بهویژه برای کسانی که در دانشگاه جافنا (University of Jaffna) درس میخوانند و از تامیل به مسیر انتشار به زبان انگلیسی میروند. هر دو جامعه با یک دیوار روبهرو میشوند و هر دو از یک جریان کاری یکسان سود میبرند: بنویسید، ویرایش کنید، پیشنویسِ خود را انسانی کنید، سپس افشا کنید.
پیشنویس را در سینالایی یا تامیل مینویسید؟ انسانیساز آن را تشخیص میدهد و پردازش میکند
همه پیشنویسها از انگلیسی آغاز نمیشوند و انسانیساز هم به آن نیاز ندارد. متن سینالایی را پیست کنید و ProofreaderPro خودکار خط را تشخیص میدهد، سپس آن را از یک مدلِ آگاه از زبان عبور میدهد که اصطلاحات و استنادهای شما را دقیقاً همانطور که نوشتهاید نگه میدارد. همانطور که AI පෙළ මානවකරණය پیشنویس سینالایی شما را مستقیم بازنویسی میکند، میتوانید پیش از ترجمه انسانیسازی کنید، نه بعد از آن. این تشخیص بیش از شصت زبان را پوشش میدهد؛ بنابراین یک پیشنویس تامیل هم به همان سهولت شناسایی و انسانیسازی میشود.
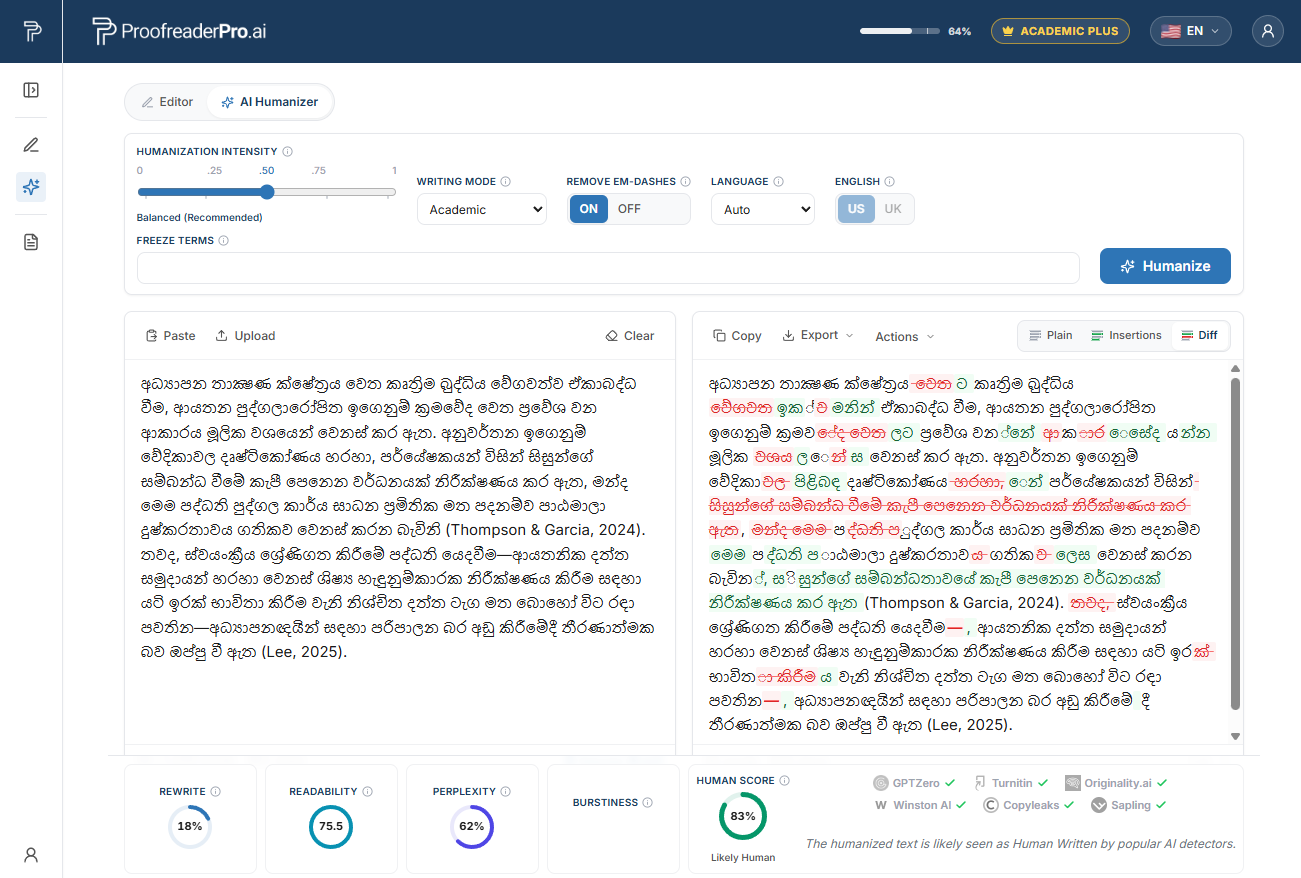
ProofreaderPro AI Humanizer که متن آکادمیک سینالایی را بازنویسی میکند. مقایسه «قبل و بعد» معنا و استنادها را حفظ میکند و بررسیهای آشکارساز تأیید میکنند که خوانش، طبیعی و انسانی است.
چرا پژوهشگران سریلانکایی با آشکارسازهای AI علامت میخورند
در سال ۲۰۲۳، تیمی از استنفورد به سرپرستی Liang و همکارانش مطالعهای در ژورنال Patternsِ Cell Press با عنوان «GPT detectors are biased against non-native English writers.» منتشر کرد. آنها انشاهای TOEFL نوشتهشده توسط انسان را از میان هفت آشکارساز AI پرکاربرد عبور دادند. بهطور متوسط حدود ۶۱٪ از انشاهای غیربومی بهعنوان AI علامت خوردند، در مقابل حدود ۵٪ برای نویسندگان انگلیسیِ بومی. تقریباً از هر پنج انشای غیربومی، یکی (حدود ۱۹٫۸٪) بهطور یکصدا توسط هر آشکارساز علامت شد. همه انشاها توسط انسان نوشته شده بودند.
مکانیزم این بیعدالتی را توضیح میدهد. بسیاری از آشکارسازها به «perplexity» نمره میدهند؛ معیاری از اینکه انتخابِ هر واژه برای یک مدل زبانی چقدر «غافلگیرکننده» است. نویسندگان دقیق و زباندوم، به سراغ واژههای رایج و عبارتبندی استاندارد و قابل پیشبینی میروند. این کار perplexity را پایین میآورد و آشکارساز آن را بهعنوان متنِ ماشینی میخواند. عادتهایی که باعث میشود نثر آکادمیک سریلانکایی شفاف و درست باشد، دقیقاً همان عادتهایی است که این ابزارها برای تنبیهشان آموزش دیدهاند.
میتوانید مکانیزم کامل را در توضیحدهنده ما درباره چرا آشکارسازهای AI نویسندگان غیربومی را علامت میزنند بخوانید. نسخه کوتاه این است: علامت خوردن نوشته شما اغلب بیشتر درباره مهارت انگلیسی شماست، نه اینکه یک ماشین آن را نوشته است یا نه.
الگوهای زبانِ اول سینالایی و تامیل پشت «علامتهای اشتباه»
ویژگیهایی که باعث میشوند انگلیسیِ زبان دوم، کمperplexity به نظر برسد، «خطا» نیستند. آنها ساختارهای درست، دقیق و استانداردند. هرچه با دقت بیشتر آنها را مرتب کنید، نثر شما متعارفتر میشود؛ و «متعارف بودن» دقیقاً چیزی است که آشکارسازهای مبتنی بر perplexity را مشکوک تلقی میکند.
حذف حرف تعریف (Article omission). در هیچیک از سینالایی و تامیل، سامانهای برای حرف تعریف معادل انگلیسی وجود ندارد. ترجمه مستقیمِ «the»، «a» یا «an» در هر دو زبان وجود ندارد و حذف حرف تعریف حدود ۵۱٪ از همه خطاهای مرتبط با حرف تعریف در نوشتار آکادمیک سریلانکایی را تشکیل میدهد. نویسندهای که «Result showed that method was effective» را به «The result showed that the method was effective» اصلاح میکند، یک جمله بینقص و کاملاً استاندارد تولید کرده است. همین استاندارد بودن است که بهعنوان perplexity پایین نمره میگیرد.
حذف «copula» و فعل be. هر دو زبان بهطور معمول «copula» را حذف میکنند. در سینالایی، «Oya lassanai» یعنی «She is beautiful» بدون وجود «is». در تامیل، «Avan periyavan» یعنی «He is big» بدون «is». وقتی این موضوع در نوشتار ظاهر میشود، میتواند به شکل «The result significant at p < 0.05.» دیده شود. وقتی به «The result was significant at p < 0.05,» اصلاح میشود، جمله به انگلیسیِ کاملاً رایج و متنی آموزشی تبدیل میشود؛ همان چیزی که آشکارسازها از یک مدل انتظار دارند.
زمان از سامانههای سادهتر. تامیل با سه «زمان» در برابر دوازده ترکیبِ زمان-بُعد در انگلیسی کار میکند و سینالایی، هرچند غنیتر است، هنوز هم «perfect» و «progressive» انگلیسی را ندارد. بنابراین «We collected samples since 2019» تبدیل میشود به «We have collected samples since 2019.» استفاده دقیق و استاندارد از زمان در سطح ژورنال بسیار قابل پیشبینی است، و نثرِ قابل پیشبینی همان چیزی است که علامت میخورد.
حروف اضافه از پسحروف اضافه. سینالایی و تامیل نشانگرها را بعد از اسم قرار میدهند. سینالایی «mese uda» بهصورت تحتاللفظی «table on» است و تامیل «mesei mel» دقیقاً همین کار را میکند. این موضوع به «in the table» منجر میشود، در حالی که انگلیسی «on the table» را میخواهد. وقتی حروف اضافه درست را یاد میگیرید و آنها را به شکل پیوسته به کار میبرید، شما برخی از استانداردترین شکلهای ممکن انگلیسی را تولید میکنید که باز هم perplexity پایینی دارد.
الگوهای ضمیر و رجیستر. در سینالایی، انتخاب ضمیر بر اساس رجیستر اجتماعی انجام میشود نه سامانه سختِ he، she، it. در تامیل نیز یک ضمیر رسمیِ خنثی از نظر جنسیت ("avar") همراه با شکلهای جنسیتدار به کار میرود. اصلاح اینها به ضمیرهای انگلیسیِ پیوسته، نثری روان و متعارف تولید میکند. هیچکدام از اینها تقلب نیست. این مهارتِ نوشتنِ زبان دوم است که آشکارساز نمیتواند از متنِ ماشینی تشخیص دهد.
زمینه سیاستهای تشخیص AI در سریلانکا و Turnitin
پایاننامهها و ارسالهای ژورنالی در سریلانکا معمولاً برای سنجش شباهت متن با Turnitin یا iThenticate غربال میشوند و این ابزارها اکنون شاخصهای AI را همراه با امتیاز شباهت نشان میدهند. طبق معیارهای ارتقای UGC، مسیر شغلی به انتشارهای نمایهشده گره خورده است؛ بنابراین یک علامتِ اشتباهِ خواندهشده میتواند یک دستنوشته را که پژوهشگر سریلانکایی ماهها روی آن کار کرده، متوقف کند.
کمک میکند بدانید خودِ این ابزارها هم محل مناقشهاند. Vanderbilt در سال ۲۰۲۳ آشکارساز AIِ Turnitin را غیرفعال کرد و دلیل را «مثبتِ کاذب» و «تعصب علیه نویسندگان غیربومی» عنوان کرد. Michigan State، UT Austin، Northwestern، Pittsburgh، SMU و Waterloo نیز اقدامات مشابهی انجام دادند. Turnitin امتیازها را در بازه ۱ تا ۱۹٪ سرکوب میکند و بهجای یک عدد، ستاره (*) نشان میدهد و هشدار میدهد که امتیازش بهتنهایی نباید برای تصمیم درباره یک پرونده صحت و تمامیت استفاده شود.
جمعبندی این است که موضوع عملی است. نمره یک آشکارساز، ادعایی است که میتوانید آن را به چالش بکشید، نه یک حکم قطعی. ژورنالها و نهادهای تأمین مالی بهطور فزاینده از شما میخواهند «افشای استفاده از AI» ارائه کنید و پاسخ درست این است که شفاف و صریح بنویسید و روشن افشا کنید، نه اینکه ابزارهایی را که استفاده کردهاید پنهان کنید.
انگلیسی دقیق خود را در برابر یک پرچم نادرست محافظت کنید
پیشنویس خود را که با کمک AI تهیه شده و در انگلیسیِ تحت تاثیر سینهلایی یا تامیلایی نوشته شده است انسانی کنید. معنا، اصطلاحات و استنادهای خود را حفظ کنید، سپس نحوه استفاده از AI را همانطور که مجله شما میخواهد، افشا کنید.
نسخه رایگان Humanizer را امتحان کنیددانشگاههای برتر سریلانکا و محلهایی که بررسیهای AI دیده میشود
هر ۱۷ دانشگاه ملی سریلانکا تحت معیارهای ارتقای UGC فعالیت میکنند که انتشار نمایهشده را الزامی میداند، و همه پایاننامهها و دستنوشتهها را برای سنجش شباهت و شاخصهای AI پیش از ارسال غربال میکنند:
- University of Colombo، Colombo. دانشگاه پیشرو بر اساس بیشتر معیارها و بزرگترین تولیدکننده نشریههای نمایهشده در Scopus در کشور.
- University of Peradeniya، Peradeniya، Kandy. بزرگترین پردیس سریلانکا با تمرکز قوی بر کشاورزی، علوم، مهندسی و دامپزشکی.
- University of Moratuwa، Moratuwa. برترین دانشگاه مهندسی؛ پیشرو در مهندسی عمران، علوم کامپیوتر و معماری.
- University of Kelaniya، Kelaniya. قوی در علوم انسانی، علوم اجتماعی، علوم و بازرگانی، با افزایش خروجی در علوم سلامت.
- University of Jaffna، Jaffna. دانشگاه پیشرو در استان شمالی و بهویژه برای پژوهشگران تامیلمدی که به انتشار انگلیسی وارد میشوند بسیار مهم.
- University of Sri Jayewardenepura، Nugegoda. قوی در مدیریت، علوم کاربردی و علوم پزشکی.
- University of Ruhuna، Matara. دانشگاه پیشرو در استان جنوبی؛ قوی در کشاورزی، شیلات، مهندسی و پزشکی.
- University of Rajarata، Mihintale. تمرکز بر کشاورزی، علوم اجتماعی و فناوری، با فعالیتهای رو به رشد در مطالعات میراث و مطالعات محیطزیست.
- Sabaragamuwa University of Sri Lanka، Belihuloya. قوی در علوم غذایی، کشاورزی و ژئوماتیک.
- Wayamba University of Sri Lanka، Makandura و Kuliyapitiya. تخصص در کشاورزی و فناوری؛ قابل توجه در فناوری غذا و زیستفناوری.
- Uva Wellassa University، Badulla. تمرکز بر علم و فناوری، با پژوهش رو به رشد در علم حیوانات و رایانش.
- Open University of Sri Lanka، Nawala. مؤسسه آموزش از راه دور کشور که به متخصصان شاغلی خدمت میکند که مسیر حرفههای پژوهشی را دنبال میکنند.
با وجود تنها ۶٬۰۶۴ پژوهشگر فعال در سطح ملی، تقاضا برای پشتیبانی زبانی بالاست و تقریباً همه آنها نیاز دارند نوشتار دقیقِ غیربومی از علامتخوردن محافظت شود.
نحوه کار انسانیساز AI برای پژوهشگران سریلانکایی
در اینجا جریان کاری آمده است: ابتدا استدلال خود را پیشنویس کنید، اختیاری است که در زبان سینالایی یا تامیل بنویسید، به شرطی که منطق در همان زبان طبیعیتر جریان پیدا کند، و سپس آن را به انگلیسی ترجمه کنید. دستور زبان را ویرایش کنید تا الگوهای «حرف تعریف»، «copula»، «زمان» و «حروف اضافه» که در بالا آمدهاند اصلاح شوند. سپس پیشنویسِ کمکگرفته از AI خود را از طریق text humanizer اجرا کنید تا نثر دقیق و استاندارد دوباره ریتم طبیعیِ انسانی پیدا کند و کمتر اشتباه خوانده شود. معنا، اصطلاحات و استنادهای شما دستنخورده باقی میماند.
ما درباره نتایج دقیق هستیم، چون شما شایسته صداقتید، نه تبلیغ. پس از آزمایش با آشکارسازهای اصلی، انسانیساز متنِ AI را به شکلی طبیعیتر و انسانیتر بازنویسی میکند؛ این کار «سیگنال AI» را کاهش میدهد و شانس آن را در برابر آشکارسازهای سختتر بهتر میکند، در حالی که دقت دستور زبان در متن آکادمیک همچنان بالا میماند. اینها نتایجِ آزمون هستند، نه تضمین. آشکارسازها هر چند ماه یکبار بازآموزی میشوند، بنابراین هیچ ابزار معتبری نمیتواند قول دهد ۱۰۰٪ غیرقابلتشخیص است یا برای همیشه یک چکِر را دور میزند.
در ادامه، گامی میآید که شما را امن نگه میدارد: افشا. استفاده خود از AI را دقیقاً در قالبی بیان کنید که مؤسسه و ژورنال هدف شما میخواهد. انسانیسازی نوشتار خود برای محافظت از آن در برابر «علامت اشتباه» و سپس افشای اینکه از کمک AI استفاده کردهاید، دقیقاً معادلِ پنهانکردن نیست. این یعنی انصاف برای کار واقعی. اگر پیش از همه به اصلاح دستور زبان و ساختار هم نیاز دارید، راهنمای مکمل ما درباره ویرایش آکادمیک برای پژوهشگران سریلانکایی به این بخش میپردازد و این پست هم داخل مرکز انسانیساز AI چندزبانه ما قرار دارد که همین جریان کاری را در زبانهای مختلف پوشش میدهد.
نهادهای تأمین مالی محلی، ژورنالها، و انتظارات افشای AI
تأمینکنندگان اصلی در سریلانکا پول را به خروجیِ منتشرشده گره میزنند. National Science Foundation (NSF) گرنتهای Competitive Research Grants را تأمین مالی میکند و تمدیدها را بر اساس انتشار در ژورنالهای معتبر بینالمللی ارزیابی میکند. National Research Council (NRC) تا سقف ۵۰ میلیون روپیه طی ۵ سال گرنت ارائه میدهد و انتظارات انتشار را متناسب تعیین میکند. University Grants Commission (UGC) برای ارتقای شغلی، حداقل ۱۲ نمره از «مقالههای ژورنالی» را لازم میداند؛ برای موقعیتهای ارشد نیز ۵ مقاله برجسته در نظر میگیرد و بالاترین نمره را به ژورنالهای نمایهشده در SCIE، SSCI و Scopus اختصاص میدهد.
اکوسیستم ژورنالها در داخل کشور کوچک است. Journal of the National Science Foundation of Sri Lanka (JNSF) تنها ژورنال نمایهشده در SCIE کشور است و این نمایهسازی را به مدت ۱۴ سال پیاپی حفظ کرده است. در کنار آن، Ceylon Journal of Science قرار دارد که یکی از قدیمیترین ژورنالهای علمی در جنوب آسیاست؛ Ceylon Medical Journal که از سال ۱۸۸۷ توسط Sri Lanka Medical Association منتشر میشود؛ Sri Lanka Journal of Social Sciences؛ Journal of the Rubber Research Institute of Sri Lanka؛ و Tropical Agricultural Research از Postgraduate Institute of Agriculture در Peradeniya. SLJOL (Sri Lanka Journals Online) نیز ۱۷۲ ژورنال ملی را برای دسترسی آزاد میزبانی میکند.
از آنجا که تقریباً همه ژورنالهای با وزن بالا در انگلیسی منتشر میکنند و خارج از کشور قرار دارند، بیشتر مسیرهای شغلی به ارسال بینالمللی وابسته است؛ جایی که سردبیران بهطور فزاینده انتظار دارند «بیانیه افشای استفاده از AI» ارائه شود. افشای خود را واضح بنویسید، دقیق نگه دارید و اگر شما هرگز هم بهطور ناعادلانه علامت بخورید، آن را بهعنوان «ادعایی برای پاسخ» در نظر بگیرید، نه قضاوتی که باید پذیرفته شود. راهنماهای ما درباره نوشتن یک AI disclosure statement و درباره چگونگی اعتراض به یک پرچم تشخیص AIِ اشتباه هر دو سناریو را پوشش میدهند.
پرسشهای متداول
Q: آیا انسانیساز AI برای پژوهشگران سریلانکایی روشی برای تقلب در Turnitin است؟
خیر. استفاده درست این است که پیشنویسِ کمکگرفته از AIِ خودتان را انسانی کنید تا انگلیسیِ تحتتأثیر سینالایی یا تامیلِ دقیق بهعنوان متنِ ماشینی خوانده نشود؛ در حالی که معنا و استنادهای شما دقیقاً همانطور که خودتان نوشتهاید باقی میماند. سپس، شما استفاده از AI را در قالبی که ژورنالتان میخواهد افشا میکنید تا در چارچوب قوانینِ تمامیت علمی بمانید. این دقیقاً نقطه مقابلِ پنهانکردن هر چیزی است.
Q: چرا آشکارسازهای AI نوشته من را وقتی من هر کلمه را خودم نوشتهام علامت میزنند؟
چون بسیاری از آشکارسازها به perplexity نمره میدهند؛ یعنی اینکه انتخاب واژهها تا چه حد قابل پیشبینی است. نویسندگان دقیقِ زبان دوم از واژههای رایج و عبارتبندی استاندارد استفاده میکنند و این باعث میشود perplexity پایین شکل بگیرد؛ چیزی که شبیه خروجیِ ماشینی خوانده میشود. یک مطالعه ۲۰۲۳ در استنفورد نشان داد حدود ۶۱٪ از انشاهای غیربومیِ نوشتهشده توسط انسان بهعنوان AI علامت خوردند، در حالی که برای نویسندگان بومی این عدد حدود ۵٪ بود؛ بنابراین الگو ثبت شده است و تقصیر شما نیست.
Q: آیا انسانیساز برای انگلیسیِ تحتتأثیر سینالایی و تامیل هم کار میکند؟
بله. این ابزار آگاه از زبان است و از بیش از ۶۰ زبان پشتیبانی میکند؛ بنابراین حذف حرف تعریف، حذف copula، سادهسازی زمان و الگوهای حروف اضافهِ ناشی از پسحروف اضافه را، که گویندگان سینالایی و تامیل هنگام انتقال به انگلیسی با خود میآورند، تشخیص میدهد. در عین حفظ اصطلاحات فنی، یافتهها و ارجاعات شما، ریتم و انتخاب واژگان را تغییر میدهد.
Q: آیا میتوانید تضمین کنید مقاله من از هر آشکارساز AI عبور میکند؟
خیر، و شما باید به هر ابزاری که چنین قولی میدهد بیاعتماد باشید. این انسانیساز که در برابر آشکارسازهای اصلی آزموده شده، متنِ AI را به شکلی طبیعیتر و انسانیتر بازنویسی میکند؛ این کار سیگنال AI را کاهش میدهد و شانس آن را در برابر آشکارسازهای سختتر بهتر میکند، در حالی که دقت دستور زبان همچنان بالا میماند. اینها نتایج آزمون هستند، نه تضمین؛ چون آشکارسازها هر چند ماه یکبار دوباره آموزش میبینند.
Q: آیا انسانیسازی استنادهای من یا نتایج من را تغییر میدهد؟
خیر. انسانیساز معنا، اصطلاحات فنی و استنادهای شما را در APA، MLA، Chicago یا IEEE حفظ میکند. فقط ریتم و عبارتبندی را تنظیم میکند و کادنس تکراری و خط تیرههای سرگردان را برمیدارد؛ بنابراین علمی که گزارش کردهاید دقیقاً یکسان میماند، اما متن طوری خوانده میشود که طبیعیتر است.
یک انسانیساز متنِ مبتنی بر آگاهی زبانی برای پژوهشگران سریلانکایی. معنا، اصطلاحات و استنادهای شما حفظ میشود، در حالی که انگلیسیِ تحت تاثیر سینهلایی و تامیلایی با طبیعی و منصفانه خوانده میشود.

Moe یک مهندس NLP با PhD در پردازش زبان طبیعی است. تحقیقات او زبانشناسی محاسباتی، تجزیه و تحلیل متن و یادگیری ماشین را پوشش میدهد و مستقیماً به مدلهای ویرایش و انسانیسازی پشت ProofreaderPro وارد میشود. او در مورد بخشی از فرآیند می نویسد که اکثر مردم هرگز نمی بینند: چگونه یک مدل زبان جمله ای را می خواند، آن را نمره می دهد و تصمیم می گیرد چه چیزی را تغییر دهد.


