
انسانساز هوش مصنوعی برای پژوهشگران اسپانیایی که به انگلیسی مینویسند
انسانساز هوش مصنوعی برای پژوهشگران اسپانیایی. با کاهش هشدارهای نادرستِ تشخیص هوش مصنوعی در انگلیسیِ تحتتأثیر اسپانیایی، معنی و استنادها را حفظ کنید و صادقانه استفاده از هوش مصنوعی را اعلام کنید.

اسپانیا یکی از تولیدکنندگان بزرگترِ پژوهش در اروپا است و بهطور مستمر از نظر میزان تولید، در میان ۱۰ تا ۱۲ کشور برتر جهان قرار میگیرد. تقریباً همهٔ این کارها برای خوانندگان، به انگلیسی ارائه میشود؛ زبانی دوم برای بیشتر افرادی که آن را مینویسند. دقیقاً همان شکافِ میان «فکر کردن به زبان اسپانیایی» و «انتشار به زبان انگلیسی» جایی است که یک انسانساز هوش مصنوعی برای پژوهشگران اسپانیایی جایگاه خود را پیدا میکند.
این مشکلی است که هیچکس از پیش برایش برنامهریزی نکرده است. هماکنون سامانههای تشخیصِ متنِ تولیدشده توسط هوش مصنوعی داخل ابزارهایی قرار گرفتهاند که پایاننامهها و ارسالهای مجله را غربال میکنند. این سامانهها برای گرفتنِ متنِ ماشینی ساخته شدهاند، اما بهطور روتین نوشتهٔ دقیق، درست و انسانیِ نویسندگان غیرمادریِ انگلیسی را هم به اشتباه علامتگذاری میکنند. مشکلِ نوشتهٔ شما نیست. مشکل، پیشبینیپذیریِ آن است.
یک پژوهشگر در مادرید یا بارسلونا که در ابتدا به زبان اسپانیایی پیشنویس تهیه میکند، آن را ترجمه میکند و برای رسیدن به انگلیسی آکادمیکِ تمیز و روان، ویرایش انجام میدهد، ممکن است بیش از یک گویندهٔ مادریِ بیدقت، که هرگز سراغ ابزارهای زبانی نرفته، شبیه یک ماشین به نظر برسد. این مطلب دربارهٔ بستنِ همین شکاف بهصورت شفاف است: بهبود پیشنویس خودتان، حفظ معنی و استنادها، و اعلام صادقانهٔ استفاده از هوش مصنوعی همانطور که دانشگاه و مجلهٔ شما انتظار دارند.
Un humanizador de texto de IA para investigadores españoles
انسانساز متنِ هوش مصنوعی ما به پژوهشگران اسپانیایی کمک میکند تا بدون آنکه نوشتارِ دقیقشان با متنِ تولیدشده توسط یک ماشین اشتباه گرفته شود، در انگلیسی منتشر کنند. معنی، اصطلاحات فنی و استنادهای خود را حفظ کنید، و سرعت و انتخاب کلمات را متنوع کنید؛ چیزهایی که یک تشخیصدهنده آنها را «خودکار» تفسیر میکند.
به زبان ساده، این ابزار ریتم و انتخاب کلماتِ پیشنویسِ خودِ شما را بازطراحی میکند تا نوشتارِ دقیقِ زبانِ دوم کمتر بهعنوان متنِ تولیدیِ نادرست خوانده شود، در حالی که استدلال و ارجاعات شما دقیقاً همانجا میمانند که شما قرار دادهاید. این ابزار برای کار واقعیِ نویسندگان واقعی ساخته شده است، نه برای پنهان کردنِ چیزی.
همچنین متن اسپانیاییتان را مستقیم انسانسازی کنید، نه فقط انگلیسیتان
لازم نیست پیش از انسانسازی، به انگلیسی مهاجرت کنید. یک بخش را به زبان اسپانیایی کپی کنید؛ سپس ProofreaderPro زبان را بهصورت خودکار تشخیص میدهد و آن را از مسیر یک مدل آگاه از زبان اسپانیایی عبور میدهد؛ مدلی که اَکسنتها، اصطلاحات و استنادها را دقیقاً همانطور که نوشتهاید حفظ میکند. بهعنوان یک humanizador de texto de IA، این ابزار روی پیشنویس اسپانیایی شما نیز درست مانند انگلیسی کار میکند: معنی را حفظ میکند، اما طوری مینویسد که عبارتبندی طبیعی به نظر برسد. پوششِ تشخیص بیش از شصت زبان را شامل میشود، بنابراین اسپانیایی بهعنوان اسپانیایی بازنویسی میشود، نه اینکه به انگلیسی «فلت» شود.
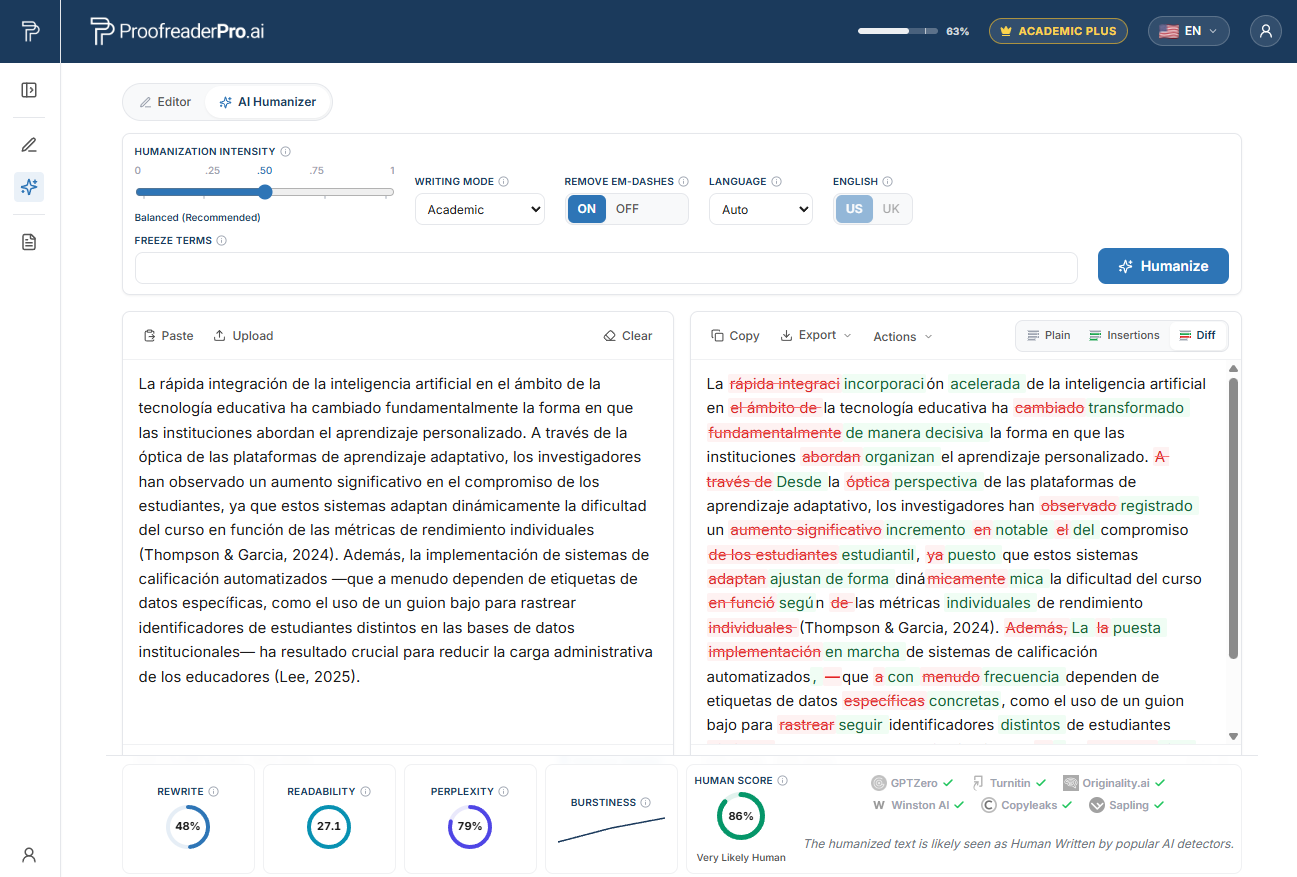
انسانساز هوش مصنوعی ProofreaderPro در حال بازنویسی متن آکادمیکِ اسپانیایی. تفاوتِ پیش و پس، معنی و استنادها را حفظ میکند و بررسیهای تشخیص تأیید میکنند که متن، طبیعی و انسانی خوانده میشود.
چرا پژوهشگران اسپانیایی با تشخیصدهندههای هوش مصنوعی علامتگذاری میشوند
واضحترین شواهد از یک مطالعهٔ ۲۰۲۳ در استنفورد توسط Liang و همکاران میآید که در مجلهٔ Cell Press با عنوان "GPT detectors are biased against non-native English writers" منتشر شد. تیم، انشاهای TOEFL نوشتهشده توسط انسان را از میان هفت تشخیصدهندهٔ پرکاربرد عبور داد.
نتیجه باید هر کسی را که در زبان دوم منتشر میکند نگران کند. حدود ۶۱٪ از انشاهای غیربومی بهطور متوسط بهعنوان هوش مصنوعی علامتگذاری شدند، در مقایسه با حدود ۵٪ برای نویسندگان انگلیسیزبانِ مادری. نزدیک به یکپنجم از انشاهای غیربومی، یعنی حدود ۱۹.۸٪، بهطور یکصدا توسط همهٔ تشخیصدهندهها علامتگذاری شد. همهٔ انشاها توسط انسان نوشته شده بودند.
مکانیسمِ این موضوع «perplexity» نام دارد: معیاری از میزان شگفتیِ انتخاب هر کلمه برای یک مدل زبانی. نویسندگانِ دقیقِ زبانِ دوم، به سراغ کلمات رایج و عبارتبندیهای استاندارد و قابل پیشبینی میروند؛ چیزی که perplexity را پایین میآورد و در نتیجه یک تشخیصدهنده آن را متنِ ماشینی میخواند. همان عادتهایی که انگلیسیِ روشن و درست پژوهشگران اسپانیایی را میسازد، عادتهایی است که این ابزارها برای علامتگذاری به آموزش دیدهاند. ما مکانیسم کامل را در راهنمای خود دربارهٔ اینکه چرا تشخیصدهندههای هوش مصنوعی نویسندگان غیربومی را علامتگذاری میکنند باز میکنیم.
الگوهای زبان اول اسپانیایی پشتِ علامتگذاریهای نادرست
اسپانیایی یک زبانِ رومی (Romance) است و الگوهای آن به شکلهایی وارد انگلیسی میشوند که کاملاً درستاند، اما بسیار منظم و قابلپیشبینیاند. همین منظم بودن دام است. در ادامه، رایجترین مواردی را که در نسخهدستنوشتههای نویسندگان اسپانیایی میبینیم فهرست میکنیم.
ناآشناییهای کاذب (False cognates). "Actual" و "actually" برای "current" و "currently" استفاده میشوند (در اسپانیایی "actual" یعنی current)، "realize" بهجای "carry out" (realizar) میآید، "assist" بهجای "attend" (asistir) و "sensible" بهجای "sensitive". هرکدام از اینها یک جایگزینی استاندارد و قابل یادگیری است و دقیقاً به همین دلیل خواناتر به نظر میرسد که قابل پیشبینی است.
زیادهروی در بهکارگیری حرف اضافهٔ معین با اسمهای انتزاعی. اسپانیایی حرفهای اضافهٔ معین را قبل از اسمهای کلی میآورد؛ بنابراین "the research shows," "the science," و "the society" جایی ظاهر میشوند که در انگلیسی حرف اضافه حذف میشود. این یک الگوی ثابت، مبتنی بر قواعد و بهشدت تکرارشونده است؛ و همین ثبات است که perplexity را پایین میآورد.
جملههای طولانی با تکیهگاههای دستوریِ زیاد. سبکِ آکادمیکِ زبانهای رومی به جملههای بلندِ دورهای با بندهای موصولیِ پشتسرهم گرایش دارد. از نظر دستور، کاملاً صحیحاند، اما ریتم یکنواختِ «بند پس از بند» آنها برای یک تشخیصدهنده شبیه متنِ صاف و ماشینی دیده میشود.
انتقالِ حرف اضافه. "Depend of" (depender de)، "consist on" (consistir en)، "different to" و "in relation with" مستقیم از نحوهٔ بهکارگیریِ حروف اضافه در زبان اسپانیایی میآیند. دقیق، نظاممند و بنابراین برای یک مدل هم پیشبینی آن آسان است.
نامسازیِ سنگین و ترتیب کلمات. ساختهایی مثل "the realization of the analysis of" اسمهای انتزاعی را در یک شکل ثابت روی هم انباشته میکنند. اگر «کدام» موصولی (relative "which") بیش از حد استفاده شود و افتتاحِ بسیاری از جملهها با یک ترجمهبرداریشده از "On the other hand" همراه باشد، متن به شکل چشمگیری منظم میشود.
هیچیک از این موارد خطای فکری نیست. اینها ساختهای صحیح، دقیق و استانداردند، و همین استاندارد بودن دقیقاً چیزی است که یک تشخیصدهنده آن را perplexity پایین امتیازدهی میکند؛ و perplexity پایین همان چیزی است که ابزار آن را «متن ماشینی» برچسب میزند.
زمینهٔ تشخیص هوش مصنوعی در اسپانیا و Turnitin
پیشرفت شغلیِ پژوهشگران اسپانیایی به sexenios de investigación وابسته است؛ ارزیابی تحقیقاتیِ ششساله از طریق ANECA و CNEAI که انتشار مقاله در مجلات فهرستشده در Journal Citation Reports (Web of Science) و Scopus را پاداش میدهد. این نظام، فشارِ دائمی برای پژوهشگران اسپانیایی ایجاد میکند تا در مجلات انگلیسیِ با اثرگذاری بالا منتشر کنند؛ جایی که تشخیصدهندهها اکنون منتظرند.
پایاننامهها در اسپانیا در مخازن نهادی مانند TDX و نیز در ثبت ملی TESEO ذخیره میشوند و پیش از آن، غربالگریِ شباهت با Turnitin یا iThenticate امری روتین است. بهطور فزاینده، همان پلتفرمها یک شاخصِ مربوط به هوش مصنوعی را همراهِ امتیازِ شباهت نیز نمایش میدهند.
برای حفظ تناسبِ این شاخص باید احتیاط کرد. وندربیلت در ۲۰۲۳ تشخیصدهندهٔ AIِ Turnitin را غیرفعال کرد و به مثبتهای کاذب و سوگیری علیه نویسندگان غیرمادری اشاره نمود؛ همان کاری که دانشگاه Michigan State، UT Austin، Northwestern، Pittsburgh، SMU و Waterloo نیز انجام دادند. Turnitin امتیازها را در بازهٔ ۱ تا ۱۹٪ سرکوب میکند و نسبت به اتکا صرف به امتیاز برای تصمیمهای مربوط به یکپارچگی (integrity) هشدار میدهد. علامتِ یک تشخیصدهنده، ادعایی برای به چالش کشیدن است، نه یک حکم. همچنین حامیان مالی و مجلات بهطور فزاینده از ارائهٔ یک افشای ساده و روشن دربارهٔ چگونگی استفاده از هوش مصنوعی، نه یک درصدِ حدسی، درخواست میکنند.
انگلیسی دقیق خود را در برابر هشدار نادرست AI محافظت کنید
متن پیش نویس خود را که با کمک هوش مصنوعی تهیه کرده اید انسانی کنید، در حالی که هر استناد و اصطلاح فنی در جای خود می ماند، سپس استفاده از هوش مصنوعی را همان طور که ژورنال شما می خواهد افشا کنید.
نسخه رایگان Humanizer را امتحان کنیددانشگاههای مطرح اسپانیا و اینکه بررسیهای هوش مصنوعی کجا ظاهر میشود
پژوهش اسپانیا در میان یک نظام قویِ دانشگاههای عمومی پخش شده است و این نهادها پایاننامهها و نسخهدستنوشتهها را از نظر شباهت غربال میکنند؛ معمولاً با Turnitin و بهطور فزاینده با لحاظ کردنِ شاخصهای هوش مصنوعی نیز:
- Universitat de Barcelona (UB)، Barcelona
- Universidad Autónoma de Madrid (UAM)، Madrid
- Universidad Complutense de Madrid (UCM)، Madrid
- Universitat Autònoma de Barcelona (UAB)، Barcelona
- Universitat de València (UV)، Valencia
- Universidad de Granada (UGR)، Granada
- Universidad Politécnica de Madrid (UPM)، Madrid
- Universitat Politècnica de València (UPV)، Valencia
- Universidad de Sevilla (US)، Seville
- Universidad del País Vasco / Euskal Herriko Unibertsitatea (UPV/EHU)، Bilbao
- Universidad de Salamanca (USAL)، Salamanca
- Universitat Pompeu Fabra (UPF)، Barcelona
- Universidad de Navarra (UNAV)، Pamplona
- Universidad de Zaragoza (UNIZAR)، Zaragoza
فرقی نمیکند پایاننامهٔ شما در UB، UAM یا UNIZAR بررسی شود؛ مرحلهٔ غربالگری بسیار مشابه است و ریسکِ اینکه انگلیسیِ دقیقِ زبانِ دوم به شکل نادرست فهمیده شود نیز همان است.
نحوهٔ عملکرد انسانساز هوش مصنوعی برای پژوهشگران اسپانیایی
جریان کار ساده است و شما را داخل چارچوب قواعد نگه میدارد. مقالهٔ خود را همانطور تهیه کنید که بیشترین کمک را به بهترین فکر شما میکند، اغلب ابتدا به اسپانیایی، سپس ترجمه کنید. دستور زبان را طوری اصلاح کنید که معنی دقیق باشد؛ اگر خواستید یک دورِ دوم هم روی خودِ انگلیسی انجام دهید، راهنمای ما دربارهٔ ویرایشِ هوش مصنوعی برای پژوهشگران اسپانیایی این مرحله را توضیح میدهد. فقط بعد از آن، متنِ خودتان را که با کمک هوش مصنوعی نوشتهاید انسانسازی میکنید تا نوشتهٔ دقیق و با perplexity پایین کمتر اشتباه خوانده شود.
همین مرحلهٔ آخر کاری است که انسانساز هوش مصنوعی ما انجام میدهد. معنی، اصطلاحات فنی و استنادهای شما را حفظ میکند و ریتم و انتخاب کلمات را متنوع میسازد؛ چیزی که تشخیصدهنده آن را ریتمِ ماشینی میخواند. این ابزار از بیش از ۶۰ زبان پشتیبانی میکند و متنِ غیربومی را از مسیر یک مدل آگاه از زبان عبور میدهد که ساختار جمله و معنا را دستنخورده حفظ میکند.
ما در ادعاهای خود دقیق هستیم. انسانساز متن تولیدشده با هوش مصنوعی را به شکلی طبیعیتر و انسانیتر بازنویسی میکند تا سیگنال هوش مصنوعی کاهش یابد و شانس آن در برابر تشخیصدهندههای دشوار بهتر شود، و این کار در برابر تشخیصدهندههای بزرگ آزمایش شده است. همچنین برای دستور زبان در متنهای آکادمیک، بیش از ۹۶٪ عملکرد بهتر دارد. اینها نتیجهٔ آزمونها هستند، نه تضمین. تشخیصدهندهها هر چند ماه یکبار بازآموزی میشوند؛ بنابراین ما هرگز عددی یا راهی برای «دور زدن» چیزی را وعده نمیدهیم.
سپس افشا میکنید. یک بیانیهٔ استفاده از هوش مصنوعی را با فرمی که مؤسسه و مجلهٔ هدف شما نیاز دارد اضافه کنید تا ابزار، نوشتارِ دقیق را بدون پنهان کردنِ اینکه چگونه تولید شده محافظت کند. این بخش در داخل مرکز انسانسازِ چندزبانهٔ هوش مصنوعی شما قرار میگیرد و اگر بخواهید یک لایهٔ ویرایش انسانی روی آن داشته باشید، با مرکز ویرایش آکادمیک جهانی ما همجفت میشود.
نهادهای تأمینمالی محلی، مجلات و انتظارات افشای هوش مصنوعی
تأمینمالی رقابتی در اسپانیا از طریق Agencia Estatal de Investigación (AEI) و Ministerio de Ciencia, Innovación y Universidades جریان دارد، در حالی که Consejo Superior de Investigaciones Científicas (CSIC) بزرگترین سازمان پژوهشی عمومیِ کشور است. پستهای دانشگاهی از سوی ANECA اعتباردهی میشوند و FECYT به مجلات علمی اسپانیایی نشان کیفیت میدهد؛ بنابراین هم نمایهسازی و هم کیفیت زبان برای مسیر شغلی در اسپانیا وزن واقعی دارند.
از نظر انتشار، پژوهشگران اسپانیایی مجلات نمایهشده در Web of Science (JCR) و Scopus را هدف میگیرند؛ در برخی حوزهها، شاخصهای ملی و رشتهای نیز اهمیت دارد و پایاننامهها به TDX و ثبت TESEO میرسند. در میان همهٔ این نهادها، افشای استفاده از هوش مصنوعی از «اختیاری» به «انتظارش میرود» در حال حرکت است. موضع امن در همهجا یکسان است: از ابزارها روی کار خودتان استفاده کنید، استنادها را دقیق نگه دارید و صریح بیان کنید که هوش مصنوعی چگونه کمک کرده است. یک دورِ نهایی را از مسیر انسانساز عبور دهید تا بدون تحریف، از نوشتار محافظت کنید.
پرسشهای متداول
Q: آیا استفاده از یک انسانساز هوش مصنوعی برای پژوهشگران اسپانیایی بهعنوان تقلب محسوب میشود؟
وقتی آن را روی پیشنویسِ خودِ نوشتهشده با کمک هوش مصنوعی به کار میبرید و سپس آن را افشا میکنید، این موضوع تقلب محسوب نمیشود. این ابزار ریتم نوشتاری را که پیشتر خودتان تولید کردهاید بازصورتبندی میکند و معنی و استنادها را حفظ نگه میدارد تا انگلیسیِ دقیقِ غیربومی بهعنوان متنِ ماشینی خوانده نشود. افشای استفاده از هوش مصنوعی در قالبی که مجله یا دانشگاه شما میخواهد، چیزی است که کل فرآیند را در چارچوب قوانین درستکاری نگه میدارد.
Q: آیا یک humanizador de texto de IA استنادها یا اصطلاحات فنی من را تغییر میدهد؟
خیر. انسانساز طوری ساخته شده است که اصطلاحات فنی، ارجاعات و ساختار استدلال شما را حفظ کند، در حالی که انتخاب کلمات و ریتم را متنوع میکند. کلیدواژههای استنادی، شکلها و واژگان تخصصی دقیقاً در همانجایی باقی میمانند که شما گذاشتهاید؛ چون تغییر دادن آنها هدف را از بین میبرد.
Q: چرا انگلیسیِ درستِ من در وهلهٔ اول بهعنوان هوش مصنوعی علامتگذاری میشود؟
چون بسیاری از تشخیصدهندهها perplexity را نمرهدهی میکنند؛ یعنی اینکه انتخاب کلمات شما تا چه اندازه قابل پیشبینی است. نویسندگان اسپانیاییِ دقیق از کلمات رایج و عبارتبندی استاندارد استفاده میکنند که perplexity را پایین میآورد؛ و پایین بودنِ perplexity خوانده میشود بهعنوان متنِ ماشینی. در مطالعهٔ استنفورد، حدود ۶۱٪ از انشاهای غیربومیِ نوشتهشده توسط انسان علامتگذاری شدند، در مقابل حدود ۵٪ برای نویسندگان انگلیسیزبان مادری؛ بنابراین علامتگذاری کار شما رایج است و قابل به چالش کشیدن.
Q: انسانساز واقعاً چه نرخهایی را به دست آورده است؟
وقتی در برابر تشخیصدهندههای بزرگ آزمایش شد، متنِ تولیدشده با هوش مصنوعی را به شکلی طبیعیتر و انسانیتر بازنویسی میکند؛ این کار سیگنال هوش مصنوعی را کاهش میدهد و شانس آن را در برابر تشخیصدهندههای سخت بهتر میکند، در حالی که دقت دستور زبان در متن آکادمیک همچنان بالا میماند. اینها نتیجهٔ آزمونها هستند، نه تضمین. تشخیصدهندهها اغلب بازآموزی میشوند؛ بنابراین ما چیزی را که اندازهگیری کردهایم توصیف میکنیم، نه اینکه یک نتیجهٔ ثابت را وعده بدهیم.
Q: پایاننامهٔ من در دانشگاه با Turnitin بررسی میشود. چه کاری باید انجام دهم؟
شاخص مربوط به هوش مصنوعی را بهعنوان یکی از سیگنالها در نظر بگیرید، نه یک حکم. به زبانی بنویسید که بیشترین کمک را به بهترین فکر شما میکند، برای دقت ویرایش کنید، پیشنویس خود را انسانسازی کنید تا احتمال علامتگذاری نادرست کاهش یابد و یک افشای روشن دربارهٔ استفاده از هوش مصنوعی ضمیمه کنید. اگر همچنان علامت ظاهر شد، شواهد مربوط به فرآیند پیشنویسنویسی خودتان را دارید تا آن را به چالش بکشید.
انسانی سازِ آگاه از زبان که منظور شما، اصطلاحات و استنادات را بدون تغییر حفظ می کند، و هم زمان میزان هشدارهای نادرست هوش مصنوعی را که به نویسندگان دقیق اسپانیایی زبان ضربه می زنند کاهش می دهد.

Moe یک مهندس NLP با PhD در پردازش زبان طبیعی است. تحقیقات او زبانشناسی محاسباتی، تجزیه و تحلیل متن و یادگیری ماشین را پوشش میدهد و مستقیماً به مدلهای ویرایش و انسانیسازی پشت ProofreaderPro وارد میشود. او در مورد بخشی از فرآیند می نویسد که اکثر مردم هرگز نمی بینند: چگونه یک مدل زبان جمله ای را می خواند، آن را نمره می دهد و تصمیم می گیرد چه چیزی را تغییر دهد.


