QuillBot: Bộ phát hiện AI của QuillBot so với văn bản được diễn đạt lại và humanized
Bộ phát hiện AI của QuillBot gần như chính xác tuyệt đối với văn bản AI dạng nguyên bản và được paraphrase, nhưng một nghiên cứu năm 2025 cho thấy độ chính xác giảm xuống còn 58% khi văn bản đó đã được humanizer AI xử lý.
Bộ phát hiện AI của QuillBot gần như chính xác tuyệt đối trong việc gắn cờ cho văn bản AI nguyên bản và đã được paraphrase. Tuy nhiên, theo một nghiên cứu độc lập năm 2025, độ chính xác giảm xuống còn 58% khi văn bản đó đã được xử lý qua một công cụ humanizer AI. QuillBot cũng xây dựng một trong những công cụ AI paraphraser phổ biến hơn cả, nên bộ phát hiện của chính họ phải đối mặt với đúng loại văn bản đã được diễn đạt lại mà các công cụ khác của họ tạo ra.
Bài viết này sẽ giải thích cách QuillBot gắn nhãn khi quét, nghiên cứu năm 2025 phát hiện gì về văn bản paraphrase và humanized, và QuillBot tuyên bố điều gì về độ chính xác của chính mình. Bài viết cũng đề cập đến các giới hạn của gói miễn phí và Premium, cũng như mối liên hệ giữa bộ phát hiện này với Turnitin.
Cách bộ phát hiện của QuillBot gắn nhãn cho một văn bản
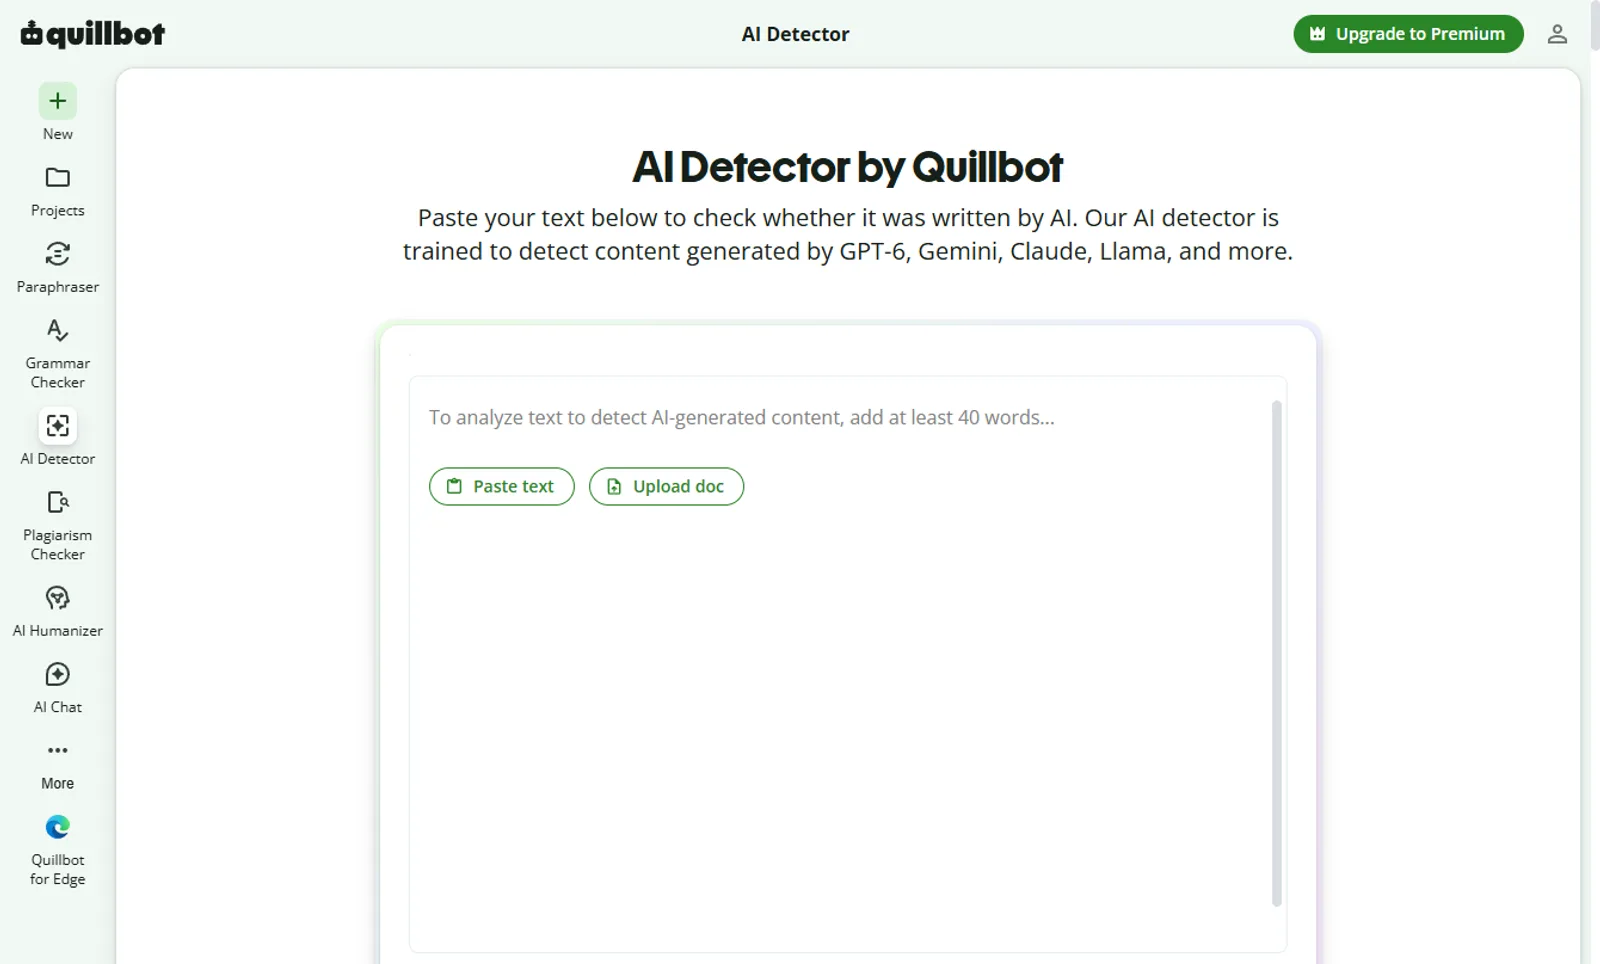
Quét của QuillBot trả về điểm số từ 0% đến 100%. Công cụ cũng trả về một trong ba nhãn: AI-generated, human-written hoặc AI-refined. QuillBot dùng nhãn AI-refined cho phần viết mà một người bắt đầu, sau đó được một công cụ AI chỉnh sửa hoặc paraphrase. Điều này khác với văn bản do một mô hình viết từ đầu. QuillBot áp dụng cả ba nhãn này bất kể công cụ nào của họ đã chạm vào văn bản trước tiên, nếu có.
Trên thực tế, ba nhãn tương ứng với ba tình huống phổ biến. Một câu trả lời hoàn chỉnh do ChatGPT hoặc DeepSeek soạn sẵn, được dán nguyên vẹn mà không chỉnh sửa, thường sẽ được gắn nhãn AI-generated. Một bản thảo của con người chỉ được sửa ngữ pháp thường vẫn được gắn nhãn human-written, vì kiểu chỉnh sửa đó không chạm vào cấu trúc câu. Một bản thảo của con người được diễn đạt lại bởi một paraphraser, hoặc được viết lại bằng một công cụ humanizer AI, chính là trường hợp mà QuillBot thiết kế nhãn AI-refined cho.
Một thẻ giải thích sẽ xuất hiện bên cạnh từng câu bị gắn cờ, kèm theo lý do ngắn gọn như cách diễn đạt dễ đoán hoặc nhịp điệu đều bất thường. Hai tín hiệu này, cách diễn đạt dễ đoán và nhịp điệu câu, trùng khớp với perplexity và burstiness, là các thước đo mà đa số bộ phát hiện AI sử dụng dưới tên gọi này hay tên gọi khác. Giải thích về perplexity trong phát hiện AI của chúng tôi trình bày chi tiết cách hoạt động.
QuillBot khuyến nghị ít nhất 80 từ để có điểm số đáng tin cậy. Họ cho biết độ chính xác tốt nhất khi có từ 300 từ trở lên. Một đoạn ngắn, như một đoạn duy nhất được trích ra khỏi ngữ cảnh, cung cấp cho mô hình ít dữ liệu để làm việc hơn nhiều so với một tài liệu đầy đủ. QuillBot kiểm tra tài liệu theo từng câu thay vì coi như một khối, nên một bài viết dài với chỉ một đoạn AI-refined duy nhất chưa chắc sẽ cho ra điểm tổng thể là AI-generated.
Không có bất kỳ nhãn nào là vĩnh viễn. QuillBot có thể quét lại cùng một văn bản sau khi chỉnh sửa, và nhãn có thể chuyển giữa các nhóm khi cách diễn đạt thay đổi. Điểm số từ một lần quét chỉ mô tả cho một phiên bản văn bản đó. Công cụ không cho biết tài liệu đã được viết theo cách nào.
Chủ website và blogger cũng có thể yêu cầu chứng chỉ QuillBot và huy hiệu xác minh cho một trang đã xuất bản, như một cách để cho thấy trang đó được viết bởi con người. Tính năng này tách biệt với ô quét chính, và hướng đến các nhà xuất bản muốn chứng minh quyền tác giả trên một trang đang hoạt động.
Nghiên cứu năm 2025: QuillBot với DeepSeek, văn bản được paraphrase và humanized
Nghiên cứu năm 2025 của Hulayyil Alshammari và Praveen Rao, đăng trên arXiv, đã thử nghiệm sáu công cụ phát hiện AI đối với văn bản từ DeepSeek-v3. Sáu công cụ đó gồm AI Text Classifier, Content Detector AI, Copyleaks, QuillBot, GPT-2 và GPTZero. Nhóm nghiên cứu bắt đầu với 49 cặp câu hỏi và trả lời do con người viết trước kỷ nguyên LLM, sau đó tạo ra 49 câu trả lời DeepSeek-v3 tương ứng cho cùng các câu hỏi. Họ bổ sung thêm 196 mẫu nữa bằng cách diễn giải và “humanizing” các câu trả lời AI, rồi chấm điểm cả sáu bộ phát hiện trên toàn bộ tập dữ liệu.
DeepSeek-v3 là một mô hình mới hơn so với những mô hình mà hầu hết các bộ phát hiện công khai được tinh chỉnh xoay quanh, và đây là một phần lý do khiến nghiên cứu này hữu ích. Một bộ phát hiện được xây dựng và huấn luyện chủ yếu dựa trên đầu ra theo kiểu ChatGPT không tự động xử lý theo cùng cách khi một mô hình khác viết ra. Việc bắt đầu từ các câu trả lời do con người thật viết trước khi có mô hình ngôn ngữ lớn cũng loại trừ khả năng các ví dụ của con người đã bị AI can thiệp đến mức nào đó.
| Điều kiện (văn bản DeepSeek-v3) | Kết quả của QuillBot trong nghiên cứu |
|---|---|
| Nguyên bản, không chỉnh sửa | Gần như hoàn hảo |
| Được diễn giải | Gần như hoàn hảo |
| Được humanized | Độ chính xác 58% |
QuillBot và Copyleaks đều gần như hoàn hảo trên cả văn bản DeepSeek nguyên bản lẫn bản được diễn giải, nghĩa là mỗi công cụ bỏ sót rất ít mẫu trong các trường hợp đó. Một số công cụ khác trong nghiên cứu, bao gồm AI Text Classifier và GPT-2, lại cho kết quả không nhất quán trên cùng các mẫu. Việc humanizing văn bản là thay đổi ảnh hưởng mạnh nhất đến độ chính xác trong cả sáu bộ phát hiện. Nó làm Copyleaks giảm xuống 71%, QuillBot xuống 58% và GPTZero xuống 52%.
Tập văn bản của nghiên cứu này ở mức vừa phải theo tiêu chuẩn các bài benchmark dành cho bộ phát hiện: 49 câu trả lời do con người viết gốc, 49 câu trả lời DeepSeek-v3 không chỉnh sửa và thêm 196 mẫu nữa được tạo bằng cách diễn giải và humanizing các câu trả lời AI đó. Dữ liệu này đủ để thấy một xu hướng rõ ràng giữa sáu bộ phát hiện, dù tập lớn hơn sẽ cho các tỷ lệ phần trăm chính xác hơn. Bài báo cũng thử nghiệm chính DeepSeek như một bộ phát hiện bằng cách dùng ví dụ few-shot và gợi ý theo chuỗi suy nghĩ thay vì dùng một mô hình phát hiện chuyên dụng. Phần đó nói về khả năng phân loại của chính DeepSeek và không bao gồm kết quả từ QuillBot.
Với ai đã diễn giải một bản nháp AI và chỉ dựa vào điều đó, nghiên cứu này là một điểm dữ liệu hữu ích. Việc diễn giải không làm giảm độ chính xác của QuillBot trong bài thử nghiệm này. Việc sắp xếp lại từ ngữ và thay đổi cấu trúc câu, tự nó, là chưa đủ để tạo ra thay đổi kết quả. Humanizing văn bản là thay đổi duy nhất làm giảm độ chính xác của QuillBot, và QuillBot vẫn phát hiện được phần lớn các mẫu đã được humanized.
Đối với sinh viên, phần hữu ích của kết quả này nằm ở sự khác nhau giữa paraphrasing và rewriting. Paraphraser thay đổi từ ngữ và một phần trật tự câu. Rewriting dựa trên sự hiểu biết của chính bạn sẽ thay đổi lập luận, ví dụ và cấu trúc, và đó là điều khiến một bản nháp trở nên “tự viết”.
QuillBot nói gì về độ chính xác
QuillBot dẫn một tỷ lệ phát hiện 99% trên RAID, một benchmark độc lập bao phủ nhiều mô hình ngôn ngữ lớn. Chúng tôi giải thích RAID thử nghiệm những gì trong bài viết của mình về bộ phát hiện AI của Grammarly, bài này xếp đầu tiên trên bảng xếp hạng của RAID.
FAQ của QuillBot nêu hai điều kiện mà họ kỳ vọng phát sinh nhiều lỗi hơn. Viết theo khuôn mẫu, chẳng hạn như định nghĩa học thuật, văn bản pháp lý hoặc các mẫu khung được cấu trúc sẵn, có khả năng kích hoạt dương tính giả cao hơn. Việc paraphrased mạnh hoặc chỉnh sửa AI nhẹ tay khiến mọi bộ phát hiện đều khó nhận diện hơn. QuillBot cũng cho biết không có bộ phát hiện AI nào đạt 100% độ chính xác, và kết quả nên được xem như một tín hiệu trong nhiều tín hiệu.
Nghiên cứu năm 2025 ở trên bổ sung một điểm dữ liệu độc lập về một mô hình mới hơn, DeepSeek-v3, mà nhiều bộ phát hiện trước đó chưa được tinh chỉnh để nhận diện.
Trang “humanizer” của QuillBot nêu một điểm liên quan về cách công ty định hình toàn bộ bộ công cụ viết bằng AI. Trang này cho biết công cụ humanizer nhằm cải thiện bản nháp và yêu cầu người dùng khai báo việc sử dụng AI theo chính sách của cơ sở đào tạo hoặc nơi làm việc. Cách định hình này cũng áp dụng cho bộ phát hiện trong cùng một tài khoản.
Viết lại cấu trúc cùng với các từ
Công cụ humanizer AI của chúng tôi thay đổi nhịp điệu câu và cấu trúc câu cũng như cách chọn từ, và các trích dẫn, thuật ngữ kỹ thuật cũng như các con số của bạn vẫn được giữ nguyên.
Thử ProofreaderPro.ai miễn phíMiễn phí vs Premium
| Tính năng | Miễn phí | Premium |
|---|---|---|
| Giới hạn từ mỗi lần quét | Tối đa 1.200 từ | Không giới hạn từ |
| Số lần quét hằng ngày | Tối đa 6 | Không giới hạn |
| Thẻ giải thích (explainer cards) | 1 thẻ miễn phí | Không giới hạn, cho toàn bộ văn bản |
| Giá | US$0 | US$4,17 mỗi tháng, thanh toán hằng năm |
Bộ phát hiện AI miễn phí của QuillBot giới hạn mỗi lần quét ở 1.200 từ và cho phép 6 lần quét mỗi ngày, kèm 1 thẻ giải thích cho mỗi lần quét. Premium loại bỏ cả hai giới hạn và bổ sung một thẻ giải thích đầy đủ cho mọi câu bị gắn cờ thay vì chỉ một thẻ. Các công cụ khác của QuillBot cũng được bao gồm với cùng mức giá, US$4,17 mỗi tháng khi thanh toán hằng năm.
Nếu bạn chỉ kiểm tra một bài tập ngắn, rất có khả năng bạn sẽ không bao giờ chạm các giới hạn của gói miễn phí, vì một lần quét bao phủ khoảng bốn trang chữ giãn dòng đôi. Một bài tổng quan tài liệu 6.000 từ, được kiểm tra theo các phần 1.200 từ, sẽ cần năm lần quét trong gói miễn phí, vẫn nằm trong giới hạn sáu lần mỗi ngày. Một chương luận dài hơn, được kiểm tra nhiều lần trong cùng một phiên, là nơi bạn dễ chạm giới hạn hằng ngày nhất. Premium cũng cho phép tải bản sao của toàn bộ báo cáo. Điều này hữu ích nếu giảng viên hoặc biên tập viên muốn xem chi tiết phần giải thích, chứ không chỉ phần trăm cuối cùng.
Bộ phát hiện của QuillBot và Turnitin
Bộ phát hiện AI của QuillBot và Turnitin là hai công cụ riêng biệt, do hai công ty riêng biệt phát triển, và điểm số từ một công cụ không dự đoán được điểm số của công cụ còn lại. Turnitin cấp phép tính năng phát hiện viết bằng AI cho các trường học, đại học và nhà xuất bản, vì vậy phần lớn sinh viên chỉ thấy kết quả Turnitin thông qua giảng viên. Hướng dẫn về điểm Turnitin của chúng tôi giải thích cách Turnitin hiển thị các chỉ số AI và mức độ tương đồng của chính nó.
Tháng 8 năm 2025, Turnitin bổ sung một tính năng mà họ gọi là phát hiện AI bypasser, tức một nhóm mô hình nhắm vào văn bản đã được xử lý qua một công cụ humanizer hoặc một bộ paraphraser nặng. Tính năng này hiện chỉ hỗ trợ tiếng Anh. Hướng dẫn thay thế QuillBot Humanizer của chúng tôi giải thích bản cập nhật này có ý nghĩa gì đối với chính công cụ humanizer của QuillBot.
Khoảng cách thực tế giữa hai công cụ quan trọng nhất đối với bất kỳ ai nộp bài qua một khóa học có Turnitinenabled. Điểm từ QuillBot, kể cả khi trông có vẻ yên tâm, cũng không nói lên liệu báo cáo phát hiện viết bằng AI của Turnitin có hiển thị điểm thấp hay không. Hai công cụ chạy trên dữ liệu huấn luyện khác nhau và các ngưỡng khác nhau.
Nghiên cứu DeepSeek ở trên cho thấy sự tách biệt tương tự. Chỉ paraphrasing thôi không làm giảm độ chính xác của QuillBot hoặc Copyleaks, trong khi humanizing thì có. Bản cập nhật năm 2025 của Turnitin nhắm vào chính khoảng trống đó: văn bản được diễn đạt lại đủ để đọc khác đi, nhưng vẫn mang những mẫu cấu trúc mà bộ phát hiện có thể đo được.
Nếu khóa học của bạn dùng Turnitin, hãy xem kết quả quét của QuillBot như một bước kiểm tra cho bản thảo của bạn và lưu kết quả kèm ghi chú. Nếu sau này giảng viên đặt câu hỏi về kết quả Turnitin, các bản thảo và ghi chú của bạn sẽ là bằng chứng tốt hơn so với bất kỳ điểm số nào, như chúng tôi giải thích trong Quy trình là bằng chứng mới.
Bộ phát hiện AI miễn phí của Scribbr chạy trên công nghệ riêng của QuillBot. Trang bộ phát hiện của Scribbr tải kết quả quét từ quillbot.scribbr.com, một tên miền phụ của QuillBot được thiết lập cho trang web của Scribbr, thông qua một tập lệnh đối tác của QuillBot. Xem bộ phát hiện AI của Scribbr của chúng tôi trình bày ý nghĩa của điều đó đối với kết quả của chính Scribbr.
Nếu bạn đã diễn đạt lại một bản nháp do AI tạo và chỉ dựa vào điều đó, nghiên cứu ở trên đáng được xem thêm lần nữa. Việc viết lại nội dung từ ghi chú của riêng bạn, với ví dụ của riêng bạn và cấu trúc của riêng bạn sẽ thay đổi nhiều hơn đối với một bài viết so với việc chỉ dùng công cụ paraphraser. Nếu bạn muốn so sánh các công cụ với nhau trước, hướng dẫn QuillBot thay thế cho bài viết học thuật và phần ProofreaderPro.ai so với QuillBot của chúng tôi đều trình bày rõ QuillBot phù hợp ở đâu trong các bản nháp học thuật. Dù bạn chọn theo hướng nào, hướng dẫn của chính QuillBot vẫn áp dụng: hãy khai báo việc hỗ trợ AI theo quy định của môn học hoặc nơi làm việc của bạn, bất kể điểm số từ bất kỳ công cụ detector nào. công cụ humanizer AI học thuật của chúng tôi được thiết kế để cho điểm thấp trong các bài kiểm tra AI bằng cách thay đổi cả cấu trúc câu lẫn cách chọn từ, và vẫn giữ nguyên các trích dẫn, thuật ngữ kỹ thuật cũng như các con số.
Câu hỏi thường gặp
Q: Quy trình phát hiện AI của QuillBot có thể phát hiện chính công cụ paraphraser của nó không?
Với văn bản được diễn đạt lại thông thường, có. Một nghiên cứu năm 2025 của Alshammari và Rao cho thấy bộ phát hiện của QuillBot gần như chính xác tuyệt đối trên văn bản DeepSeek-v3 đã được chạy qua paraphraser. Việc “humanizing” cùng văn bản này là một thử thách lớn hơn, làm giảm độ chính xác của QuillBot xuống 58% trong nghiên cứu đó.
Q: Bộ phát hiện AI của QuillBot có hoạt động với văn bản DeepSeek không?
Có. Nghiên cứu năm 2025 tương tự đã thử nghiệm QuillBot cụ thể trên đầu ra DeepSeek-v3 và cho kết quả gần như chính xác đối với cả phiên bản gốc lẫn phiên bản diễn đạt lại, khớp với hiệu năng của Copyleaks trong thử nghiệm đó.
Q: “AI-refined” trong QuillBot có nghĩa là gì?
Đó là nhãn của QuillBot dành cho nội dung bắt đầu từ văn bản do chính một người viết, sau đó được chỉnh sửa hoặc diễn đạt lại bằng một công cụ AI, thay vì được viết mới hoàn toàn bởi một mô hình từ đầu. QuillBot chấm theo từng câu, nên một đoạn văn được “AI-refined” sẽ không làm toàn bộ tài liệu trở thành kết quả do AI tạo.
Q: Tôi có thể kiểm tra miễn phí tối đa bao nhiêu từ?
Tối đa 1.200 từ khi quét, với tối đa sáu lần quét mỗi ngày trong gói miễn phí của QuillBot. Premium xóa cả hai giới hạn này với US$4.17 mỗi tháng, thanh toán hằng năm.
Q: QuillBot Premium có đáng tiền nếu chỉ để dùng cho bộ detector không?
Điều đó còn tùy bạn quét tần suất như thế nào và tài liệu của bạn dài bao nhiêu. Premium xóa giới hạn 1.200 từ và giới hạn sáu lần quét mỗi ngày, đồng thời thêm phần giải thích đầy đủ cho từng câu bị gắn cờ thay vì chỉ một phần. Các công cụ còn lại của QuillBot vẫn được bao gồm với cùng mức giá.
Q: Turnitin có phát hiện việc QuillBot diễn đạt lại không?
Thường là có. Turnitin đã thêm lớp phát hiện AI-paraphrasing chuyên biệt vào tháng 7 năm 2024 và một lớp AI-bypasser vào tháng 8 năm 2025, nhằm vào văn bản đã được xử lý qua công cụ humanizer hoặc paraphraser nặng. Hướng dẫn QuillBot Humanizer Alternative của chúng tôi bao quát toàn bộ bức tranh.
Q: Bộ phát hiện của QuillBot có hoạt động trên các ngôn ngữ khác không?
Có. QuillBot cho biết AI Detector của họ hỗ trợ hơn 20 ngôn ngữ, bao gồm tiếng Anh, tiếng Tây Ban Nha, tiếng Pháp và tiếng Bồ Đào Nha. Công cụ AI Humanizer của họ hỗ trợ ít ngôn ngữ hơn: tiếng Tây Ban Nha, tiếng Đức, tiếng Pháp, tiếng Bồ Đào Nha và bốn giọng tiếng Anh.
Q: Bộ phát hiện của QuillBot có giống với Scribbr không?
Largely, là có. Trang AI Detector của Scribbr tải kết quả quét từ quillbot.scribbr.com, một tên miền phụ của QuillBot, thông qua một đoạn script của đối tác QuillBot được nhúng trực tiếp trong trang. Hướng dẫn xem AI detector của Scribbr của chúng tôi giải thích cách Scribbr trình bày các kết quả do chính công cụ đó tạo ra.
Viết lại các bản nháp học thuật có hỗ trợ AI trong khi các trích dẫn, thuật ngữ và ý nghĩa của bạn được giữ nguyên.
Dana là người sáng tạo nội dung tại ProofreaderPro, nơi cô điều hành hoạt động viết blog và viết blog hàng ngày. Cô ấy viết các bài báo về cách hoạt động của nền tảng chỉnh sửa trực tuyến và cô ấy xử lý tin nhắn của khách hàng hàng ngày với điểm hài lòng là 5 sao để thể hiện điều đó.