
OpenAI, Google và Anthropic đều đã xây dựng cùng một công nghệ: một watermark thống kê cho văn bản do AI tạo ra. OpenAI giữ phiên bản của mình lại trong nhiều năm và bắt đầu triển khai, với tên textGrain, vào tháng 10 năm 2026. Google tích hợp SynthID vào Gemini và công bố phương pháp. Anthropic yêu cầu watermark của Claude bắt buộc cho mọi người dùng vào tháng 8 năm 2026. Nếu bạn viết với sự hỗ trợ của AI dưới bất kỳ hình thức nào, cả ba quyết định đó hiện nay đều quyết định cách tài liệu của bạn được đánh giá.
Watermarking chuyển từ một chủ đề nghiên cứu sang tin tức phổ biến trên báo chí vào ngày 11 tháng 8 năm 2026, khi Anthropic công bố rằng mọi mô hình Claude mới đều đánh dấu đầu ra văn bản. Chúng tôi đã phân tích chi tiết thông báo đó trong bài Giải thích về Watermark của Claude từ Anthropic (2026). Hướng dẫn này bao quát toàn bộ bức tranh: watermark văn bản là gì, từng trong ba phòng thí nghiệm lớn đã triển khai hay từ chối đến đâu, và mỗi hệ thống cho thấy điều gì về một bài viết.
Watermark văn bản AI là gì?
Watermark văn bản AI là một mẫu thống kê được ẩn trong cách chọn từ của văn bản do tạo sinh, được gieo ngay tại thời điểm tạo ra để một bộ phát hiện có đúng khóa sau đó có thể xác minh rằng văn bản đến từ một hệ thống AI cụ thể. Đây không phải là nhãn hiển thị, không phải ký tự ẩn, và không phải siêu dữ liệu gắn kèm vào tệp. Dấu nằm ngay trong các từ của chính văn bản.
Sự phân biệt đó quan trọng, vì thuật ngữ "watermark" được dùng một cách lỏng lẻo cho ba thứ khác nhau:
| Nó là gì | Nó nằm ở đâu | Chép dán có còn sống sót không? | |
|---|---|---|---|
| Watermark thống kê | Một dạng thiên lệch trong việc mô hình chọn từ | Chính văn bản đó | Có |
| Siêu dữ liệu tệp (C2PA) | Một nhãn nguồn gốc có chữ ký | Thùng chứa tệp | Không, việc sao chép bản văn thuần sẽ làm nó mất đi |
| Ký tự độ rộng bằng không | Ký tự Unicode vô hình được chèn vào văn bản | Nằm giữa các ký tự nhìn thấy được | Không, bị loại bỏ một cách dễ dàng |
Mã dán thủy vân thống kê là phương pháp duy nhất trong ba phương pháp còn sống sót khi sao chép, dán, gõ lại vào một tài liệu mới và khi chuyển đổi định dạng. Đó là lý do cả ba phòng thí nghiệm lớn đều hội tụ vào nó cho văn bản, và vì sao các công cụ "gỡ watermark" loại bỏ ký tự vô hình không có tác dụng gì trước nó. Trang gỡ watermark cho Claude miễn phí của chúng tôi ghi lại đúng trường hợp thất bại này kèm nguồn tham khảo.
Mã dán thủy vân thống kê thực sự hoạt động như thế nào?
Ở mọi bước khi viết một câu, một mô hình ngôn ngữ sẽ chọn giữa nhiều từ gần tương đương, và mã dán thủy vân âm thầm tải các con xúc xắc đó. Công thức nền tảng được công bố bởi Kirchenbauer và cộng sự tại Đại học Maryland vào tháng 1 năm 2023 trong Watermark cho mô hình ngôn ngữ lớn (ICML 2023). Hoạt động như sau:
- Trước khi chọn mỗi từ, một khóa bí mật được suy ra từ các từ đứng trước sẽ chia bộ từ vựng thành tập ưu tiên và tập trung tính.
- Mô hình sẽ điều chỉnh lựa chọn của mình nghiêng về tập ưu tiên. "Suggest" thay vì "indicate". "Across" thay vì "among". Mỗi lần chọn riêng lẻ trông hoàn toàn tự nhiên.
- Bộ phát hiện giữ khóa sẽ đếm xem văn bản rơi vào các tập ưu tiên với tần suất bao nhiêu. Bài viết của con người thường đạt đúng tần suất kỳ vọng nhờ ngẫu nhiên. Văn bản có dán thủy vân vượt xa tần suất đó, và một phép thử thống kê sẽ báo hiệu sự khác biệt.
Không có một từ đơn lẻ nào là bằng chứng của bất kỳ điều gì. Tín hiệu chỉ xuất hiện khi xét trên hàng chục hoặc hàng trăm lần lựa chọn, đó là lý do các đoạn dài dễ kiểm tra hơn các đoạn ngắn, và vì sao việc phát hiện luôn mang tính xác suất, chứ không phải dấu xác nhận có hay không.
Hệ thống sản xuất của Google DeepMind, được công bố trên Nature vào tháng 10 năm 2024 trong Kỹ thuật thủy vân có thể mở rộng để xác định đầu ra của mô hình ngôn ngữ lớn, đã tinh chỉnh thêm bằng một kỹ thuật gọi là tournament sampling, giúp chất lượng văn bản vẫn tốt đến mức có thể chạy âm thầm trong một sản phẩm tiêu dùng ở quy mô lớn. Bài báo này quan trọng vượt ra ngoài Google: đây là cơ sở đã được Anthropic trích dẫn cho phần triển khai của Claude.
Điểm yếu chính đã được công bố trước hầu hết các lần triển khai. Vào tháng 3 năm 2023, Krishna và cộng sự đã chứng minh trong Paraphrasing evades detectors of AI-generated text (NeurIPS 2023) rằng việc tạo lại cách diễn đạt của một đoạn sẽ làm sụp việc phát hiện trên nhiều phương pháp, bao gồm cả watermarking. Tín hiệu nằm trong đúng chuỗi token, và không nằm ở đâu khác, nên bất kỳ thứ gì viết lại chuỗi đó, kể cả một biên tập viên con người, sẽ làm mất bằng chứng. Mọi nhà cung cấp triển khai watermark hiện nay đều nêu rõ hạn chế này trong tài liệu riêng của họ.

OpenAI: công ty đã phát minh ra nó và công bố muộn nhất
OpenAI đã có một mã dán thủy vân văn bản hoạt động trong nhiều năm và chọn không phát hành cho đến tháng 10 năm 2026. Scott Aaronson, khi đó đang làm về an toàn tại OpenAI, lần đầu mô tả ý tưởng này công khai trong một bài giảng tháng 11 năm 2022. Phương pháp này thiên lệch các lựa chọn của mô hình giữa những từ gần tương đương bằng một hàm mã hóa bí mật, nên chính văn bản cho thấy nó đến từ đâu. Bài giảng đó cũ hơn mọi hệ thống đã triển khai.
Vào tháng 5 năm 2024, OpenAI đã mô tả tình trạng của dự án trong bản cập nhật về nguồn gốc (provenance update), Hiểu nguồn gốc của những gì chúng ta thấy và nghe trực tuyến. Công ty cho biết phương pháp đóng dấu thủy văn văn bản của họ chính xác và hiệu quả với các chỉnh sửa nhỏ, nhưng họ tạm hoãn việc phát hành trong lúc cân nhắc các đánh đổi. Hai trong số những rủi ro mà OpenAI nêu ra tác động trực tiếp đến người viết học thuật:
- Dễ vượt rào. Việc diễn giải hoặc dịch văn bản sẽ loại bỏ dấu, đúng như nghiên cứu năm 2023 đã dự đoán. Một watermark chủ yếu bắt được những người không biết nó tồn tại thì là công cụ thực thi yếu.
- Ảnh hưởng không cân xứng đến người nói tiếng Anh không phải ngôn ngữ mẹ đẻ. OpenAI cho biết việc đóng dấu thủy văn có thể gây kỳ thị đối với việc sử dụng hợp pháp AI như một công cụ hỗ trợ viết cho những người viết bằng ngôn ngữ thứ hai. Bài viết của chúng tôi về vì sao công cụ AI detector gắn cờ người viết không phải người bản ngữ cũng đề cập vấn đề tương tự từ phía detector.
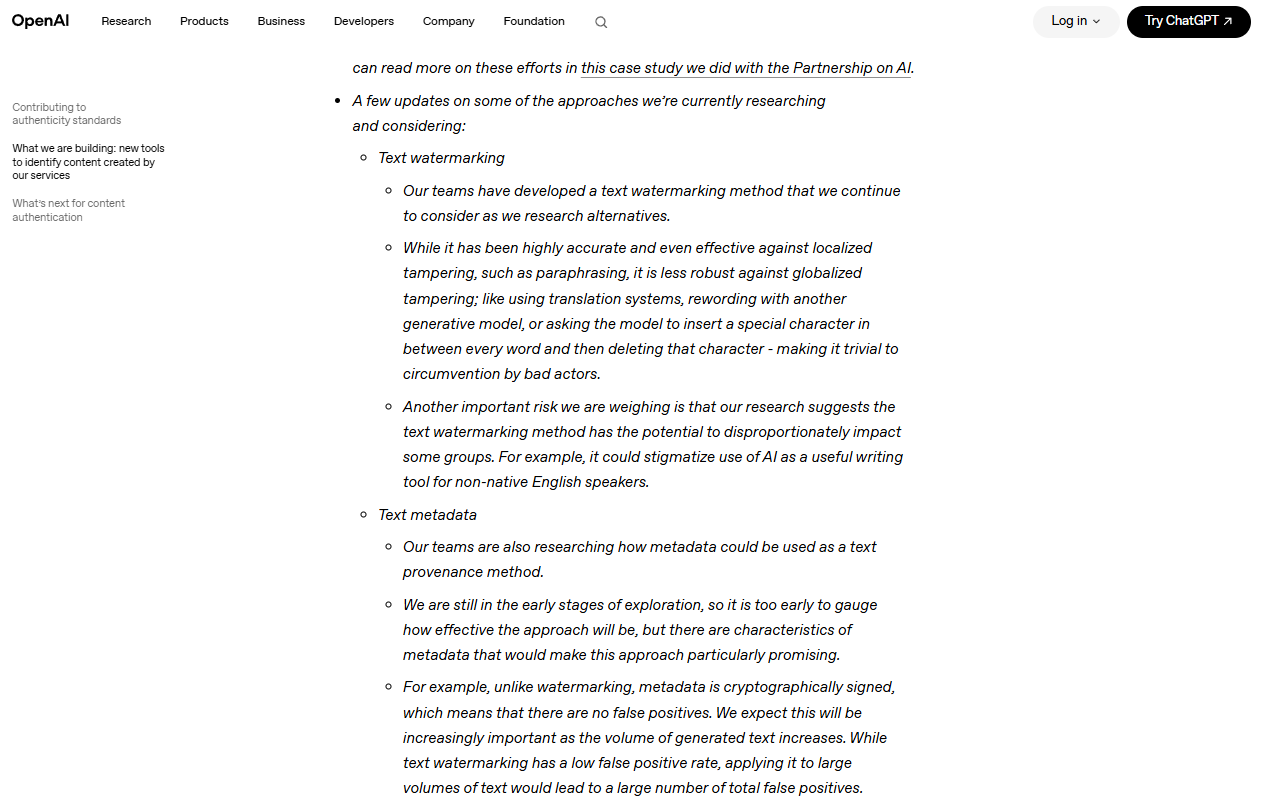
Bản cập nhật provenance năm 2024 của OpenAI: phương pháp hoạt động, và công ty liệt kê các lý do khiến họ giữ lại thời điểm đó.
Đối với hình ảnh và âm thanh, OpenAI đi theo hướng khác: siêu dữ liệu provenance C2PA trong đầu ra của DALL-E và Sora, tức là nhãn ở cấp tệp chứ không phải dấu trong nội dung. Với văn bản, đầu ra của ChatGPT không có watermark cho đến tháng 10 năm 2026. Công ty đề xuất công nghệ này là công ty cuối cùng trong ba bên triển khai nó.
OpenAI hiện có đóng watermark cho văn bản không?
Có, từ ngày 5 tháng 10 năm 2026, OpenAI bắt đầu đóng watermark một số dạng văn bản, để đáp ứng Đạo luật AI của EU. Bài thông báo của họ giới thiệu một watermark văn bản có tên textGrain, bổ sung một tín hiệu thống kê vô hình vào các lựa chọn từ của mô hình. Việc triển khai có ba phần, và watermark không phải là mặc định áp dụng toàn cục:
- Khách hàng dùng API ở bất kỳ đâu có thể bật đầu ra đã được watermark cho một số mô hình nhất định. Tùy chọn này mặc định là tắt.
- Trong các tuần tiếp theo, phần đầu ra văn bản của ChatGPT và Codex đáp ứng điều kiện tại Liên minh châu Âu sẽ nhận watermark, trên tất cả các gói.
- Các nhà nghiên cứu được phê duyệt và các tổ chức chuyên môn có thể nộp đơn để xin quyền truy cập vào trình dò watermark văn bản.
OpenAI cho biết textGrain đạt mức tương đương hoặc vượt các phương pháp khác mà họ đã thử nghiệm, bao gồm SynthID của Google cho văn bản. Họ cũng công bố nơi mà việc phát hiện trở nên yếu hơn. Với tỷ lệ dương tính giả là 1%, trình dò nhận diện watermark trong khoảng 80% các đoạn 200 từ và khoảng 95% các đoạn 400 từ đối với nội dung về tâm lý học. Mức phát hiện thấp hơn nhiều đối với toán học, nơi lựa chọn từ ít linh hoạt hơn.
Việc chỉnh sửa làm suy yếu tín hiệu nhanh chóng. Ở các đoạn 400 từ, việc thay thế 10% số từ bằng từ đồng nghĩa đã làm giảm phát hiện từ khoảng 92% xuống còn 66%, và thay thế 25% thì giảm xuống còn 17%.
OpenAI cũng kiểm tra liệu watermark có làm thay đổi chất lượng câu trả lời trên Astra, mô hình mới nhất của họ hay không, và nói rằng họ không thấy khác biệt có ý nghĩa. Dưới đây là bốn trong số các bộ chuẩn (benchmarks) mà họ công bố:
| Benchmark | Không có watermark (Astra) | Có watermark (Astra) |
|---|---|---|
| Artificial Analysis Intelligence Index | 49.57 điểm | 49.76 điểm |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
Với học sinh, ngày tháng là quan trọng. Văn bản ChatGPT được viết trước đợt triển khai, hoặc ở ngoài EU mà không bật tùy chọn trên API, sẽ không có watermark của OpenAI. Hướng dẫn của chúng tôi về Turnitin Clarity được giải thích giải thích cách các trường đang thiết lập chính sách sử dụng AI của riêng họ trong giai đoạn này.
Có công cụ kiểm tra watermark của OpenAI nào dành cho công chúng không?
Hiện tại chưa có công cụ kiểm tra watermark OpenAI cho văn bản ở dạng công khai. Công cụ công cụ xác minh miễn phí của OpenAI kiểm tra tệp hình ảnh và âm thanh để xác nhận C2PA Content Credentials và một watermark SynthID. OpenAI nhúng SynthID vào các hình ảnh và âm thanh được hỗ trợ. OpenAI cho biết công cụ này không hỗ trợ văn bản.
Đối với văn bản, OpenAI cung cấp quyền truy cập bộ dò theo từng trường hợp cho các nhà nghiên cứu đã được phê duyệt và các tổ chức chuyên môn, thông qua biểu mẫu Content Provenance API. OpenAI nói rằng họ chưa đưa bộ dò văn bản ra công khai ngay từ khi ra mắt vì rủi ro bỏ sót watermark và cảnh báo sai. Bộ dò sẽ báo cáo liệu có tìm thấy watermark OpenAI hay không, và nó không xác định người dùng cũng như không hiển thị prompt của họ.
| Bạn muốn kiểm tra | Công cụ | Ai có thể sử dụng |
|---|---|---|
| Một tệp hình ảnh hoặc âm thanh của OpenAI | Công cụ xác minh của OpenAI | Bất kỳ ai, miễn phí |
| Đầu ra văn bản của OpenAI (textGrain) | Bộ dò watermark văn bản của OpenAI | Các nhà nghiên cứu đã được phê duyệt và các tổ chức chuyên môn, theo đơn |
| Đầu ra văn bản của Claude | Bộ dò watermark của Claude | Các tổ chức đủ điều kiện, theo đơn (xem hướng dẫn watermark của Claude) |
OpenAI cũng nêu rõ những gì kết quả không thể cho bạn biết. Việc phát hiện watermark không đo được mức độ một người đã đóng góp, và cũng không xác định ai đã viết hoặc đã sử dụng văn bản đó. Thiếu watermark cũng không chứng minh được tác giả là con người, vì văn bản có thể quá ngắn, đã được chỉnh sửa, dịch, hoặc đến từ một mô hình không được hỗ trợ.
Google: đơn vị đầu tiên triển khai, rồi sau đó công bố công thức
Google DeepMind triển khai trước, công bố đầy đủ, rồi mở phương pháp ra. Hệ thống của họ, SynthID, ban đầu là watermark cho hình ảnh vào năm 2023 và mở rộng sang văn bản vào năm 2024. Đến thời điểm bài báo Nature xuất hiện vào tháng 10 năm 2024, SynthID-Text đã chạy sẵn bên trong Gemini ở môi trường sản xuất, khiến nó trở thành watermark văn bản thống kê đầu tiên được triển khai ở quy mô người dùng đại trà.
SynthID bao phủ văn bản, hình ảnh, âm thanh và video, và đã chạy trong đầu ra văn bản của Gemini từ tháng 10 năm 2024.
Sau đó, Google công bố cách triển khai dưới dạng mã nguồn mở trên Hugging Face, cho phép mọi nhà phát triển áp dụng cùng sơ đồ watermarking cho các mô hình của riêng họ. Tháng 5 năm 2025, họ công bố SynthID Detector, một cổng xác minh nơi nội dung có thể được kiểm tra các dấu SynthID trên văn bản, hình ảnh, âm thanh và video.
Một giới hạn phạm vi quan trọng cần lưu ý: SynthID chỉ đánh dấu và chỉ phát hiện nội dung từ các mô hình do Google tự phát triển. Hệ thống không nói gì về đầu ra của ChatGPT hay Claude, và quét SynthID sạch không đồng nghĩa với việc văn bản được viết bởi con người. Điều đó có nghĩa là các mô hình của Google đã không tạo ra văn bản đó, là một nhận định hẹp hơn nhiều.
Anthropic: triển khai sau cùng, nhưng chính sách nghiêm ngặt nhất
Anthropic triển khai muộn nhất, với phạm vi bao phủ bắt buộc rộng nhất. Mọi mô hình Claude ra mắt vào hoặc sau ngày 2 tháng 8 năm 2026 đều nhúng một watermark thống kê vào đầu ra văn bản, trên toàn thế giới, trong mọi gói, không có tùy chọn từ chối. Công ty mô tả cơ chế này trong phần giải thích, Cách watermark văn bản của Claude hoạt động, và phạm vi chính sách trong bài viết ở trung tâm trợ giúp, Cách Claude đánh dấu nội dung do AI tạo. Cụ thể, Claude API, claude.ai, Claude Code, Claude Cowork và Claude Tag đều nằm trong phạm vi. Các mô hình ra mắt trước mốc thời gian sẽ ở giai đoạn chuyển tiếp, và Anthropic cho biết họ cũng đang bổ sung hỗ trợ đánh dấu cho các mô hình đó. Cùng với dấu thống kê, các tệp do Claude tạo ra cũng mang siêu dữ liệu C2PA, là một hệ thống riêng biệt thứ hai, mà việc sao chép văn bản thuần thường sẽ cắt bỏ.
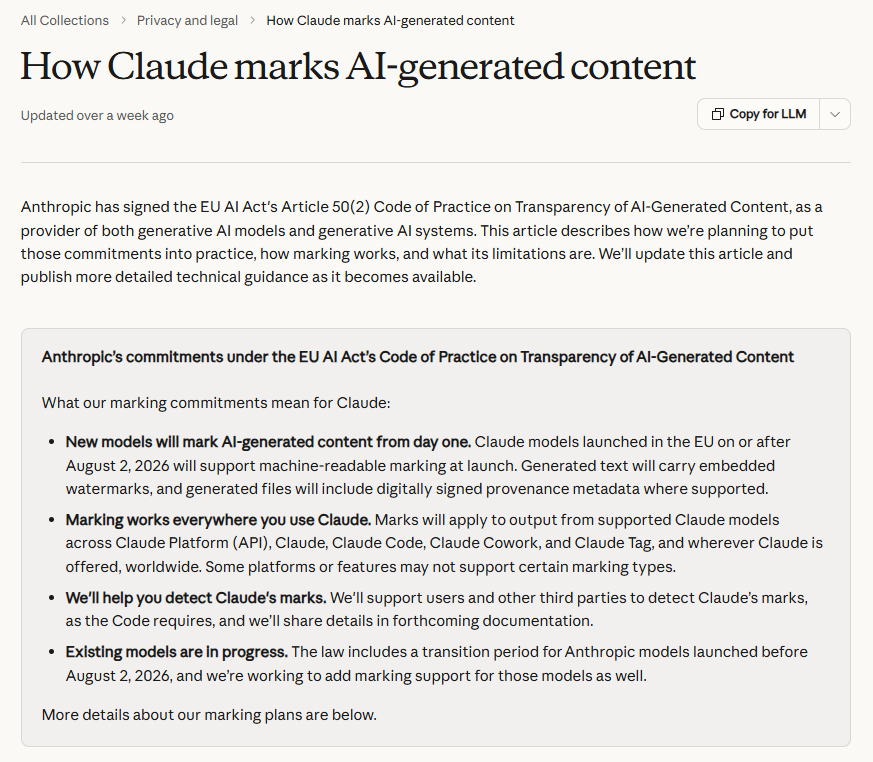
Theo đúng ngôn từ trong chính sách của Anthropic: mọi mô hình mới, mọi nền tảng, trên toàn thế giới, với các mô hình cũ được bổ sung thêm.
Tài liệu của Anthropic nêu rõ giới hạn. Việc phát hiện mang tính xác suất. Nhãn không thể phân biệt được một tài liệu do Claude viết với một tài liệu do con người viết rồi Claude chỉ chỉnh sửa nhẹ. Viết lại hoàn toàn sẽ xóa nhãn đó. Chúng tôi đã đi qua toàn bộ nội dung này, bao gồm việc một kết quả phát hiện dương tính thực sự chứng minh điều gì và cần làm gì nếu bài viết của chính bạn bị gắn nhãn, trong hướng dẫn chuyên biệt về watermark Claude.
Thời điểm tuân theo quy định. Anthropic đã ký Bộ Quy tắc Thực hành Điều 50(2) về Minh bạch đối với Nội dung do AI tạo ra theo EU AI Act, trong đó yêu cầu các nhà cung cấp hệ thống AI sinh ra phải đảm bảo rằng đầu ra được "đánh dấu theo định dạng mà máy có thể đọc được và có thể nhận biết là được tạo nhân tạo." Những nghĩa vụ minh bạch đó bắt đầu có hiệu lực vào ngày 2 tháng 8 năm 2026: ngày cắt mốc chính xác trong chính sách mô hình của Anthropic, sớm hơn công bố công khai chín ngày. Anthropic lựa chọn tuân thủ trên toàn cầu thay vì duy trì hành vi tách riêng cho luồng truy cập từ EU. Google đã tuân thủ sẵn theo thiết kế. Câu hỏi tuân thủ công khai cho năm 2027 là phần đầu ra văn bản không được đánh dấu của OpenAI.
Ba cách tiếp cận, đặt cạnh nhau
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| Có triển khai watermark cho văn bản không? | Có (textGrain, triển khai cho EU từ ngày 5 tháng 10 năm 2026) | Có (Gemini, từ tháng 10 năm 2024) | Có (các mô hình Claude từ ngày 2 tháng 8 năm 2026) |
| Kỹ thuật | textGrain, một tín hiệu thống kê dựa trên lựa chọn từ ngữ | Torne o lấy mẫu kiểu SynthID | Nhãn bằng lấy mẫu thống kê, theo phong cách SynthID |
| Phạm vi áp dụng | Văn bản của ChatGPT và Codex đủ điều kiện trong EU; API bật tùy chọn trên toàn thế giới | Chỉ các mô hình của Google | Tất cả mô hình Claude mới; các mô hình cũ đang trong giai đoạn chuyển tiếp |
| Tắt/miễn trừ | Tắt theo mặc định trong API | Không | Không |
| Bộ phát hiện công khai | Không | Cổng SynthID Detector (2025) | Dự kiến, chưa được phát hành |
| Đã công bố sơ đồ chưa? | Chỉ các bài giảng dạng khái niệm | Bài báo Nature + mã nguồn mở | Trình giải thích, dựa trên các nghiên cứu đã công bố |
| Siêu dữ liệu tệp (C2PA) | Có, hình ảnh và âm thanh | Có, trên nhiều loại phương tiện | Có, trên các tệp được tạo |
| Giới hạn được nêu | Tránh né, kỳ thị ESL | Phạm vi chỉ giới hạn trong các mô hình của chính công ty | Mang tính xác suất, các chỉnh sửa làm mờ quyền tác giả |
Mẫu hình xuyên suốt các cột: OpenAI coi việc đóng watermark văn bản là một vấn đề chính sách chưa được giải quyết, Google coi đó là hạ tầng cần chuẩn hóa, và Anthropic coi đó là một nghĩa vụ tuân thủ cần triển khai đầy đủ.
Điều này có ý nghĩa gì đối với các nhà nghiên cứu và người viết bài học thuật
Hậu quả thực tiễn phụ thuộc vào việc những công cụ nào chạm vào bài viết của bạn. Nếu bạn viết nháp bằng ChatGPT, bài viết của bạn hiện không có watermark. Nếu bạn viết nháp bằng Gemini, nó mang dấu SynthID mà chỉ bộ phát hiện của Google mới đọc được. Nếu bạn viết nháp hoặc chỉnh sửa bằng một mô hình Claude hiện tại, nó mang dấu của Anthropic, và không có thiết lập nào tắt điều đó.
Ba điều người viết học thuật nên biết:
Watermark dùng để nhận diện công cụ, không phải tác giả. Mọi nhà cung cấp đều nêu điều này trong tài liệu của họ, và đáng để nhắc lại vì các chính sách của tổ chức không phải lúc nào cũng phân biệt rõ. Văn bản có thể được gắn watermark vì một AI đã viết nháp nó, vì một AI đã biên tập chính xác hai câu trong đó, hoặc vì một đoạn được đánh dấu đã được trích dẫn. Nếu tổ chức của bạn thực hiện kiểm tra watermark, thì thứ mà phép kiểm tra chứng minh là một mô hình cụ thể đã chạm vào văn bản ở một thời điểm nào đó, chứ không phải gì khác. Hướng dẫn của chúng tôi về khiếu nại cờ phát hiện AI sai đề cập cách đưa ra lập luận đó khi nó quan trọng.
Watermark và AI detectors là hai công nghệ khác nhau với các kiểu lỗi khác nhau. Các bộ phát hiện như Turnitin hoặc GPTZero đoán dựa trên phong cách mang tính thống kê, với các vấn đề về độ chính xác mà chúng tôi đã ghi nhận. Phát hiện watermark là một bài kiểm tra dựa trên khóa, có tỷ lệ dương tính giả rất thấp đối với văn bản do con người chưa bị watermark. Sự bất đối xứng được lật lại đối với âm tính giả: kiểm tra watermark bỏ sót mọi văn bản AI từ một mô hình không gắn watermark, mà hiện tại bao gồm tất cả ChatGPT.
Việc công bố vẫn là vị trí vững chắc nhất của bạn. Dấu watermark khiến việc dùng AI lén lút trở nên rủi ro hơn và việc dùng AI được công bố an toàn hơn, vì quy trình đã công bố thì không có gì phải lo trước một dấu hiệu tích cực. Hầu hết tạp chí và trường đại học hiện có chính sách dùng AI nêu rõ; chính sách dùng AI của chúng tôi giải thích cách chúng tôi vạch ra những ranh giới đó trên các công cụ của chính mình, và đây là một khuôn mẫu hợp lý cho “cách dùng được minh bạch” trông như thế nào.
Điều gì loại bỏ thủy ấn văn bản, và điều gì không
Việc viết lại sẽ loại bỏ được; định dạng lại thì không. Việc sao chép, dán, đổi phông chữ, chuyển đổi giữa các định dạng tệp và xóa ký tự vô hình đều để lại một thủy ấn thống kê vẫn còn nguyên vẹn, vì dấu ấn nằm trong cách chọn từ. Thứ loại bỏ dấu ấn đó là bất cứ điều gì tạo ra lại phần nội dung: một chỉnh sửa mang tính con người sâu sắc, một bản dịch, hoặc một diễn giải thực sự, như công trình tính bền vững NeurIPS 2023 đã chứng minh trước khi bất kỳ hệ thống nào trong số này được phát hành.
Hai chiều đều quan trọng ở đây. Việc dấu biến mất không có nghĩa là văn bản đã thuộc về bạn, và việc dấu vẫn tồn tại cũng không có nghĩa là văn bản không thuộc về bạn. Một bản nháp do AI viết lại vẫn là tài liệu có sự hỗ trợ của AI, và các quy định công bố của tổ chức bạn vẫn áp dụng cho nó. Công cụ công cụ humanizer AI viết lại các bản nháp có hỗ trợ của AI sang văn phong học thuật tự nhiên, và vì quá trình đó tái tạo chuỗi token nên các dấu thống kê không tồn tại sau nó. Riêng với văn bản của Claude, công cụ xóa watermark Claude miễn phí diễn đạt lại từng câu bằng cách dùng cách diễn đạt mới trong khi vẫn giữ nguyên dữ kiện, con số và trích dẫn. Thứ mà không công cụ nào có thể thay đổi là nghĩa vụ của bạn đối với người đọc: tính minh bạch về cách tài liệu được tạo ra.
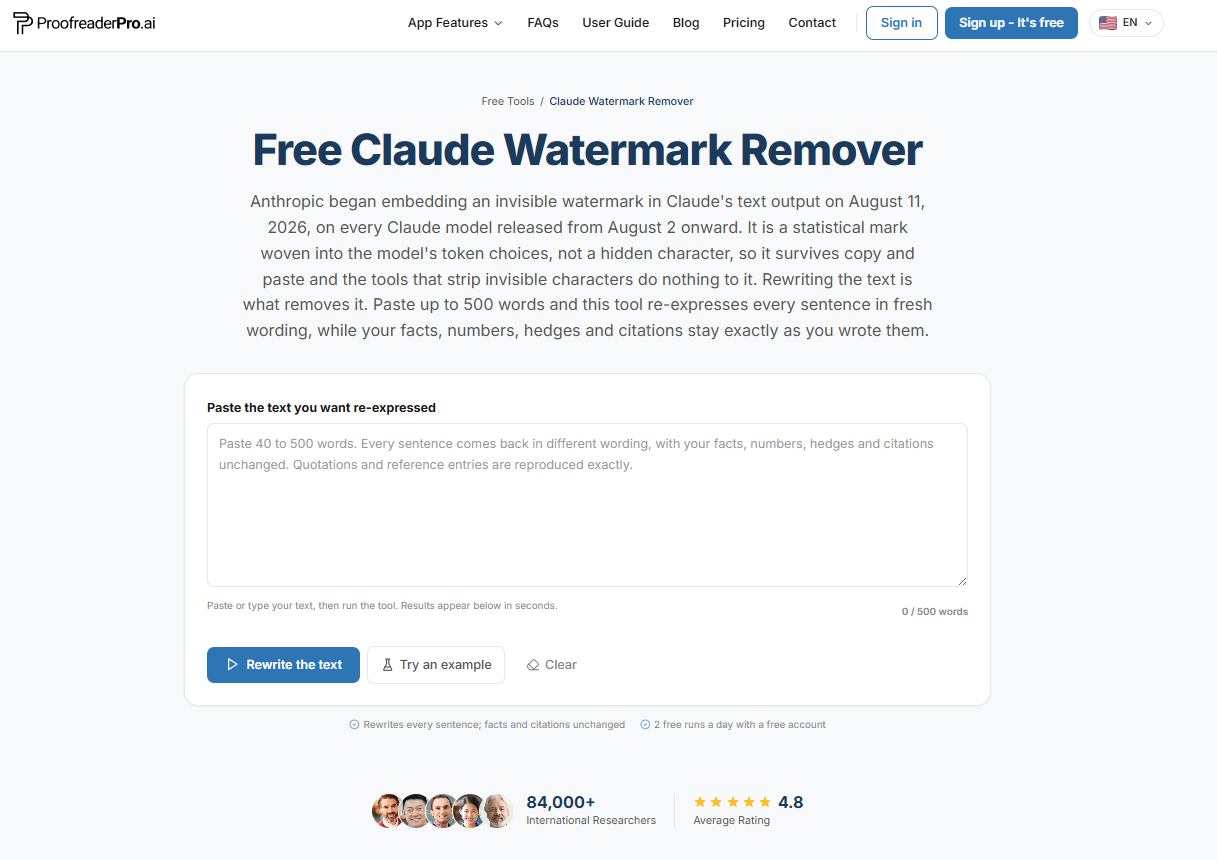
Việc viết lại là thao tác duy nhất loại bỏ dấu thống kê, và chính đó là điều công cụ này thực hiện, theo từng câu.
Nó sẽ đi tiếp theo hướng nào
Theo dõi ba điều đến năm 2027. Thứ nhất, liệu OpenAI có mở rộng textGrain ra ngoài EU không: nó bắt đầu ở đó vì việc thực thi ở EU đối với Điều 50 yêu cầu có dấu có thể đọc được bằng máy trên văn bản AI. Thứ hai, liệu các bộ phát hiện có hội tụ không. Nếu mọi phòng thí nghiệm lớn đều watermark theo một sơ đồ đã công bố, các trường đại học có thể kiểm tra khóa thay vì đoán từ phong cách viết, điều này sẽ cải thiện so với tình trạng phát hiện dễ dương tính giả hiện nay. Thứ ba, liệu các dấu có trở nên tương thích không. Hiện tại, ba phòng thí nghiệm dùng ba loại dấu khác nhau, và không có một cơ chế kiểm tra đơn lẻ nào bao phủ hết. C2PA lấp khoảng trống đó cho các tệp, còn chưa có gì lấp khoảng trống đó cho văn bản gốc.
ChatGPT có watermark văn bản không?
Có, một phần, kể từ ngày 5 tháng 10 năm 2026. OpenAI bắt đầu thêm watermark textGrain vào các văn bản của ChatGPT và Codex đủ điều kiện tại Liên minh châu Âu, và khách hàng dùng API ở bất kỳ nơi đâu có thể bật tùy chọn này. Watermark là tín hiệu thống kê trong cách chọn từ, không có ký tự ẩn. OpenAI cũng áp metadata nguồn gốc C2PA cho các tệp media của DALL-E và Sora, đây là một hệ thống riêng, ở cấp độ tệp.
Google Gemini có watermark văn bản không?
Có. Đầu ra của Gemini đã mang watermark SynthID-Text do Google DeepMind gắn kể từ tháng 10 năm 2024. Đây là một dấu thống kê trong cách chọn từ, không nhìn thấy đối với người đọc và có thể kiểm tra thông qua Trình phát hiện SynthID của Google. Chỉ áp dụng cho các mô hình của Google, vì vậy kết quả SynthID âm tính không nói gì về văn bản từ các hệ thống AI khác.
Claude có watermark văn bản không?
Có. Mọi mô hình Claude được triển khai vào hoặc sau ngày 2 tháng 8 năm 2026 nhúng một watermark thống kê trong đầu ra văn bản của nó, trên mọi nền tảng và gói, không có tùy chọn từ chối, và các tệp do Claude tạo thêm còn mang metadata C2PA. Các mô hình được triển khai trước thời điểm đó thì chưa đánh dấu đầu ra; Anthropic cho biết họ đang bổ sung hỗ trợ đánh dấu cho các mô hình này trong giai đoạn chuyển tiếp. Các chi tiết đầy đủ nằm trong phần giải thích về watermark của Claude.
Các trường đại học có thể phát hiện watermark AI không?
Chỉ khi có sự hợp tác của nhà cung cấp, vì việc phát hiện cần khóa của nhà cung cấp. Google cung cấp một cổng trình phát hiện công khai cho nội dung SynthID. Anthropic cho biết họ dự kiến cung cấp hỗ trợ phát hiện cho người dùng và bên thứ ba nhưng vẫn chưa phát hành một trình phát hiện công khai. Hiện chưa có bộ công cụ so sánh đạo văn phổ biến nào có thể xác minh các watermark thống kê từ bất kỳ phòng thí nghiệm nào, vì vậy “phát hiện AI” ở cấp tổ chức ngày nay vẫn chủ yếu là đoán dựa trên phong cách, chứ không phải xác minh watermark.
Việc watermark AI có được luật pháp yêu cầu không?
Tại EU, có hiệu lực trên thực tế. Điều 50(2) của Đạo luật AI của EU yêu cầu các nhà cung cấp AI tạo sinh đảm bảo đầu ra được gắn dấu theo định dạng có thể đọc bằng máy và có thể nhận diện là được tạo một cách nhân tạo, đồng thời có các nghĩa vụ minh bạch áp dụng từ ngày 2 tháng 8 năm 2026. Anthropic đã ký thỏa thuận Mã Quy tắc Thực hành liên quan và chọn tuân thủ trên phạm vi toàn cầu. Cách các cơ quan quản lý xử lý watermark văn bản do OpenAI chưa phát hành là điều cần theo dõi vào năm 2027.
Liệu watermark AI có tồn tại sau khi dịch không?
Không. Watermark thống kê nằm trong chính trình tự các từ mà mô hình đã chọn, và việc dịch thay thế từng từ. Điều này cũng đúng với việc diễn giải sâu và chỉnh sửa thủ công nhiều. Giới hạn này được ghi nhận trong các tài liệu được phản biện khoa học và được mọi nhà cung cấp triển khai watermark thừa nhận.
Có công cụ kiểm tra watermark OpenAI công khai cho văn bản không?
Không. Công cụ xác minh công khai của OpenAI chỉ kiểm tra các tệp hình ảnh và âm thanh, để lấy siêu dữ liệu C2PA và các watermark SynthID. OpenAI nói rằng hãng không hỗ trợ văn bản. Bộ dò watermark văn bản của OpenAI chỉ mở cho các nhà nghiên cứu được phê duyệt và các tổ chức chuyên môn, theo từng trường hợp.
textGrain là gì?
textGrain là watermark văn bản của OpenAI, được công bố vào ngày 5 tháng 10 năm 2026. Nó bổ sung một tín hiệu thống kê vô hình vào lựa chọn từ của mô hình, vì vậy dấu nằm trong các từ, không có ký tự ẩn hoặc siêu dữ liệu tệp. OpenAI nói rằng phương pháp này khớp hoặc vượt các phương pháp khác mà họ đã thử nghiệm, bao gồm SynthID cho văn bản, và việc chỉnh sửa sẽ làm suy yếu nó.
Các nhà nghiên cứu có thể xin quyền truy cập bộ dò watermark văn bản của OpenAI không?
Có. Các nhà nghiên cứu được phê duyệt và các tổ chức chuyên môn có thể nộp đơn thông qua biểu mẫu Content Provenance API của OpenAI. OpenAI cấp quyền truy cập theo từng trường hợp dưới khuôn khổ Mã Quy tắc Thực hành của EU. Hãng cho biết sẽ xem xét việc mở rộng quyền truy cập khi công nghệ và bằng chứng phát triển.
Nguồn tham khảo
- Anthropic, Cách watermark văn bản của Claude hoạt động, Tháng 8 năm 2026
- Trung tâm Hỗ trợ Anthropic, Claude gắn dấu nội dung do AI tạo như thế nào, 2026
- OpenAI, Hiểu nguồn gốc của những gì ta thấy và nghe trên mạng, Tháng 5 năm 2024
- Google DeepMind, SynthID
- Dathathri và cộng sự, Thủy ấn có khả năng mở rộng để xác định đầu ra của các mô hình ngôn ngữ lớn, Nature, Tháng 10 năm 2024
- Google, Thông báo về bộ dò SynthID, Tháng 5 năm 2025
- Hugging Face, Giới thiệu SynthID Text, Tháng 10 năm 2024
- Kirchenbauer và cộng sự, Bộ thủy ấn cho các mô hình ngôn ngữ cỡ lớn, ICML 2023
- Krishna và cộng sự, Việc diễn đạt lại né được các bộ dò văn bản do AI tạo ra, NeurIPS 2023
- Scott Aaronson, Buổi giảng về An toàn AI của tôi cho UT Effective Altruism, Tháng 11 năm 2022
- Liên minh châu Âu, AI Act, Điều 50
- C2PA, Liên minh vì nguồn gốc và tính xác thực của nội dung
Dana là người sáng tạo nội dung tại ProofreaderPro, nơi cô điều hành hoạt động viết blog và viết blog hàng ngày. Cô ấy viết các bài báo về cách hoạt động của nền tảng chỉnh sửa trực tuyến và cô ấy xử lý tin nhắn của khách hàng hàng ngày với điểm hài lòng là 5 sao để thể hiện điều đó.