العلامة المائية من OpenAI و SynthID و Claude: مقارنة علامات النص المائي
هل تُلصق OpenAI علامة مائية على النص، وهل يوجد مُتحقق عام من علامة OpenAI المائية، وكيف تختلف SynthID وعلامة Claude، مقارنةً بالكتّاب الأكاديميين.
متى طُوّرت تقنية واحدة متماثلة لدى OpenAI وGoogle وAnthropic: علامة مائية إحصائية للنص المُولّد بالذكاء الاصطناعي. لقد أرجأت OpenAI إصدار نسختها لسنوات وبدأت نشرها، باسم textGrain، في أكتوبر 2026. قامت Google بتضمين SynthID داخل Gemini ونشرت الطريقة. جعلت Anthropic علامة Claude المائية إلزامية لكل مستخدم في أغسطس 2026. إذا كنت تكتب بمساعدة من الذكاء الاصطناعي بأي شكل، فإن قرارات كل هذه الأطراف تحدد الآن كيفية تقييم مستنداتك.
انتقلت عملية الترميز المائي من موضوع بحثي إلى أخبار سائدة في 11 أغسطس 2026، عندما أعلنت Anthropic أن كل نموذج جديد من Claude يضع علامة على مخرجات نصه. تناولنا هذا الإعلان بالتفصيل في دليلنا شرح علامة Claude المائية. يغطي هذا الدليل الصورة الكاملة: ما هي العلامة المائية للنص، وكيف طبّقت كل واحدة من المختبرات الثلاثة الكبرى أو امتنعت عن تطبيقها، وماذا يثبت كل نظام عن جزء من الكتابة.
ما هي العلامة المائية النصية للذكاء الاصطناعي؟
العلامة المائية النصية للذكاء الاصطناعي هي نمط إحصائي مخفي في اختيارات الكلمات للنص المُولّد، يتم زرعه أثناء لحظة التوليد بحيث يستطيع مُكتشف يحمل المفتاح المناسب لاحقًا التحقق من أن النص جاء من نظام ذكاء اصطناعي محدد. ليست علامة ظاهرة، وليست حرفًا مخفيًا، وليست بيانات وصفية مرفقة بملف. العلامة موجودة داخل الكلمات نفسها.
هذه التفرقة مهمة، لأن مصطلح "watermark" يُستخدم بشكل فضفاض لثلاثة أشياء مختلفة:
| ما هو | أين يوجد | هل يبقى بعد النسخ واللصق؟ | |
|---|---|---|---|
| العلامة المائية الإحصائية | تحيز يتمثل في الكلمات التي يختارها النموذج | النص نفسه | نعم |
| بيانات وصف الملف (C2PA) | وسم منشأ موقّع | حاوية الملف | لا، النسخ كنص عادي يزيله |
| أحرف بعرض صفري | تم إدراج يونيكود غير مرئي داخل النص | بين الأحرف الظاهرة | لا، يُزال بسهولة |
التضمين بالمَعلمات الإحصائية هو الوحيد من بين الثلاثة الذي يبقى بعد النسخ واللصق وإعادة الكتابة يدويًا داخل مستند جديد، وبعد تحويل التنسيق. لهذا اجتمعت المختبرات الثلاثة الكبرى عليه للكتابة النصية، ولهذا فإن «مُزيلات المعلمات» التي تزيل الأحرف غير المرئية لا تفعل شيئًا ضده. تُوثق صفحة مُزيل معلمة Claude المجاني هذا الفشل بالمصادر.
كيف يعمل التضمين بالمَعلمات الإحصائية فعليًا؟
في كل خطوة أثناء كتابة جملة، يختار نموذج لغوي بين عدة كلمات متقاربة في المعنى، وتُحمّل علامة مائية بهدوء تلك النرد. نُشرت الوصفة الأساسية بواسطة Kirchenbauer وزملائه في جامعة Maryland في يناير 2023 في A Watermark for Large Language Models (ICML 2023). يعمل الأمر هكذا:
- قبل اختيار كل كلمة، يقوم مفتاح سري مشتق من الكلمات السابقة بتقسيم المفردات إلى مجموعة مفضلة ومجموعة محايدة.
- يدفع النموذج اختياره نحو المجموعة المفضلة. «Suggest» بدلًا من «indicate». «Across» بدلًا من «among». تبدو كل عملية اختيار فردية طبيعية تمامًا.
- يعدّ كاشف يحمل المفتاح عدد مرات وقوع النص داخل المجموعات المفضلة. الكتابة البشرية تصيب المعدل المتوقع بالصدفة. النص المُضمَّن يصيبه كثيرًا جدًا، وباختبار إحصائي يتم وسم هذا الاختلاف.
لا توجد كلمة واحدة تكون دليلًا على أي شيء. تظهر الإشارة فقط عبر عشرات أو مئات الاختيارات، لذلك تكون المقاطع الأطول أسهل للفحص من المقاطع القصيرة، ولذلك يكون الكشف دائمًا احتماليًا وليس «وسمًا» نعم أو لا.
يعتمد نظام الإنتاج لدى Google DeepMind، الذي نُشر في Nature في أكتوبر 2024 بعنوان scalable watermarking لتحديد مخرجات نماذج اللغات الكبيرة، على تحسينه بتقنية اسمها أخذ العينات على شكل بطولة، تحافظ على جودة النص بدرجة كافية ليعمل صامتًا داخل منتج استهلاكي على نطاق واسع. وهذه الورقة مهمة يتجاوز تأثيرها Google: فهي الأساس المنشور الذي تشير إليه Anthropic لتطبيق Claude.
كانت نقطة الضعف الأساسية قد نُشرت قبل معظم عمليات النشر. في مارس 2023، أظهر Krishna وزملاؤه في إعادة الصياغة تتجاوز كواشف النص المُولّد بالذكاء الاصطناعي (NeurIPS 2023) أن إعادة توليد صياغة المقطع تُسقط الكشف عبر الطرق، بما في ذلك التضمين بالمَعلمات. تعيش الإشارة في تسلسل الرموز (tokens) الدقيق ولا مكان آخر، لذلك أي شيء يعيد كتابة التسلسل، بما في ذلك محرر بشري، يعيد تدوير الدليل بعيدًا. كل مزود يطرح تضمينًا بمعلمة اليوم يذكر هذا القيد في توثيقه الخاص.
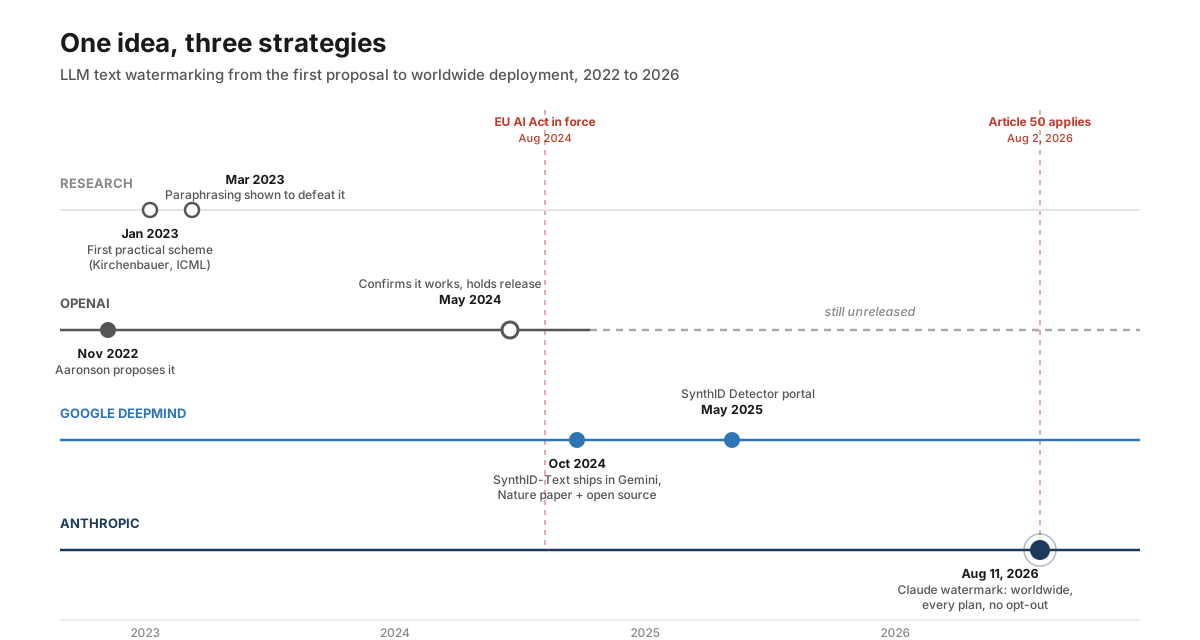
OpenAI: الشركة التي اخترعته وشحنته أخيرًا
لدى OpenAI معلمة نصية تعمل لسنوات واختارت عدم إصدارها حتى أكتوبر 2026. وصف Scott Aaronson، وكان يعمل آنذاك على السلامة في OpenAI، الفكرة لأول مرة علنًا في محاضرة نوفمبر 2022. تتحيز الطريقة اختيارات النموذج بين كلمات متكافئة تقريبًا باستخدام دالة تشفيرية سرية، لذلك يُظهر النص نفسه مصدره. وتلك المحاضرة أقدم من أي نظام تم نشره حتى اليوم.
في مايو 2024، وصف OpenAI حالة المشروع في تحديثه الخاص بإثبات المصدر، فهم مصدر ما نراه ونسمعه عبر الإنترنت. وقالت الشركة إن طريقة الترميز المائي للنص كانت دقيقة وفعالة على التعديلات الصغيرة، لكنها كانت تؤجل الإطلاق بينما كانت تقيّم المفاضلات. وتؤثر اثنتان من المخاطر التي ذكرتها OpenAI تأثيرا مباشرا على كتّاب أكاديميين:
- سهولة التحايل. إن إعادة صياغة النص أو ترجمته تزيل العلامة، تماما كما توقعت أبحاث 2023. إن الترميز المائي الذي يلتقط غالبا الأشخاص الذين لا يعلمون بوجوده هو أداة إنفاذ ضعيفة.
- أثر غير متناسب على متحدثي الإنجليزية كلغة غير أم. ذكرت OpenAI أن الترميز المائي قد يوصم الاستخدام المشروع للذكاء الاصطناعي كوسيلة مساعدة في الكتابة لدى من يكتبون بلغة ثانية. يناقش مقالنا حول لماذا وُسِمَت كتابات متحدثي الإنجليزية غير الأصليين بواسطة كاشفات الذكاء الاصطناعي المشكلة نفسها من جهة الكاشف.
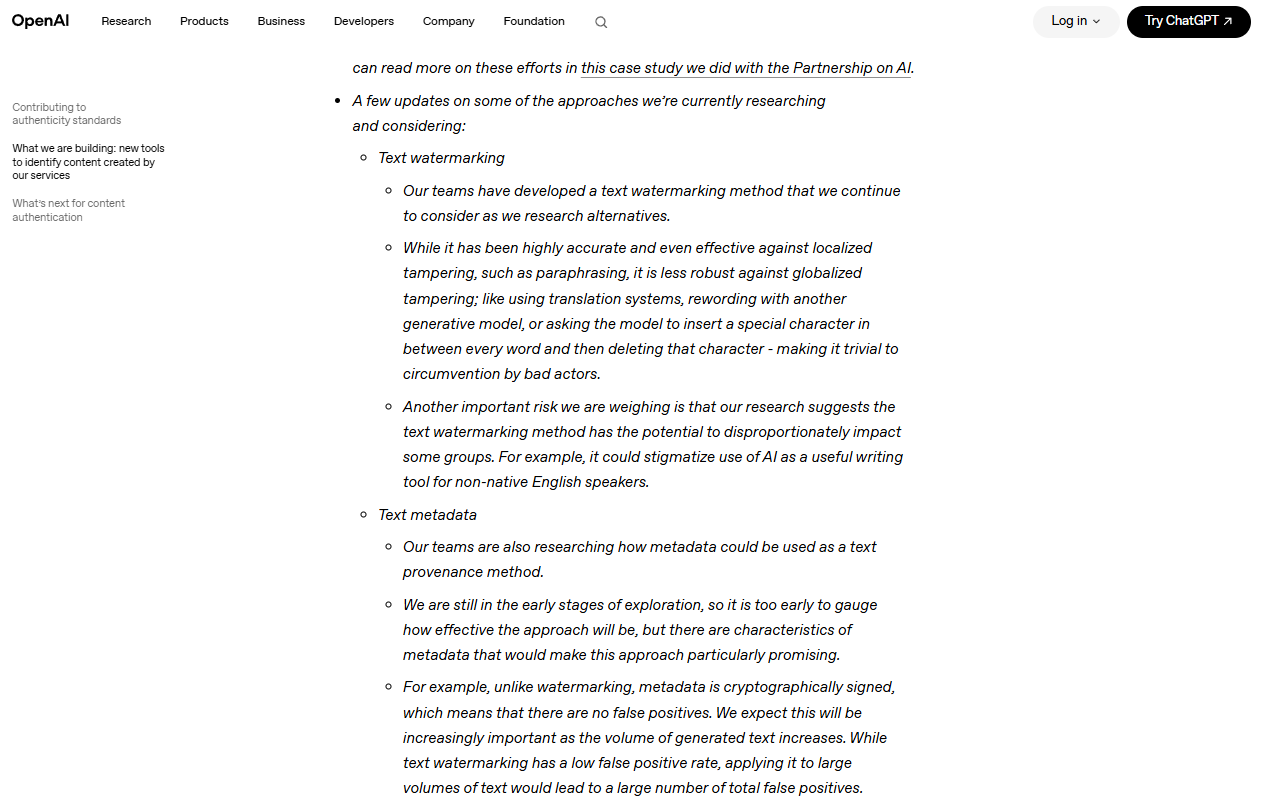
تحديث إثبات المصدر لعام 2024 من OpenAI: تعمل الطريقة، وتذكر الشركة أسباب تأجيلها لها في ذلك الوقت.
بالنسبة للصور والصوت، اتخذت OpenAI مسارا مختلفا: بيانات إثبات المصدر C2PA في مخرجات DALL-E وSora، وهي تسمية على مستوى الملف وليست علامة داخل المحتوى. أما النص، فلم يكن مخرجات ChatGPT عليها ترميز مائي حتى أكتوبر 2026. وكانت الشركة التي اقترحت التقنية هي الأخيرة بين الثلاثة لتطبيقها.
هل يقوم OpenAI بترميز النص بالماء الآن؟
نعم، بدأ OpenAI بترميز بعض النصوص بالماء في 5 أكتوبر 2026، استجابة لقانون الاتحاد الأوروبي للذكاء الاصطناعي EU AI Act. ويقدّم إعلانه ترميزا مائيا للنص يسمى textGrain، يضيف إشارات إحصائية غير مرئية إلى خيارات الكلمات التي ينتجها النموذج. ويأتي الطرح على ثلاثة أجزاء، ولا يعد الترميز المائي خيارا افتراضيا عاما:
- يمكن لعملاء API في أي مكان تفعيل الإخراج المرمز بالماء لطرازات محددة. ويبقى غير مفعّل افتراضيا.
- خلال الأسابيع التالية، ستحصل مخرجات نص ChatGPT وCodex المؤهلة داخل الاتحاد الأوروبي على الترميز المائي، في جميع الخطط.
- يمكن للباحثين المعتمدين والمنظمات الخبيرة التقديم للحصول على إمكانية الوصول إلى كاشف الترميز المائي للنص.
يقول OpenAI إن textGrain تطابق أو تفوق على الطرق الأخرى التي اختبرها، بما في ذلك SynthID من Google للنسخ النصي. كما نشر أيضا أين تصبح عملية الكشف أضعف. عند معدل إيجابيات خاطئة قدره 1%، حدد الكاشف الترميز المائي في حوالي 80% من المقاطع التي تحتوي على 200 كلمة تقريبا، وفي حوالي 95% من المقاطع التي تحتوي على 400 كلمة تقريبا لمحتوى علم النفس. كانت نسبة الكشف أقل بكثير في الرياضيات، حيث تكون مساحة حرية اختيار الكلمات أقل.
يضعف التحرير الإشارة بسرعة. ففي المقاطع التي تحتوي على 400 كلمة، أدى استبدال 10% من الكلمات بمرادفات إلى خفض الكشف من حوالي 92% إلى 66%، وخفض استبدال 25% إلى 17%.
تحقق OpenAI أيضا مما إذا كان الترميز المائي يغيّر جودة الإجابات على Astra، أحدث نموذج لديه، ويقول إنه لم ير أي اختلاف ذي معنى. وهذه أربعة من معايير الأداء التي نشرها:
| المعيار | بدون ترميز مائي (Astra) | مع ترميز مائي (Astra) |
|---|---|---|
| Artificial Analysis Intelligence Index | 49.57 نقطة | 49.76 نقطة |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
بالنسبة للطلاب، التاريخ مهم. فالنص الذي كتبته ChatGPT قبل بدء الطرح، أو خارج الاتحاد الأوروبي دون تفعيل إعداد API، لا يحتوي على ترميز مائي من OpenAI. يغطي دليلنا إلى شرح Turnitin Clarity كيفية وضع المدارس سياسات خاصة بها لاستخدام الذكاء الاصطناعي في هذه الأثناء.
هل توجد أداة فحص عامة للترميز المائي من OpenAI؟
لا يوجد حتى الآن فاحص عام من OpenAI لمعاينة النص. تتحقق أداة أداة التحقق المجانية من OpenAI من ملفات الصور والصوت بحثا عن بيانات اعتماد C2PA Content Credentials وبحثا عن علامة SynthID، والتي تدمجها OpenAI في الصور والصوت المدعومة. وتقول OpenAI إن الأداة لا تدعم النص.
بالنسبة إلى النص، تتيح OpenAI الوصول إلى أدوات الكشف على أساس كل حالة على حدة للباحثين المعتمدين والمنظمات الخبيرة، عبر نموذج Content Provenance API. وتقول إنها لا تنشر كاشف النص للجمهور عند الإطلاق بسبب خطر عدم اكتشاف بعض العلامات والإنذارات الإيجابية الكاذبة. يعرض الكاشف ما إذا كان يعثر على علامة OpenAI، ولا يحدد هوية المستخدم ولا يعرض طلباته.
| ما الذي تريد فحصه | الأداة | من يمكنه استخدامها |
|---|---|---|
| ملف صورة أو صوت من OpenAI | أداة التحقق من OpenAI | أي شخص، مجانا |
| مخرجات نص OpenAI (textGrain) | كاشف علامة نص OpenAI | باحثون معتمدون ومنظمات خبيرة، عبر التقديم |
| مخرجات نص Claude | كاشف علامة Claude | منظمات مؤهلة، عبر التقديم (انظر دليل علامة Claude) |
توضح OpenAI أيضا ما لا يمكن للنتيجة أن تخبرك به. فالعلامة المكتشفة لا تقيس مقدار إسهام شخص ما، ولا تحدد من كتب النص أو استخدمه. كما أن عدم وجود علامة لا يثبت أيضا التأليف البشري، لأن النص قد يكون قصيرا جدا، أو تمت عليه تعديلات، أو تمت ترجمته، أو يكون مصدره من نموذج غير مدعوم.
Google: الأول من حيث الإطلاق ثم كشف الوصفة
أطلقت Google DeepMind أولا ونشرت التفاصيل بالكامل ثم فتحت الطريقة للجميع. بدأ نظامها، SynthID، كعلامة مائية للصور في 2023 وتوسع ليشمل النص في 2024. وحتى وقت ظهور ورقة Nature في أكتوبر 2024، كان SynthID-Text يعمل بالفعل داخل Gemini في الإنتاج، ما جعله أول علامة مائية إحصائية للنص يتم نشرها على نطاق المستهلك.
يغطي SynthID النص والصور والصوت والفيديو، وكان يعمل في مخرجات Gemini النصية منذ أكتوبر 2024.
ثم نشرت Google التنفيذ كـ مفتوح المصدر على Hugging Face، ما يتيح لأي مطور تطبيق مخطط العلامة المائية نفسه على نماذجه الخاصة. وفي مايو 2025 أعلنت عن كاشف SynthID، وهو بوابة تحقق يمكن فحص المحتوى فيها بحثا عن علامات SynthID عبر النص والصور والصوت والفيديو.
توجد مسألة واحدة مهمة تتعلق بنطاق الاستخدام: تضع SynthID العلامات فقط وتكتشف فقط المحتوى القادم من نماذج Google نفسها. ولا تقول شيئا عن مخرجات ChatGPT أو Claude، وظهور فحص SynthID بنظافة لا يعني أن النص كتبته يد بشرية. بل يعني أن نماذج Google لم تكتبه، وهي ادعاء أضيق بكثير.
Anthropic: آخر من تحرك، وسياسة أشد صرامة
أطلقت Anthropic أحدث الحلول، وبأوسع نطاق تغطية إجباري. كل نموذج Claude يتم إطلاقه في أو بعد 2 أغسطس 2026 يضم علامة مائية إحصائية في مخرجات نصه، على مستوى العالم، في كل خطة، دون خيار إلغاء. وتشرح الشركة الآلية في شرحتها، كيف تعمل علامة نص Claude، وتحدد نطاق السياسة في مقال مركز المساعدة، كيف تعلّم Claude المحتوى الناتج عن الذكاء الاصطناعي: فواجهة Claude API وclaude.ai وClaude Code وClaude Cowork وClaude Tag كلها مشمولة. وتكون النماذج التي تم إطلاقها قبل هذا الموعد في فترة انتقالية، وتقول Anthropic إنها تضيف أيضا دعم الوسم لتلك النماذج. وبالإضافة إلى العلامة الإحصائية، تحمل الملفات التي ينتجها Claude أيضا بيانات وصف C2PA، وهي نظام ثان منفصل يحذف النسخ النصي العادي أجزاء منه.
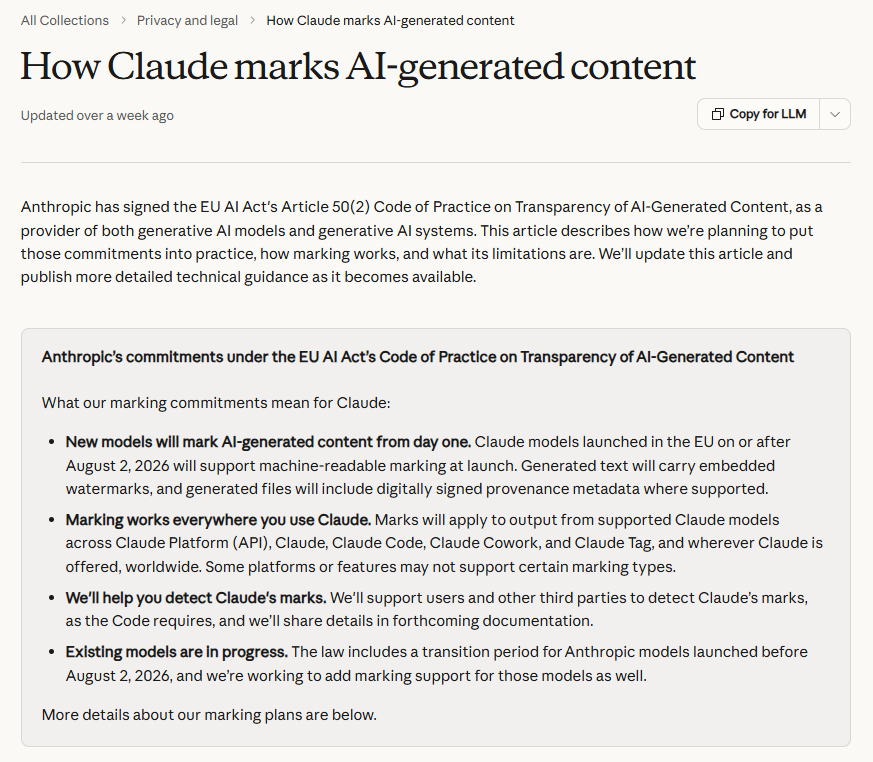
سياسة Anthropic بصياغتها الخاصة: كل نموذج جديد، كل منصة، على مستوى العالم، مع إضافة النماذج الأقدم تدريجيًا.
تذكر وثائق Anthropic القيود بشكل مباشر. الكشف احتمالي. لا يستطيع الترميز التمييز بين مستند كتبه Claude ومستند كتبه إنسان ثم قام Claude بتحريره بشكل خفيف. إعادة الكتابة بالكامل تزيله. لقد استعرضنا كل ذلك، بما في ذلك ما الذي يثبته الكشف الإيجابي فعليًا، وما الذي ينبغي فعله إذا وُسمت كتاباتك أنت في دليل مخصص لعلامات Claude المائية.
يستند التوقيت إلى التنظيم. وقّعت Anthropic على مدونة الممارسة بشأن شفافية المحتوى المُولّد بالذكاء الاصطناعيArticle 50(2) تحت قانون الاتحاد الأوروبي للذكاء الاصطناعي، والذي يطلب من مقدمي أنظمة الذكاء الاصطناعي التوليدي ضمان أن تكون المخرجات "موسومة بتنسيق قابل للقراءة آليًا وقابلة للكشف عن كونها مُولدة بشكل اصطناعي". أصبحت التزامات الشفافية هذه سارية في 2 أغسطس 2026: وهو تاريخ القطع الدقيق في سياسة نماذج Anthropic، قبل الإعلان العام بتسعة أيام. اختارت Anthropic الالتزام عالميًا بدلًا من الحفاظ على سلوك منفصل لحركة مرور الاتحاد الأوروبي. كانت Google ملتزمة بالفعل بحكم التصميم. يُعد مخرجات OpenAI غير المُوسومة سؤال الالتزام المفتوح لعام 2027.
الثلاثة أساليب جنبًا إلى جنب
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| هل تم نشر علامة النص؟ | نعم (textGrain، طرح الاتحاد الأوروبي ابتداء من 5 أكتوبر 2026) | نعم (Gemini، منذ أكتوبر 2024) | نعم (نماذج Claude ابتداء من 2 أغسطس 2026) |
| التقنية | textGrain، إشارة إحصائية في اختيارات الكلمات | عينات بنهج بطولة SynthID | علامة عبر أخذ عينات إحصائية بنمط SynthID |
| نطاق التغطية | نص Eligible لدى ChatGPT وCodex في الاتحاد الأوروبي؛ وخيار الاشتراك عبر API عالميًا | نماذج Google فقط | جميع نماذج Claude الجديدة؛ والنماذج الأقدم في فترة انتقال |
| الاستثناء (Opt-out) | مغلق افتراضيًا في واجهة API | لا | لا |
| كاشف عام | لا | بوابة SynthID Detector (2025) | مخطط، وليس مُتاحًا بعد |
| هل نُشر المخطط (Scheme)؟ | محاضرات مفاهيمية فقط | بحث Nature + مصدر مفتوح | شرح قائم على عمل منشور |
| بيانات وصف الملف (C2PA) | نعم، الصور والصوت | نعم، عبر وسائط متعددة | نعم، على الملفات المُولدة |
| القيود المعلنة | التحايل، وصمة ESL | النطاق محدود على نماذجها الخاصة | احتمالي، والتعديلات تُشوش نسبة التأليف |
النمط عبر الأعمدة: تعتبر OpenAI حبرَ النص غير المُحل كمسألة سياسات غير محسومة، وتعتبر Google أنه بنية تحتية لِتوحيده، بينما ترى Anthropic أنه التزام امتثال يجب تنفيذه بالكامل.
ماذا يعني ذلك للباحثين والكتّاب الأكاديميين
النتائج العملية تعتمد على الأدوات التي تلامس نصك. إذا صاغت نصك باستخدام ChatGPT، فلن يحمل النص حبرًا اليوم. إذا صاغت نصك باستخدام Gemini، فسيحمل علامة SynthID يمكن ل كاشف Google وحده قراءتها. وإذا صاغت أو عدلت باستخدام نموذج Claude الحالي، فسيحمل علامة Anthropic، ولا توجد إعدادات تُعطّل ذلك.
ثلاثة أمور يجب أن يعرفها الكتّاب الأكاديميون:
الحبر يعرّف الأداة لا المؤلف. يذكر كل مورد ذلك في وثائقِه، وتجدر إعادة التأكيد عليه لأن السياسات المؤسسية لا تجعل دائمًا هذا التفريق. يمكن وسم النص لأن الذكاء الاصطناعي هو الذي صاغه، أو لأن ذكاء اصطناعي قام بتحرير نسخة لغوية للجملتين أو أكثر، أو لأن فقرة مُعلّمة تم اقتباسها. إذا كانت مؤسستك تجري فحوص الحبر، فإن ما يثبتُه الفحص هو أن نموذجًا بعينه لمس النص في مرحلة ما، ولا شيء أكثر. دليلنا حول الاستئناف ضد إشارة كشف خاطئة للذكاء الاصطناعي يشرح كيفية تقديم هذا الحُجّة عندما يهم الأمر.
الحبر وكواشف AI تقنيات مختلفة بطرق فشل مختلفة. كواشف مثل Turnitin أو GPTZero تستنتج من الأسلوب الإحصائي، مع مشكالت دقة وثقناها. كشف الحبر اختبار قائم على المفتاح مع معدل منخفض جدًا للإيجابيات الكاذبة في النص البشري غير المُعلّم. ويقلب عدم التماثل اتجاهه مع السلبيات الكاذبة: تفشل فحوص الحبر في التقاط أي نص AI من نموذج لا يضع حبرًا، وهو ما يشمل نماذج ChatGPT كلها اليوم.
الإفصاح يبقى أقوى موقف لك. يجعل وسم الحبر استخدام AI الصامت أكثر خطورة، بينما يجعل الإفصاح عن استخدام AI استخدامًا مُعلنًا أكثر أمانًا، لأن سير العمل المُفصح عنه لا يواجه أي خوف من علامة إيجابية. لدى معظم المجلات والجامعات الآن سياسات صريحة لاستخدام AI. يشرح سياسة استخدام AI لدينا كيف نرسم تلك الحدود عبر أدواتنا الخاصة، وهي قالب معقول لما يبدو عليه الاستخدام الشفاف.
ما الذي يزيل حبر نص، وما الذي لا يزيله
إعادة الكتابة تُزيله، بينما إعادة التنسيق لا تفعل ذلك. النسخ واللصق وتغيير الخط وتحويل صيغ الملفات وإزالة الأحرف غير المرئية كلها تترك علامة إحصائية سليمة بالكامل، لأن العلامة موجودة في اختيارات الكلمات. ما يزيلها هو أي شيء يُعيد توليد الصياغة: تحرير بشري عميق أو ترجمة أو إعادة صياغة حقيقية، كما أثبتت أعمال المتانة الخاصة بـ أعمال المتانة في NeurIPS 2023 قبل شحن أي من هذه الأنظمة.
الاتجاهان مهمان هنا. اختفاء العلامة لا يجعل النص لك، وبقاء العلامة لا يعني أن النص ليس لك. إن إعادة صياغة مسودة باستخدام الذكاء الاصطناعي تظل وثيقة مدعومة بالذكاء الاصطناعي وتخضع لقواعد الإفصاح في مؤسستك. يقوم humanizer للذكاء الاصطناعي بإعادة صياغة المسودات المدعومة بالذكاء الاصطناعي إلى أسلوب أكاديمي طبيعي، ونتيجة لأن هذه العملية تعيد توليد تسلسل الرموز، فلا تستمر العلامات الإحصائية خلالها. وبالنسبة إلى نص Claude تحديدًا، فإن إزالة علامة Claude المائية مجانًا يعيد التعبير عن كل جملة بصياغة جديدة مع الحفاظ على الحقائق والأرقام والاستشهادات كما هي. لا تستطيع أي أداة تغيير ما عليك فعله تجاه قارئك: الشفافية بشأن كيفية إعداد المستند.
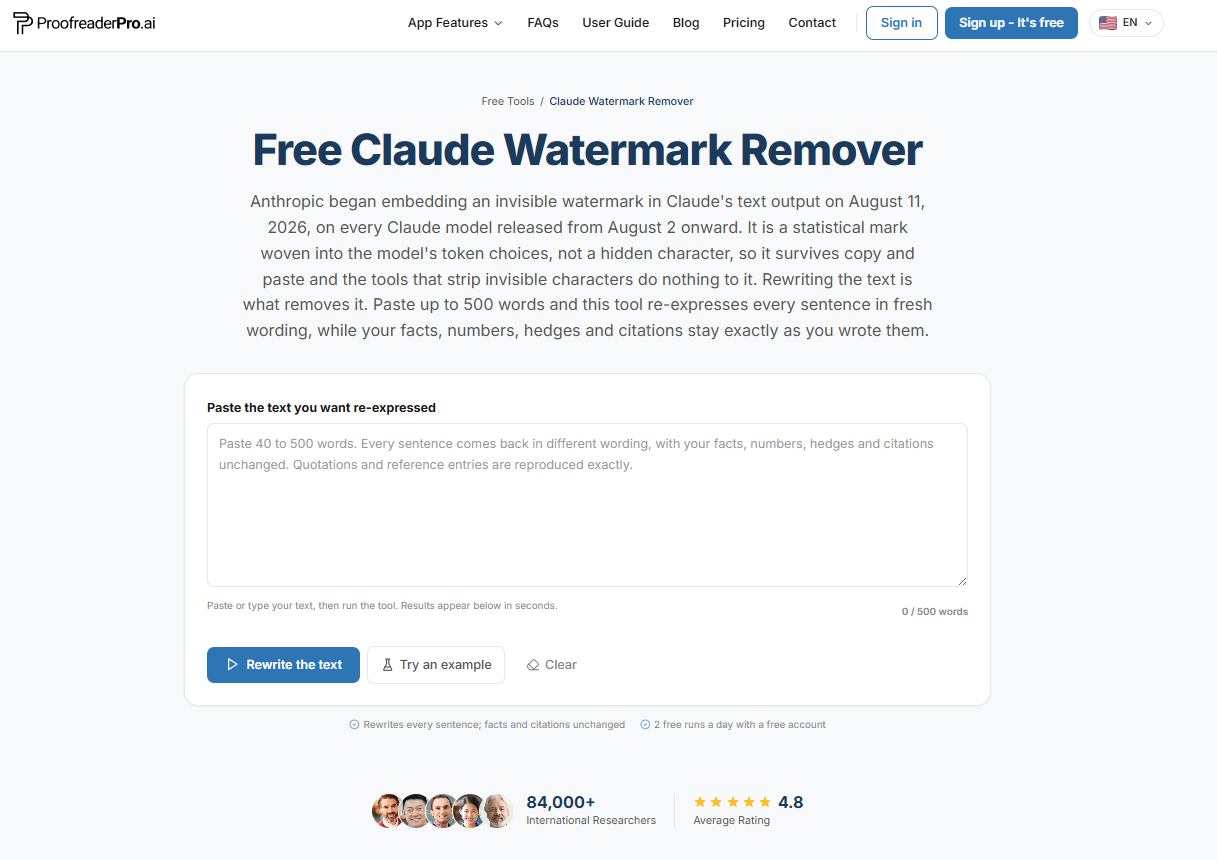
إعادة الكتابة هي العملية الوحيدة التي تزيل العلامة الإحصائية، وهي ما تفعله هذه الأداة، جملة جملة.
إلى أين ستتجه الأمور بعد ذلك
تابع ثلاثة أشياء حتى عام 2027. أولًا، هل تتجاوز OpenAI textGrain إلى ما هو خارج الاتحاد الأوروبي: بدأت هناك لأن تطبيق الاتحاد الأوروبي للمادة 50 يتطلب علامات قابلة للقراءة آليًا على نصوص الذكاء الاصطناعي. ثانيًا، هل تتلاقى الكاشفات. إذا كانت كل المختبرات الرئيسية تضع علامات مائية بخطة منشورة، تستطيع الجامعات التحقق من المفاتيح بدل التخمين من نمط الكتابة، ما سيحسن على الكشف المعرّض لنتائج إيجابية كاذبة. ثالثًا، هل تصبح العلامات متوافقة. اليوم، تستخدم ثلاثة مختبرات ثلاث علامات مختلفة، ولا يوجد فحص واحد يغطيها جميعًا. يملأ C2PA هذه الفجوة للملفات، ولا يوجد شيء بعد يملأها للنص الخام.
هل يضع ChatGPT علامة مائية على نصه؟
نعم، جزئيًا، بدءًا من 5 أكتوبر 2026. بدأت OpenAI بإضافة علامة textGrain المائية إلى نصوص ChatGPT وCodex المؤهلة داخل الاتحاد الأوروبي، ويمكن لعملاء API في أي مكان تفعيلها. العلامة المائية إشارة إحصائية في اختيارات الكلمات، دون أحرف مخفية. تطبق OpenAI أيضًا بيانات ميتاداتا منشأ C2PA على ملفات وسائط DALL-E وSora، وهذه منظومة منفصلة على مستوى الملفات.
هل يضع Google Gemini علامة مائية على نصه؟
نعم. تحمل مخرجات Gemini علامة SynthID-Text الخاصة بـ Google DeepMind منذ أكتوبر 2024. إنها علامة إحصائية ضمن اختيارات الكلمات، غير مرئية للقراء، ويمكن التحقق منها عبر كاشف SynthID من Google. ولا تنطبق إلا على نماذج Google نفسها، لذا فإن ظهور نتيجة سلبية لـ SynthID لا يعني شيئًا بخصوص النصوص الصادرة من أنظمة ذكاء اصطناعي أخرى.
هل يضع Claude علامة مائية على نصه؟
نعم. كل نموذج من نماذج Claude الذي يتم إطلاقه في أو بعد 2 أغسطس 2026 يضم علامة مائية إحصائية في مخرجات نصه، على كل منصة وكل خطة، بدون خيار إيقاف، كما تحمل الملفات الناتجة عن Claude أيضًا بيانات ميتاداتا C2PA. النماذج التي تم إطلاقها قبل ذلك التاريخ لا تميز مخرجاتها بعد، وتقول Anthropic إنها تضيف دعم التمييز لهذه النماذج خلال فترة انتقالية. التفاصيل الكاملة في شرحنا لعلامة Claude المائية.
هل يمكن للجامعات اكتشاف العلامات المائية للذكاء الاصطناعي؟
فقط بمشاركة البائع، لأن الكشف يتطلب مفتاح البائع. تقدم Google بوابة كاشف عامة لمحتوى SynthID. وتقول Anthropic إن دعم الكشف للمستخدمين وللطرف الثالث مخطط له، لكنه لم يُصدر بعد بوابة كاشف عامة. لا يمكن حاليًا لأي باقة رائدة للكشف عن الانتحال أن تتحقق من العلامات المائية الإحصائية من أي مختبر، لذلك يعني مصطلح "الكشف عن الذكاء الاصطناعي" في المؤسسات اليوم ما يزال تخمينًا قائمًا على الأسلوب، وليس التحقق من العلامة المائية.
هل يلزم وضع العلامات المائية للذكاء الاصطناعي بموجب القانون؟
في الاتحاد الأوروبي، نعم فعليا. ينص البند 50(2) من قانون الاتحاد الأوروبي للذكاء الاصطناعي (EU AI Act) على أن مزودي الذكاء الاصطناعي التوليدي يجب أن يضمنوا وسم المخرجات بتنسيق قابل للقراءة من الآلة وقابل للاكتشاف على أنه مُولّد بصورة اصطناعية، مع وجود التزامات بالشفافية تسري اعتبارا من 2 أغسطس 2026. وقّعت Anthropic على مدونة الممارسات ذات الصلة واختارت الالتزام على مستوى العالم. والسؤال الذي يجب متابعته في 2027 هو كيفية تعامل الجهات التنظيمية مع وسم النص غير المُعلن من OpenAI.
هل تعيش أوسمة الذكاء الاصطناعي بعد الترجمة؟
لا. يعيش الوسم الإحصائي داخل التسلسل الدقيق للكلمات التي اختارها النموذج، والترجمة تستبدل كل كلمة. ينطبق الشيء نفسه على إعادة الصياغة العميقة والتحرير البشري المكثف. تم توثيق هذا القيد في الأدبيات المحكمة وقرّته كل شركة تزوّد بأداة وسْم عند شحنها.
هل توجد أداة تحقق عامة من وسم OpenAI للنص؟
لا. أداة التحقق العامة من OpenAI تتحقق فقط من ملفات الصور والصوت، الخاصة ببيانات C2PA الوصفية وأوسمة SynthID. تقول OpenAI إنها لا تدعم النص. كاشف وسم النص لديها متاح فقط للباحثين المعتمدين والمؤسسات الخبيرة، وبشكل فردي حسب كل حالة.
ما هو textGrain؟
textGrain هو وسم النص الخاص بـ OpenAI، المُعلن في 5 أكتوبر 2026. يضيف إشارة إحصائية غير مرئية إلى خيارات كلمات النموذج، لذلك يكون الوسم جزءا من الكلمات، دون وجود أحرف مخفية أو بيانات وصفية داخل الملف. تقول OpenAI إنه يطابق أو يتفوق على الطرق الأخرى التي اختبرتها، بما في ذلك SynthID للنص، وأن التعديل يضعفه.
هل يمكن للباحثين التقدم بطلب للحصول على وصول إلى كاشف وسم نص OpenAI؟
نعم، يمكن للباحثين المعتمدين والمؤسسات الخبيرة التقدم عبر نموذج واجهة برمجة التطبيقات الخاصة بإسناد منشأ المحتوى من OpenAI. تمنح OpenAI الوصول بشكل فردي حسب كل حالة ضمن مدونة الممارسات التابعة للاتحاد الأوروبي. وتقول إنها ستعيد النظر في إتاحة وصول أوسع مع تطور التقنية وتراكم الأدلة.
المصادر
- Anthropic, كيف يعمل وسم نص Claude, أغسطس 2026
- مركز مساعدة Anthropic, كيف يوسم Claude المحتوى المُولّد بالذكاء الاصطناعي, 2026
- OpenAI, فهم مصدر ما نراه ونسمعه عبر الإنترنت, مايو 2024
- Google DeepMind, SynthID
- Dathathri وآخرون، وسم Scalable لتحديد مخرجات نماذج اللغة الكبيرة، Nature، أكتوبر 2024
- Google, إعلان كاشف SynthID، مايو 2025
- Hugging Face, التقديم لـ SynthID Text, أكتوبر 2024
- Kirchenbauer وآخرون، وسم للمخرجات لنماذج اللغة الكبيرة، ICML 2023
- Krishna وآخرون، إعادة الصياغة تتفادى كواشف النص المُولّد بالذكاء الاصطناعي، NeurIPS 2023
- Scott Aaronson، محاضرة سلامة الذكاء الاصطناعي الخاصة بي لبرنامج UT Effective Altruism، نوفمبر 2022
- الاتحاد الأوروبي، قانون الذكاء الاصطناعي، المادة 50
- C2PA، ائتلاف التوافق مع منشأ المحتوى والأصالة
دانا هي منشئة محتوى في ProofreaderPro، حيث تدير المدونة اليومية وعمليات الكتابة. وهي تكتب المقالات حول كيفية عمل منصة التحرير عبر الإنترنت، وتتعامل مع رسائل العملاء كل يوم، مع الحصول على درجة رضا من فئة الخمس نجوم لإظهارها.