
面向瑞典研究人员的英语写作 AI 人性化工具
面向瑞典研究人员的 AI 人性化工具。降低由瑞典英语风格影响而引发的误报型 AI 检测标记,保留原意与引用,并进行诚实披露。

瑞典以英语为运转语言。卡罗林斯卡学院(Karolinska Institutet)的博士论文用英语撰写并进行答辩,隆德大学(Lund)与乌普萨拉大学(Uppsala)的论文也常在英语中起草,且该国长期位居 EF 英语能力水平指数(EF English Proficiency Index)的前列。因此,当一名瑞典博士生得知自己亲手写的某一章节被某种 AI 检测器标记时,通常会直接陷入难以置信。
这种反应是合理的。之所以存在面向瑞典研究人员的 AI 人性化工具,是因为经过细致、规范、流畅的“瑞典语式英语”(Swedish-English)恰恰是这些检测器最容易误读的文风类型。优秀英语并不能保护你。有时,问题就在这里。
机制一旦看明白就令人不适。检测器会奖励那些“出乎意料”的词汇选择,却惩罚“可预测”的用法。经过训练以清晰表达、使用常见词并保持句式干净顺畅的写作者,会产出较低困惑度(perplexity)的文本;而较低困惑度恰恰是检测器将文本判定为机器生成的依据。
Så kan svenska forskare humanisera AI-text för publicering på engelska
我们的工具帮助瑞典研究人员对自己的 AI 文稿进行“人性化”,使规范且写作良好的瑞典英语不被错误地标记为“掩蔽式生成”(maskingenererad),同时保留意义、术语与文献引注。
用更直白的话说:该工具会以你自己经过 AI 辅助的草稿为基础,调整文本的节奏与用词差异,让干净的“瑞典语式英语”不那么容易被主要检测器误读。它保留你的引文、你的技术词汇,以及你的论证结构不被改变。它不会替你写论文,也不是为了隐藏任何内容而构建。
在瑞典语书写?系统会自动识别并以母语方式进行人性化
瑞典研究人员常常会先用母语写作,再转到英语。人性化工具正是为这种流程提供支持:将瑞典语文本粘贴进去后,ProofreaderPro 会自行识别语言,再通过一个“对瑞典语言敏感”的模型处理,确保 å、ä、ö 这些字符、你的术语以及你的引用都准确地保持在原位。要实现对 AI 文本的人性化,你可以从自己的瑞典语草稿出发,它会像处理英文草稿一样迅速改写;同一套“检测,人性化”覆盖超过 60 种语言,并且会以各自的语言声音来完成处理。
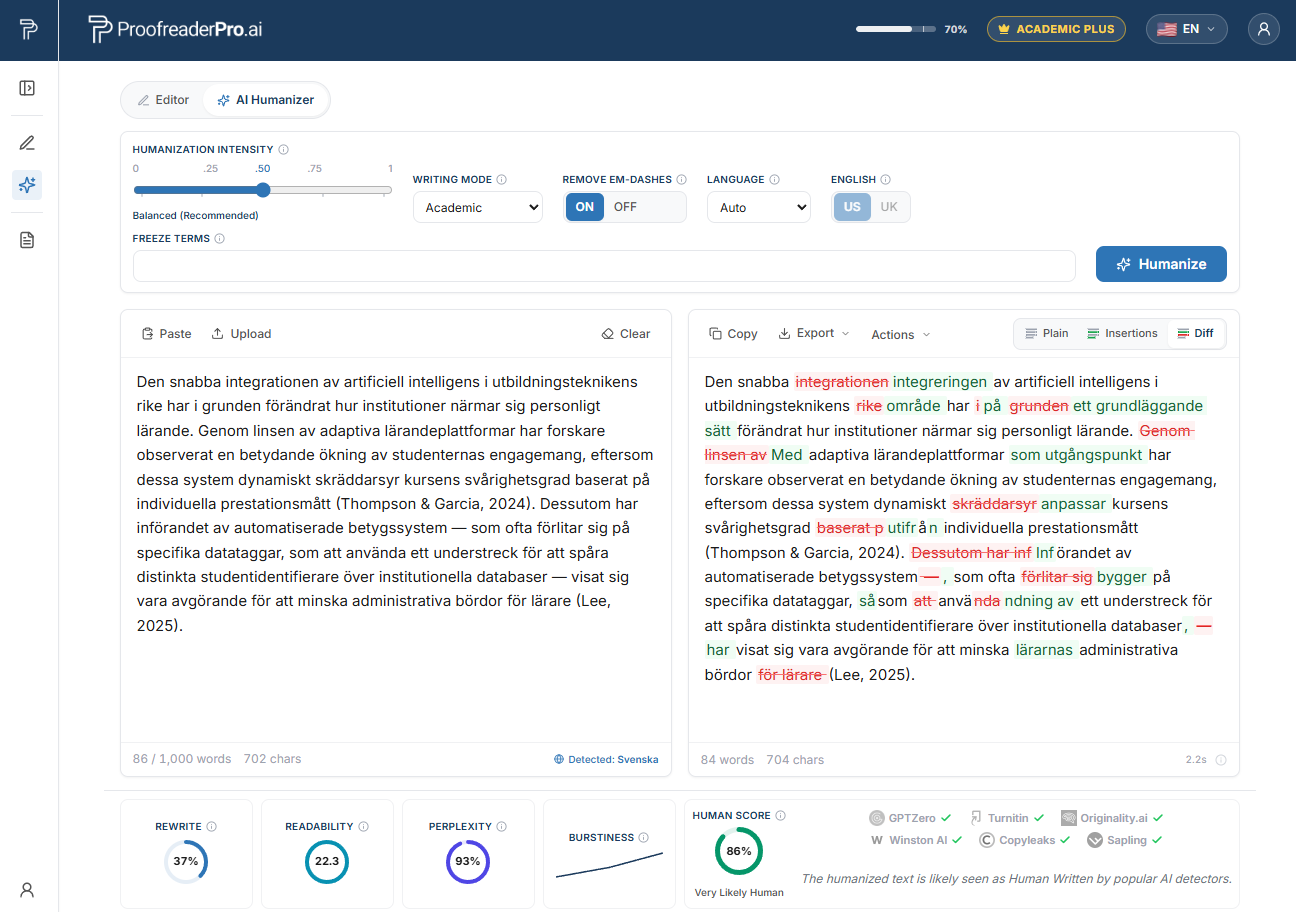
ProofreaderPro AI 人性化工具重写瑞典学术文本。改写前后对比差异(diff)保留你的含义与引用,而检测检查结果则确认这是自然、人类的阅读体验。
Why Swedish researchers get flagged by AI detectors
先看那项把问题量化出来的研究。2023 年,斯坦福团队由 Liang 及其同事领衔,在 Cell Press 期刊 Patterns 上发表论文 "GPT detectors are biased against non-native English writers"。他们将人工撰写的 TOEFL 写作随笔输入七种广泛使用的检测器进行测试。
结果十分鲜明:平均而言,大约 61% 的非母语文章被判定为 AI 生成;而母语英文写作者的比例约为 5%。在面板中的每一种检测器都一致认为为 AI 的情况接近五分之一,即约 19.8% 的非母语文章被“全体一致”标记。每一篇随笔都由真人撰写。
为什么会这样?许多检测器会计算困惑度(perplexity),即衡量语言模型对“下一个词”预测有多么出人意料。细致的二语写作者往往会使用常见词以及标准句式,这本身当然属于良好写作,但同时也会生成可预测、较低困惑度的文本。而正是那些让“瑞典语式英语”更清晰的习惯,恰恰是这些系统被训练来识别并标记的特征。我们会在 why AI detectors flag non-native English 中更细致地讲解其机制。
这些并非抽象问题。非母语研究人员的被拒率往往比母语者高约 2.5 倍,在撰写论文上花费的时间约多 51%,且因语言质量而收到的修订请求数量也远高于母语者。一旦出现误报型 AI 标记,就会落在本已陡峭的门槛之上。
The Swedish first-language patterns behind false flags
瑞典学术英语有一种可识别的“形状”,其中没有任何内容是错误的。这些都是正确、谨慎、规范的构式。它们的“规范性”正是陷阱:对检测器而言,“标准”会被读取为低困惑度。
“假朋友”(false friends)是经典信号。"Aktuell" 的含义是“当前的/相关的”,不是“actual(实际的)”;"eventuellt" 的含义是“可能”,不是“eventually(最终)”;"kontrollera" 的含义是“检查”,不是“to control(控制)”。当瑞典作者写 "we controlled the temperature" 并想表达 “we checked it(我们检查了温度)”时,他所使用的是精确、刻意的词汇,这正是模型容易预测到的用法。
词序也会延续。瑞典语是“动词第二位”(verb-second)语言,因此限定动词会倾向于出现在第二个位置。这样的习惯会产生经过衡量、略显正式的句子;而在纠正之后("Therefore the model is robust"),仍然保留的平整度会被检测器读取为“机器节奏”。
还有介词与冠词。瑞典语用后缀来标记确定性,而不是像英语那样用独立的词,所以英语的冠词可能会被遗漏或重复:"the research show"、"result was significant"。一旦校对者把这些调整为规范形式,它们就会变得整齐有序;而“整齐”恰恰是低困惑度的典型得分特征。
此外还有一些较小但反复出现的信号:用于表示“持续时间”的 "since"、以及大量使用复合名词与词语 "respective",再加上一种略显克制的文体(register),有些审稿人会把这种风格误读为平淡。每一种选择单独看都可以辩护。但合在一起,它们会形成顺畅、均匀、且容易被模型提前预测的文本。
Sweden's AI-detection and Turnitin context
在瑞典,论文和手稿会例行接受筛查。相似性检测是行业中的常规做法,而许多瑞典高校在历史上依赖于本土开发的 Urkund 与 Ouriginal 系统,它们现在已成为 Turnitin 的一部分。AI 指示信息日益与相似度分数一起出现在同一份报告中。
指导意见也在追赶。瑞典高等教育机构协会(Association of Swedish Higher Education Institutions, SUHF)以及各个高校都发布了生成式 AI 方面的指导,而资助方与期刊越来越频繁地要求清晰说明 AI 的使用方式。整体趋势是走向披露,而不是禁止。
需要记住的一点是:检测器分数是一种“主张”,而不是“裁决”。Turnitin 本身会压制低区间分数,而不是给出具体数字,并提示其分数不应仅凭分数来决定诚信相关问题。国外多所高校(包括 Vanderbilt)已经因为误报与对非母语写作者的偏见而完全停用了 AI 检测器。被标记是一件需要争议的事,而不是一种“认罪”。
在提交之前保护您的瑞典语-英语写作
对您自己的借助AI撰写的稿件进行人性化处理,保留您的引用和含义,然后按照期刊与机构要求披露您的AI使用情况。先在论文的单段落上试用,看看差异。
试用 Humanizer 免费版Top Swedish universities and where AI checks appear
在瑞典顶尖机构中,同样的筛查工具会出现在不同院校里,从医学院到技术类大学:
- Karolinska Institutet (KI),斯德哥尔摩(医学)
- Uppsala universitet,乌普萨拉
- Lunds universitet,隆德
- Kungliga Tekniska högskolan (KTH),斯德哥尔摩
- Stockholms universitet (SU),斯德哥尔摩
- Göteborgs universitet (GU),哥德堡
- Chalmers tekniska högskola,哥德堡
- Linköpings universitet (LiU),林雪平
- Umeå universitet,于默奥
- Sveriges lantbruksuniversitet (SLU),乌普萨拉
- Örebro universitet,厄勒布鲁
- Linnéuniversitetet,韦克舍与卡尔马
以上每一个筛查都会对论文与手稿做相似性检查,并且越来越会在同一套工作流程中权衡 AI 指示信息。重点并不在于它们“都怀有敌意”。而在于:误报型标记可能发生在任何一所机构的仔细工作上,因此最稳妥的做法是在提交之前保护好自己的写作。
瑞典研究人员的 AI 人性化工具如何运作
工作流程诚实且简单,从你的原创草稿开始。
先写作。许多瑞典研究人员会先用瑞典语起草,思考最快,再进行翻译;也有一些人会直接用英语起草。不论哪种方式,文字和论证都属于你。
先校对语法。把“假朋友”词、被遗漏的冠词,以及动词第二位结构带来的延续问题理顺。我们的 AI proofreader 会在不扁平化你表达的前提下修复机械性问题;一旦语法到位,你就可以进入人性化步骤。
再对你自己的 AI 辅助文本进行人性化处理。此时,面向瑞典研究人员的 AI 人性化工具 会调整节奏与用词选择,打破过于均匀的节拍,去除那些容易触发检测器的重复模式与游离的破折号(em dashes)。在我们自己的测试中,这会显著降低主要检测器(Turnitin、Originality.ai、GPTZero 等)对“认真但非母语写作”的误读频率,同时保留你的含义、术语与引文。我们将其描述为我们在测试中观察到的效果,而不是承诺。检测器每隔几个月就会重新训练,因此没有任何诚实的工具可以声称“100% 不被识别”。
非英语草稿同样适用。该人性化工具支持超过 60 种语言,并将非英语文本通过“语言感知”的模型处理,从而保持句子结构与意义不被破坏。如果你需要在翻译之前先对瑞典语草稿进行人性化,这一点尤其重要。本文是我们 multilingual AI humanizer hub 的一个节点,并且它与 global academic editing hub 并行,用于全手稿层面的编辑工作。
然后进行披露。对自己的写作进行人性化,并不等同于隐藏它。你需要按照你所在院系与目标期刊要求的格式说明你如何使用 AI;在这样做之后,你就能在诚信规则的框架内,既保护你的成果不被误报型标记影响。
Local funding bodies, journals, and AI-disclosure expectations
瑞典的资助方越来越希望看到关于 AI 使用的透明度。Vetenskapsrådet(瑞典研究理事会,VR)是主要的公共资助方,而 Knut and Alice Wallenberg Foundation(KAW)是重要的私人资助方。Forte(健康、工作生活与福利)、Formas(环境与农业)以及 Vinnova(创新)分别资助各自领域;瑞典相关团队也会定期赢得 ERC 项目,并且开放获取在各方面都被要求。
在发表层面,瑞典研究人员主要瞄准 Web of Science 和 Scopus 收录的期刊,并在 SwePub 中登记成果。这些期刊也越来越频繁地要求对 AI 辅助做出明确说明。现在就把简短、诚实的披露写进常规的方法(methods)或致谢(acknowledgements)部分,往往比多数人想象的更容易做到。请参阅我们关于撰写 AI disclosure statement 的指南;如果即便在内容清晰且已披露的情况下仍然出现了标记,那么 appeal playbook 会讲解如何应对。
贯穿其中的主题是公平。你完成了研究,你写下了论文;而困惑度分数不应当取代这一切。
Frequently asked questions
Q: Will an AI humanizer help if my English is already very good?
通常可以,而且这正是最反直觉的部分。检测器会标记低困惑度文本,而“精炼、标准”的瑞典语式英语天生就容易呈现低困惑度。人性化工具会调整你的节奏与措辞,使得干净的写作更不容易被误读,同时不改变你实际上表达了什么。
Q: Is it against the rules to humanise AI-text in my own thesis?
将自己的草稿进行人性化处理,然后披露你使用 AI,大多数机构并不违反规则。规则所关注的是:是否把捏造或未披露的内容当作自己的成果来提交。当你保留原意与引文,并清楚说明你如何使用 AI,你就仍然处在诚信框架之内。
Q: Can any tool guarantee my paper passes Turnitin or GPTZero?
不能,而且要小心任何声称能做到这一点的人。检测器每隔几个月就会更换其模型,因此没有任何诚实的工具可以承诺结果,或声称“100% 不被识别”。我们能说的是:在我们的测试中,人性化工具确实能在谨慎的非母语文本上显著降低误报,这与“保证”不同。
Q: Does the humanizer change my citations or technical terms?
不会。该工具的设计目标是保留引文、技术术语以及你论证的实质内容,同时对节奏与用词做相应调整。你的参考文献列表、你的公式,以及你的领域词汇都会保持为你原本写作时的样子。
Q: I drafted in Swedish first. Does that matter?
这不是问题。人性化工具支持超过 60 种语言,并使用“语言感知”的模型处理非英语文本,从而保护句子结构与意义。因此,你可以用瑞典语先工作,再翻译;或者在把内容翻译成英语之后再进行人性化处理。
在保留您的含义、术语和引用的前提下,减少对谨慎的非母语文稿的误报型AI检测。专为研究人员在英文期刊发表而设计。

Moe 是一名 NLP 工程师,拥有自然语言处理领域的 PhD 学位。 他的研究涵盖计算语言学、文本分析和机器学习,并直接反馈到 ProofreaderPro 背后的编辑和人性化模型中。 他写了大多数人从未见过的过程的一部分:语言模型如何读取句子、对其进行评分并决定更改哪些内容。


