
面向用英语撰写的匈牙利研究者的 AI 人类化工具
面向匈牙利研究者的 AI 人类化工具。降低受匈牙利语影响的英语中误触发 AI 检测的情况,保持原意与引文,真实披露使用情况。

匈牙利的科学成就往往“超出其体量”。一个不足一千万人口的国家,造就了一条令人瞩目的数学家、物理学家、化学家以及生命科学研究者的队伍,而这种传统在今天匈牙利的高校产出中仍能看见。工作以英语写作来完成。几乎每一位布达佩斯或塞格德的研究者都会先用匈牙利语起草并思考,然后把论证“跨语言”到第二种几乎不共享语法的语言中。这种翻译落差,正是面向匈牙利研究者的 AI 人类化工具能够发挥作用的关键点:如今,经过细致的匈英写作却被误读成了机器文本。
这里有一个令人不适的事实:你的英语越清晰、越规范、越“标准”,AI 检测越可能把它标记出来。某些通过评估词语“有多出人意料”来给文本打分的模型,会把你那种严谨、可预期的表达方式当作机器作者的信号。你用一门困难的第二语言把写作写得更清楚,却反而得到了一次错误指控。
为了解决这一特定问题,我们打造了这款人类化工具:保护真正的研究者、真正的研究成果,而不是去隐藏任何人的“捷径”。本指南将说明它如何嵌入匈牙利学者真实的投稿出版流程。
AI-szöveg humanizálása(匈牙利研究者的 AI 文本人类化)
AI-szöveg humanizálása 的意思是:让你使用人工智能辅助撰写的文本呈现更“像人”的节奏,同时保持含义、术语与引文不变。我们的工具面向以母语匈牙利语起草、再用英语发表的匈牙利学术作者。
关键不在于伪装任何东西。关键在于:一位匈牙利学者写出的、经过细致打磨的规范英语句子,不应因为“它清晰且规范”就被当作可疑对象。我们的 text humanizer 正是为降低这种误报而设计。
先用匈牙利语起草?人类化工具能直接识别并重写
你可以在不先翻译成英语的情况下,对匈牙利语草稿进行人类化处理。直接粘贴你的文本,ProofreaderPro 会自动识别语言,然后把它交给一个“懂匈牙利语”的模型:它会尊重长元音、黏着结构,以及你文中保留的引文。AI-szöveg humanizálása 会在不改变每一个术语与参考信息的前提下,调整你匈牙利语散文的节奏。自动检测覆盖六十多种语言,因此匈牙利语会被当作匈牙利语来处理,而不是被改造成英语。
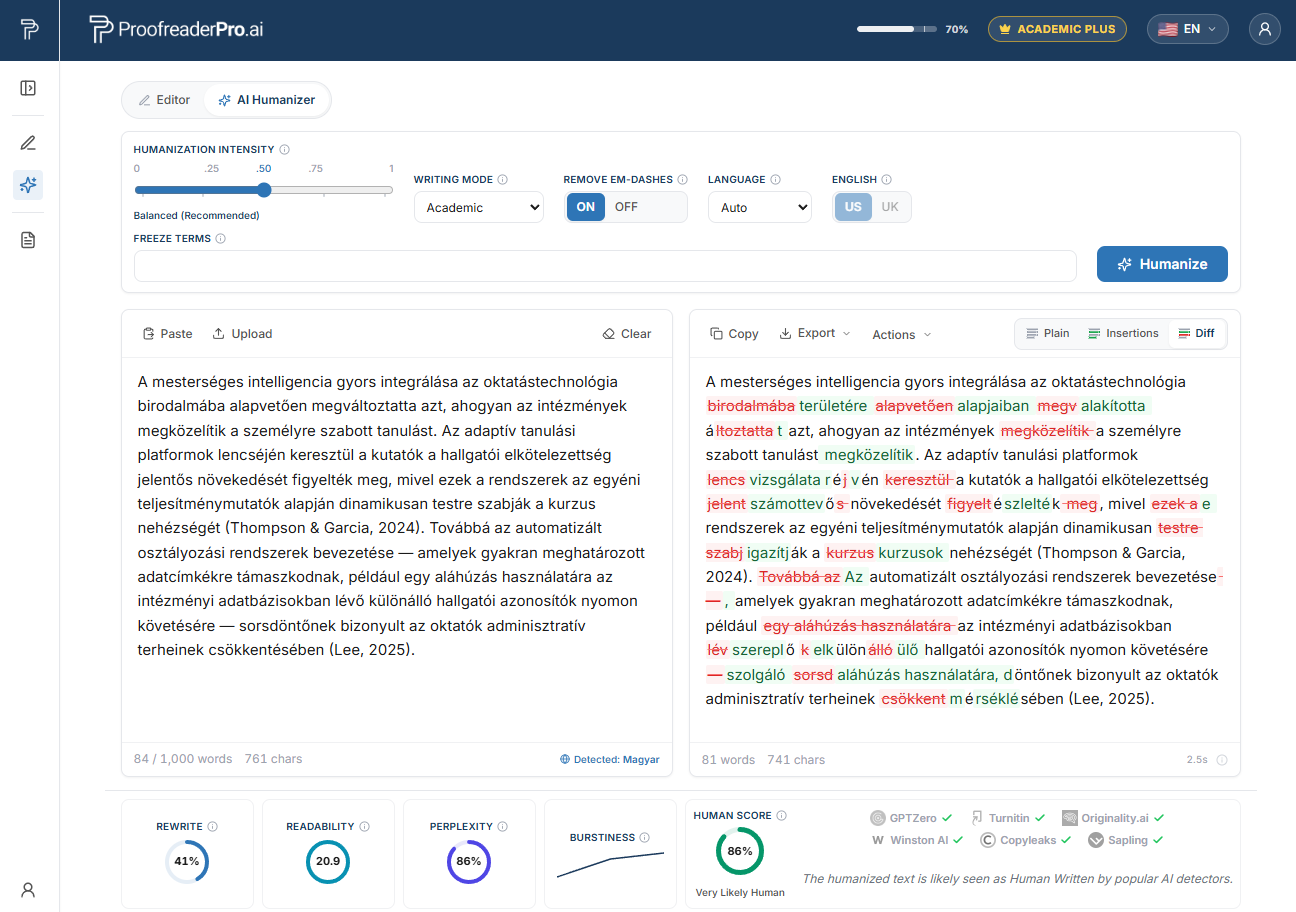
ProofreaderPro AI Humanizer 重写匈牙利学术文本。前后对比差异(diff)保留了你的含义与引文,检测检查则证实阅读体验更加自然、更具“人味”。
为什么匈牙利研究者容易被 AI 检测标记
在 2023 年,斯坦福大学一个由 Weixin Liang 领导的研究小组测试了七种常用的 GPT 检测器,所用材料是人类撰写的论文。论文来自 TOEFL 考试,因此每一份材料都有人类作者,只是作者是非母语英语写作者。平均来看,这些论文中约 61% 被标记为 AI 生成。对于母语英语作者的论文,这一比例约为 5%。而在非母语论文中,几乎五分之一(约 19.8%)的文章被每一个单独检测器“全体一致”地标记。
再读一遍:由于英语是作者的第二语言,人类写作反而比“它本应如此”的情况被标记得更频繁,频率高出十倍以上。
其机制被称为“困惑度(perplexity)”。许多检测器会估计你所选择的词在语言模型看来有多“可预测”。当你用第二语言写作时,你会倾向于使用安全、常见、正确的构式,因为谨慎的写作者往往就是这么做的。“安全且常见”意味着困惑度更低,而“困惑度更低”正是这些工具训练时用来读取为机器文本的指纹。我们在 why AI detectors flag non-native writers 中拆解了完整机制,但简短的版本很残酷:让你的文笔清晰的写作习惯,正是导致它被标记的原因。
错误标记背后的匈牙利语母语模式
匈牙利语属于乌拉尔语系,与周边的印欧语言并无亲缘关系,其逻辑与英语确实不同。这种差异会在匈牙利语,英语写作中留下“指纹”。这些指纹并不是智力层面的错误。它们是非常不同的语法所留下的影子,一旦被平滑地整理成干净的英语,就会在检测器看来变得平、变得可预期。
一个代词对应 he 和 she。 匈牙利语只有一个第三人称代词、没有语法性别,因此 “he” 与 “she” 在英语里会被互换。那些会为此进行校正的作者,往往会过度使用最安全的选项,或围绕 “the author(作者)” 和 “the participant(参与者)” 重建句子,从而产生非常均匀、低变化率的散文。
冠词的分布逻辑不同。 匈牙利语当然也使用冠词(a、az、egy),但其放置逻辑与英语不同。定冠词与不定冠词会被省略或增补,而这种“谨慎的修正”通常是在每个位置都选择最标准、最像教科书的冠词。恰恰是“标准化”的结果,会更像机器。
黏着结构与较重的名词化。 匈牙利语通过把后缀层层叠加到词干上来构建意义。转移到英语后,这种习惯会变成密集的名词短语,以及很长的名词化链条(“the implementation of the optimization of...”),它们在语法上完全正确,却在节奏上高度单调。检测器尤其青睐这种单调。
话题优先的词序。 匈牙利语会把句子的“话题”和“焦点”摆在前台,因此强调落点的位置与英语读者的预期不同。当作者把这种结构“规范化”为直白的主语,谓语,宾语英语时,结果通常是正确、井然、有规律且可预期的。
没有专门的将来时标记,以及不同的体(aspect)系统。 匈牙利语对未来的标记方式不同,并以自己的方式处理体,因此英语的时态选择可能会显得不够一致,然后又会朝向最中性、最常见的时态被校正。最安全的时态,依旧是那个困惑度最低的时态。
用后置词(postpositions)而非介词(prepositions)。 匈牙利语会把关系标记放在名词之后,因此在英语里更容易出现介词使用上的“滑错”。修复这些滑错就意味着你必须每次都去选用那个最标准的介词,而“标准”正是检测器读取为“生成式文本”的特征。
匈牙利的 AI 检测与 Turnitin 语境
来自匈牙利机构的学位论文与期刊投稿通常会例行进行文本相似度筛查,最常见的是使用 Turnitin 或同类系统,同时 AI 指示也越来越多地被纳入同一类筛查之中。这已经成为博士答辩与稿件审阅中的常规环节,而非某种“例外步骤”。
也值得把这些工具的局限性纳入考量。国外一些大型高校(包括 Vanderbilt)已因误报以及对非母语写作者的偏差而关闭 Turnitin 的 AI 写作检测;而 Turnitin 本身也会压低其最低分并提示:其分数绝不应当单独决定一个诚信相关案件。检测器的分数是一种你被允许提出异议的“主张”,而不是最终裁决。
匈牙利的机构也发布了针对生成式 AI 的自有指导,资助方与期刊也越来越期待作者披露这些工具是如何被使用的。诚实的回应并不是隐瞒任何东西,而是负责任地写作与编辑,然后声明你所依赖的工具。
匈牙利顶尖高校及 AI 检查通常出现在哪里
在匈牙利高等教育体系中,从博士培养单位到期刊编辑部,文本相似度筛查与 AI 指示相关的检查普遍存在。以下机构是该国研究强度最高的机构之一,其论文与稿件会经过这些检查:
- Eötvös Loránd Tudományegyetem(Eötvös Loránd University,ELTE),布达佩斯
- Semmelweis Egyetem(Semmelweis University),布达佩斯,一所重要的医学院
- Szegedi Tudományegyetem(University of Szeged),塞格德
- Debreceni Egyetem(University of Debrecen),德布勒森
- Budapesti Műszaki és Gazdaságtudományi Egyetem(Budapest University of Technology and Economics,BME),布达佩斯
- Budapesti Corvinus Egyetem(Corvinus University of Budapest),布达佩斯
- Pécsi Tudományegyetem(University of Pécs),佩奇
- Pázmány Péter Katolikus Egyetem(Pázmány Péter Catholic University),布达佩斯
- Óbudai Egyetem(Óbuda University),布达佩斯
无论你的工作是在 ELTE 进行答辩的学位论文,还是来自 Semmelweis 的临床稿件,同样的逻辑都适用:经过细致打磨的、标准的匈英写作,是最容易触发基于困惑度的误报的写作。
面向匈牙利研究者的 AI 人类化工具如何工作
我们建议的流程简单,而且更重要的是诚实。它分为三个阶段。
第一步,起草。按照最快把你的思考写到页面上的方式来完成论文。对许多匈牙利研究者而言,这意味着先用匈牙利语起草再翻译,或在 AI 辅助下直接用英语写作。两种方式都可以。
第二步,校对与完善内容。修正语法、术语与论证,使科学表述准确无误。如果语言本身需要更细致的处理,我们的 global academic editing hub 涵盖这一部分。
第三步,对你自己的草稿进行“人类化”。这时就会用到 text humanizer。它会调整句子的长度与节奏,打散黏着结构的匈牙利语—英语写作往往会产生的单调韵律,并移除 AI 工具与第二语言习惯共同留下的那些零散的破折号(em dashes)以及反复出现的结构。关键是:它会保留你的含义、你的技术词汇以及所有引文。非英语的源文本会走入“语言感知”的模型处理流程,而该工具支持超过六十种语言。
这会带来什么效果?在我们自己的测试中,对一份严谨的非母语草稿进行人类化,能显著降低主要检测器误读其为机器写作的频率,同时保持学术含义不变。我们将其描述为“我们在测试中看到的结果”,而不是作出承诺。任何诚实的工具都无法在这里保证一定会得到某个结果,因为检测器会每隔几个月重新训练;任何声称“100% 不可检测”的服务,都在向你兜售一个无法交付的承诺。
最后一步:披露。在你所在大学以及目标期刊要求的格式下添加 AI 使用声明。将你自己借助 AI 辅助完成的写作进行人类化,然后如实声明,这并不是“技巧”。这意味着你在确保:你的细致工作会依据其本身的价值被评估,而不是因为你在第二语言中写得足够清晰,就被指控为“写得像机器”。关于跨国家层面的更广泛语言图景,请参阅我们的 multilingual AI humanizer hub。
本地资助机构、期刊与 AI 披露预期
匈牙利的竞争性科研主要通过 NKFIH(Nemzeti Kutatási, Fejlesztési és Innovációs Hivatal,the National Research, Development and Innovation Office) 提供资金支持;同时以 MTA(Magyar Tudományos Akadémia,the Hungarian Academy of Sciences) 作为国家级学术机构,以及由 HUN-REN(the Hungarian Research Network) 运行公共科研机构。它们都奖励已发表并被收录的成果,这会持续给研究者带来“用英语发表”的压力。
这些成果会通过 Web of Science 与 Scopus 收录的期刊进行衡量,并在 MTMT(Magyar Tudományos Művek Tára,the Hungarian Scientific Bibliography) 这一国家出版数据库中登记。评价文化奖励国际化、英语语言的发表方式,而这正是把匈牙利学者推向“干净、标准化散文”的压力,因为检测器往往会把这种文风误读为机器文本。
预期在课题申请报告与期刊投稿中,AI 使用披露将变得更常见。把它当作常规做法。直接说明你使用了哪些工具、如何使用,保持数据与引文的诚实性,这样你就能在规则内保持从容,同时在面对不公平的误报时捍卫你的写作。
常见问题
Q: 面向匈牙利研究者的 AI 人类化工具会改变我的引文或技术术语吗?
不会。人类化工具的设计目标就是:完整保留你的含义、与你学科相关的术语,以及你在写作中所写下的每一条参考信息。它只会调整节奏与措辞,而不改变你的科学内容或你的资料来源。
Q: 有任何工具能保证我的论文通过所有 AI 检测器吗?
没有,你也应该对任何做出此类保证的人保持不信任。检测器会定期重新训练,因此任何诚实的服务都无法承诺“100% 不可检测”。我们能说的是:在我们的测试中,对谨慎的非母语文本进行人类化,会显著降低其被误读为机器写作的频率。
Q: 把自己的草稿进行人类化是否属于作弊?
只要你是在处理自己的 AI 辅助写作、保持研究发现的诚实性,并按照你所在机构与期刊的要求披露工具使用情况,就不算作弊。目标是对真实工作保持公平,而不是伪装。
Q: 为什么我的英语写得很清楚却被标记,而较弱的写作却不会?
因为许多检测器会评分“可预测性”。谨慎的第二语言写作者会选择安全、标准且正确的构式,这会产生低困惑度文本,而低困惑度正是这些工具所关联的“机器写作”模式。你的清晰度反而会与你作对。
Q: 我是先用匈牙利语起草。工具能处理吗?
可以。非英语文本会进入“语言感知”的模型处理流程,在六十多种语言之间保留句子结构与含义,因此你可以用匈牙利语起草、再翻译,然后对英语版本进行人类化,而不会丢失你的论点。
将您自己精心撰写、借助 AI 辅助的匈牙利语-英语草稿改写为自然的学术表述,保留每一个引用和结论,然后自信地披露您使用 AI 的情况

Moe 是一名 NLP 工程师,拥有自然语言处理领域的 PhD 学位。 他的研究涵盖计算语言学、文本分析和机器学习,并直接反馈到 ProofreaderPro 背后的编辑和人性化模型中。 他写了大多数人从未见过的过程的一部分:语言模型如何读取句子、对其进行评分并决定更改哪些内容。


