
Как снизить показатель AI detection: практическое руководство для исследователей
Пошаговое руководство, как снизить AI detection score ниже 15%. Проверенные методы для GPTZero, ZeroGPT и Copyleaks.

Если вы использовали модели ИИ, такие как ChatGPT, Claude, Gemini или Deepseek, чтобы помочь в работе над вашей исследовательской статьей, ваш AI score, вероятно, был бы высоким в популярных AI detectors, таких как Turnitin или GPTZero. В этой статье объясняется, как снизить ваш AI detection score до уровня, подходящего для подачи.
Вот точный workflow, который снизит ваш AI percentage до безопасного диапазона.
Пять шагов вкратце
- Прогоните свой черновик через два детектора и отметьте, какие фрагменты помечены.
- Перепишите помеченные фрагменты вручную своими словами, меняя структуру, а не просто заменяя слова.
- Обработайте упрямые разделы с помощью академического гуманизатора, который сохраняет цитаты и терминологию.
- Повторно проверьте весь документ теми же детекторами, с которых вы начинали.
- Остановитесь на реалистичной цели, ниже 15% достижимо, а 0% не требуется.
Разделы ниже подробно рассматривают каждый шаг, включая то, что делать, когда написанный человеком текст получает пометку.
Что на самом деле измеряет ваш AI detection score
Прежде чем вы начнёте исправлять это число, нужно понять, что оно означает. AI detectors, такие как Turnitin, GPTZero, Originality.ai и Copyleaks, анализируют ваш текст на наличие статистических паттернов, которые характерны для текста, сгенерированного AI.
К таким паттернам относятся low perplexity, то есть предсказуемый выбор слов, low burstiness, то есть однородная длина и структура предложений, а также высокая согласованность ритма абзацев. Человеческое письмо обычно более неряшливое, с разной длиной предложений, неожиданным выбором слов, периодическими отступлениями в сторону. AI writing tends to be smooth, even, and predictable.
Ваш AI detection score не измеряет, использовали ли вы AI. Он измеряет, проявляет ли ваш текст паттерны, которые коррелируют с output AI. Это важное различие, потому что очень многие тексты, написанные людьми, вызывают срабатывание тех же самых паттернов, особенно формальное академическое письмо, которое по своей природе более структурировано и предсказуемо, чем разговорная проза.
Третий сигнал, который некоторые detectors учитывают, это распределение vocabulary. Models favor слова, которые статистически часто встречаются в их training data, тогда как у human writers vocabulary более идиосинкразический: термины, которые они употребляют слишком часто, необычные слова, которые они предпочитают, дисциплинарный жаргон, используемый в неожиданных местах.
Детекторы университетского уровня, один за другим
Понимание того, с каким именно детектором вы имеете дело, меняет то, как вы читаете результат. Это инструменты, которые учреждения и клиенты реально используют в 2026, что именно измеряет каждый из них и какой результат считается безопасным. Какой бы ни был инструмент, относитесь к любому показателю как к сигналу к проверке, а не как к доказательству: в одном широко цитируемом исследовании Stanford обычные детекторы пометили 61% эссе, написанных не носителями английского языка, как созданные AI.
| Детектор | Кто его использует | Что нужно знать |
|---|---|---|
| Turnitin | Университеты, на уровне учреждений | Показывает *% ниже 20%; практическая цель ниже 20% |
| GPTZero | Преподаватели и студенты | Подсвечивает помеченные предложения; цель ниже 15% без подсвеченных серий |
| Originality.ai | Издатели, агентства, клиенты | Только платный, агрессивный, часто обновляется |
| Copyleaks | Университеты через интеграции с LMS | Многоязычный, опубликованная доля ложных срабатываний ниже 1% |
| Winston AI | Преподаватели и контент-команды | Обработка входных данных через OCR; воспринимайте заявление о 99.98% как маркетинг |
| ZeroGPT | Студенты как бесплатная первая проверка | Показатели сильно колеблются; сам по себе никогда не является окончательным |
| Pangram | Офисы академической добросовестности | Ложные срабатывания на уровне 0.5% или ниже в независимом исследовании |
| Scribbr AI Detector | Студенты перед подачей | Точность в диапазоне от высоких 70% до средних 80%; это фильтр, а не доказательство |
| Sapling | Бизнес-команды и службы поддержки | Одно рецензируемое исследование выявило, что 90% человеческих образцов были помечены |
Turnitin
Стандарт по умолчанию в университетах. Система обнаружения AI-письма Turnitin встроена в ту же платформу, которая формирует отчет о сходстве, и лицензируется на уровне всего учреждения, поэтому студенты не могут купить доступ и проверить работу до сдачи. Она разбивает ваш документ на фрагменты и оценивает, какая часть прозы выглядит как сгенерированная AI, отдельно от показателя сходства. Важны два правила отображения: при результатах 20% и выше показывается процент с выделением на уровне предложений, тогда как результаты от 1% до 19% отображаются как *% без приписанного числа, потому что собственные тесты Turnitin показали больше ложных срабатываний ниже 20%. Практическая цель, это оставаться ниже 20%, то есть ниже порога, при котором отчет показывает точное число. Несколько крупных университетов отключили эту функцию из-за опасений по поводу ложноположительных результатов, а более новый продукт Turnitin Clarity смещает акцент доказательств в сторону процесса подготовки текста. Наши материалы пояснение по Turnitin Clarity и руководство по оценке Turnitin подробно разбирают оба вопроса.
GPTZero
Самый известный самостоятельный детектор, созданный для образования. GPTZero напрямую измеряет perplexity и burstiness и выделяет отдельные предложения, которые считает написанными машиной, что делает его самым полезным инструментом для рабочего процесса целевой переработки текста в этом руководстве. Преподаватели используют его панели для класса, студенты, бесплатный тариф, как предварительную проверку. Он хорошо показывает себя на необработанном выводе модели в бенчмарк-тестах и слабеет, когда текст действительно переработан. Стремитесь к показателю ниже 15% без выделенных последовательностей предложений. Наше руководство по оценке GPTZero разбирает его особенности.
Originality.ai
Детектор скорее для фриланса и издательской сферы, чем для аудитории учебных заведений. Агентства, редакторы и владельцы сайтов прогоняют через него целые статьи и веб-сайты, и красный результат может задержать оплату для пишущих специалистов. Он платный, регулярно обновляет модель и работает достаточно агрессивно: он находит больше AI-текста, чем большинство конкурентов, ценой большего числа ложных срабатываний на чистой прозе. Если клиент проверяет текст с его помощью, храните собственный отчет и стремитесь к четкому человеческому вердикту. Мы разбираем споры и тактики переработки в руководстве по оценке Originality.ai.
Copyleaks
Выбор корпоративного сегмента. Copyleaks подключается к системам управления обучением вроде Canvas, Moodle и Blackboard, распознает текст на нескольких языках и предлагает режимы чувствительности, а также сертификаты соответствия, которые внушают доверие закупочным отделам. В опубликованных данных его показатель ложноположительных результатов ниже 1%, один из самых низких среди распространенных инструментов. Университеты, которые не используют Turnitin, часто используют Copyleaks. Наше пояснение по Copyleaks объясняет, насколько можно доверять такому сигналу.
Winston AI
Продвигается как инструмент с точностью 99.98%, и это число следует читать как маркетинговое, а не измерительное, поскольку независимое тестирование показывает более скромную картину. Реальное отличие Winston, это обработка входных данных: он выполняет OCR, поэтому преподаватели могут сканировать рукописные или распечатанные работы, а также фотографии документов. Он продается образовательным организациям и контент-командам. Относитесь к его проценту как к любому другому результату одного инструмента и сверяйте его со вторым детектором. См. наш анализ точности Winston AI.
ZeroGPT
Бесплатный инструмент без входа в систему, который большинство студентов пробуют первым. Его оценки сильно колеблются на одном и том же тексте, поэтому он полезен лишь как грубый первый взгляд и не более того. Высокий показатель ZeroGPT на тексте, который вы написали сами, это обычное явление, и он не предсказывает, что скажут Turnitin или Copyleaks. Если ZeroGPT пометил ваш текст, перепроверьте его на двух более точно настроенных инструментах, прежде чем менять хоть слово. Наш обзор точности ZeroGPT объясняет, почему его цифры так сильно плавают.
Pangram
Самый сильный среди новых поколений. В независимом исследовании University of Chicago Pangram оказался единственным детектором, который удерживал ложноположительные результаты на уровне не выше 0.5% и при этом надежно выявлял AI-текст, а его точность сохраняется даже после прогонки текста через humanizers. Он все активнее используется в подразделениях академической добросовестности и редакционных командах, которые однажды уже пострадали от ложных срабатываний в других местах. Если ваша работа будет проверяться Pangram, единственный надежный подход, это тот, которому учит это руководство: подлинная структурная переработка собственным голосом.
Scribbr AI Detector
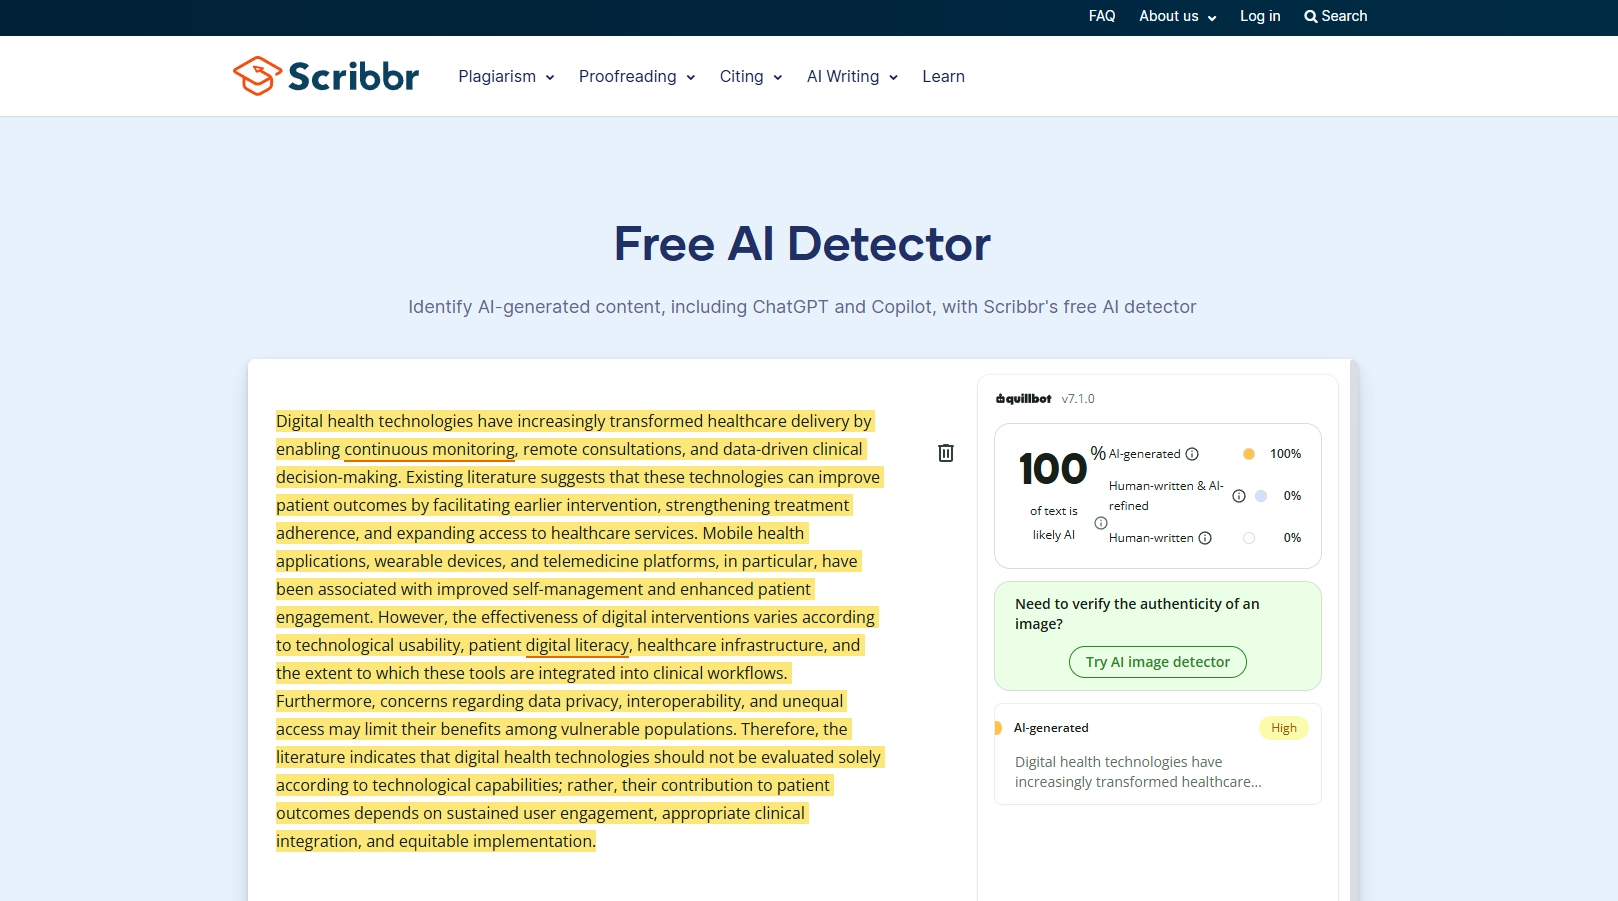
Бесплатная проверка для студентов, с платным тарифом, от одноименной редакторской компании. В тестах точности он попадает в диапазон от высоких 70-х до середины 80-х процентов, что делает его удобной предварительной проверкой перед сдачей и слабой основой для любого решения о добросовестности. Используйте его как первое мнение, а затем подтвердите вывод более сильным инструментом.
Sapling
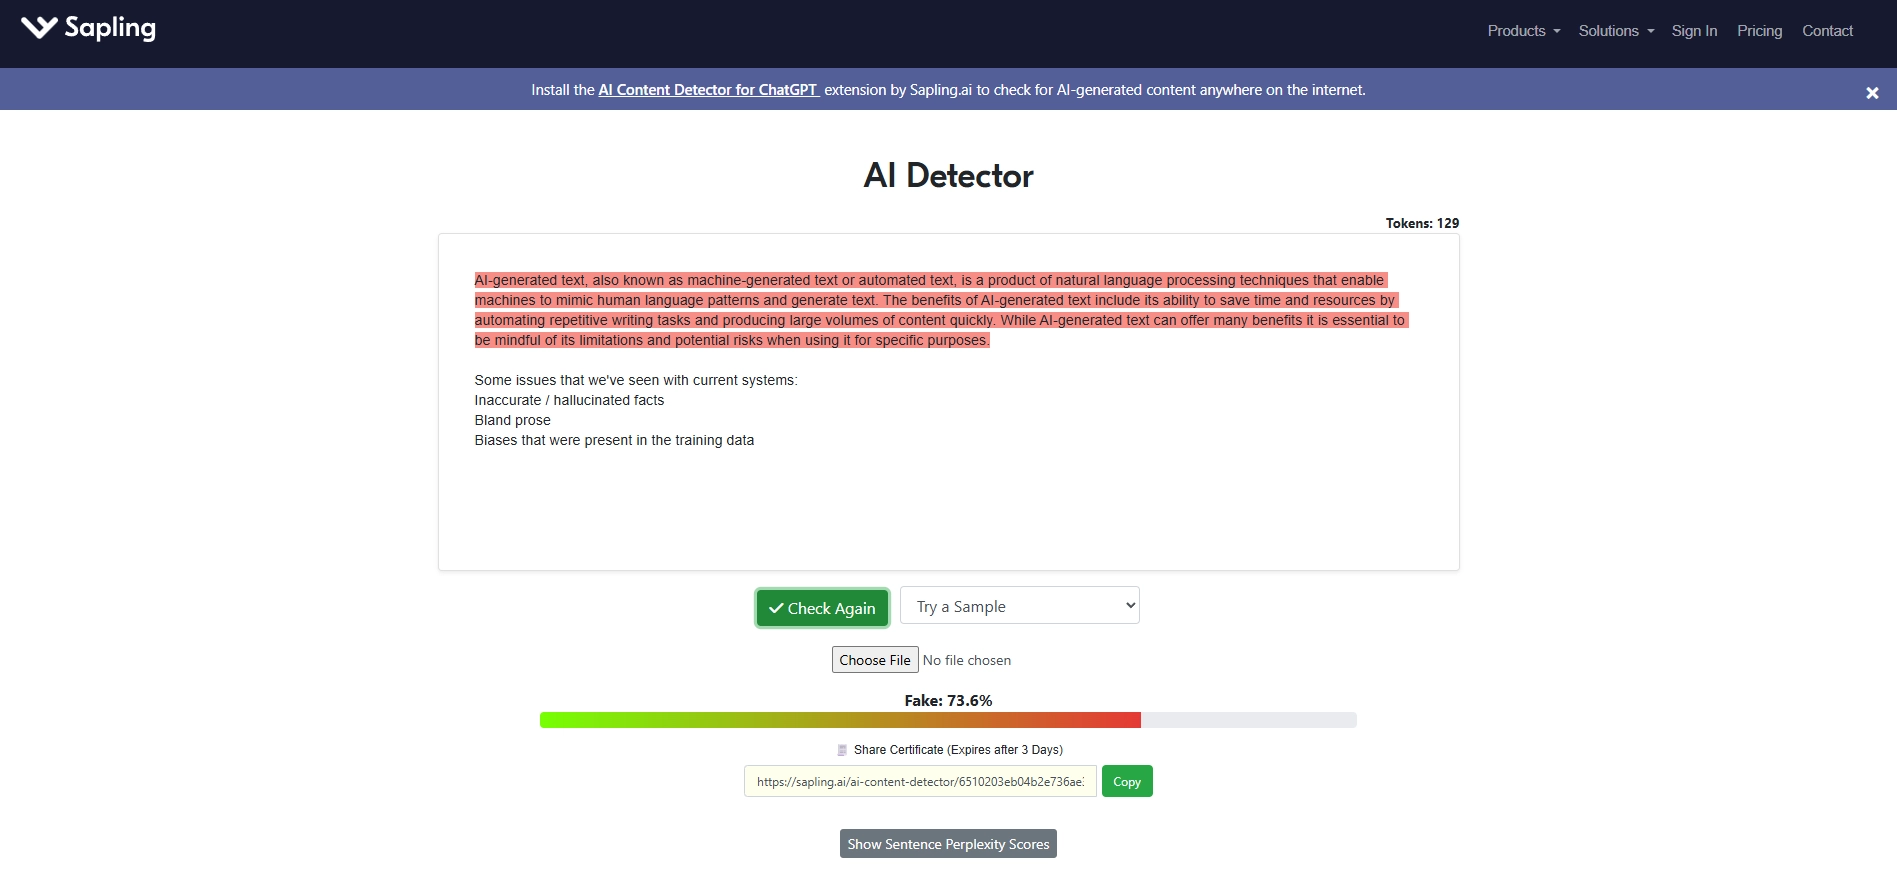
Создан для деловой переписки и текстов службы поддержки, а не для академической среды, и служит полезным предостережением: он заявляет точность до 97%, однако одно рецензируемое исследование показало, что он пометил 90% действительно написанных человеком образцов как AI. Если против вас когда-либо используют результат такого инструмента, именно это исследование стоит знать. И это еще одна причина, по которой это руководство снова и снова повторяет одно и то же правило: ни одно число одного детектора не является доказательством.
Шаг 1: Определите, какие разделы отмечены
Не переписывайте всю работу. Это пустая трата времени и, скорее всего, только ухудшит результат.
Вместо этого пропустите текст через детектор, который показывает анализ по предложениям или по абзацам. Пометка на уровне предложения в GPTZero особенно полезна здесь. Она покажет вам, какие именно фрагменты помечаются как вероятно сгенерированные ИИ.
По нашему опыту, оценки обнаружения ИИ в научной работе редко распределяются равномерно. Обычно оказывается, что 2-3 раздела формируют большую часть оценки, часто это введение, обзор литературы или сильно структурированные описания методологии. Именно на них и стоит сосредоточиться.
Скопируйте свой текст в детектор. Отметьте фрагменты, которые были помечены. Это ваш список приоритетов.
Шаг 2: Перепишите отмеченные фрагменты вручную
Это самый эффективный отдельный шаг, который вы можете предпринять, чтобы снизить свой показатель обнаружения ИИ, и здесь нет никакого обходного пути.
Возьмите каждый отмеченный фрагмент и перепишите его с нуля. Не редактируйте существующий текст. Откройте пустой документ и изложите ту же идею своими словами. Это заставляет вас разорвать статистические паттерны, которые фиксируют детекторы.
Есть три конкретные техники, которые работают:
Целенаправленно варьируйте длину предложений. Текст, созданный ИИ, обычно тяготеет к предложениям длиной 15-25 слов с поразительной регулярностью. Вставляйте короткие предложения. Затем продолжайте более длинным предложением, которое развивает мысль подробнее и включает одно или два придаточных предложения. Одно это разнообразие может заметно снизить показатель ИИ у абзаца.
Добавляйте личный академический голос. Там, где это уместно, вставляйте смягчающие формулировки ("это может указывать"), оговорки ("с учетом того, что") или характерные для вашей дисциплины формулировки. ИИ склонен писать на обобщенном академическом английском. У вашей области есть собственные конвенции, используйте их.
Перестраивайте, а не просто перефразируйте. Если в сгенерированной ИИ версии три пункта были перечислены в нумерованном формате, объедините их в связный текст. Если там использовалась структура "тематическое предложение, затем доказательства", попробуйте начать с доказательств и подвести к тезису. Структурные изменения эффективнее, чем изменения на уровне отдельных слов.
Шаг 3: Используйте AI humanizer для упрямых фрагментов
Некоторые фрагменты не поддаются ручной переработке, особенно разделы методов с жёстко фиксированным процедурным языком или разделы результатов, построенные вокруг статистической отчётности. Эти разделы по своей природе структурированы и предсказуемы, поэтому детекторы помечают их независимо от того, писал ли их AI.
Для таких фрагментов может помочь AI text humanizer. Хороший humanizer вносит естественное разнообразие в структуру предложений и выбор слов, сохраняя техническую точность.
Ключевое слово здесь, 'хороший'. Большинство humanizer'ов вычеркнут вашу техническую лексику и исказят цитаты. Используйте инструмент, созданный для академического текста, тот, который понимает, что "p < 0.05" это статистическое выражение, а не опечатка, которую нужно исправить. Наше руководство по humanizing AI text for academic writing объясняет, как выбирать и использовать эти инструменты без ущерба для качества.
Снизьте свой AI-оценку за минуты
Наш инструмент очеловечивания текста создан для академического письма. Он сохраняет цитаты, технические термины и научный стиль, одновременно снижая показатели AI-детекции.
Попробовать Text Humanizer бесплатноШаг 4: Повторная проверка с несколькими детекторами
После переписывания и очеловечивания текста прогоните обновлённую версию как минимум через три разных детектора. Мы рекомендуем GPTZero, ZeroGPT и Copyleaks, потому что они используют разные модели и выявляют разные типы закономерностей.
Почему именно три? Потому что ни один детектор не является окончательным авторитетом. Отрывок, который получает 5% в GPTZero, может получить 30% в ZeroGPT. Ваш преподаватель может использовать любой из них, или вообще другой инструмент. Проверяя текст в нескольких детекторах, вы охватываете больше вариантов.
Если ваш текст получает ниже 15% во всех трёх, вы в безопасной зоне. Если один из детекторов всё ещё помечает какой-то фрагмент, вернитесь именно к этому месту и примените ручные приёмы переписывания из Шага 2.
Что не работает
Некоторые популярные тактики стабильно дают сбой, а несколько даже ухудшают результат.
- Парафразеры, заменяющие синонимы, подставляют слова, сохраняя при этом типичную для ИИ структуру предложений, а именно это и измеряют детекторы. После такого подбора слов оценки нередко растут.
- Приемы на уровне символов, невидимый Unicode, похожие буквы, добавленные пробелы, современные детекторы нормализуют еще до анализа, а некоторые отдельно фиксируют сам факт манипуляции.
- Обратный перевод через другой язык ухудшает смысл и цитирование, но сохраняет машинно-типичный ритм.
- Намеренные опечатки снижают качество рукописи, не изменяя статистические закономерности, которые считывают детекторы.
Структурная переработка, это единственный подход, который меняет то, что измеряют детекторы: ритм предложений, предсказуемость слов и структуру абзацев. Ручное переписывание и academic humanization делают именно это, разница лишь в скорости.
Где сосредоточиться, раздел за разделом
Разные части статьи вызывают подозрения по-разному, поэтому тратьте время на переработку там, где это действительно важно.
Аннотация. Часто это самый заметный для проверок раздел, потому что по своей природе он насыщенный и формульный. Варьируйте структуру предложений и избегайте начала трёх последовательных предложений с "This study," "This paper," или "This research,", шаблон, который AI особенно любит.
Введение. Здесь хорошо работают личные формулировки. "We became interested in this question when..." или "The gap became apparent during our review of..." Элементы повествования от первого лица модели трудно воспроизводить естественно, и они воспринимаются как текст, написанный человеком.
Методы. По своей природе этот раздел формульный, поэтому он естественным образом показывает низкий показатель perplexity. Именно здесь detection AI наименее надёжно, и именно здесь проверяющие ожидают жёсткого следования конвенциям. Сосредоточьтесь на точности, а не на «очеловечивании».
Результаты. Сообщайте конкретные выводы с точными числами. "Participants in the treatment group showed a mean improvement of 3.7 points (SD = 1.2, p = 0.003)" звучит как человеческий текст. Обобщённое резюмирование звучит как AI.
Обсуждение. Здесь важнее всего ваш интерпретационный голос. Вступайте в диалог с противоречивыми результатами, конкретно, а не расплывчато, обозначайте ограничения и связывайте результаты с вашей более широкой исследовательской программой. Эти элементы требуют подлинной экспертности и воспринимаются как аутентично человеческие.
Почему некоторые тексты, написанные человеком, помечаются как AI, ложно положительные срабатывания
Вот что удивляет большинство людей: тексты, полностью написанные человеком, регулярно вызывают срабатывание AI-детекторов.
Мы проверили это сами. Мы взяли пять фрагментов, полностью написанных исследователями-людьми, без какого-либо участия AI, и прогнали их через GPTZero, ZeroGPT и Copyleaks. Средний AI-скор по всем фрагментам составил 18%. Один раздел методов получил 34% AI, хотя был написан от руки постдоком с десятью годами опыта.
Ложно положительные срабатывания возникают потому, что академическое письмо разделяет структурные особенности с результатами, создаваемыми AI. И то, и другое обычно тяготеет к формальному регистру, последовательной структуре абзацев и предсказуемой лексике внутри дисциплины. Детекторы не могут различить, что именно означает «это похоже на AI, потому что это написал AI» и «это похоже на AI, потому что это формальная академическая проза».
Именно поэтому паника из-за умеренного AI-скорa контрпродуктивна. Некоторый уровень детекции нормален, даже для полностью оригинальной работы. Для более глубокого взгляда на то, насколько надежны эти инструменты на самом деле, см. наш анализ точности AI-детекции в 2026 году.
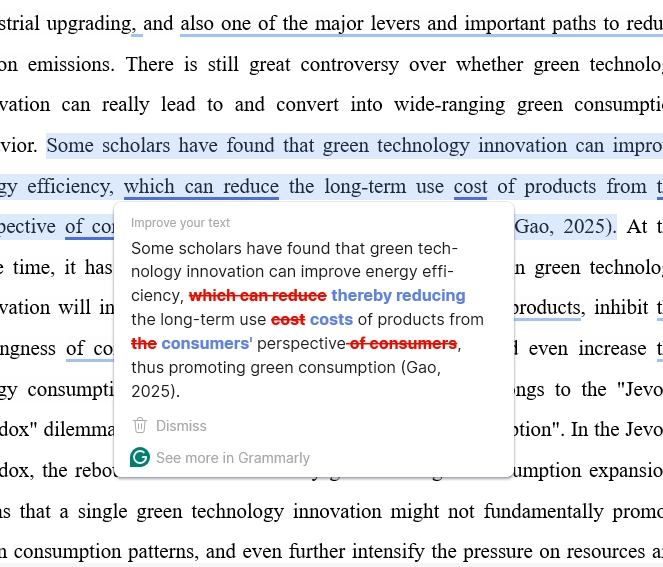
Повышают ли Grammarly, QuillBot и другие инструменты редактирования ваш AI score?
Да, могут, и это застаёт людей врасплох, потому что черновик изначально полностью человеческий. Эти инструменты меняют именно то, что измеряют детекторы.
Скриншот ниже показывает, как Grammarly проходит по рукописи по экономике, написанной человеком. Его предложение заменяет "which can reduce" на "thereby reducing" и перестраивает "the consumers' perspective" в "the perspective of consumers". Каждая замена грамматически корректна, и каждая замена сдвигает предложение в сторону гладкого, формального регистра, к которому языковые модели по умолчанию тяготеют.
Тот же проход проверки предложил "underscoring" вместо "which highlights", одного из самых узнаваемых AI-типичных слов в академической прозе:
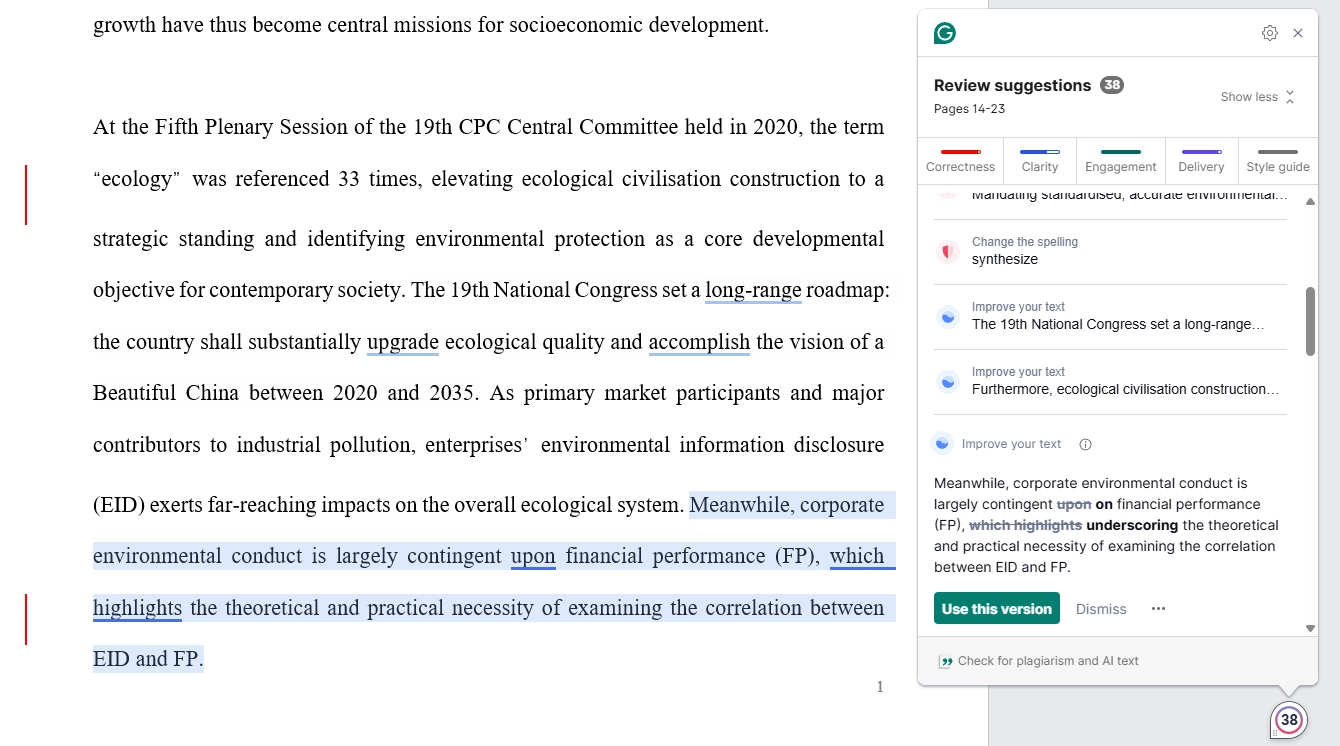
Одно принятое предложение ничего не меняет. Несколько десятков меняют статистический профиль документа, ритм предложений становится более ровным, связки более формальными, а слова вроде "thereby", "moreover" и "underscoring" накапливаются. Именно этот профиль и оценивают детекторы, и некоторые теперь называют его напрямую. Детектор Scribbr, показанный ранее в этом руководстве, сообщает отдельную категорию "Human-written & AI-refined" для именно такого текста. Режимы перефразирования QuillBot идут ещё дальше в том же направлении, потому что переписывание целых предложений в фирменный стиль и есть весь продукт.
Решение не в том, чтобы отказаться от редактирования. Нужно использовать редактор, который исправляет ошибки, не перерабатывая ваш текст. Режим Light proofreading в ProofreaderPro безопасен для детекторов по этой причине: он исправляет грамматику, орфографию и пунктуацию как отдельные отслеживаемые изменения и оставляет структуру предложений и выбор слов без изменений, так что шаблоны, по которым детекторы ставят отпечаток, остаются вашими. Запустите его через AI proofreader, проверьте каждое изменение, и ваш score будет отражать ваше письмо, а не ваш инструмент редактирования.
Реалистичная цель: ниже 15%, а не 0%
Перестаньте пытаться достичь 0%. Это недостижимо, и погоня за этим только ухудшит качество вашего текста.
Для 0% AI score текст должен быть настолько неровным и непредсказуемым, что его было бы трудно читать как хорошо написанный. Статистические паттерны, на которые смотрят детекторы, существенно пересекаются с паттернами ясной, хорошо организованной академической прозы. Устранение всех сигналов для детекторов означает устранение ясности и структуры.
Реалистичная цель для академической работы, это ниже 15% в нескольких детекторах. На этом уровне ваш текст попадает в нормальный диапазон академического контента, написанного человеком. Большинство учреждений, использующих AI detection, устанавливают пороги на уровне 20% или выше, признавая, что некоторый уровень совпадения паттернов неизбежен.
Вот рабочий процесс, который мы рекомендуем:
- Напишите или сгенерируйте черновик, как бы вы его ни создавали
- Прогоните его через GPTZero, чтобы выявить отмеченные фрагменты
- Вручную перепишите самые проблемные по оценке отрывки, используя методы выше
- Используйте text humanizer для упрямых фрагментов, которые не поддаются ручной переработке
- Проверьте повторно в трех детекторах: GPTZero, ZeroGPT, Copyleaks
- Стремитесь к уровню ниже 15% во всех трех, затем остановитесь
Снижение ниже 15% дает все меньшую отдачу. Время, которое вы потратили бы на погоню за более низким числом, лучше направить на улучшение фактического содержания вашей работы и ее аргументации.
В следующий раз: сначала пишите сами, потом используйте AI
Самый надёжный способ изначально избежать высокого результата, это перевернуть обычный рабочий процесс с AI: сначала написать собственный черновик, а AI использовать только для его доработки. Грубый, несовершенный человеческий черновик несёт в себе ритм ваших предложений, выбор слов и структурные привычки, а доработка с помощью AI сглаживает поверхность, не стирая эти более глубокие особенности.
- Напишите черновик по своим заметкам и исследованиям, без помощи AI
- Самостоятельно отредактируйте структуру и аргументацию
- Используйте AI для конкретных задач: проверки грамматики, повышения ясности предложений, рекомендаций по выбору слов
- Просмотрите и измените предложения AI так, чтобы они соответствовали вашему стилю
- В конце перечитайте текст, чтобы убедиться, что он звучит как ваш
В более долгосрочной перспективе та же привычка формирует самую сильную защиту, какая только есть: узнаваемый голос. Читайте много в своей области, пишите регулярно и используйте AI proofreading tool для финальной полировки после того, как мыслительная работа завершена. По-настоящему человеческое письмо содержит закономерности, которые не воспроизводит ни одна модель, и у детектора просто нечего обнаруживать, когда текст ваш собственный.
Этические принципы, изложенные прямо
Между двумя ситуациями есть существенная разница. Использование AI для написания работы, которую вы выдаете за собственную, а затем скрытие участия AI, является академической недобросовестностью, и никакое "очеловечивание" этого не меняет. Использование AI как инструмента письма для улучшения грамматики, ясности и структуры, а затем обеспечение того, чтобы результат не был ошибочно помечен, является ответственным использованием инструмента. Критерий здесь, интеллектуальный вклад: идеи, анализ и аргументы должны быть вашими. Многие университеты теперь прямо закрепляют это различие в своих правилах по AI, поэтому проверьте свои и при необходимости сообщайте об использовании инструмента.
Часто задаваемые вопросы
Как уменьшить мой процент AI ниже 20%?
Наиболее эффективный метод, это ручная переработка помеченных фрагментов. Пропустите текст через детектор на уровне предложений, такой как GPTZero, определите конкретные отрывки, которые повышают ваш показатель, и перепишите эти отрывки с нуля, не просто редактируйте их. Сосредоточьтесь на вариации длины предложений, добавлении специфичной для вашей области формулировки и перестройке абзацев. Для упорных фрагментов используйте академический AI humanizer. Большинство студентов могут опуститься ниже 20% за один раунд целевой переработки.
Определяет ли ZeroGPT весь текст, написанный AI?
Нет. ZeroGPT, как и все AI детекторы, имеет существенные ограничения. В независимом тестировании точность ZeroGPT составляет от 60-85% в зависимости от типа текста и AI модели, которая его сгенерировала. Он лучше работает с неотредактированным выводом GPT-3.5 и хуже с текстом от более новых моделей или текстом, который был вручную исправлен. Он также дает ложные срабатывания, помечая написанный человеком текст как сгенерированный AI, с частотой от 5-15% в зависимости от стиля письма. Ни один AI детектор не следует считать безошибочным.
Почему мой показатель AI высокий, хотя я написал текст сам?
Ложные срабатывания распространены в академическом письме, потому что формальная научная проза разделяет статистические признаки с текстом, сгенерированным AI,, постоянную длину предложений, формальную лексику, предсказуемую структуру абзацев и организацию по теме-предложению. Разделы с методикой и обзоры литературы особенно подвержены ложным срабатываниям, потому что они следуют жестким дисциплинарным конвенциям. Если вы написали текст сами, задокументируйте процесс написания и поговорите с преподавателем, вместо того чтобы пытаться переписать и без того хороший текст, чтобы обмануть детектор.
Какой показатель AI большинство университетов считают приемлемым?
Универсального стандарта не существует. Политики сильно различаются между учреждениями и даже между кафедрами в одном университете. Самые распространенные пороги, которые мы видели, находятся в диапазоне от 15% до 25%, хотя некоторые учреждения помечают для проверки все, что выше 10%. Многие университеты вообще не устанавливают жестких порогов, они используют AI detection как инструмент предварительного отбора, который запускает человеческую проверку, а не автоматические санкции. Проверьте политику вашего конкретного учреждения и, если есть сомнения, стремитесь к показателю ниже 15% по нескольким детекторам.
Работает ли тот же метод на AI score Turnitin?
Да. Индикатор AI у Turnitin считывает тот же класс статистических паттернов, что и GPTZero и Copyleaks, поэтому структурная переработка меняет его таким же образом. Для подробностей, специфичных для Turnitin, см. наше руководство по humanizer для Turnitin и руководство по score Turnitin.
Этично ли избегать AI detection в академическом письме?
Это зависит от того, как именно вы использовали AI. Если вы использовали AI как вспомогательный инструмент для письма, для проверки грамматики, повышения ясности предложений или структурирования собственных идей, тогда разумно убедиться, что ваш текст не будет ошибочно помечен. Если вы использовали AI для генерации контента, который выдаете за свою собственную интеллектуальную работу, избегать обнаружения нечестно. Этический вопрос касается идей, а не стиля текста. Всегда проверяйте и соблюдайте политику вашего учреждения в отношении использования AI.
Какой самый эффективный способ избежать AI detection?
Писать собственный первый черновик и использовать AI только для доработки. Текст, который начинается как написанный человеком, сохраняет человеческие паттерны даже после редактирования AI. В сочетании с намеренной вариацией длины предложений, добавлением личного авторского голоса и финальной проверкой через детектор это дает текст, который стабильно проходит AI detectors.
Работают ли AI detectors с неанглийским текстом?
AI detectors для неанглийского текста менее надежны, чем детекторы для английского языка. Большинство коммерческих детекторов обучаются в первую очередь на англоязычных данных. Если вы пишете на другом языке, вероятность ложных срабатываний может быть выше, а стратегии обхода обнаружения могут потребовать адаптации к нормам этого языка.
Может ли Turnitin обнаружить AI-assisted writing?
AI detection в Turnitin выявляет паттерны, согласующиеся с генерацией AI, и не может различить текст, сгенерированный AI, и текст, созданный при помощи AI. Текст, который в основном был написан человеком и доработан с помощью AI, все равно может быть помечен. Если вы пишете первые черновики сами и значительно варьируете структуру предложений, это существенно снижает вероятность ложного срабатывания.
Снижайте показатели обнаружения AI, сохраняя академический тон, цитаты и техническую лексику.
Мо — инженер NLP с PhD в области обработки естественного языка. Его исследования охватывают компьютерную лингвистику, анализ текста и машинное обучение, и они напрямую используются в моделях редактирования и гуманизации, лежащих в основе ProofreaderPro. Он пишет о той части процесса, которую большинство людей никогда не видит: о том, как языковая модель читает предложение, оценивает его и решает, что изменить.


