Водяные знаки OpenAI, SynthID и Claude: сравнение текстовых водяных знаков
Наносит ли OpenAI водяные знаки на текст, есть ли публичный проверяльщик водяных знаков OpenAI, и чем отличаются водяные знаки SynthID и Claude, сравнение для академических авторов.
OpenAI, Google и Anthropic создали одну и ту же технологию: статистический водяной знак для текста, сгенерированного ИИ. OpenAI несколько лет держала свою версию в стороне и начала внедрение, как textGrain, в октябре 2026. Google встроила SynthID в Gemini и опубликовала метод. Anthropic сделала водяной знак Claude обязательным для каждого пользователя в августе 2026. Если вы пишете с помощью ИИ в любом виде, эти три решения теперь влияют на то, как оценивают ваши документы.
От темы исследований до мейнстрим-новостей: 11 августа 2026 года, когда Anthropic объявила, что каждая новая модель Claude маркирует текстовый вывод. Мы подробно разобрали это объявление в нашем объяснении водяного знака Claude. Это руководство дает полную картину: что такое текстовый водяной знак, как каждая из трех ключевых лабораторий реализовала или не стала его внедрять, и что каждый из систем подтверждает в отношении фрагмента текста.
Что такое AI-текстовый водяной знак?
AI-текстовый водяной знак это статистический шаблон, скрытый в выборе слов сгенерированного текста. Его встраивают в момент генерации, чтобы детектор с нужным ключом позже мог подтвердить, что текст был создан конкретной ИИ-системой. Это не видимая метка, не скрытый символ и не метаданные, прикрепленные к файлу. Знак живет непосредственно в самих словах.
Это важное различие, потому что термин "watermark" используется довольно свободно для трех разных вещей:
| Что это | Где находится | Переживает ли копирование и вставку? | |
|---|---|---|---|
| Статистический водяной знак | Смещение, при котором модель выбирает одни слова вместо других | Сам текст | Да |
| Метаданные файла (C2PA) | Подписанная метка происхождения | Контейнер файла | Нет, копирование обычного текста это убирает |
| Символы нулевой ширины | Невидимый Unicode вставлен в текст | Между видимыми символами | Нет, это тривиально удаляется |
Статистическое водяное маркирование это единственное из трех, которое сохраняется при копировании, вставке, повторном наборе в новый документ и при преобразовании формата. Поэтому все три крупнейшие лаборатории сошлись на нем для текста, и поэтому «средства удаления водяных знаков», которые убирают невидимые символы, против него не помогают. Наша страница бесплатного средства удаления водяного знака Claude документирует этот сценарий отказа с источниками.
Как именно работает статистическое водяное маркирование?
На каждом шаге написания предложения языковая модель выбирает между несколькими близкими по смыслу словами, а водяной знак незаметно «загружает» эти кости. Базовый рецепт был опубликован Kirchenbauer и коллегами из Университета Мэриленда в январе 2023 года в Водяной знак для больших языковых моделей (ICML 2023). Это работает так:
- Перед тем как выбрать каждое слово, секретный ключ, полученный из предшествующих слов, разделяет словарь на предпочитаемый набор и нейтральный набор.
- Модель слегка направляет свой выбор в сторону предпочитаемого набора. «Suggest» вместо «indicate». «Across» вместо «among». Каждый отдельный выбор выглядит совершенно естественно.
- Детектор, который знает ключ, подсчитывает, как часто текст попадает в предпочитаемые наборы. Человеческое письмо попадает в ожидаемую долю случайно. Водяная разметка попадает туда слишком часто, и статистический тест выявляет несоответствие.
Ни одно слово само по себе не является доказательством чего бы то ни было. Сигнал проявляется только на десятках или сотнях решений, поэтому более длинные фрагменты проверять проще, чем короткие, и поэтому детектирование всегда вероятностное, а не «штамп да или нет».
Производственная система Google DeepMind, опубликованная в Nature в октябре 2024 года как Масштабируемое маркирование для выявления выходных данных больших языковых моделей, усовершенствовала это техникой под названием tournament sampling, которая сохраняет качество текста настолько хорошо, что позволяет выполнять маркирование незаметно внутри потребительского продукта в масштабе. Эта работа важна не только для Google: это опубликованная основа, на которую Anthropic ссылается для реализации водяного знака Claude.
Основная слабость была опубликована до большинства развертываний. В марте 2023 года Krishna и коллеги показали в Paraphrasing evades detectors of AI-generated text (NeurIPS 2023), что перефразирование текста обходит детекторы ИИ-текста для всех методов, включая водяные знаки. Сигнал существует в точной последовательности токенов и больше нигде, поэтому любое переписывание последовательности, включая работу редактора-человека, переписывает доказательства. Любой поставщик, который сегодня использует водяной знак, указывает это ограничение в своей документации.
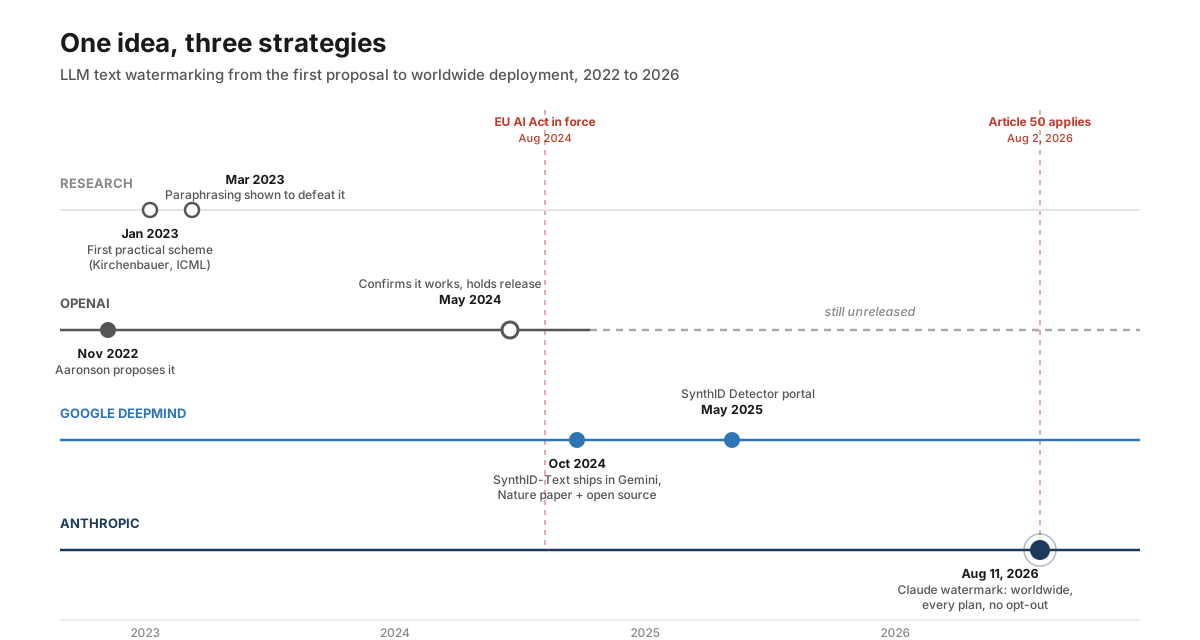
OpenAI: компания, которая это изобрела и выпустила в последнюю очередь
У OpenAI было работающее текстовое водяное маркирование много лет, и компания решила не выпускать его до октября 2026 года. Scott Aaronson, работавший тогда над безопасностью в OpenAI, впервые публично описал идею в лекции в ноябре 2022. Метод смещает выбор модели между близкими по смыслу словами с помощью секретной криптографической функции, так что сам текст показывает, откуда он взялся. Эта лекция старше каждой из развернутых систем.
В мае 2024 OpenAI описала состояние проекта в своем обновлении по происхождению данных, Understanding the source of what we see and hear online. Компания заявила, что ее метод текстового водяного знака точен и эффективен при небольших правках, но при этом задерживала выпуск, пока взвешивала компромиссы. Два из рисков, которые назвала OpenAI, напрямую важны для авторов в академической среде:
- Легкий обход. Перефразирование или перевод текста убирает отметку ровно так же, как это предсказали исследования 2023 года. Водяной знак, который в основном ловит тех, кто не знает о его существовании, это слабый инструмент принудительного контроля.
- Несоразмерное влияние на носителей английского как не родного. OpenAI сообщила, что водяная маркировка может стигматизировать законное использование ИИ как инструмента письма для людей, которые пишут на втором языке. Наша публикация о почему AI-детекторы отмечают авторов с не родным английским рассматривает ту же проблему со стороны детектора.
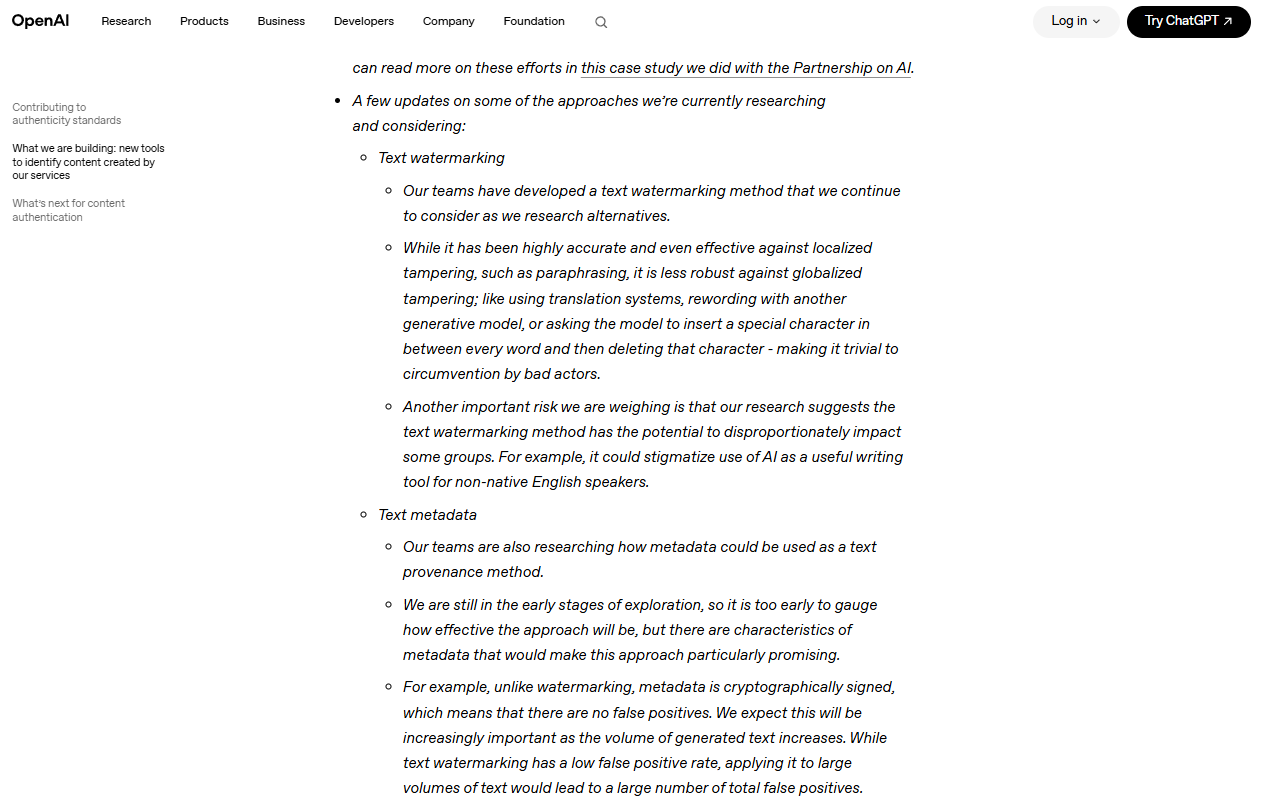
Обновление по происхождению данных OpenAI за 2024 год: метод работает, и компания приводит причины, почему не внедряла его сразу.
Для изображений и аудио OpenAI выбрала другой подход: метаданные происхождения C2PA в результатах DALL-E и Sora, то есть метка на уровне файла, а не отметка внутри содержания. Для текста вывод ChatGPT не имел водяного знака до октября 2026. Компания, предложившая технологию, была последней из трех, кто внедрил ее.
Накладывает ли OpenAI сейчас водяные знаки на текст?
Да, 5 октября 2026 года OpenAI начала маркировать некоторый текст водяными знаками в ответ на EU AI Act. Ее объявление представляет текстовую водяную маркировку под названием textGrain, которая добавляет невидимый статистический сигнал в выбор слов моделью. Развертывание состоит из трех частей, и водяной знак не является настройкой по умолчанию для всех:
- Клиенты API в любом месте могут включить водяномаркированный вывод для выбранных моделей. По умолчанию он остается выключенным.
- В последующие недели подходящий текстовый вывод ChatGPT и Codex в Европейском союзе получает водяной знак на всех тарифах.
- Утвержденные исследователи и экспертные организации могут подать заявку на доступ к детектору текстовой водяной маркировки.
OpenAI утверждает, что textGrain совпадал с другими методами, которые она тестировала, или превосходил их, включая SynthID для текста от Google. Также она опубликовала, где детектирование становится слабее. При уровне ложноположительных срабатываний 1% детектор выявлял водяной знак примерно в 80% фрагментов по 200 токенов и примерно в 95% фрагментов по 400 токенов в материалах по психологии. Для математики детектирование было намного ниже, потому что там меньше свободы в выборе формулировок.
Редактирование быстро ослабляет сигнал. В фрагментах по 400 токенов замена 10% слов синонимами снижала детектирование примерно с 92% до 66%, а замена 25% снижала до 17%.
OpenAI также проверила, меняет ли водяной знак качество ответов на Astra, ее последней модели, и заявляет, что не увидела существенной разницы. Это четыре из тех бенчмарков, которые она опубликовала:
| Бенчмарк | Без водяного знака (Astra) | С водяным знаком (Astra) |
|---|---|---|
| Artificial Analysis Intelligence Index | 49.57 балла | 49.76 балла |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
Для студентов важна дата. Текст ChatGPT, написанный до запуска, либо за пределами EU без включенной в API настройки, не содержит водяной маркировки OpenAI. Наше руководство по Turnitin Clarity описывает, как школы в это время формируют собственные политики использования ИИ.
Есть ли публичный проверяльщик водяных знаков OpenAI?
Пока нет публичного проверочного инструмента OpenAI для текста. Бесплатный инструмент для проверки от OpenAI проверяет изображения и аудиофайлы на наличие Content Credentials по C2PA и на наличие водяного знака SynthID. OpenAI встраивает SynthID в поддерживаемые изображения и аудио. При этом OpenAI заявляет, что инструмент не поддерживает текст.
Для текста OpenAI предоставляет доступ к детектору по принципу case-by-case для утвержденных исследователей и профильных организаций через форму Content Provenance API. Также она говорит, что не делает детектор текста публичным при запуске из-за риска пропустить водяные знаки и выдать ложные срабатывания. Детектор сообщает, находит ли он водяной знак OpenAI, но не идентифицирует пользователя и не показывает его подсказки.
| Что вы хотите проверить | Инструмент | Кто может пользоваться |
|---|---|---|
| Файл изображения или аудио от OpenAI | Инструмент верификации OpenAI | Любой, бесплатно |
| Текстовый вывод OpenAI (textGrain) | Детектор текстового водяного знака OpenAI | Утвержденные исследователи и профильные организации, по заявке |
| Текстовый вывод Claude | Детектор водяного знака Claude | Подходящие организации, по заявке (см. наше руководство по водяным знакам Claude) |
OpenAI также четко разъясняет, о чем не может сказать результат. Обнаруженный водяной знак не измеряет, сколько вклад сделал человек, и не определяет, кто написал или использовал текст. Отсутствие водяного знака тоже не доказывает авторство человека, потому что текст может быть слишком коротким, отредактированным, переведенным или созданным с помощью неподдерживаемой модели.
Google: сначала выпустили, затем раскрыли рецепт
Google DeepMind выпустила первой, затем полностью опубликовала, а после открыла метод. Ее система SynthID начиналась как водяной знак для изображений в 2023 году и расширилась на текст в 2024. К моменту появления статьи Nature в октябре 2024 SynthID-Text уже работал внутри Gemini в промышленной эксплуатации, что сделало его первым статистическим текстовым водяным знаком, развернутым в масштабе для массового пользователя.
SynthID охватывает текст, изображения, аудио и видео и работает в Gemini в выводе текста с октября 2024.
Затем Google опубликовала реализацию как open source на Hugging Face, позволяя любому разработчику применять ту же схему водяной маркировки к собственным моделям. В мае 2025 она объявила о SynthID Detector, портале верификации, где контент можно проверить на наличие меток SynthID в тексте, изображениях, аудио и видео.
Важно одно ограничение по охвату: SynthID только маркирует и только обнаруживает контент только из моделей самой Google. Она ничего не говорит о выводе ChatGPT или Claude, и чистое сканирование SynthID не означает, что текст написан человеком. Это значит лишь то, что модели Google не создавали этот текст, то есть это гораздо более узкое утверждение.
Anthropic: последняя к внедрению, самая строгая политика
Anthropic развернула последнюю версию с самым широким обязательным покрытием. Любая модель Claude, запущенная 2 августа 2026 года или позже, встраивает статистический водяной знак в текстовый вывод, по всему миру, во всех тарифах, без возможности отказаться. Механизм компания описывает в разъяснении How Claude's text watermark works, а область действия политики указана в статье справочного центра How Claude marks AI-generated content. Под покрытие подпадают Claude API, claude.ai, Claude Code, Claude Cowork и Claude Tag. Модели, запущенные до указанной отсечки, находятся в переходном периоде, и Anthropic говорит, что добавляет поддержку маркировки и для них. Помимо статистической метки, файлы, созданные Claude, также несут метаданные C2PA, второй отдельный механизм, который исчезает при простом копировании обычного текста.
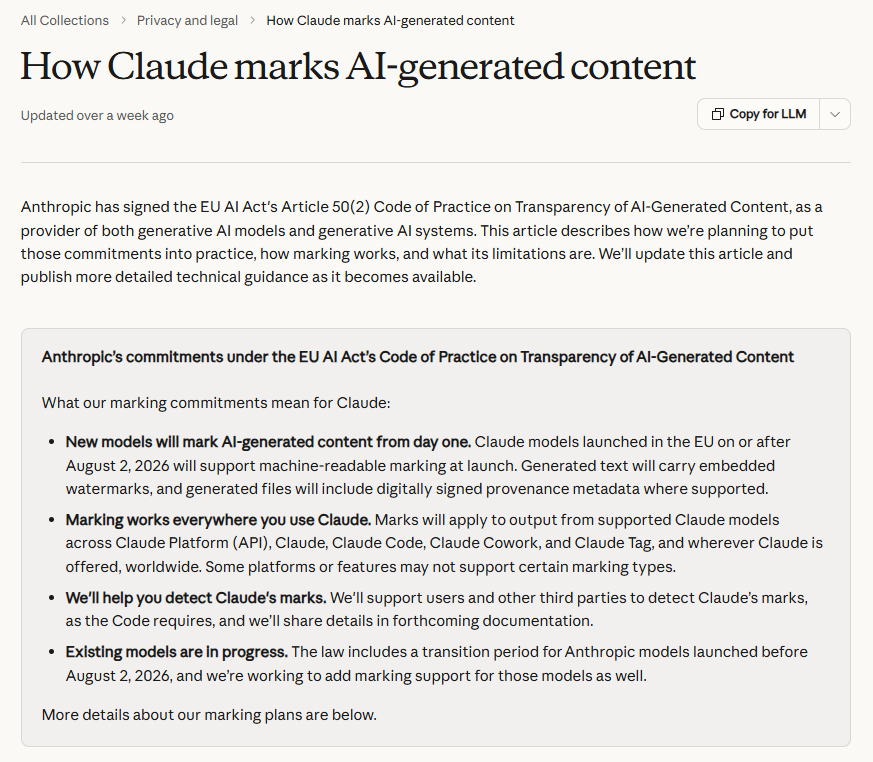
Политика Anthropic в формулировках компании: каждая новая модель, каждая платформа, по всему миру, при этом со старых моделей маркировка добавляется позже.
В документации Anthropic ограничения указаны прямо. Детектирование является вероятностным. Маркировка не может отличить документ, который написал Claude, от документа, который человек написал и Claude лишь слегка отредактировал. Полный перезапись удаляет маркировку. Мы разобрали все это, включая то, что именно доказывает положительное детектирование, и что делать, если вашу собственную работу пометили, в специализированном руководстве по водяным знакам Claude.
Сроки соответствуют регулированию. Anthropic подписала Кодекс практик Article 50(2) по прозрачности AI-Generated Content в рамках EU AI Act, который требует от поставщиков систем генеративного AI обеспечить, чтобы результаты были "помечены в машиночитаемом формате и распознавались как искусственно сгенерированные". Эти обязательства по прозрачности вступили в силу 2 августа 2026 года: это точная дата отсечки в модели Anthropic, за девять дней до публичного объявления. Anthropic выбрала глобальное соответствие вместо того, чтобы сохранять разное поведение для трафика из ЕС. Google уже был в соответствии по дизайну. Немаркированный вывод OpenAI это открытый вопрос соответствия на 2027 год.
Три подхода, рядом
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| Развернут текстовый водяной знак? | Да (textGrain, запуск в ЕС с 5 октября 2026) | Да (Gemini, с октября 2024) | Да (модели Claude с 2 августа 2026) |
| Технология | textGrain, статистический сигнал в выборе слов | Сэмплинг с турнирной схемой SynthID-Text | Статистическая маркировка при выборке, в стиле SynthID |
| Покрытие | Подходящие тексты ChatGPT и Codex в ЕС; в API опция включения по желанию по всему миру | Только модели Google | Все новые модели Claude; у старых моделей переходный период |
| Отключение | По умолчанию выключено в API | Нет | Нет |
| Публичный детектор | Нет | Портал SynthID Detector (2025) | Планируется, но пока не выпущен |
| Опубликована схема? | Только концептуальные лекции | Статья Nature плюс открытый исходный код | Пояснение на основе опубликованных работ |
| Метаданные файла (C2PA) | Да, для изображений и аудио | Да, в разных типах медиа | Да, для сгенерированных файлов |
| Заявленные ограничения | Обход, стигма для ESL | Область ограничена собственными моделями | Вероятностно: правки размывают авторство |
Шаблон во всех столбцах: OpenAI рассматривает текстовое водяное маркирование как нерешенную проблему политики, Google видит в нем инфраструктуру, которую нужно стандартизировать, а Anthropic трактует это как обязательство по соблюдению требований, которое нужно реализовать полностью.
Что это означает для исследователей и авторов академических текстов
Практические последствия зависят от того, какие инструменты касаются вашего текста. Если вы создаете черновик с помощью ChatGPT, сегодня в вашем тексте нет водяного знака. Если вы создаете черновик с помощью Gemini, в тексте есть отметка SynthID, которую может прочитать только детектор Google. Если вы создаете или редактируете с помощью актуальной модели Claude, в тексте будет отметка Anthropic, и не существует настройки, которая позволяет это отключить.
Три вещи, которые авторам академических текстов стоит знать:
Водяной знак идентифицирует инструмент, а не автора. Каждый вендор указывает это в своей документации, и повторять это стоит, потому что институциональные политики не всегда проводят это различие. Текст может быть помечен, потому что его создал ИИ, потому что ИИ сделал вычитку двух предложений, или потому что процитирован абзац с отметкой. Если в вашем учреждении выполняют проверки водяных знаков, то то, что доказывает проверка, это то, что конкретная модель касалась текста в какой-то момент, и ничего более. Наше руководство по оспариванию ложного сигнала AI-детекции объясняет, как выстроить этот аргумент, когда это важно.
Водяные знаки и AI-детекторы это разные технологии с разными режимами ошибок. Детекторы вроде Turnitin или GPTZero делают предположения по статистическим признакам стиля, с проблемами точности, которые мы задокументировали. Обнаружение водяного знака это проверка на основе ключа с очень низкой вероятностью ложноположительного срабатывания на немаркированный человеческий текст. Асимметрия меняется для ложноотрицательных результатов: проверка на водяной знак пропускает любой AI-текст от модели, которая не использует водяные знаки. Сегодня так происходит со всеми текстами ChatGPT.
Раскрытие остается вашей самой сильной позицией. Маркирование делает скрытое использование ИИ более рискованным, а раскрытое использование ИИ более безопасным, потому что при раскрытом процессе у вас нет повода опасаться положительной отметки. Большинство журналов и университетов сейчас имеют явные политики по использованию ИИ; в нашем политическом документе об использовании AI объясняется, где мы проводим эти границы для собственных инструментов, и это разумный шаблон для прозрачного использования.
Что убирает водяной знак текста и что не убирает
Переписывание убирает его; форматирование не убирает. Копирование, вставка, изменение шрифтов, преобразование между форматами файлов и удаление невидимых символов оставляют статистический водяной знак полностью нетронутым, потому что отметка находится в выборе слов. Убирает его все, что приводит к регенерации формулировок: глубокая правка человеком, перевод или действительно честный перефраз. Это было установлено в работе NeurIPS 2023 по устойчивости до того, как эти системы были запущены в производство.
Здесь важны оба направления. Исчезнувший маркер не делает текст вашим, а сохранившийся маркер не означает, что текст не ваш. Переписанный черновик, сгенерированный ИИ, все равно остается документом с ИИ-помощью, и к нему применяются правила вашего учебного заведения по обязательному раскрытию. Наш AI text humanizer переписывает черновики с ИИ-помощью в естественный академический стиль, и поскольку в процессе генерируется новая последовательность токенов, статистические маркеры через него не сохраняются. Для текста Claude, в частности, удаление водяных знаков Claude заново выражает каждое предложение свежими формулировками, не меняя факты, числа и ссылки (цитирования). То, что не может изменить ни один инструмент, это ваше обязательство перед читателем: прозрачность о том, как был подготовлен документ.
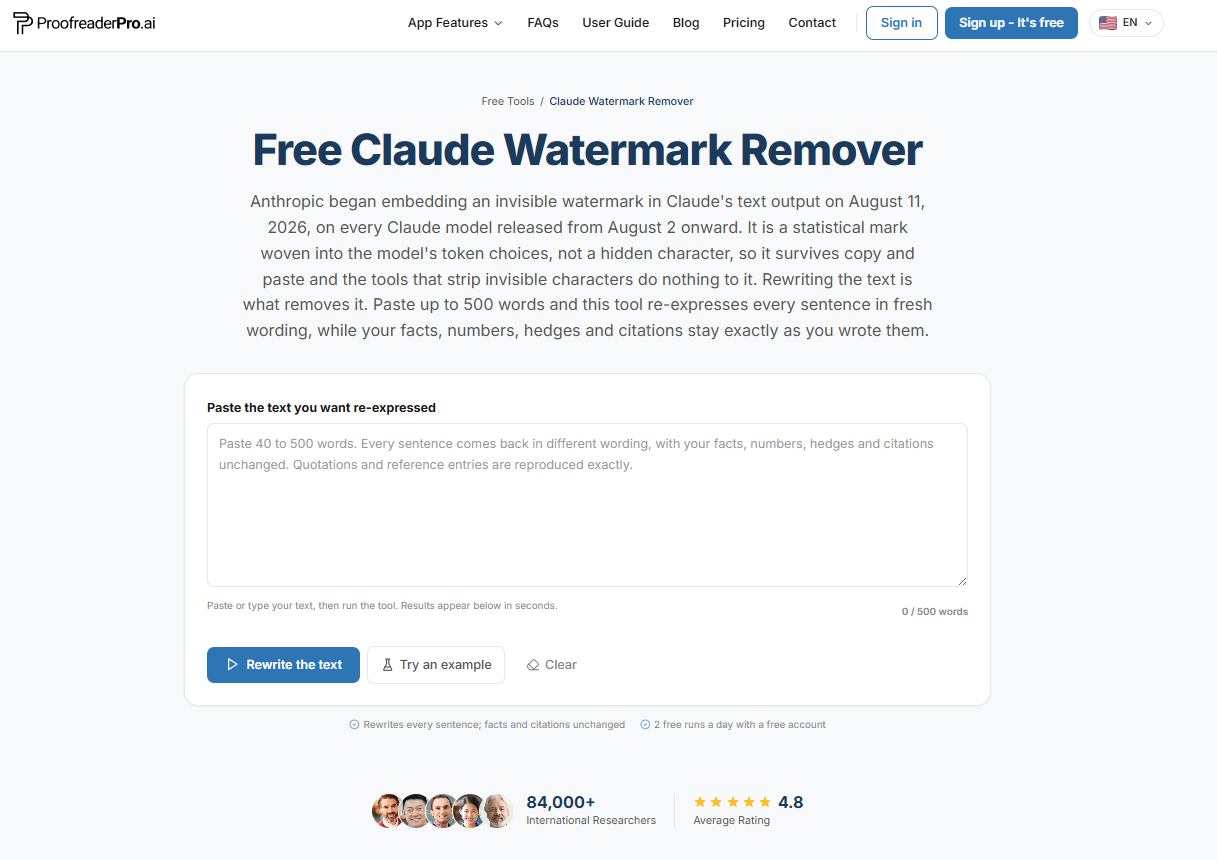
Переписывание это единственная операция, которая удаляет статистический маркер, и именно это делает этот инструмент, предложение за предложением.
Куда идти дальше
Присмотритесь к трем вещам до 2027 года. Во-первых, возьмет ли OpenAI текстGrain за пределами ЕС. Оно стартовало там, потому что в ЕС для соблюдения требований статьи 50 нужны машиночитаемые маркеры в текстах ИИ. Во-вторых, сойдутся ли детекторы. Если все крупнейшие лаборатории будут ставить водяные знаки по опубликованной схеме, университеты смогут проверять ключи вместо догадок по стилю письма, что улучшит сегодняшнее Насколько точны AI-детекторы в 2026 году? Проверенная точность и ложные срабатывания. В-третьих, станут ли маркеры совместимыми. Сегодня три лаборатории используют три разных маркера, и ни одна единая проверка не покрывает их все. C2PA закрывает этот пробел для файлов, но пока ничто не закрывает его для исходного текста.
Поставляет ли ChatGPT водяной знак на своем тексте?
Да, частично, начиная с 5 октября 2026 года. OpenAI начала добавлять свой водяной знак текстом textGrain к подходящим текстам ChatGPT и Codex в Европейском союзе, а клиенты API где угодно могут включить эту функцию. Водяной знак это статистический сигнал в выборе слов, без скрытых символов. OpenAI также применяет C2PA к данным происхождения к медиафайлам DALL-E и Sora. Это отдельная система на уровне файла.
Поставляет ли Google Gemini водяной знак на своем тексте?
Да. Вывод Gemini несет водяной знак SynthID-Text от Google DeepMind с октября 2024 года. Это статистический маркер в выборе слов, невидимый для читателей и проверяемый через SynthID Detector от Google. Он применяется только к собственным моделям Google, поэтому отрицательный результат SynthID ничего не говорит о тексте от других систем ИИ.
Поставляет ли Claude водяной знак на своем тексте?
Да. Каждая модель Claude, запущенная 2 августа 2026 года или позже, встраивает статистический водяной знак в вывод своего текста, на каждой платформе и по каждому тарифу, без возможности отключения. Кроме того, файлы, созданные Claude, дополнительно несут метаданные C2PA. Модели, запущенные до этой даты, пока не маркируют свой вывод. Anthropic говорит, что добавляет поддержку маркировки для них в течение переходного периода. Полные детали изложены в нашем материале-объяснителе про водяные знаки Claude.
Могут ли университеты обнаруживать водяные знаки ИИ?
Только при сотрудничестве с вендором, потому что для детектирования нужен ключ вендора. Google предлагает публичный портал детектирования для контента SynthID. Anthropic заявляет, что поддержка детектирования для пользователей и сторонних организаций запланирована, но пока не выпустила публичный детектор. Ни один распространенный антиплагиатный пакет сейчас не может верифицировать статистические водяные знаки из какой-либо лаборатории, поэтому сегодняшнее институциональное «детектирование ИИ» по-прежнему означает догадки на основе стиля, а не проверку водяных знаков.
Обязательна ли маркировка водяными знаками ИИ по закону?
В ЕС да, по сути. Статья 50(2) закона об ИИ ЕС (EU AI Act) требует от провайдеров генеративного ИИ обеспечивать, чтобы результаты были помечены в машинно-читаемом формате и распознавались как искусственно сгенерированные, при этом обязательства по прозрачности применяются с 2 августа 2026 года. Anthropic подписала соответствующий Кодекс практик и выбрала глобальное соблюдение. Как регуляторы будут относиться к невыпущенной разметке источника текста у OpenAI, это вопрос, за которым стоит следить в 2027 году.
Сохраняются ли AI-водяные знаки при переводе?
Нет. Статистический водяной знак живет в точной последовательности слов, которую выбрала модель, а перевод заменяет каждое слово. То же самое верно для глубокого перефразирования и интенсивного ручного редактирования. Это ограничение зафиксировано в рецензируемой научной литературе и признается каждым вендором, который выпускает водяной знак.
Есть ли публичная проверка водяного знака OpenAI для текста?
Нет, публичный инструмент верификации OpenAI проверяет только изображения и аудиофайлы, а также метаданные C2PA и водяные знаки SynthID. OpenAI утверждает, что не поддерживает текст. Его детектор текстового водяного знака доступен только утвержденным исследователям и экспертным организациям, в каждом случае отдельно.
Что такое textGrain?
textGrain это текстовый водяной знак OpenAI, объявленный 5 октября 2026 года. Он добавляет невидимый статистический сигнал к выбору слов моделью, поэтому метка является частью самих слов, без скрытых символов и метаданных файла. OpenAI заявляет, что он совпал или превзошел другие протестированные методы, включая SynthID для текста, и что редактирование ослабляет этот эффект.
Могут ли исследователи подать заявку на доступ к детектору текстового водяного знака OpenAI?
Да, утвержденные исследователи и экспертные организации могут подать заявку через форму OpenAI для Content Provenance API. OpenAI предоставляет доступ в каждом конкретном случае в рамках ЕС Кодекса практик. Компания говорит, что будет возвращаться к вопросу более широкого доступа по мере развития технологии и доказательной базы.
Источники
- Anthropic, Как работает текстовый водяной знак у Claude, август 2026
- Anthropic Help Center, Как Claude помечает контент, сгенерированный AI, 2026
- OpenAI, Понимание источника того, что мы видим и слышим в интернете, май 2024
- Google DeepMind, SynthID
- Dathathri и др., Масштабируемое водяное маркирование для идентификации выходных данных больших языковых моделей, Nature, октябрь 2024
- Google, Объявление о детекторе SynthID, май 2025
- Hugging Face, Introducing SynthID Text, октябрь 2024
- Kirchenbauer и др., Водяной знак для больших языковых моделей, ICML 2023
- Krishna и др., Перефразирование обходит детекторы текста, сгенерированного ИИ, NeurIPS 2023
- Scott Aaronson, Моя лекция по AI Safety для UT Effective Altruism, ноябрь 2022
- Европейский союз, AI Act, статья 50
- C2PA, Коалиция за достоверность и происхождение контента
Дана — создатель контента в ProofreaderPro, где она ведет ежедневный блог и пишет статьи. Она пишет статьи о том, как работает платформа онлайн-редактирования, и ежедневно обрабатывает сообщения клиентов, что подтверждается пятизвездочным рейтингом удовлетворенности.