OpenAI Watermark, SynthID és Claude: szövegbélyegzők összehasonlítása
Az OpenAI vízjelez a szövegében, van nyilvános OpenAI-bélyegző-ellenőrző, és miben különbözik a SynthID valamint a Claude vízjelezése az akadémiai szerzők számára?
Az OpenAI, a Google és az Anthropic mind ugyanazt a technológiát építette be: egy statisztikai bélyegzést az AI által generált szöveghez. Az OpenAI évekig visszatartotta a saját verzióját, majd 2026 októberében, textGrain néven kezdte el fokozatosan bevezetni. A Google a SynthID-et beépítette a Gemini rendszerbe, és közzétette a módszert. Az Anthropic 2026 augusztusban minden felhasználó számára kötelezővé tette a Claude-bélyegzést. Ha bármilyen formában AI segítséggel írsz, mindhárom döntés ma már meghatározza, hogyan ítélik meg a dokumentumaidat.
A bélyegzés a kutatási témából 2026. augusztus 11-én került a szélesebb nyilvánosság elé, amikor az Anthropic bejelentette, hogy minden új Claude-modell jelöli a szövegkimenetét. Az erről szóló bejelentést részletesen lefedtük a Az Anthropic Claude vízjele, magyarázat (2026) cikkünkben. Ez az útmutató teljes képet ad: mi az a szövegbélyegző, a három nagy laboratórium hogyan valósította meg vagy miért nem alkalmazta, és az egyes rendszerek mit bizonyítanak egy-egy írásról.
Mi az AI szövegbélyegző?
Az AI szövegbélyegző egy generált szöveg szóválasztásában rejtett statisztikai minta, amely a generálás pillanatában kerül beültetésre, hogy a megfelelő kulccsal rendelkező detektor később ellenőrizni tudja, hogy a szöveg egy adott AI rendszerből származik. Nem látható felirat, nem rejtett karakter, és nem a fájlhoz csatolt metaadat. A jelölés magukban a szavakban él.
Ez a különbség azért fontos, mert a „watermark” kifejezést laza módon három különböző dologra használják:
| Mi az | Hol található | Túléli a másolást beillesztést? | |
|---|---|---|---|
| Statisztikai szövegbélyegző | Egy torzítás, amelyben a modell a szavakat kiválasztja | Magában a szövegben | Igen |
| Fájlinformáció, C2PA | Aláírt eredetiség-jelző | A fájltároló (konténer) | Nem, a sima szövegű másolás kiveszi |
| Zéró szélességű karakterek | Láthatatlan Unicode került a szövegbe | A látható karakterek között | Nem, egyszerűen eltávolítható |
A statisztikai watermarking az egyetlen a három közül, amely túléli a másolást, beillesztést, új dokumentumba történő újratipizálást, valamint a formátumkonverziót. Ezért a három nagy labor mind erre futott rá szöveg esetén, és ezért a "watermark eltávolítók", amelyek a láthatatlan karaktereket lecsupaszítják, ezzel szemben nem érnek semmit. A ingyenes Claude watermark eltávolító oldalunk dokumentálja ezt a hibamódot forrásokkal.
Hogyan működik valójában a statisztikai watermarking?
A mondat megírásának minden egyes lépésében egy nyelvi modell több, egymáshoz nagyon hasonló szó közül választ, és a watermark halkan betölti azokat a kockadobásokat. Az alapreceptet Kirchenbauer és munkatársai, a Maryland Egyetemen, 2023 januárjában tették közzé az A watermark nagy nyelvi modellekhez című (ICML 2023) műben. Így működik:
- Mielőtt minden szó kiválasztásra kerülne, a megelőző szavakból származó titkos kulcs kettéválasztja a szókincset egy preferált halmazra és egy semleges halmazra.
- A modell a választását a preferált halmaz felé tereli. "Suggest" helyett "indicate". "Across" helyett "among". Minden egyes különálló választás teljesen természetesnek tűnik.
- A kulcsot ismerő detektor megszámolja, milyen gyakran landol a szöveg a preferált halmazokban. Az emberi írás várhatóan véletlen alapján adja ezt az arányt. A watermarkelt szöveg viszont messze túl gyakran, és egy statisztikai teszt jelzi a különbséget.
Egyetlen szó önmagában nem bizonyít semmit. A jelzés csak tucatnyi vagy akár száznyi választás során bontakozik ki, ezért könnyebb tesztelni hosszabb szövegrészeket, mint rövideket, és ezért a detektálás mindig valószínűségi, nem pedig egy igen vagy nem jellegű bélyeg.
A Google DeepMind gyártási rendszere, amelyet 2024 októberében a Nature folyóiratban tettek közzé, Skálázható watermarking a nagy nyelvi modellek kimeneteinek azonosításához, ezt egy tournament samplingnek nevezett technikával tovább finomította. Ennek köszönhetően a szövegminőség annyira jól megőrződik, hogy akár egy fogyasztói termékben, nagy léptékben, észrevétlenül fusson. Ez a tanulmány Google-on túl is számít: ez az a publikált alap, amelyre az Anthropic hivatkozik Claude-jának megvalósításához.
A fő gyengeséget a legtöbb bevezetés előtt publikálták. 2023 márciusában Krishna és munkatársai a A parafrázisok kikerülik a mesterséges intelligencia által generált szövegek detektorait (NeurIPS 2023) tanulmányban megmutatták, hogy egy szövegrész megfogalmazásának újragenerálása módszertől függetlenül összeomlasztja a detektálást, a watermarkinget is beleértve. A jel csak az adott token-szekvenciában él, máshol sehol, ezért minden olyan dolog, ami újraírással megváltoztatja a szekvenciát, legyen az emberi szerkesztés is, az bizonyítékot is átírja, illetve eltünteti. Minden olyan szállító, amely ma watermarkinget szállít, a saját dokumentációjában külön jelzi ezt a korlátozást.
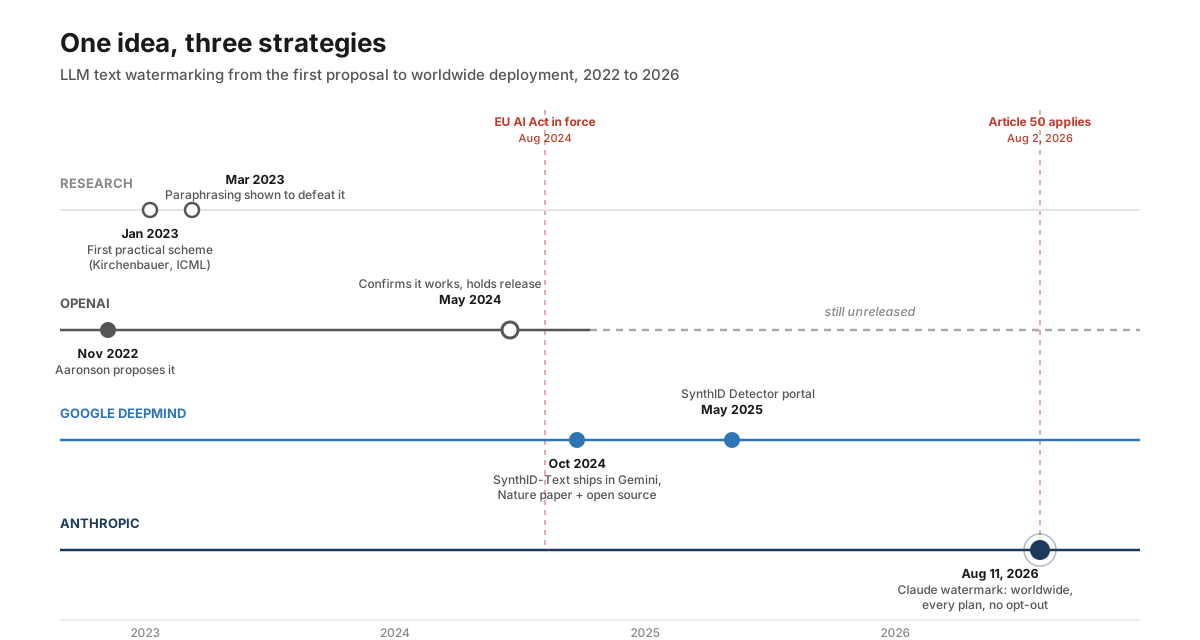
OpenAI: a cég, amely kitalálta, és a legkésőbb szállította
Az OpenAI-nál éveken át működött a szöveg watermark, mégsem adták ki. 2026 októberéig várt. Scott Aaronson, aki akkoriban az OpenAI-nál a biztonságon dolgozott, először 2022 novemberében ismertette a nyilvánosság előtt az ötletet egy November 2022 lecture előadásban. A módszer elfogultságot visz be a modell szóválasztásaiban a nagyon hasonló szavak között egy titkos kriptográfiai függvénnyel, ezért maga a szöveg megmutatja, honnan származik. Ez az előadás régebbi, mint bármelyik bevezetett rendszer.
2024 májusában az OpenAI a származási jelentésében ismertette a projekt állapotát, az online látott és hallott forrásának megértése. A vállalat szerint a szöveg „watermark” (szövegazonosító jel) módszere pontos és hatékony volt kisebb módosítások esetén, ugyanakkor a kiadást visszatartotta, miközben mérlegelte a lehetséges kompromisszumokat. Az OpenAI által megnevezett kockázatok közül kettő közvetlenül érinti a tanulmányírókat:
- Könnyű kijátszás. A szöveg átfogalmazása vagy lefordítása eltávolítja a jelölést, pontosan úgy, ahogy a 2023-as kutatás előre jelezte. Egy olyan watermark, amely többnyire azokat fogja meg, akik nem tudnak a létezéséről, gyenge érvényesítési eszköz.
- Aránytalan hatás a nem anyanyelvi angol beszélőkre. Az OpenAI szerint a watermark megbélyegezheti azokat, akik jogosan használják a mesterséges intelligenciát írássegítőként, különösen azoknál, akik második nyelven írnak. A miért jelzik az AI-detektorok a nem anyanyelvi írókat című írásunk ugyanerről a problémáról szól a detektor oldaláról.
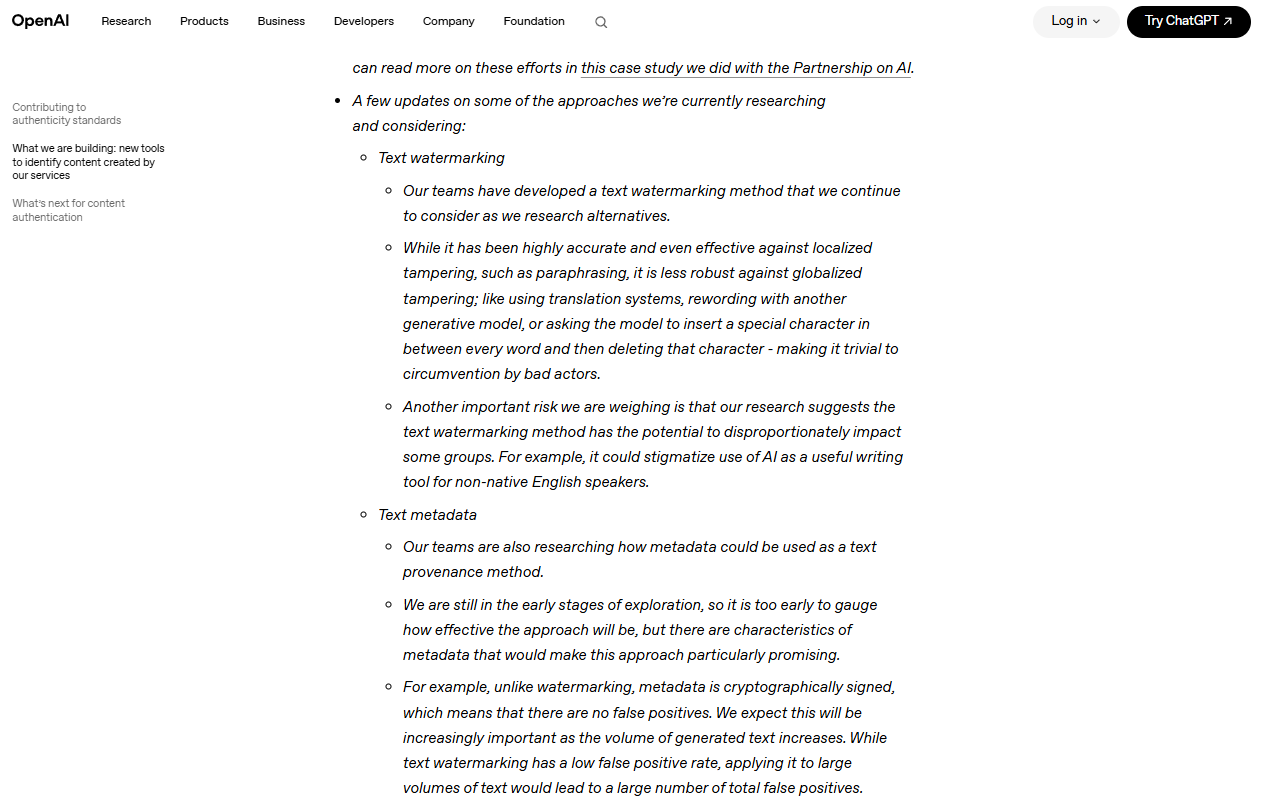
Az OpenAI 2024-es származási frissítése: a módszer működik, és a vállalat felsorolja, miért tartotta vissza akkoriban.
A képek és a hang esetében az OpenAI más megoldást választott: a DALL-E és a Sora kimeneteiben a C2PA származási metaadatai, vagyis fájlszintű jelölés, nem pedig a tartalomban elhelyezett jel. Szöveg esetén a ChatGPT kimenetének nem volt watermarkje 2026 októberéig. A technológiát javasoló vállalat volt a három közül az utolsó, amely bevezette azt.
Most az OpenAI watermarkolja a szöveget?
Igen, az OpenAI 2026. október 5-én kezdett el bizonyos szövegeket watermarkolni, válaszul az EU AI Act-re. Az bejelentése bemutat egy szöveg watermarkot, a textGrain-t, amely láthatatlan statisztikai jelet ad a modell szóválasztásához. A bevezetésnek három része van, és a watermark nem alapértelmezett mindenhol:
- Bárhonnan elérhető API-ügyfelek bizonyos modellek esetében bekapcsolhatják a watermarkolt kimenetet. Alapértelmezés szerint ki van kapcsolva.
- A következő hetekben az Európai Unióban az arra jogosult ChatGPT és Codex szöveges kimenetek megkapják a watermarkot, minden csomagban.
- Jóváhagyott kutatók és szakmai szervezetek pályázhatnak hozzáférésre a szöveg watermark detektorához.
Az OpenAI szerint a textGrain megfelelt vagy túlszárnyalta a többi általa tesztelt módszert, beleértve a Google SynthID-ját szöveghez. Emellett azt is közzétette, hol gyengül a detektálás. 1% hamis pozitív aránynál a detektor körülbelül 200 szavas (token) részleteknél mintegy 80%-ban, és körülbelül 400 tokenes részleteknél mintegy 95%-ban azonosította a watermarkot pszichológiai tartalomban. A matematika esetében a detektálás sokkal alacsonyabb volt, ahol kevesebb a szabadság a szóválasztásban.
A szerkesztés gyorsan gyengíti a jelet. 400 tokenes részletekben a szavak 10%-ának szinonimákkal való cseréje a detektálást körülbelül 92%-ról 66%-ra csökkentette, a 25%-os csere pedig 17%-ra vitte le.
Az OpenAI azt is ellenőrizte, hogy a watermark változtat-e a válaszminőségen az Astra nevű legújabb modelljénél, és azt mondja, hogy nem látott érdemi különbséget. Íme négy a közzétett benchmarkok közül:
| Benchmark | Watermark nélkül (Astra) | Watermarkkal (Astra) |
|---|---|---|
| Artificial Analysis Intelligence Index | 49.57 pont | 49.76 pont |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
A hallgatók számára számít a dátum. A ChatGPT által a bevezetés előtt írt szöveg, illetve az EU-n kívül, ahol az API beállítás nincs bekapcsolva, nem tartalmaz OpenAI watermarkot. A Turnitin Clarity magyarázva bemutatója segít abban, hogyan alakítják ki az iskolák saját AI-használati szabályzataikat addig is.
Van nyilvános OpenAI watermark-ellenőrző?
Jelenleg még nincs nyilvános OpenAI szöveg-ellenőrző az AI-val készült tartalmakhoz. Az OpenAI ingyenes verifikációs eszköze a C2PA Content Credentials adatokat, valamint a SynthID watermarkot ellenőrzi képfájlokban és hangfájlokban, amelyeket az OpenAI a támogatott képekbe és hanganyagokba ágyaz be. Az OpenAI szerint az eszköz nem támogatja a szöveget.
Szöveghez az OpenAI eseti alapon, jóváhagyott kutatók és szakmai szervezetek számára ad hozzáférést, az Content Provenance API űrlapon keresztül. Azt is közli, hogy az indításkor nem teszi nyilvánossá a szövegdetektort a kihagyott watermarkok és a téves pozitív találatok kockázata miatt. A detektor jelzi, hogy talál-e OpenAI watermarkot, és nem azonosítja a felhasználót, illetve nem mutatja meg az adott személy kéréseit (promptjait).
| Mit szeretnél ellenőrizni | Eszköz | Ki használhatja |
|---|---|---|
| Egy OpenAI kép- vagy hangfájl | Az OpenAI verifikációs eszköze | Mindenki, ingyenes |
| OpenAI szövegkimenet (textGrain) | OpenAI szöveg watermark detektor | Jóváhagyott kutatók és szakmai szervezetek, jelentkezés alapján |
| Claude szövegkimenet | Claude Watermark Detector | Jogosult szervezetek, jelentkezés alapján (lásd a Claude watermark útmutatónkat) |
Az OpenAI azt is egyértelműen megfogalmazza, hogy egy eredmény mit nem tud megmondani. A detektált watermark nem méri azt, hogy egy személy mennyiben járult hozzá, és nem azonosítja, ki írta vagy használta a szöveget. A hiányzó watermark sem bizonyítja önmagában, hogy a szöveget ember írta, mert a szöveg túl rövid lehet, szerkeszthetik, lefordíthatják, vagy származhat nem támogatott modelltől.
Google: először érkezett, majd kiadták a receptet
A Google DeepMind először szállította le, teljesen publikálta, majd később megnyitotta a módszert. A rendszere, a SynthID, 2023-ban kép-watermarkolásként indult, majd 2024-ben bővült szöveggel. Mire a Nature tanulmány 2024 októberében megjelent, a SynthID-Text már termelésben futott a Gemini szolgáltatásban, ami az első olyan statisztikai szöveg watermark, amelyet fogyasztói szinten telepítettek.
A SynthID lefedi a szöveget, a képeket, a hangot és a videót, és 2024 októbere óta él a Gemini szövegkimenetében.
A Google ezt követően a nyílt forráskódú megoldásként a Hugging Face-en is publikálta, így bármely fejlesztő ugyanazt a watermarkolási sémát alkalmazhatja a saját modelljein. 2025 májusában bejelentette a SynthID Detector, egy hitelesítési portált, ahol a tartalom ellenőrizhető SynthID-jelölések szempontjából szövegben, képekben, hangokban és videókban.
Egy lényeges korlát számít: a SynthID csak jelöl, és csak a Google saját modelljeiből származó tartalmat észlel. Nem mond semmit a ChatGPT vagy a Claude kimenetéről, és egy tiszta SynthID-ellenőrzés nem jelenti azt, hogy a szöveg ember által írt. Ez azt jelenti, hogy a Google modelljei nem írták azt, ami sokkal szűkebb állítás.
Anthropic: a legkésőbb vált, a legszigorúbb szabályzattal
Az Anthropic a legkésőbb állt át, és a legszélesebb kötelező lefedettséget vezette be. Minden, 2026. augusztus 2-án vagy azt követően indított Claude modell statisztikai watermarkot ágyaz be a szövegkimenetébe, világszerte, minden csomagban, és nincs leiratkozási lehetőség. A vállalat a működés mechanizmusát a magyarázó anyagában ismerteti, Hogyan működik Claude szöveg watermarkja, a szabályzat hatókörét pedig a súgócikkében, Hogyan jelöli a Claude az AI-generált tartalmakat. A Claude API, a claude.ai, a Claude Code, a Claude Cowork és a Claude Tag mind bele tartozik. A határidő előtt bevezetett modellek átmeneti időszakban vannak, és az Anthropic szerint ezekhez is hozzáadja a jelöléstámogatást. A statisztikai jelölés mellett a Claude által generált fájlok C2PA metaadatokat is hordoznak, egy második, különálló rendszert, amely a sima szöveg másolás során kiiktatódik.
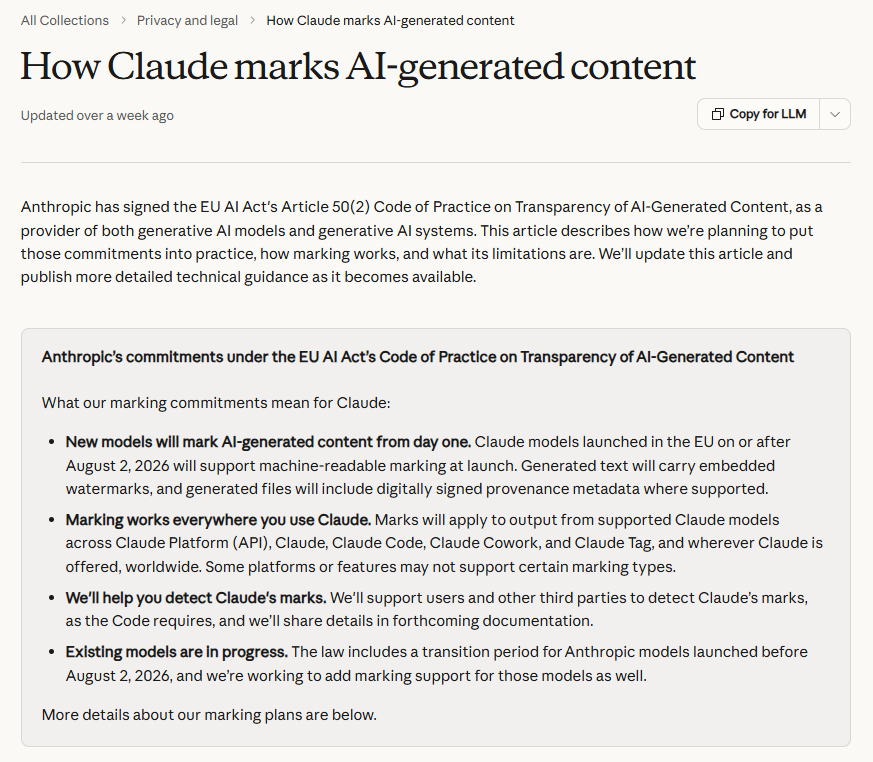
Az irányelv Anthropic saját megfogalmazásában: minden új modell, minden platform, világszerte, miközben a régebbi modellek fokozatosan kerülnek be.
Az Anthropic dokumentációja ezt egyértelműen leírja. A detektálás valószínűségi. A jelölés nem képes megkülönböztetni, hogy egy dokumentumot a Claude írt, vagy hogy egy ember írta, és a Claude csak enyhén szerkesztette. A teljes újrafogalmazás eltávolítja a jelölést. Végigvettük mindezt, beleértve azt is, mit bizonyít valójában a pozitív detektálás, és mit tegyél, ha a saját írásodat jelölik, a dedikált Claude watermark útmutatóban.
Az ütemezés a szabályozást követi. Az Anthropic aláírta az EU AI Act keretében az Article 50(2) Szabályzatot a mesterséges intelligenciával előállított tartalom átláthatóságáról, amely megköveteli a generatív AI rendszerek szolgáltatóitól, hogy az outputokat "gép által olvasható formátumban jelöljék, és mesterségesen előállítottként detektálhatók legyenek". Ezek az átláthatósági kötelezettségek 2026. augusztus 2-ától váltak alkalmazandóvá: ez az Anthropic modellpolitikájában szereplő pontos határidő, kilenc nappal a nyilvános bejelentés előtt. Az Anthropic a globális megfelelést választotta, ahelyett hogy az EU-s forgalomra külön viselkedést tartson fenn. A Google már eleve megfelelt a tervezésből adódóan. Az OpenAI jelöletlen szövegkimenete jelenti a nyitott megfelelőségi kérdést 2027-re.
A három megközelítés egymás mellett
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| Szöveg watermark bevezetve? | Igen (textGrain, EU bevezetés 2026. október 5-től) | Igen (Gemini, 2024. októbertől) | Igen (Claude modellek 2026. augusztus 2-tól) |
| Technika | textGrain, statisztikai jel a szóválasztásban | SynthID-Text tournament mintavételezés | Statisztikai mintavételes jelölés, SynthID-szerű megközelítés |
| Kiterjedés | Jogosult ChatGPT és Codex szöveg az EU-ban; API-ben világszerte bekapcsolható (opt-in) | Csak Google modellek | Minden új Claude modell; az idősebb modellek átmenetben |
| Kikapcsolás (opt-out) | Alapértelmezetten ki az API-ben | Nem | Nem |
| Nyilvános detektor | Nem | SynthID Detector portál (2025) | Tervezett, még nem jelent meg |
| Közzétették a sémát? | Csak koncepcióelőadások | Nature-cikk + nyílt forráskód | Magyarázat publikált munkák alapján |
| Fájlmetadaták (C2PA) | Igen, képek és hang | Igen, több médiumban | Igen, generált fájlokon is |
| Kinyilvánított korlátok | Megkerülés, ESL-bélyeg | A saját modellekre korlátozva | Valószínűségi: a szerkesztések elmoshatják a szerzőséget |
A mintázat az oszlopok között: az OpenAI a szöveg vízjelezését nyitott szakpolitikai problémaként kezeli, a Google infrastruktúraként, amelyet egységesíteni kell, az Anthropic pedig a megfelelési kötelezettségként, amit teljes körűen meg kell valósítani.
Mit jelent ez a kutatók és az akadémiai szerzők számára
A gyakorlati következmények attól függenek, hogy mely eszközök érnek a szöveghez. Ha ma ChatGPT-vel készítesz vázlatot, a szövegeden nincs vízjel. Ha ma Gemini-vel készítesz vázlatot, a szövegeden van egy SynthID-jel, amit csak a Google detektora tud olvasni. Ha pedig egy jelenlegi Claude-modellel írsz vagy szerkesztesz, azon az Anthropic-jel szerepel, és nincs olyan beállítás, ami ezt ki tudná kapcsolni.
Három dolgot, amit az akadémiai szerzőknek érdemes tudni:
A vízjel egy eszközt azonosít, nem a szerzőt. Minden szolgáltató ezt leírja a saját dokumentációjában, és érdemes ezt ismételni, mert az intézményi irányelvek nem mindig teszik meg a különbséget. A szöveg jelölhető azért, mert egy AI írta, mert egy AI két mondatot copy-edite-olt, vagy mert egy jelölt bekezdést idéztek. Ha az intézményed vízjel-ellenőrzéseket futtat, amit az ellenőrzés bizonyít, az az, hogy egy adott modell valamikor kapcsolatba került a szöveggel, ennyivel többet nem. Az útmutatónk a hamis AI észlelési jelzés elleni fellebbezésről bemutatja, hogyan kell ezt az érvet előadni, amikor számít.
A vízjelek és az AI detektorok különböző technológiák, különböző hibamódokkal. Olyan detektorok, mint a Turnitin vagy a GPTZero statisztikai stílus alapján tippelnek, a dokumentált pontossági problémáinkkal. A vízjel detektálása kulcs-alapú teszt, amelynél nagyon alacsony a hamis pozitív arány a jelöletlen humán szöveg esetén. A felcserélődés a hamis negatívoknál történik: a vízjel-ellenőrzés minden olyan AI-szöveget kihagy, amely nem vízjelező modellekből származik, és amelyek ma a ChatGPT-t is magukban foglalják.
A nyilvánosságra hozás marad a legerősebb pozíció. A vízjelezés a rejtett AI-használatot kockázatosabbá teszi, a nyilvánosságra hozott AI-használatot viszont biztonságosabbá, mert a bejelentett munkafolyamatnak nincs mitől tartania a pozitív jelöléstől. A legtöbb folyóirat és egyetem ma már rendelkezik kifejezett AI-használati irányelvekkel; az AI-használati irányelvünk elmagyarázza, hogyan húzzuk meg a határvonalakat a saját eszközeinknél, és ez jó mintának számít ahhoz, hogyan néz ki az átlátható felhasználás.
Mi távolít el egy szöveg vízjelet, és mi nem
Az átírás eltávolítja; az újraformázás nem. A másolás, beillesztés, betűtípus-váltás, fájlformátumok közötti átalakítás és a láthatatlan karakterek eltávolítása mind teljes egészében érintetlenül hagyja a statisztikai vízjelet, mert a jel a szóválasztásban van. Amit eltávolít, az minden olyan folyamat, ami újragenerálja a megfogalmazást: egy mélyreható humán szerkesztés, egy fordítás vagy egy valódi parafrázis, amit a NeurIPS 2023 robusztusságot vizsgáló kutatás is igazolt még azelőtt, hogy ezek a rendszerek elindultak volna.
Mindkét irány számít. A jel eltűnése nem jelenti azt, hogy a szöveg a tiéd, és a jel fennmaradása sem jelenti azt, hogy a szöveg nem a tiéd. Egy újraírt, AI-val készült vázlat még mindig olyan, AI-val támogatott dokumentum, amelyre az intézményed nyilvánosságra hozatali szabályai vonatkoznak. Az AI text humanizer az AI-val támogatott vázlatokat természetes tudományos nyelvezetre írja át, és mivel ez a folyamat újragenerálja a jeltokensorozatot, az értekezési statisztikai jelek nem maradnak meg benne. Kifejezetten Claude szövegnél a claude vízjel eltávolító minden egyes mondatot új megfogalmazásban fejez ki úgy, hogy a tények, számok és hivatkozások változatlanok maradnak. Amit egyetlen eszköz sem képes megváltoztatni, az az, amivel a te olvasódnak tartozol: átláthatóság arról, hogyan készült a dokumentum.
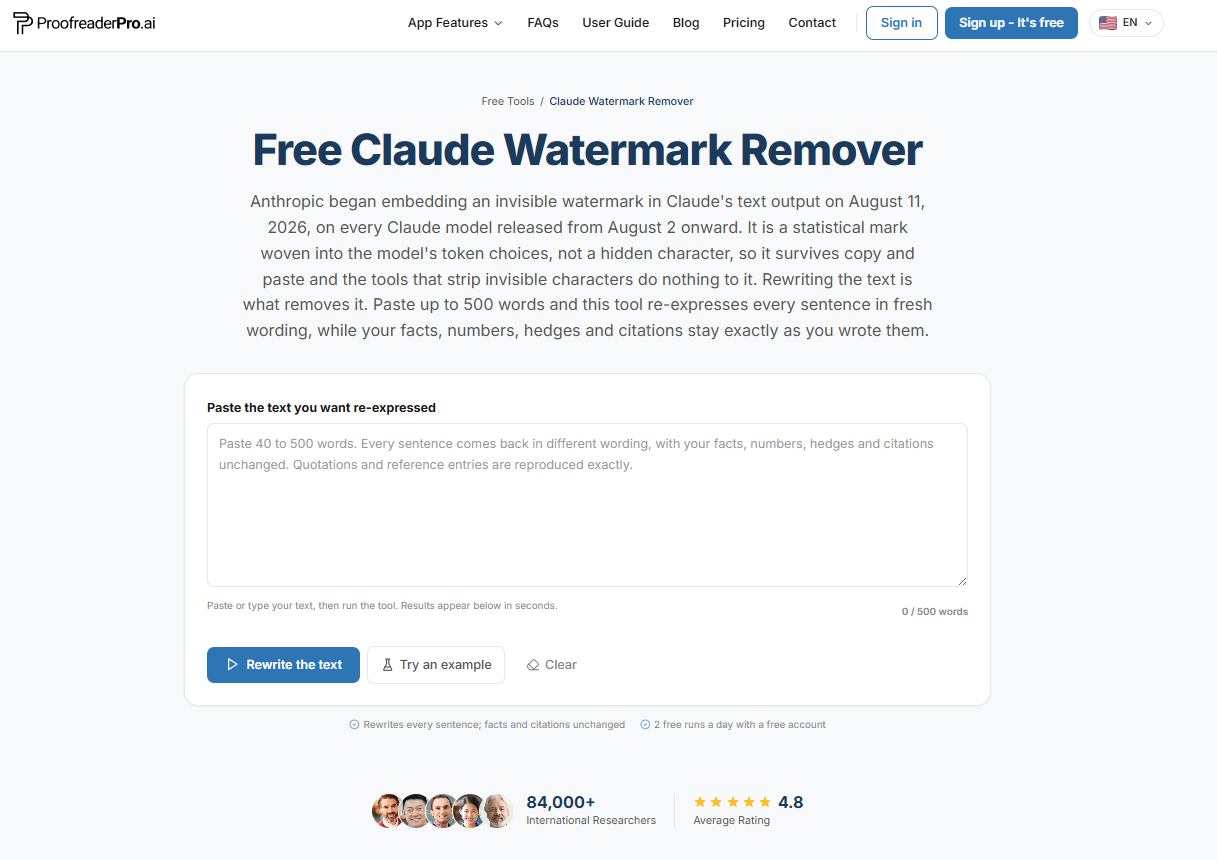
Az újraírás az az egyetlen művelet, amely eltávolítja a statisztikai jelet, és pontosan ezt csinál ez az eszköz, mondatról mondatra.
Hová megy innen
Figyeld három dolgot 2027-ig. Először azt, hogy az OpenAI a textGrain-t túljuttatja-e az EU-n: onnan indult, mert az EU 50. cikke géppel olvasható jeleket követel meg az AI-szövegeken. Másodszor azt, hogy a detektorok konvergálnak-e. Ha minden nagy labor közzétett rendszer szerint vízjelez, az egyetemek a kulcsokat ellenőrizhetik, nem pedig a megírási stílus alapján találgatnának, ami javítana a mai, hamis riasztásokra hajlamos detektáláson. Harmadszor azt, hogy a jelek kompatibilissé válnak-e. Ma három labor három különböző jelet használ, és egyetlen ellenőrzés sem fedi le mindet. A C2PA fájloknál betölti ezt a hiányt, nyers szövegnél viszont még nem töltötte be.
A ChatGPT vízjelezi a szövegét?
Igen, részben, 2026. október 5. óta. Az OpenAI elkezdte az its textGrain vízjelének hozzáadását az arra jogosult ChatGPT- és Codex-szövegekhez az Európai Unióban, és az API ügyfelei bárhol bekapcsolhatják. A vízjel statisztikai jel a szóválasztásban, nincsenek benne rejtett karakterek. Az OpenAI a C2PA eredetiségre vonatkozó metaadatokat alkalmazza a DALL-E és a Sora médiatartalmaira is, ez azonban egy külön, fájl-szintű rendszer.
A Google Gemini vízjelezi a szövegét?
Igen. A Gemini kimenet 2024 októbere óta viseli a Google DeepMind SynthID-Text vízjelét. Ez a szóválasztásban található statisztikai jel, az olvasók számára láthatatlan, és a Google SynthID Detector segítségével ellenőrizhető. Kizárólag a Google saját modelljeire vonatkozik, ezért egy negatív SynthID-eredmény nem mond semmit más AI-rendszerek szövegéről.
A Claude vízjelezi a szövegét?
Igen. Minden, 2026. augusztus 2-án vagy azt követően indított Claude modell statisztikai vízjelet ágyaz be a szövegkimenetébe, minden platformon és csomagban, opt-out nélkül, és a Claude által generált fájlok emellett C2PA metaadatokat is hordoznak. Az ezen időpont előtt indított modellek még nem jelölik a kimenetüket; az Anthropic szerint átmeneti időszakban hozzáadja a jelölési támogatást ezekhez. A teljes részletek a Claude watermark magyarázónkban találhatók.
Az egyetemek képesek észlelni az AI-vízjeleket?
Csak a gyártó együttműködésével, mert az észleléshez a gyártó kulcsa szükséges. A Google kínál egy nyilvános detektáló portált a SynthID-tartalomhoz. Az Anthropic azt mondja, hogy tervezik a felhasználók és harmadik felek számára az észlelési támogatást, de még nem adták ki nyilvános detektorként. Egyetlen mainstream plágiumellenőrző csomag sem tud jelenleg statisztikai vízjeleket bármely labortól megerősíteni, így az intézményi „AI-detektálás” ma még mindig stílus-alapú találgatást jelent, nem pedig vízjel-ellenőrzést.
Az AI-vízjelezést jogszabály írja elő?
Az EU-ban igen, lényegében. Az EU AI Act 50(2). cikke előírja, hogy a generatív MI szolgáltatóknak biztosítaniuk kell, hogy a kimenetek géppel olvasható formátumban legyenek megjelölve, és mesterségesen generáltként felismerhetők legyenek, továbbá az átláthatósági kötelezettségek 2026. augusztus 2-tól alkalmazandók. Az Anthropic aláírta a kapcsolódó Magatartási Kódexet, és a világszintű megfelelőséget választotta. A kérdés, amit 2027-ben érdemes figyelni, az, hogyan kezelik a szabályozók az OpenAI még ki nem adott szöveg watermark-jét.
Túléli az AI watermark a fordítást?
Nem. A statisztikai watermark abban a pontos szósorrendben él, amelyet a modell választott, a fordítás pedig minden szót lecserél. Ugyanez igaz a mély parafrázisokra és az erőteljes, emberi szerkesztésre is. Ezt a korlátot a lektorált szakirodalom dokumentálja, és minden olyan vállalat elismeri, amely watermarkot bevezető megoldást szállít.
Van nyilvános OpenAI watermark-ellenőrző szöveghez?
Nem. Az OpenAI nyilvános ellenőrző eszköze csak kép- és hangfájlokat vizsgál, C2PA metaadatok és SynthID watermark-ek esetén. Az OpenAI azt mondja, hogy nem támogat szöveget. A szöveg watermark detektora csak jóváhagyott kutatóknak és szakmai szervezeteknek hozzáférhető, esetről esetre.
Mi a textGrain?
A textGrain az OpenAI szöveg watermark-ja, amelyet 2026. október 5-én jelentettek be. Láthatatlan statisztikai jelet ad a modell szavakra vonatkozó választásaihoz, így a jel a szavak része, nincs rejtett karakter, és nincs fájlmetaadat. Az OpenAI szerint az általa tesztelt többi módszert elérte vagy túlszárnyalta, beleértve a szöveghez tartozó SynthID-t is, és azt is, hogy a szerkesztés gyengíti azt.
A kutatók jelentkezhetnek hozzáférésre az OpenAI szöveg watermark detektáló eszközéhez?
Igen. Jóváhagyott kutatók és szakmai szervezetek az OpenAI Content Provenance API űrlapján keresztül igényelhetnek hozzáférést. Az OpenAI az EU-s Magatartási Kódex keretében esetről esetre ad hozzáférést. Azt is jelzi, hogy a technológia és a bizonyítékok fejlődésével felülvizsgálja a szélesebb körű hozzáférést.
Források
- Anthropic, Hogyan működik Claude szöveg watermark-ja, 2026
- Anthropic Help Center, Hogyan jelöli a Claude az AI által generált tartalmat, 2026
- OpenAI, A forrás megértése, amit online látunk és hallunk, 2024 május
- Google DeepMind, SynthID
- Dathathri és mtsai., Skálázható watermarking a nagy nyelvi modellek kimeneteinek azonosításához, Nature, 2024 október
- Google, SynthID Detektor bejelentés, 2025 május
- Hugging Face, A SynthID Text bemutatása, 2024 október
- Kirchenbauer és mtsai., Watermark egy nagy nyelvi modellekhez, ICML 2023
- Krishna és mtsai., Parafrázisok kijátsszák az AI által generált szöveg detektorait, NeurIPS 2023
- Scott Aaronson, AI Safety előadásom az UT-n és a hatékony altruizmushoz kapcsolódóan, 2022 november
- Európai Unió, AI Act, 50. cikk
- C2PA, a Content Provenance és Hitelesség Koalíciója
Dana a ProofreaderPro tartalomkészítője, ahol napi blogot vezet és írási műveleteket végez. Ő írja a cikkeket az online szerkesztőplatform működéséről, és minden nap kezeli az ügyfelek üzeneteit, amiről ötcsillagos elégedettségi pontszámot tudhat.