AI-szövegemberesítő indiai kutatóknak, akik angolul írnak
AI-szövegemberesítő indiai kutatóknak. Csökkentse a hindi-hatású angol szövegekben a téves AI-észlelési jelzéseket, őrizze meg a jelentést és a hivatkozásokat, és nyilatkozzon őszintén.

India évente több mint 278 000, Scopus által indexelt cikket publikál, amivel a világ harmadik legnagyobb kutatási nemzete Kína és az Egyesült Államok mögött. A PhD-képzésbe való beiratkozás 81%-kal ugrott 2015 és 2022 között, az UGC 2025-ös tervezet rendeletei pedig a publikálást az ösztönzött kategóriából a kari toborzás és előléptetés szempontjából jogilag kötelezővé tették. Soha ennyi indiai kutató nem ír nemzetközi folyóiratokba.
Sokan közülük ma már mesterséges intelligencia támogatásával készítik el a szöveget, majd beadás előtt futtatják az eredményt egy AI-ellenőrzésen. Itt jön képbe az indiai kutatóknak szánt AI-szövegemberesítő, mert ezen az ellenőrzésen egy konkrét probléma gyakran előjön: a gondos, korrekt, második nyelvű angolt a rendszer gép által generált szövegként félreolvassa.
A nem anyanyelvi angol beszélők már eleve körülbelül 2,5-szer magasabb elutasítási aránnyal szembesülnek, mint a natív beszélők. Ha pedig egy AI-érzékelő erre rátesz egy téves jelzést, egy ember által írt módszertani szakaszt indoklás nélkül gyanúsnak lehet tekinteni pusztán azért, mert egy második nyelvű szerző másképp fogalmaz. Ez a útmutató elmagyarázza, miért történik ez indiai kutatóknál, és hogyan kezelheti ezt egyszerűen.
एआई ह्यूमनाइज़र भारतीय शोधकर्ताओं को अंग्रेज़ी में प्रकाशित करने में मदद करता है
Az “हमारे एआई ह्यूमनाइज़र”ünk (AI humanizer) segít az indiai kutatóknak angolul publikálni úgy, hogy a gondos írásukat ne tévesszék össze AI-kimenettel. A saját, AI-támogatással készült vázlatán dolgozik, megőrzi a jelentést, a terminológiát és a hivatkozásokat, miközben variálja azt a ritmust és szóválaszt, amelyeket a detektorok tipikusan megpróbálnak megjelölni.
60-nál több nyelvet támogat. Ha először átgondolja az érvelést hindi, tamil, bengáli, telugu vagy marathi nyelven, akkor a nyelvérzékeny text humanizer megőrzi a mondatszerkezetét és a jelentést is, amikor átáll az akadémiai angolra.
Hindi nyelven ír? A rendszer azt is felismeri, és emberivé teszi
Sok indiai kutató gondolkodás és vázlatkészítés közben hindi nyelven (majd angolra váltva) dolgozik, a szövegemberesítő pedig pontosan erre az esetre készült. Illesszen be egy hindi nyelvű részletet, a ProofreaderPro automatikusan felismeri a devanagari írásrendszert, majd egy nyelvérzékeny modell segítségével feldolgozza úgy a szövegét, hogy az pontosan úgy maradjon, ahogy Ön megírta, beleértve a szöveget, a terminológiát és a hivatkozásokat is. A “एआई ह्यूमनाइज़र” a hindi vázlatán ugyanolyan természetesen működik, mint az angolon, így nincs szükség arra, hogy a szöveget először lefordítsa. Az automatikus felismerés több mint hatvan nyelvre terjed ki, és minden nyelvet a maga saját hangján emberiesít.
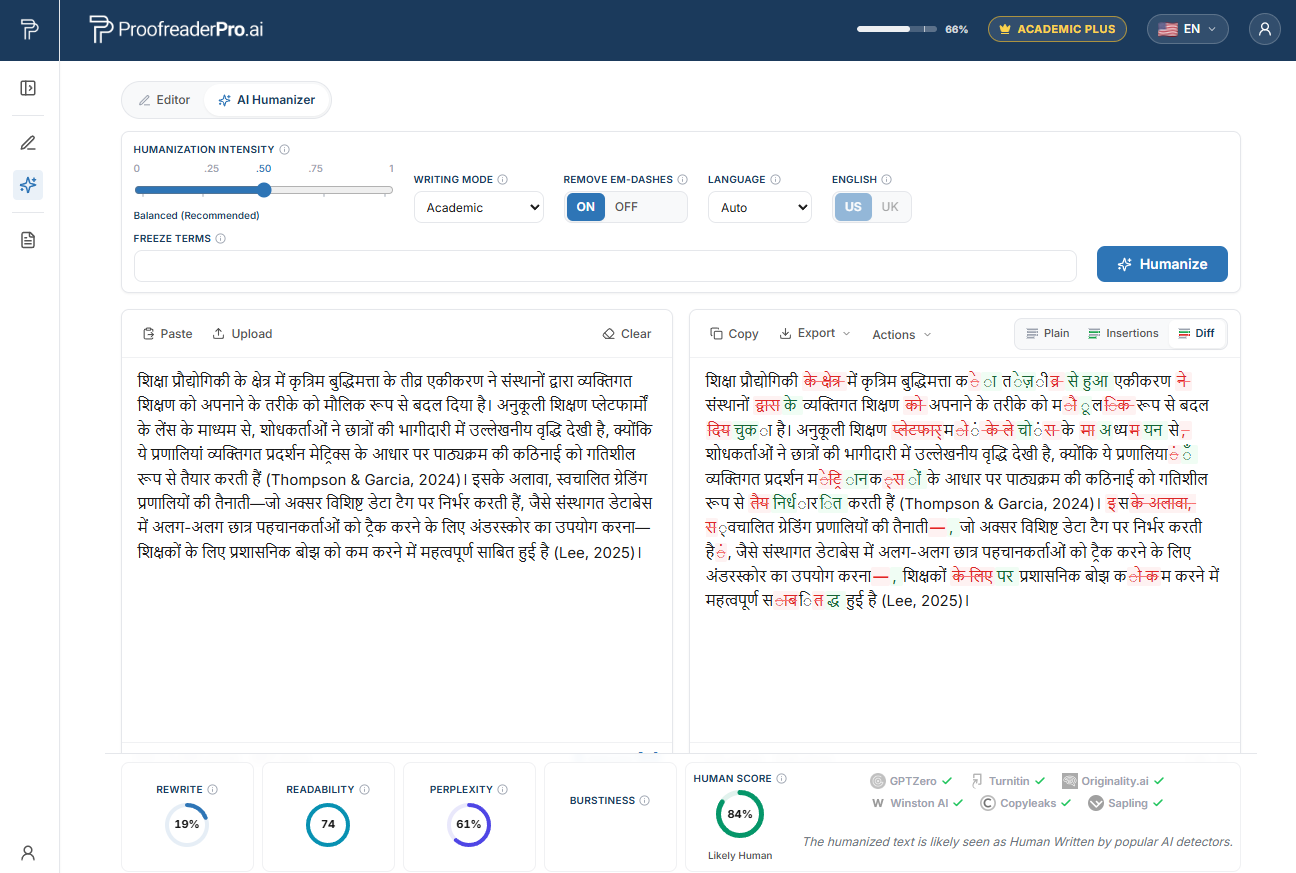
- A ProofreaderPro AI Humanizer a hindi akadémiai szöveget alakítja át. A before és after diff megőrzi a jelentést és a hivatkozásokat, a detektor-ellenőrzések pedig azt igazolják, hogy a szöveg természetes, emberi olvasatú.*
Miért jelölik tévesen az AI-detektorok az indiai kutatók szövegeit
2023-ban egy Liang és munkatársai által vezetett stanfordi csapat a Cell Press folyóiratban, a Patterns-ben megjelentetett egy tanulmányt “GPT detectors are biased against non-native English writers.” címmel. Ember által írt TOEFL-esszéket futtattak át hét, széles körben használt detektoron. Átlagosan a nem anyanyelvi esszék körülbelül 61%-át jelölték AI-ként, szemben a natív angol írók kb. 5%-ával. A nem anyanyelvi esszék csaknem egyötöde (körülbelül 19,8%) pedig minden detektoron egyhangúan tévesztve lett megjelölve. Minden esszét ember írt.
A mechanizmus a perplexitás. Sok detektor azt pontozza, hogy egy nyelvi modell számára mennyire “meglepő” minden egyes szóválasztás. A gondos, második nyelvű írók gyakori szavakat és standard, kiszámítható megfogalmazást használnak, ami alacsony perplexitást eredményez, ez pedig gépszövegként olvasható. Azok a szokások, amelyek a nem anyanyelvi akadémiai prózát érthetővé és korrekté teszik, pontosan azok a minták, amelyeket ezek az eszközök a jelölésre betanultak. Részletesen kitérünk erre itt: why AI detectors flag non-native writers.
A hindi és a regionális nyelvek mintái, amelyek téves jelzésekhez vezetnek
Az indiai akadémiai angolban rendszerszintű hatás jelenik meg a hindi, a tamil, a bengáli, a telugu, a marathi és más első nyelvek irányából. Ezek nem hanyag hibák. Hanem azok a kiszámítható, standardizált módok, amelyekkel a gondos szerzők kompenzálják az első nyelvük és az angol közötti távolságot, és az a kiszámíthatóság az, amit a perplexitáson alapuló detektorok magas AI-pontszámmal jutalmaznak.
Articles. Sok indiai nyelvben nincs határozott/határozatlan névelő rendszer, ezért a “the” versus “a” versus névelő nélküli különbség hindi nyelvben nem létezik. Azok az írók, akik megtanították magukat arra, hogy ne felejtsenek el névelőket elhagyni, gyakran túlkorrigálnak, és olyan nagyon szabályos, tankönyvszerű megfogalmazásokba csúsznak, mint például: “The experiment was conducted using a modified protocol.” Korrekt, standard és alacsony perplexitás.
Prepositions. Olyan minták, mint a “discuss about”, a “comprises of” és az “interested on”, közvetlenül hindi mintára kerülnek át. Amikor ezeket a standard angol formára szerkesztik át, a mondat minden alkalommal a detektor számára a leggyakoribb, legkiszámíthatóbb prepozícióra “landol” pont arra, amit a rendszer egy modellnél vár.
Szórend és egyeztetés. A hindi alany–tárgy–ige (subject-object-verb) sorrendet követ. Az indiai kutatók, amikor hosszabb angol mondatokat építenek, gyakran átrendezik őket a legbiztonságosabb, legkonvencionálisabb alany–ige–tárgy (subject-verb-object) szerkezetre, hogy biztosan helyesek maradjanak. A biztonságos és konvencionális megfogalmazás pedig ugyancsak alacsony perplexitásként olvasható.
Időviszonyok következetessége. Az angol igeidőjelölők rugalmatlanabbak, mint a legtöbb indiai nyelvben, így a gondos szerzők a módszertani szakaszt egységes múlt időbe “zárják”. Egységes, szabályos és kiszámítható, újra.
Mondathossz. Az indiai akadémiai próza gyakran hosszabb, bonyolult szerkezetű mondatok felé hajlik. Ha ezeket a folyóirati elvárásokhoz igazítják, sokszor rövidebb, egyenletes, hasonlóan formált mondatokra esnek szét, amelyeket a detektor gépszerű ritmusként érzékel.
India AI-észlelési és Turnitin-fókuszú környezete
Indiában a szakdolgozatokat és a folyóiratbeküldéseket gyakran Turnitin vagy iThenticate segítségével szűrik át mind hasonlósági, mind AI-indikátorok alapján. A legtöbb egyetem kötelező plágiumszűrést futtat, mielőtt a szakdolgozatot elfogadnák, és sokan már ugyanazon a riporton megnézik az AI-írás jelzőjét is. Az UGC iránymutatása az akadémiai integritásról a hasonlósági szűrést a kutatások értékelésének megszokott részévé tette.
Fontos pontosan tisztázni, mit csinálnak ezek az eszközök valójában. A Turnitin maga az AI-pontszámokat a 1–19% tartományban elnyomja: csillag jelzést tesz ki, nem számot, és figyelmeztet, hogy a pontszámot önmagában nem szabad az integritási döntés alapjaként használni. Több külföldi intézmény, köztük a Vanderbilt, még tovább is ment: 2023-ban letiltotta a Turnitin AI-detektorát a téves pozitív találatok és a nem anyanyelvi írókkal szembeni torzítás miatt. A Michigan State, az UT Austin, a Northwestern, a Pittsburgh, az SMU és a Waterloo is hasonló lépéseket tett. Egy detektor-pontszám vitatható állítás, nem ítélet.
Ezzel párhuzamosan azonban a finanszírozók és a folyóiratok egyre gyakrabban kérik a szerzőket, hogy hozzák nyilvánosságra, hogyan használtak AI-t. Az indiai kutató számára ésszerű álláspont nem az, hogy elrejtse az AI-használatot. A feladat az, hogy gondosan írjon és szerkesszen, védje meg ezt a gondos írást a téves jelzéstől, majd pedig pontosan tegye közzé, mit tett.
Védje meg gondosan megírt angolját a téves AI-jelzéstől
Tegye emberibbé a saját, AI-támogatott vázlatát, őrizze meg a jelentést és a hivatkozásokat, majd közölje. Indiai kutatóknak készült, Scopus és Web of Science folyóiratokhoz írt cikkekhez.
Próbálja ki a Humanizer ingyenes verziójátLegfontosabb indiai egyetemek és ahol megjelennek az AI-ellenőrzések
India kutatási kibocsátása elit intézmények hálózatában koncentrálódik, és mindegyikük még a munka továbblépése előtt hasonlósági és AI-ellenőrzést végez a szakdolgozatokon és kéziratokon.
- IISc Bengaluru (भारतीय विज्ञान संस्थान): India legmagasabban rangsorolt kutatóintézménye (NIRF 2025: 1. hely), legerősebb a természettudományok fizikai területein, a mérnöki és a biológiai tudományokban.
- IIT Madras, IIT Delhi, IIT Bombay, IIT Kharagpur, és IIT Kanpur (भारतीय प्रौद्योगिकी संस्थान): az eredeti öt IIT, folyamatosan az első tíz között van a mérnöki, a számítástechnikai és az anyagtudományi kutatások terén.
- IIT Roorkee, IIT Guwahati és IIT Hyderabad: újabb IIT-k gyorsan növekvő kutatási profillal a mérnöki és az alkalmazott tudományok területén.
- AIIMS New Delhi (अखिल भारतीय आयुर्विज्ञान संस्थान): India vezető orvosi kutatóintézménye, biomedicinális és klinikai munkákat publikál nagy hatású folyóiratokban.
- Jawaharlal Nehru University (जवाहरलाल नेहरू विश्वविद्यालय): az egyetemi kategóriában a NIRF 2025-ös rangsor 2. helye, legerősebb a társadalomtudományokban és a bölcsészettudományokban.
- University of Delhi (दिल्ली विश्वविद्यालय): India egyik legnagyobb kutatóegyeteme, széles körű lefedettséggel a természettudományok és a bölcsészet területén.
- Banaras Hindu University (काशी हिन्दू विश्वविद्यालय): jelentős kibocsátás a természettudományok, a mérnöki tudományok és az ájurvédikus orvoslás területén.
- Jadavpur University: erős mérnöki és tudományos kutatás, folyamatosan az első tíz között rangsorolt indiai egyetem.
- Homi Bhabha National Institute: nukleáris tudomány, fizika és mérnöki tudományok, a BARC-hoz és más DAE intézményekhez kapcsolódva.
Ezen intézmények mindegyike megköveteli, hogy a kutatók angol nyelvű nemzetközi folyóiratokban publikáljanak karrierépítés céljából, és mindegyikük futtatja az AI- és hasonlósági ellenőrzéseket, amelyekbe a téves jelzés beleakadhat.
Hogyan működik az AI-szövegemberesítő indiai kutatóknak
Az indiai kutatóknak szánt AI-szövegemberesítő egyetlen munkafolyamatra épül, nem rövidítésre. Íme az általunk ajánlott sorrend.
Először: vázlatkészítés. Ha segít, írja meg azt a nyelven, amelyben gondolkodik, hindi, tamil vagy bengáli, majd fordítsa le angolra, vagy készítsen angol nyelvű vázlatot AI-támogatással. Másodszor: lektorálja a nyelvtant, hogy a névelők, prepozíciók és igeidők helyesek legyenek. Harmadszor: futtassa az eredményt a text humanizer segítségével, hogy az Ön gondosan, standardizált prózája természetes variációt kapjon a ritmusban és a szóválasztásban, így kisebb eséllyel olvassa félre a detektor gépi kimenetként. A jelentése, a technikai terminológiája és a hivatkozásai pontosan ott maradnak, ahova Ön helyezte.
A szövegemberesítőnk az AI-szöveget természetesebb, emberi formára alakítja át, ami csökkenti az AI-jelet, és javítja az esélyeit a nehéz detektorok ellen (a nyelvtani pontosság magas marad az akadémiai szövegben). Ez tesztelésen alapul, nem garancián. A detektorok néhány havonta újratanulnak, ezért azt írjuk le, mit tett az eszköz, soha nem ígérjük, hogy bármely szöveg véglegesen undetektálható, és soha nem kezeljük ezt a folyamatot a szűrés megkerülésének módjaként.
Ezután: nyilatkozzon. Adjon hozzá egy AI-használatra vonatkozó nyilatkozatot abban a formátumban, amelyet az intézménye és a célfolyóirata megkövetel. A gondos írás, megóvva a téves jelzéstől, majd egyértelmű közzététel, így marad az integritási szabályokon belül. Ez ugyanaz az elv, mint a academic editing guide for researchers in India útmutatónkban, és szerves része a szélesebb multilingual AI humanizer hub központunknak.
Helyi finanszírozó szervek, folyóiratok és az AI-közzététel elvárásai
A DST-SERB, a CSIR, az ICMR vagy a DBT által támogatott kutatóknak a támogatási programjaik teljesítéseként nemzetközi folyóiratokban kell publikálniuk, és a nyelvi szerkesztés a legtöbb ilyen szervezetnél elismert, megengedett költségnek számít. Ez azért fontos, mert azt jelenti, hogy egy lektorálási és emberiesítési eszköz használata egy AI-támogatott vázlaton legitim kutatási költség, nem kerülő megoldás.
Indiai kutatók mind nemzetközi, mind hazai folyóiratokban publikálnak. Több jelentős indiai kiadvány a publikálásra kész angolt várja el, és egyre gyakrabban kérdez rá az AI-használatra a beadáskor:
- Current Science: India legrégebbi több tudományterületet lefedő folyóirata, amelyet C.V. Raman alapított 1932-ben.
- Indian Journal of Medical Research (IJMR): nyílt hozzáférésű, az ICMR adja ki, kizárólag angol nyelven, és az egyik legnagyobb hatású indiai folyóirat.
- Pramana (Journal of Physics): Indian Academy of Sciences, a Springerrel közösen publikálják.
- Economic & Political Weekly (EPW): a vezető társadalomtudományi folyóirat, Scopus által indexelt.
- Journal of Biosciences és Journal of Earth System Science: mindkettő az Indian Academy of Sciences kiadásában.
- Sadhana: az Indian Academy of Sciences mérnöki tudományai, Q1 és Q2 kategóriákba sorolva.
- The National Medical Journal of India: lektorált klinikai és orvosi kutatás.
Az Indian Academy of Sciences összes folyóirata angol nyelvű kéziratokat követel. Bármelyik folyóirathoz is nyújt be, a legbiztonságosabb szokás az, hogy az AI-használatát a folyóirat által kért formátumban közzétegye, és tartson egy rövid, privát megjegyzést arról, mit tett, arra az esetre, ha valaha fellebbezni kellene egy téves jelzés miatt.
Gyakran ismételt kérdések
K: Indiai kutatóknak szánt AI-szövegemberesítő használata csalásnak számít?
Nem. A helyes felhasználás az, hogy a saját AI-támogatott vázlatát emberiesítse, a jelentését és a hivatkozásait érintetlenül hagyja, majd az AI-használatot a szükséges intézményi és folyóirati formátumban közzétegye. Ön a gondos, ember által végzett kutatást védi a téves jelzéstől, nem pedig kitalált munkát vagy mások írását leplezi.
K: A szövegemberesítő garantálja, hogy a cikkem átmegy a Turnitin AI-detektorán?
Nem. Egyetlen eszköz sem tud ilyet garantálni, és minden olyan eszköz, amely ezt ígéri, félrevezeti Önt. A főbb detektorokkal végzett tesztelés alapján a szövegemberesítőnk az AI-szöveget természetesebb, emberi formára írja át, ami csökkenti az AI-jelet, és javítja az esélyeit a nehéz detektorok ellen. Ráadásul a detektorok folyamatosan újratanulnak, ezért az eredmény nem végleges. A tesztelés során látottakat jelentjük, és soha nem állítjuk, hogy a szöveg véglegesen nem detektálható.
K: Működik hindi, tamil, bengáli és más indiai nyelveknél is?
Igen. A szövegemberesítő 60-nál több nyelvet támogat. Készíthet vázlatot azon a nyelven, amelyben gondolkodik, majd átállhat az akadémiai angolra, és egy nyelvérzékeny modell megőrzi a mondatszerkezetét és a jelentést. Kezeli azokat az angol interferenciamintákat is, amelyek gyakoriak a hindi, tamil, bengáli, telugu, marathi és más első nyelvek esetében.
K: Fizethetek érte a DST-SERB vagy CSIR támogatásomból?
A nyelvi szerkesztés a legtöbb indiai finanszírozó szervnél elismert, megengedett költség, beleértve a DST-SERB-et, a CSIR-t, az ICMR-t és a DBT-t is. A szerkesztő és humanizáló szoftverek előfizetései jellemzően beleférnek a megengedett kutatási költségekbe. A biztos döntéshez ellenőrizze a saját támogatásának konkrét feltételeit.
K: Mi történik a hivatkozásaimmal és a technikai kifejezésekkel?
Ezek pontosan ott maradnak, ahova Ön helyezte. A szövegemberesítő variálja a ritmust és a szóválaszt, és eltávolítja a repetitív fordulatszerűséget, de megőrzi a jelentését, a technikai terminológiáját és minden hivatkozást. A beadás előtt Ön ellenőrzi az eredményt.
Őrizze meg a jelentést, a terminológiát és a hivatkozásokat. Változtassa a ritmust, amelyet a detektorok jelöl. Indiai kutatóknak készült, angolul mint második vagy harmadik nyelven történő íráshoz.
Moe egy NLP mérnök PhD-vel a természetes nyelvi feldolgozásban. Kutatásai kiterjednek a számítógépes nyelvészetre, a szövegelemzésre és a gépi tanulásra, és közvetlenül beépültek a ProofreaderPro mögötti szerkesztési és humanizálási modellekbe. A folyamat azon részéről ír, amelyet a legtöbb ember soha nem lát: hogyan olvas fel egy nyelvi modell egy mondatot, pontozza azt, és hogyan dönti el, min változtasson.


