AI-szövegemberiesítő görög kutatóknak, akik angolul írnak
AI-szövegemberiesítő görög kutatóknak. Csökkentse a téves AI-észlelési riasztásokat a görög hatású angol szövegek esetében, őrizze meg a jelentést és a hivatkozásokat, és legyen őszinte a használatról.

Egy Athéni Nemzeti Műszaki Egyetemről származó fizikus az angol nyelvű módszertani szakaszát írja: minden cikket és minden igeidőt kétszer ellenőriz, majd egy Scopus által indexelt folyóiratnak küldi be. Hetekkel később egy társszerző továbbít egy szerkesztői megjegyzést: egy automatizált AI-detektor a kézirat egy részét gép által írtként azonosította. Ő minden egyes mondatot maga írt.
A fenti helyzet mára elég gyakori ahhoz, hogy befolyásolja, mennyire óvatosnak érzik magukat a kutatók már a benyújtás előtt. Az AI-szövegemberiesítő görög kutatóknak arra szolgál, hogy kezelje ezt, és az ok, amiért erre szükség van, többet elárul a detektorokról, mint magáról az írásról.
A görög kutatás erős a mérnöki tudományokban, a számítástechnikában, a fizikában, az orvostudományban és a klasszikus tudományokban; ennek jelentős része angolul jut el a világhoz, miközben a gondolkodás és az első vázlat görögül készül. A Web of Science és Scopus szerinti publikációk előrehaladást és egységek szerinti értékelést hoznak, ezért a tiszta, gördülékeny angol publikálásra nehezedő nyomás nem csillapodik. A csapda az, hogy a jól formált, standard másodiknyelvi angol pont azoknak a segédeszközöknek az egyik leggyakoribb tévesztési célpontja.
Humanising AI text for Greek researchers (εξανθρωπισμός κειμένου AI)
Az emberiesítőnk segíti a görög akadémikusokat abban, hogy angolul publikáljanak anélkül, hogy a gondosan, anyanyelv-hatás által formált prózát gépként tévesztenék. A saját, AI-val támogatott vázlatodon működik: megőrzi a jelentést és a hivatkozásokat, továbbá változtat azokon a ritmus- és szóválasztási elemen, amelyekre a detektorok rögzülnek. Bármely, tisztességtelenül megjelölt bekezdéssel kipróbálhatod a text humanizer eszközt.
Ez az útmutató egy nagyobb multilingual AI humanizer hub egyik csomópontja, amely ugyanazt a problémát járja körül több mint hatvan nyelven, mert a téves jelölés mintázata ott ismétlődik, ahol a kutatók másodiknyelvként írnak tudományos angolul.
Görög szöveget ír? A humanizer ezt is felismeri és feldolgozza
Nem minden vázlat indul angolul, és az emberiesítő sem igényli ezt. Illeszd be a görög szöveget, a ProofreaderPro pedig automatikusan felismeri a görög ábécét, majd egy nyelvérzékeny modelen keresztül irányítja, amely pontosan úgy hagyja meg a terminológiát, a ékezeteket és a hivatkozásokat, ahogy megadtad. Az εξανθρωπισμός κειμένου AI keretében a rendszer közvetlenül átírja a görög prózádat, így még fordítás előtt humanizálhatsz. Ugyanez a detektálás több mint hatvan nyelvre kiterjed: mindegyik nyelvet az adott nyelv sajátjaként írja át.
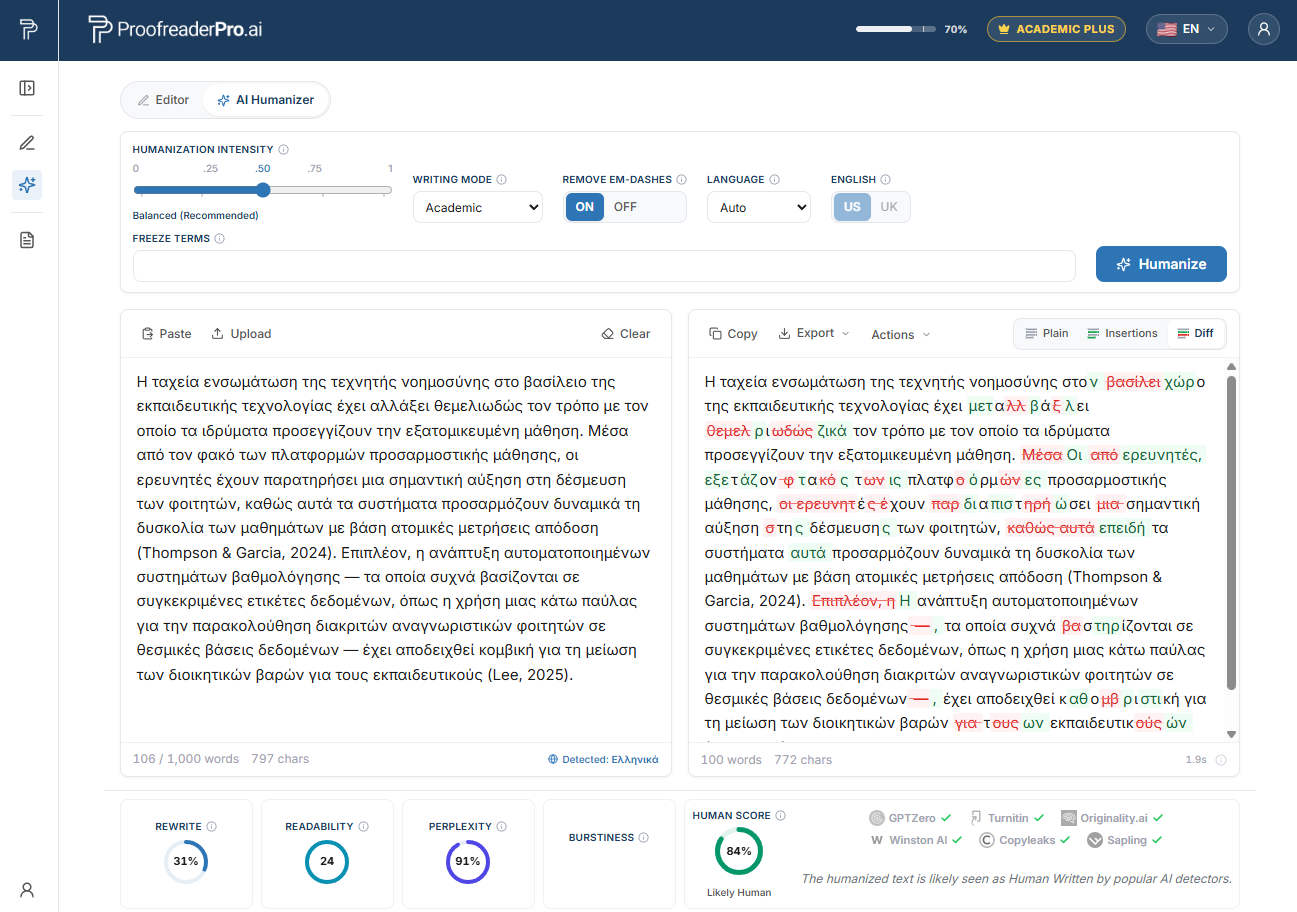
The ProofreaderPro AI Humanizer rewriting Greek academic text. A before and after diff megőrzi a jelentést és a hivatkozásokat, és a detektor-ellenőrzések megerősítik a természetes, emberi olvasatot.
Miért kapnak AI-észlelési jelölést a görög kutatók?
Kezdjük azzal a tanulmánnyal, amely számokkal mutatta be a problémát. 2023-ban egy Stanford-csoport, amelyet Weixin Liang vezetett, a Cell Press Patterns folyóiratban publikálta a következőt: "GPT detectors are biased against non-native English writers". A szerzők ember által írt TOEFL esszéket vettek, majd átfuttatták azokat hét, széles körben használt detektoron.
Az eredmény egyoldalú volt. Átlagosan a nem anyanyelvi írók esszéi közül körülbelül 61%-ot jelöltek AI-ként, míg az anyanyelvi angolos szerzőknél ez nagyjából 5% volt. A nem anyanyelvi esszék közül csaknem minden ötödik (körülbelül 19,8%) minden detektor által egyöntetűen kapott jelölést a vizsgált mintában. Mindegyik ilyen esszének volt emberi szerzője.
A mechanizmust perplexity-nek nevezik. Sok detektor úgy pontozza a következő szót, hogy azt méri, mennyire „meglepő” az az adott nyelvi modell számára; az olyan szöveg pedig, amely gyakori szavakból, kiszámítható sorrendben épül fel, alacsony perplexity-t kap. Az alacsony perplexity gépszerű szövegként olvasható. Egy gondos görög kutató, aki standard szókincset és biztonságos mondatsablonokat választ, pontosan azt a prózát állítja elő, amelyet a detektor arra tanított, hogy ne bízzon benne. A kudarc e típusába mélyebben belemegyünk itt: why AI detectors flag non-native writers.
A görög anyanyelvi mintázatok a téves jelölések mögött
Az alábbi szokások egyáltalán nem hibák. Helyesek, bevett, standard szerkezetek, és éppen ezért csökkentik a perplexity-t, és ezért rajzolnak riasztó jelölést.
Az egyik legkézenfekvőbb eset az article (névelő). A görög a határozott névelőt használja az absztrakt főneveknél, tulajdonneveknél és általánosító kifejezéseknél is, így az angolul író görög beszélő természetesen tölti meg a szöveget a „the” alak használatával: „the science shows”, „the Professor Papadopoulos argued”, „the nature of the problem”. Mindegyik kifejezés nyelvtanilag helyes, és ezek folyamatos felhalmozódása nagyon szabályos.
Az igeidő és az aspektus egy másik jelzést ad. A görög az aspektust olyan módon jelöli, ahogyan az angol nem, ezért a jelen perfect és a simple past közti választás, illetve a sima és a folyamatos alakok közti különbség beállhat egy bekezdésen belül egyenletesen és kiszámíthatóan. A detektor ezt az egyenletességet mintázatként értelmezi, nem pedig úgy, mint az egyes választásokkal rendelkező személy munkáját.
A mondathossz is számít. A görög tudományos stílus hosszú, nehéz kötőszókkal összefűzött mondatokat kedvel, ezért a „moreover”, „furthermore” és „in addition” egymásra rakódik az érvelés „illesztéseinél”. Ezek a kötőszavak ráadásul a modellek által nagy valószínűséggel várható következő szavak közé tartoznak, így a perplexity még tovább csökken.
Kettő további, átvételi hatás kerekíti ki a képet. A mondatrend olyan nyelvből kerül át, ahol a szórend szabadabb, így olyan topikalizált mondatok születnek, amelyek helyesek, de alakjukban egyformák. És amikor a névátírásoknál, a nevek és a szakkifejezések kilépnek a görög ábécéből, különféle átírási döntések születnek, ez is egy újabb szintű szabályosságot ad. Együttvéve ezek a jellemzők miatt a becsületes görög–angol szöveg, a detektor szemében, gyanúsan simává válik.
Greece's AI-detection and Turnitin context
A görög intézményekből érkező szakdolgozatokat és folyóirat-benyújtásokat rutinszerűen szűrik. A Turnitin vagy az iThenticate alapú hasonlóság-ellenőrzés a szakdolgozatoknál és kéziratoknál bevett gyakorlat, és ezek a platformok ma már az AI-írásra utaló jelzőket is megjelenítik a hasonlósági pontszám mellett.
Görögország-szerte az egyetemek saját generatív AI-irányelveket is kiadtak, és az irány a tiltás helyett a közzététel felé mutat. A támogatók és a folyóiratok egyre gyakrabban kérik a szerzőktől, hogy jelezzék, hol és hogyan használtak AI-eszközöket. Semmi sem jelenti azt, hogy az AI-segítség tilos lenne. A közzététel őszintesége lesz az elvárás, ami pedig egészen más, mint elrejteni.
Érdemes felidézni: egy detektor pontszáma nem ítélet. A Turnitin maga is elnyomja az alacsony AI-pontszámokat, és figyelmeztet, hogy a szám nem lehet önmagában az integritásról szóló döntés egyetlen alapja. Másutt több egyetem tovább is ment, és az AI-detektoraikat pontosan a fenti, dokumentált torzítás miatt kikapcsolták. A jelölés olyan állítás, amelyet vitathatsz, nem bizonyíték a bűnösségre.
Ne hagyja, hogy egy elfogult detektor szóljon a kutatásáért
Illesszen be egy jelölt bekezdést, és nézze meg, hogyan őrzi meg az emberibbé tétel a jelentést, a terminológiát és az idézeteket, miközben a ritmust a detektorok félreértéseinek irányába változtatja.
Próbálja ki a Humanizer ingyenes verziójátTop Greek universities and where AI checks appear
Az alábbi intézmények szakdolgozatokat és kéziratokat szűrnek hasonlóság és egyre inkább AI-jelzők szempontjából is. Ha bármelyiknél publikálsz vagy adsz be anyagot, számíts rá, hogy a dolgozatod vagy a benyújtásod ezen rendszerek valamelyikén keresztül megy.
- Εθνικό και Καποδιστριακό Πανεπιστήμιο Αθηνών (National and Kapodistrian University of Athens, NKUA), Athénben
- Αριστοτέλειο Πανεπιστήμιο Θεσσαλονίκης (Aristotle University of Thessaloniki, AUTH), Szalonikiben
- Εθνικό Μετσόβιο Πολυτεχνείο (National Technical University of Athens, NTUA), Athénben
- Πανεπιστήμιο Πατρών (University of Patras), Patrasban
- Πανεπιστήμιο Κρήτης (University of Crete), Heraklionban és Rethymnóban
- Πανεπιστήμιο Ιωαννίνων (University of Ioannina), Ioanninában
- Πανεπιστήμιο Θεσσαλίας (University of Thessaly), Volosban
- Οικονομικό Πανεπιστήμιο Αθηνών (Athens University of Economics and Business, AUEB), Athénben
- Δημοκρίτειο Πανεπιστήμιο Θράκης (Democritus University of Thrace), Komotiniben
A lista nem fedi le teljes egészében a görög felsőoktatást, de nagyjából ott mutatja be, hol történik a legtöbb angol nyelvű kutatási szöveg elkészítése, illetve ahol a legtöbb szűrés ténylegesen zajlik.
Hogyan működik az AI-szövegemberiesítő görög kutatóknak
A munkafolyamat őszinte és egyszerű, és bent tartja a szabályok keretei között.
Előkészítés: Először írj. Ha ott a legkifejezőbb a gondolkodásod, írj görögül, majd fordíts, vagy, ha így kényelmes, készíts vázlatot közvetlenül angolul a használni kívánt segítséggel. Mielőtt azon kezdenél aggódni, hogyan hangzik, tedd rendbe az érvelést és az evidenciát.
Következő lépés: helyesbítés a nyelvtan terén. Javítsd a névelő-túlhasználatot, rendezd az igeidőket, és ellenőrizd a terminológiát, hogy a jelentés pontosan az legyen, amit szánsz. A text humanizer nem kiváltja ezt a lépést, mert a tiszta bemenet jobb kimenetet eredményez.
Végül: humanizáld a saját, AI-val támogatott prózádat. Az eszköz változtat a mondatok ritmusán és a szóválasztáson, megtöri azt az egységes „dallamot”, amely alacsony perplexityként hat, és eltünteti a jellegzetes nyomokat is — például az ismétlődő kötőszókat és az eltévedt hosszú gondolatjeleket — miközben megőrzi a jelentést, a technikai terminológiát és valamennyi hivatkozást. A nem angol szöveg egy nyelvérzékeny modellre kerül, így a görög rész nem laposodik el, hanem megtartja a szerkezetét.
Mit állíthatunk őszintén az eredményekről? Saját tesztelésünkben azt láttuk, hogy az humanizálás lényegesen csökkenti, hányszor olvassák félre a gondos, standard nem anyanyelvi angolt a nagyobb detektorok, például a Turnitin, az Originality.ai és a GPTZero, miközben az akadémiai jelentés változatlan marad. Nem teszünk számot. A detektorok néhány hónaponként újratanulnak, és egyetlen őszinte eszköz sem ígérheti, hogy 100%-ban fel nem ismerhető. Aki garantálja ezt, az valamit próbál eladni neked.
A végén: tedd közzé. Jelezd az AI-használatot abban a formátumban, ahogy a témavezetőd, az intézményed és a megcélzott folyóirat kéri. Az emberiesítés megóvja a gondosan megírt szöveget a torzított jelöléstől; a közzététel pedig őszintén rögzíti, milyen segítséget használtál. A kettő együtt jár. Ha az emberiesítésen túl szerkesztési segítségre is szükséged van, a global academic editing hub egy helyen gyűjti össze a nyelvi támogatási erőforrásokat.
Helyi finanszírozási szervek, folyóiratok és az AI-közzététel elvárásai
A görögországi versenyképes kutatási pénz nagyrészt HFRI-n keresztül fut, vagyis a Hellenic Foundation for Research and Innovation (ΕΛΙΔΕΚ) finanszírozza a vizsgálatvezető-központú projekteket, míg a GSRI, a General Secretariat for Research and Innovation alakítja a nemzeti kutatási politikát. Sok görög csoport emellett European Research Council (ERC) támogatásokkal is rendelkezik. Mindegyiknek megvan a maga jelentéstételi kultúrája, és az AI-használat közzététele fokozatosan ennek részévé válik.
A publikálási oldalon a görög kutatók Web of Science és Scopus által indexelt folyóiratokat céloznak, a National Documentation Centre (EKT) pedig fenntartja a nemzeti repozitóriumokat és a kutatási statisztikákat. A legtöbb nemzetközi folyóirat ma már az AI-közzétételt is tartalmazza a szerzői irányelvekben. A biztonságos szokás az, hogy még benyújtás előtt elolvasod ezt a részt, és írsz egy rövid nyilatkozatot az eszközeidről, ahelyett hogy a folyamatodat hallgatólagosan feltételezésekből kellene rekonstruálni.
Tartsd szem előtt az érvelést. A saját vázlatod humanizálása nem kerül meg semmilyen fenti elvárást. Megvédi a tiszta görög–angol szöveget a dokumentált detektor-torzítástól, és a közzététel rendben tartja a nyilvántartást. Valódi munka, tisztességesen kezelve.
Gyakran ismételt kérdések
K: Segít-e egy AI-szövegemberiesítő, ha a dolgozatomat annak ellenére jelölték, hogy magam írtam?
Igen, pontosan ez az a helyzet, amire kifejlesztették. A gondosan megírt, nem anyanyelvi angol alacsony perplexity-t kap, és gépszerű szövegként félreolvassák; a humanizálás pedig variálja azt a ritmust és szóválasztást, ami kiváltja a jelölést, miközben a jelentést változatlanul hagyja. Nem tudja eltörölni azt a tényt, hogy a detektorok tökéletlenek, de eltávolítja azokat a konkrét jellemzőket, amelyeket túlzottan „túlsúlyoznak” a modelljeik.
K: Az AI-szöveg humanizálása megváltoztatja a hivatkozásaimat vagy a szakkifejezéseimet?
Nem. Az emberiesítő megőrzi a hivatkozásokat, az idézeteket és a szakterületi terminológiát, mert ezek megváltoztatása károsítaná a dolgozatot. A működés a ritmusra és a megfogalmazásra vonatkozik, nem pedig az evidenciádra vagy a szakmai szókincsedre.
K: A görög kutatóknak szánt AI-szövegemberiesítő használata csalásnak számít?
Nem, ha őszintén használod. Te humanizálod a saját, AI-val támogatott vázlatodat, megőrzöd a jelentést és a hivatkozásokat, majd közzéteszed az AI-használatot úgy, ahogy az intézményed és a folyóiratod megköveteli. A cél a tisztesség a valódi írásban, nem a gyártott munka leplezése.
K: Bármelyik eszköz garantálja, hogy a szövegem minden AI-detektort át fog menni?
Nem, és ne higgy annak, aki ezt állítja. A detektorok rendszeresen frissítik a modelljeiket, ezért egyetlen eszköz sem ígérheti, hogy 100%-ban fel nem ismerhető. Amit egy jó humanizáló tehet, az az, hogy csökkenti annak esélyét, hogy a valódi, nem anyanyelvi prózát gyakran félrejelöljék, ezt látjuk a tesztelésben.
K: Görögül írtam, majd lefordítottam. Emiatt valószínűbb lesz a jelölés?
Lehet, mert a lefordított tudományos próza gyakran nagyon standard és szabályos, és pontosan ez az, ami alacsony perplexityként olvasható. A lefordított vázlat humanizálása, majd a folyamat közzététele egy ésszerű módja annak, hogy a tiszta megfogalmazás ne a tisztasága miatt kapjon büntetést.
Nem anyanyelvi akadémikusoknak készült: csökkentse a téves AI-jelzéseket a körültekintő görög-angol nyelv esetén, miközben megőrzi az idézeteket, a terminológiát és az érvelést.
Moe egy NLP mérnök PhD-vel a természetes nyelvi feldolgozásban. Kutatásai kiterjednek a számítógépes nyelvészetre, a szövegelemzésre és a gépi tanulásra, és közvetlenül beépültek a ProofreaderPro mögötti szerkesztési és humanizálási modellekbe. A folyamat azon részéről ír, amelyet a legtöbb ember soha nem lát: hogyan olvas fel egy nyelvi modell egy mondatot, pontozza azt, és hogyan dönti el, min változtasson.


