
OpenAI, Google und Anthropic haben alle dieselbe Technologie entwickelt: ein statistisches Wasserzeichen für KI-generierten Text. OpenAI hat seine Version jahrelang zurückgehalten und begann sie, als textGrain, im Oktober 2026 auszurollen. Google hat SynthID direkt in Gemini ausgeliefert und die Methode veröffentlicht. Anthropic hat das Wasserzeichen von Claude im August 2026 für jede Nutzerin und jeden Nutzer verpflichtend gemacht. Wenn Sie in irgendeiner Form mit KI-Unterstützung schreiben, beeinflussen heute alle drei Entscheidungen, wie Ihre Dokumente beurteilt werden.
Watermarking wechselte am 11. August 2026 vom Forschungsthema in die gängigen Medien, als Anthropic ankündigte, dass jedes neue Claude-Modell die Textausgabe kennzeichnet. Wir haben diese Ankündigung in unserem Claude-Wasserzeichen-Erklärstück ausführlich behandelt. Dieser Leitfaden zeigt das Gesamtbild: Was ein Text-Wasserzeichen ist, wie jede der drei großen Labore es umgesetzt oder zurückgehalten hat, und was jedes System über ein Stück Text beweist.
Was ist ein KI-Text-Wasserzeichen?
Ein KI-Text-Wasserzeichen ist ein statistisches Muster, das in den Wortentscheidungen von generiertem Text verborgen ist. Es wird zum Zeitpunkt der Generierung gesetzt, sodass ein Detektor mit dem passenden Schlüssel später prüfen kann, ob der Text von einem bestimmten KI-System stammt. Es ist keine sichtbare Kennzeichnung, kein verstecktes Zeichen und keine dem Dateicontainer angehängte Metadaten-Angabe. Die Markierung lebt in den Wörtern selbst.
Dieser Unterschied ist wichtig, denn der Begriff "Wasserzeichen" wird locker für drei verschiedene Dinge verwendet:
| Was es ist | Wo es sich befindet | Übersteht Copy-Paste? | |
|---|---|---|---|
| Statistisches Wasserzeichen | Eine Verzerrung, bei der das Modell bestimmte Wörter auswählt | Der eigentliche Text | Ja |
| Dateimetadaten (C2PA) | Ein signiertes Provenance-Label | Der Dateicontainer | Nein, das reine Kopieren in Klartext entfernt es |
| Zeichen mit Nullbreite | Unsichtbares Unicode in den Text eingefügt | Zwischen den sichtbaren Zeichen | Nein, wird ohne Weiteres entfernt |
Statistische Wasserzeichen sind das einzige von allen drei Verfahren, das beim Kopieren, Einfügen, Neutippen in ein neues Dokument und bei Formatumwandlungen erhalten bleibt. Deshalb haben sich alle drei großen Labore für Text darauf verständigt, und deshalb richten sich sogenannte „Wasserzeichen-Entferner“, die unsichtbare Zeichen entfernen, dagegen nichts aus. Unsere Seite kostenloser Claude-Wasserzeichenentferner dokumentiert dieses Versagensmuster anhand von Quellen.
Wie funktioniert statistisches Watermarking tatsächlich?
Bei jedem Schritt beim Schreiben eines Satzes wählt ein Sprachmodell zwischen mehreren nahezu gleichwertigen Wörtern, und ein Wasserzeichen lädt die Würfel leise. Das grundlegende Rezept wurde von Kirchenbauer und Kolleginnen und Kollegen an der University of Maryland im Januar 2023 veröffentlicht, in A Watermark for Large Language Models (ICML 2023). So funktioniert es:
- Bevor jedes Wort ausgewählt wird, teilt ein geheimer Schlüssel, der aus den vorangegangenen Wörtern abgeleitet ist, den Wortschatz in eine bevorzugte Menge und eine neutrale Menge.
- Das Modell lenkt seine Wahl in Richtung der bevorzugten Menge. „Suggest“ statt „indicate“. „Across“ statt „among“. Jede einzelne Entscheidung wirkt vollkommen natürlich.
- Ein Detektor, der den Schlüssel besitzt, zählt, wie oft der Text in den bevorzugten Mengen landet. Menschliches Schreiben trifft die erwartete Rate nur zufällig. Mit Wasserzeichen versehener Text trifft sie viel zu oft, und ein statistischer Test markiert die Abweichung.
Kein einzelnes Wort ist ein Beleg für irgendetwas. Das Signal entsteht erst über Dutzende oder Hunderte von Entscheidungen, weshalb längere Passagen sich leichter testen lassen als kurze, und weshalb Erkennung immer probabilistisch ist, also kein Ja- oder Nein-Label.
Das Produktionssystem von Google DeepMind, veröffentlicht in Nature im Oktober 2024 als Skalierbares Watermarking zur Identifizierung von Ausgaben großer Sprachmodelle, verfeinerte dies mit einer Technik namens Tournament Sampling, die die Textqualität so gut erhält, dass sie sich im Hintergrund in einem Endkundenprodukt in großem Maßstab betreiben lässt. Diese Arbeit ist auch über Google hinaus wichtig: Sie ist die veröffentlichte Grundlage, auf die Anthropic für Claudes Implementierung verweist.
Die größte Schwäche wurde veröffentlicht, bevor die meisten der Umsetzungen stattfanden. Im März 2023 zeigten Krishna und Kolleginnen und Kollegen in Paraphrasing umgeht Detektoren für durch KI erzeugten Text (NeurIPS 2023), dass das Neuschreiben der Formulierungen in einem Abschnitt die Erkennung über alle Methoden hinweg aushebelt, einschließlich Watermarking. Das Signal lebt in der exakten Token-Sequenz und nirgendwo sonst, sodass jede Änderung, die die Sequenz umschreibt, auch das Beweismaterial umschreibt. Selbst ein menschlicher Lektor. Jede Anbieterin und jeder Anbieter, die oder der heute ein Wasserzeichen ausliefert, nennt diese Einschränkung in der eigenen Dokumentation.

OpenAI: das Unternehmen, das es erfunden hat und es als Letztes auslieferte
OpenAI hatte seit Jahren ein funktionierendes Text-Wasserzeichen und entschied sich dagegen, es bis Oktober 2026 freizugeben. Scott Aaronson, damals bei OpenAI mit Schwerpunkt auf Sicherheit, beschrieb die Idee erstmals öffentlich in einer Vorlesung im November 2022. Die Methode lenkt die Entscheidungen des Modells zwischen nahezu gleichwertigen Wörtern mit einer geheimen kryptografischen Funktion. Dadurch zeigt der Text selbst, woher er stammt. Diese Vorlesung ist älter als jedes der Systeme, die inzwischen ausgeliefert werden.
Im Mai 2024 beschrieb OpenAI den Stand des Projekts in seinem Provenance-Update in Die Quelle dessen verstehen, was wir online sehen und hören. Das Unternehmen sagte, seine Text-Watermarking-Methode sei bei kleinen Änderungen präzise und wirksam, habe aber das Release zurückgestellt, während es die Vor- und Nachteile abwog. Zwei der Risiken, die OpenAI nannte, betreffen akademische Schreibende direkt:
- Leichte Umgehung. Eine Paraphrasierung oder Übersetzung des Texts entfernt das Zeichen, genau wie die Forschung von 2023 vorhergesagt hat. Eine Watermark, die vor allem Menschen erfasst, die nicht wissen, dass es sie gibt, ist ein schwaches Durchsetzungsinstrument.
- Unverhältnismäßige Auswirkung auf nicht-muttersprachliche Englischsprechende. OpenAI erklärte, dass Watermarking die legitime Nutzung von KI als Schreibhilfe für Menschen stigmatisieren könne, die in einer zweiten Sprache schreiben. Unser Beitrag zu warum KI-Detektoren nicht-muttersprachliche Schreibende markieren behandelt dasselbe Problem aus der Perspektive der Detektoren.
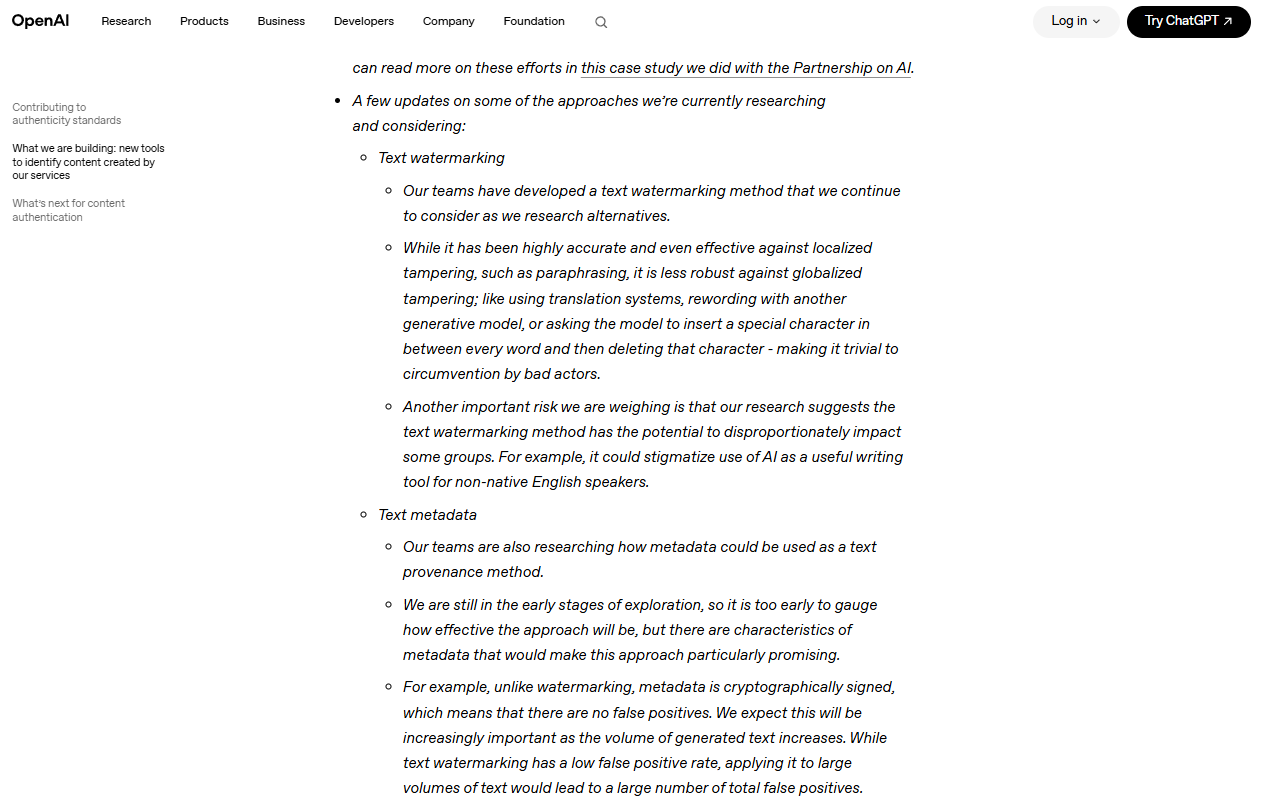
Provenance-Update von OpenAI 2024: Die Methode funktioniert, und das Unternehmen nennt die Gründe, warum es sie damals zurückhielt.
Für Bilder und Audio ging OpenAI einen anderen Weg: C2PA-Provenance-Metadaten in den DALL-E- und Sora-Ausgaben, also eine Kennzeichnung auf Dateiebene, nicht ein Zeichen im Inhalt. Für Text hatte die ChatGPT-Ausgabe bis Oktober 2026 keine Watermark. Das Unternehmen, das die Technologie vorgeschlagen hatte, war das letzte von den drei, das sie einführte.
Watermarkt OpenAI mittlerweile Text?
Ja, OpenAI begann am 5. Oktober 2026 damit, einige Texte zu watermarken, als Reaktion auf den EU AI Act. Seine Ankündigung führt eine Text-Watermark namens textGrain ein, die ein unsichtbares statistisches Signal in den Wortentscheidungen des Modells hinzufügt. Die Einführung hat drei Bestandteile, und die Watermark ist kein globaler Standard:
- API-Kundinnen und -Kunden können überall die watermarked Ausgabe für ausgewählte Modelle aktivieren. Standardmäßig bleibt es deaktiviert.
- In den folgenden Wochen erhalten berechtigte ChatGPT- und Codex-Textausgaben in der Europäischen Union die Watermark, in allen Tarifen.
- Zugelassene Forschende und Experteneinrichtungen können sich für den Zugang zum Text-Watermark-Detektor bewerben.
OpenAI sagt, textGrain habe die anderen Methoden, die es getestet hat, erreicht oder übertroffen, darunter Googles SynthID für Text. Außerdem veröffentlichte es, wo die Erkennung schwächer wird. Bei einer 1%igen Falsch-Positiv-Rate identifizierte der Detektor die Watermark bei etwa 80% der Passagen mit 200 Tokens und bei etwa 95% der Passagen mit 400 Tokens im Bereich Psychologie. Für Mathematik war die Erkennung deutlich geringer, weil es dort weniger Spielraum bei der Wortwahl gibt.
Das Bearbeiten schwächt das Signal schnell. In Passagen mit 400 Tokens senkte das Ersetzen von 10% der Wörter durch Synonyme die Erkennung von etwa 92% auf 66%, und das Ersetzen von 25% auf 17%.
OpenAI prüfte außerdem, ob die Watermark die Antwortqualität auf Astra, seinem neuesten Modell, verändert, und sagt, es habe keinen bedeutungsvollen Unterschied festgestellt. Das sind vier der Benchmarks, die es veröffentlicht hat:
| Benchmark | Ohne Watermark (Astra) | Mit Watermark (Astra) |
|---|---|---|
| Artificial Analysis Intelligence Index | 49,57 Punkte | 49,76 Punkte |
| GPQA Diamond | 94.44% | 93.94% |
| HealthBench Professional | 64.27% | 64.60% |
| BrowseComp | 87.92% | 87.35% |
Für Studierende ist das Datum entscheidend. ChatGPT-Texte, die vor der Einführung geschrieben wurden, oder außerhalb der EU ohne die API-Einstellung, haben keine OpenAI-Watermark. Unser Leitfaden zu Turnitin Clarity erklärt zeigt, wie Schulen inzwischen eigene Richtlinien zur KI-Nutzung festlegen.
Gibt es einen öffentlichen OpenAI-Watermark-Checker?
Es gibt bislang keinen öffentlichen OpenAI-Wasserzeichen-Checker für Text. Der kostenlose Verifizierungs-Tool von OpenAI prüft Bild- und Audiodateien auf C2PA Content Credentials sowie auf ein SynthID-Wasserzeichen, das OpenAI in unterstützten Bildern und Audiodateien einbettet. OpenAI sagt, dass das Tool Text nicht unterstützt.
Für Text gewährt OpenAI Detektor-Zugriff fallweise an genehmigte Forschende und Expert:innen-Organisationen, über sein Content Provenance API-Formular. OpenAI sagt, dass es den Textdetektor beim Launch nicht öffentlich macht, weil das Risiko von übersehenen Wasserzeichen und falsch positiven Ergebnissen besteht. Der Detektor meldet, ob er ein OpenAI-Wasserzeichen findet, und er identifiziert den Nutzer nicht und zeigt auch keine Prompts.
| Was Sie prüfen möchten | Tool | Wer es nutzen darf |
|---|---|---|
| Eine OpenAI-Bild- oder Audiodatei | Das Verifizierungs-Tool von OpenAI | Jede Person, kostenlos |
| OpenAI-Textausgabe (textGrain) | Der Text-Wasserzeichendetektor von OpenAI | Genehmigte Forschende und Expert:innen-Organisationen, per Antrag |
| Claude-Textausgabe | Claude Watermark Detector | Geeignete Organisationen, per Antrag (siehe unsere Claude-Wasserzeichen-Anleitung) |
OpenAI macht auch deutlich, was ein Ergebnis nicht über Sie aussagen kann. Ein erkannter Wasserzeichenwert misst nicht, wie viel eine Person beigetragen hat, und er identifiziert nicht, wer den Text geschrieben oder verwendet hat. Ein fehlendes Wasserzeichen beweist auch keine menschliche Urheberschaft, denn Text kann zu kurz sein, bearbeitet, übersetzt oder von einem nicht unterstützten Modell stammen.
Google: zuerst liefern, dann das Rezept offenlegen
Google DeepMind lieferte zuerst, veröffentlichte alles vollständig und öffnete danach die Methode. Sein System SynthID begann als Bild-Wasserzeichen im Jahr 2023 und wurde 2024 auf Text ausgeweitet. Bis zu dem Zeitpunkt, als das Nature-Paper im Oktober 2024 erschien, lief SynthID-Text bereits im Produktionsbetrieb in Gemini. Damit war es das erste statistische Text-Wasserzeichen, das im Konsumentenmaßstab eingesetzt wurde.
SynthID umfasst Text, Bilder, Audio und Video und ist seit Oktober 2024 in der Gemini-Textausgabe live.
Google veröffentlichte anschließend die Implementierung als Open Source auf Hugging Face, sodass jede:r Entwickler:in das gleiche Wasserzeichnungs-Schema auf die eigenen Modelle anwenden kann. Im Mai 2025 kündigte Google den SynthID Detector an, ein Verifizierungsportal, in dem Inhalte auf SynthID-Markierungen über Text, Bilder, Audio und Video hinweg geprüft werden können.
Eine wichtige Einschränkung ist entscheidend: SynthID markiert und erkennt nur Inhalte aus den eigenen Google-Modellen. Es sagt nichts über ChatGPT- oder Claude-Ausgaben, und ein sauberer SynthID-Scan bedeutet nicht, dass ein Text von Menschen geschrieben wurde. Das bedeutet lediglich, dass Googles Modelle ihn nicht geschrieben haben, was eine deutlich engere Aussage ist.
Anthropic: zuletzt wechseln, strengste Richtlinie
Anthropic setzte als Letztes an und bot die breiteste verpflichtende Abdeckung. Jedes Claude-Modell, das am oder nach dem 2. August 2026 gestartet wurde, bettet ein statistisches Wasserzeichen in seine Textausgabe ein, weltweit, in jedem Plan, ohne Opt-out. Das Unternehmen beschreibt den Mechanismus in seinem Erklärtext, Wie Claude das Text-Wasserzeichen funktioniert, und den Geltungsbereich in seinem Hilfecenter-Artikel Wie Claude KI-generierte Inhalte kennzeichnet. Abgedeckt sind dabei die Claude API, claude.ai, Claude Code, Claude Cowork und Claude Tag. Modelle, die vor der Cutoff-Zeit gestartet wurden, befinden sich in einer Übergangsphase, und Anthropic sagt, dass es die Kennzeichnungsunterstützung auch dafür hinzufügt. Zusätzlich zur statistischen Markierung tragen Claude-generierte Dateien auch C2PA-Metadaten. Das ist ein zweites, separates System, das bei reinem Textkopieren verloren geht.
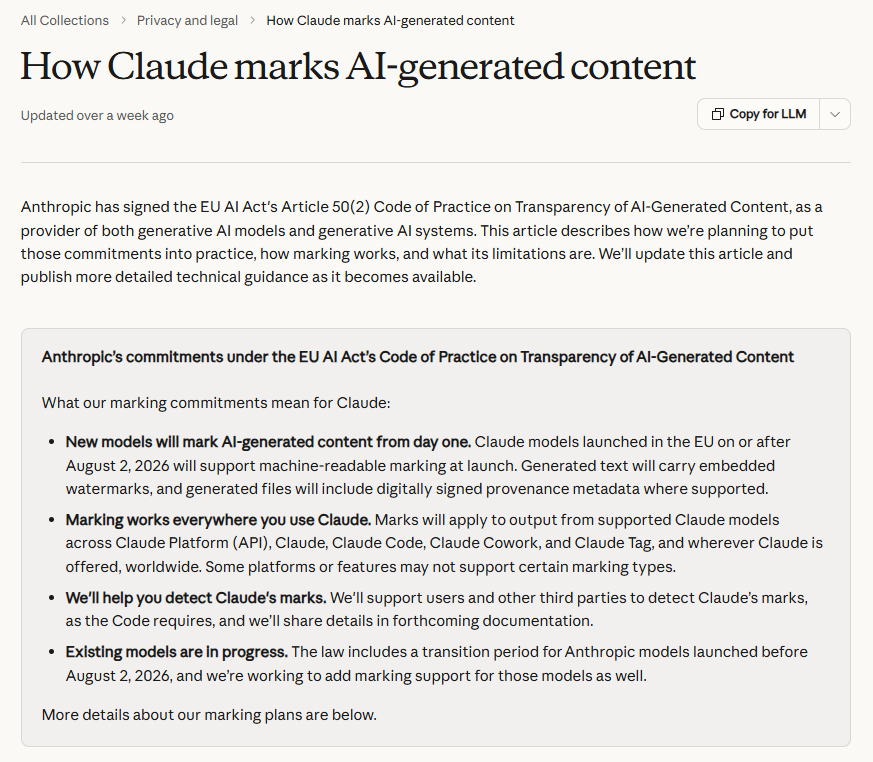
Die Richtlinie in den eigenen Worten von Anthropic: jedes neue Modell, jede Plattform, weltweit, wobei ältere Modelle nach und nach hinzugefügt werden.
Anthropics Dokumentation stellt die Grenzen direkt dar. Detektion ist probabilistisch. Die Kennzeichnung kann nicht unterscheiden, ob ein Dokument von Claude verfasst wurde oder ob es ein Mensch verfasst hat und Claude es nur leicht editiert hat. Ein vollständiges Rewrite entfernt sie. Wir sind durch all das gegangen, einschließlich dessen, was eine positive Detektion tatsächlich beweist, und was Sie tun sollten, wenn Ihr eigenes Schreiben markiert wird, in der dedizierten Claude-Anleitung zur Wasserzeichnung.
Der Zeitplan folgt der Regulierung. Anthropic hat den Verhaltenskodex Artikel 50(2) zur Transparenz von KI-Generierten Inhalten unter der EU AI Act unterzeichnet. Dieser verlangt von Anbietern generativer KI-Systeme, sicherzustellen, dass Ausgaben in einem maschinenlesbaren Format gekennzeichnet sind und als künstlich generiert erkannt werden können. Diese Transparenzpflichten wurden ab dem 2. August 2026 anwendbar: das genaue Stichtagsdatum in Anthropics Modellrichtlinie, neun Tage vor der öffentlichen Bekanntgabe. Anthropic hat sich für weltweite Konformität entschieden, statt für EU-Verkehr ein getrenntes Verhalten beizubehalten. Google war bereits per Design konform. OpenAIs unmarkierte Textausgabe ist die offene Compliance-Frage für 2027.
Die drei Ansätze, nebeneinander
| OpenAI | Google DeepMind | Anthropic | |
|---|---|---|---|
| Text-Wasserzeichen bereitgestellt? | Ja (textGrain, EU-Rollout ab dem 5. Oktober 2026) | Ja (Gemini, seit Oktober 2024) | Ja (Claude-Modelle ab dem 2. August 2026) |
| Technik | textGrain, ein statistisches Signal in Wortwahl | SynthID-Text-Turnierabstichproben | Statistische Sampling-Kennzeichnung, SynthID-ähnlich |
| Abdeckung | Berechtigter ChatGPT- und Codex-Text in der EU; API-Opt-in weltweit | Nur Google-Modelle | Alle neuen Claude-Modelle; ältere Modelle in der Übergangsphase |
| Opt-out | In der API standardmäßig aus | Nein | Nein |
| Öffentlicher Detektor | Nein | SynthID-Detektor-Portal (2025) | Geplant, noch nicht veröffentlicht |
| Schema veröffentlicht? | Nur Konzeptvorlesungen | Nature paper + Open Source | Erklärung auf Basis veröffentlichter Arbeiten |
| Dateimetadaten (C2PA) | Ja, für Bilder und Audio | Ja, über Medien hinweg | Ja, für generierte Dateien |
| Benannte Grenzen | Umgehung, ESL-Stigma | Begrenzter Umfang auf eigene Modelle | Wahrscheinlich, Änderungen verwischen die Urheberschaft |
Das Muster über die Spalten hinweg: OpenAI betrachtet Text-Wasserzeichen als ungelöstes Politikproblem, Google als Infrastruktur, die standardisiert werden muss, und Anthropic als Compliance-Verpflichtung, die vollständig umgesetzt werden muss.
Was das für Forschende und akademische Schreibende bedeutet
Die praktischen Folgen hängen davon ab, welche Tools mit Ihrem Text in Berührung kommen. Wenn Sie mit ChatGPT entwerfen, trägt Ihr Text heute kein Wasserzeichen. Wenn Sie mit Gemini entwerfen, trägt er ein SynthID-Signal, das nur der Google-Detektor lesen kann. Wenn Sie mit einem aktuellen Claude-Modell entwerfen oder bearbeiten, trägt er das Zeichen von Anthropic, und es gibt keine Einstellung, mit der man das ausschalten kann.
Drei Dinge, die akademische Schreibende wissen sollten:
Ein Wasserzeichen identifiziert ein Tool, nicht einen Autor. Jeder Anbieter nennt das in seiner eigenen Dokumentation, und es lohnt sich, das zu wiederholen, weil institutionelle Richtlinien den Unterschied nicht immer machen. Text kann markiert sein, weil eine KI ihn entworfen hat, weil eine KI zwei Sätze als Copy-Editing überarbeitet hat, oder weil ein markierter Absatz zitiert wurde. Wenn Ihre Institution Wasserzeichen-Checks durchführt, zeigt der Check, dass ein bestimmtes Modell den Text irgendwann einmal berührt hat, mehr nicht. Unser Leitfaden zu einer Einspruchsmöglichkeit bei einem fälschlich gemeldeten AI-Detektionssignal zeigt, wie Sie diese Argumentation aufbauen, wenn es darauf ankommt.
Wasserzeichen und KI-Detektoren sind unterschiedliche Technologien mit unterschiedlichen Fehlermodi. Detektoren wie Turnitin oder GPTZero schätzen anhand statistischen Stils, mit den Genauigkeitsproblemen, die wir dokumentiert haben. Die Erkennung von Wasserzeichen ist ein schlüsselbasiertes Testverfahren mit einer sehr niedrigen Falsch-Positiv-Rate bei nicht markiertem menschlichem Text. Die Asymmetrie kehrt sich bei False Negatives um: Ein Wasserzeichen-Check verpasst jeden KI-Text eines nicht wasserzeichnenden Modells, zu dem heute alle von ChatGPT gehören.
Offenlegung bleibt Ihre stärkste Position. Wasserzeichen machen die stille KI-Nutzung riskanter und die offengelegte KI-Nutzung sicherer, weil eine offengelegte Vorgehensweise vor einem positiven Markierungsbefund nichts zu fürchten hat. Die meisten Fachzeitschriften und Universitäten haben inzwischen explizite Richtlinien zur KI-Nutzung; unsere KI-Nutzungsrichtlinie erläutert, wie wir diese Grenzen über unsere eigenen Tools hinweg ziehen, und sie ist eine sinnvolle Vorlage dafür, wie transparente Nutzung aussieht.
Was ein Text-Wasserzeichen entfernt und was nicht
Umformulierung entfernt es; Umformatierung nicht. Kopieren, Einfügen, Schriftarten ändern, zwischen Dateiformaten umwandeln und unsichtbare Zeichen entfernen lassen das statistische Wasserzeichen vollständig intakt, weil das Zeichen in den Wortentscheidungen steckt. Was es entfernt, ist alles, was die Formulierung neu erzeugt: ein tiefgreifender menschlicher Eingriff, eine Übersetzung oder eine echte Paraphrase, wie die Robustheitsarbeit von NeurIPS 2023 gezeigt hat, noch bevor diese Systeme überhaupt ausgeliefert wurden.
Beide Richtungen sind hier wichtig. Das Verschwinden eines Markers macht den Text nicht zu Ihrem, und das Fortbestehen eines Markers macht den Text nicht zu nicht Ihrem. Ein umgeschriebener KI-Entwurf ist weiterhin ein KI-gestütztes Dokument, auf das die Offenlegungsregeln Ihrer Einrichtung anwendbar sind. Unser KI-Humanizer für KI-Text macht KI-gestützte Entwürfe in einen natürlichen akademischen Sprachstil um, und weil dieser Prozess die Token-Reihenfolge neu generiert, überleben statistische Marker ihn nicht. Für Claude im Speziellen entfernt der kostenlose Claude-Wasserzeichenentferner den Inhalt, indem er jeden Satz in frischem Wortlaut neu ausdrückt und dabei Fakten, Zahlen und Zitate unverändert lässt. Was kein Tool verändern kann, ist, was Sie Ihrem Leser schulden: Transparenz darüber, wie das Dokument erstellt wurde.
Umformulieren ist die eine Tätigkeit, die einen statistischen Marker entfernt, und genau das tut dieses Tool, Satz für Satz.
Wohin es als Nächstes geht
Beobachten Sie drei Dinge bis 2027. Erstens, ob OpenAI textGrain über die EU hinausbringt. Dort begann es, weil die EU- Durchsetzung von Artikel 50 maschinenlesbare Marker auf KI-Text erfordert. Zweitens, ob sich Detektoren angleichen. Wenn jedes große Labor mit einem veröffentlichten Schema watermarkt, können Universitäten Schlüssel prüfen statt aus dem Schreibstil zu raten, was eine Verbesserung gegenüber der heutigen detektion mit hoher Fehlalarmquote wäre. Drittens, ob die Marker miteinander kompatibel werden. Heute verwenden drei Labore drei unterschiedliche Marker, und kein einziger Abgleich deckt alle ab. C2PA schließt diese Lücke für Dateien, aber für reinen Text ist bislang nichts dafür verfügbar.
Wasserzeichnet ChatGPT seinen Text?
Ja, teilweise, seit dem 5. Oktober 2026. OpenAI hat begonnen, sein textGrain-Wasserzeichen dem berechtigten ChatGPT- und Codex-Text in der Europäischen Union hinzuzufügen, und API-Kunden können es überall einschalten. Das Wasserzeichen ist ein statistisches Signal in den Wortwahlen, ohne versteckte Zeichen. OpenAI wendet außerdem C2PA-Provenienzmetadaten auf DALL-E- und Sora-Mediendateien an, das ist jedoch ein separates System auf Dateiebene.
Wasserzeichnet Google Gemini seinen Text?
Ja. Gemini-Ausgaben tragen seit Oktober 2024 das SynthID-Text-Wasserzeichen von Google DeepMind. Es ist ein statistischer Marker in den Wortwahlen, für Leser unsichtbar und über den SynthID-Detektor von Google prüfbar. Er gilt nur für die eigenen Modelle von Google, daher sagt ein negatives SynthID-Ergebnis nichts über Text von anderen KI-Systemen aus.
Wasserzeichnet Claude seinen Text?
Ja. Jedes Claude-Modell, das am oder nach dem 2. August 2026 auf den Markt kam, bettet ein statistisches Wasserzeichen in die Textausgabe ein, auf jeder Plattform und in jedem Tarif, ohne Opt-out. Claude-generierte Dateien tragen zusätzlich C2PA-Metadaten. Modelle, die vor diesem Datum veröffentlicht wurden, markieren ihre Ausgabe noch nicht; Anthropic sagt, dass es während einer Übergangsphase Markierungsunterstützung dafür hinzufügt. Die vollständigen Details finden Sie in unserer Erklärung zum Claude-Wasserzeichen.
Können Universitäten KI-Wasserzeichen erkennen?
Nur mit der Kooperation des jeweiligen Anbieters, denn für die Erkennung wird der Schlüssel des Anbieters benötigt. Google bietet ein öffentliches Detektor-Portal für SynthID-Inhalte an. Anthropic sagt, dass die Erkennung für Nutzer und Dritte geplant ist, aber noch keinen öffentlichen Detektor veröffentlicht hat. Kein gängiges Plagiatserkennungs-Tool kann derzeit statistische Wasserzeichen aus irgendeinem Labor verifizieren. Daher bedeutet die institutionelle "KI-Erkennung" heute immer noch stilbasiertes Raten, nicht eine Überprüfung von Wasserzeichen.
Ist KI-Wasserzeichenkennzeichnung gesetzlich vorgeschrieben?
In der EU ja, faktisch. Artikel 50 Absatz 2 des EU AI Act verpflichtet Anbieter von generativer KI sicherzustellen, dass Ausgaben in einem maschinenlesbaren Format gekennzeichnet und als künstlich generiert erkennbar sind, wobei Transparenzpflichten ab dem 2. August 2026 gelten. Anthropic hat den entsprechenden Code of Practice unterzeichnet und weltweite Konformität gewählt. Wie Regulierungsbehörden mit dem unveröffentlichten Text-Wasserzeichen von OpenAI umgehen, ist 2027 die entscheidende Frage.
Überleben KI-Wasserzeichen die Übersetzung?
Nein. Ein statistisches Wasserzeichen lebt in der exakten Wortabfolge, die das Modell gewählt hat, und Übersetzung ersetzt jedes einzelne Wort. Das gilt ebenso für Deep Paraphrasing und intensives menschliches Überarbeiten. Diese Einschränkung ist in der begutachteten Fachliteratur dokumentiert und von jedem Anbieter anerkannt, der ein Wasserzeichen ausliefert.
Gibt es einen öffentlichen OpenAI-Wasserzeichen-Checker für Text?
Nein. Das öffentliche Verifizierungstool von OpenAI prüft nur Bild- und Audiodateien, auf C2PA-Metadaten und SynthID-Wasserzeichen. OpenAI sagt, dass es Text nicht unterstützt. Sein Text-Wasserzeichen-Detektor ist nur für genehmigte Forschende und Expertorganisationen zugänglich, jeweils im Einzelfall.
Was ist textGrain?
textGrain ist das Text-Wasserzeichen von OpenAI, angekündigt am 5. Oktober 2026. Es fügt dem Wortwahlverhalten des Modells ein unsichtbares statistisches Signal hinzu, sodass das Markenzeichen Teil der Wörter ist, ohne versteckte Zeichen oder Datei-Metadaten. OpenAI sagt, es habe die anderen von ihm getesteten Verfahren entweder erreicht oder übertroffen, darunter SynthID für Text, und dass Bearbeitungen es schwächen.
Können Forschende eine Zugangsberechtigung zum Text-Wasserzeichen-Detektor von OpenAI beantragen?
Ja. Genehmigte Forschende und Expertorganisationen können sich über das Formular der Content Provenance API von OpenAI bewerben. OpenAI gewährt den Zugang Fall für Fall im Rahmen des EU Code of Practice. OpenAI sagt, es werde einen breiteren Zugang erneut prüfen, sobald sich die Technologie und die Evidenz weiterentwickeln.
Quellen
- Anthropic, So funktioniert das Text-Wasserzeichen von Claude, August 2026
- Anthropic Help Center, So kennzeichnet Claude Inhalte als KI-generiert, 2026
- OpenAI, Die Quelle dessen verstehen, was wir online sehen und hören, Mai 2024
- Google DeepMind, SynthID
- Dathathri et al., Skalierbares Watermarking zur Identifizierung von Ausgaben großer Sprachmodelle, Nature, Oktober 2024
- Google, Ankündigung des SynthID Detectors, Mai 2025
- Hugging Face, SynthID Text vorstellen, Oktober 2024
- Kirchenbauer et al., Ein Watermark für Large Language Models, ICML 2023
- Krishna et al., Paraphrasieren umgeht Detektoren für KI-generierten Text, NeurIPS 2023
- Scott Aaronson, Meine KI-Sicherheitsvorlesung für UT Effective Altruism, November 2022
- Europäische Union, AI Act, Artikel 50
- C2PA, Koalition für Inhaltsherkunft und Verlässlichkeit
Dana ist Content-Erstellerin bei ProofreaderPro, wo sie den täglichen Blog- und Schreibbetrieb leitet. Sie schreibt die Artikel über die Funktionsweise der Online-Bearbeitungsplattform und bearbeitet täglich Kundennachrichten, was ihr eine Zufriedenheitsbewertung von fünf Sternen einbringt.