
KI-Texthumanizer für sri-lankische Forschende, die auf Englisch schreiben
KI-Texthumanizer für sri-lankische Forschende. Reduzieren Sie falsch-positive KI-Erkennungsalarme bei Englisch, das von Sinhalesisch und Tamil beeinflusst ist, bei gleichbleibender Bedeutung und Zitaten; legen Sie die KI-Nutzung ehrlich offen.

Sri Lanka belegt Platz 98 im Nature Index. Das Land hat 17 nationale Universitäten, 6.064 Forschende und innerhalb seiner Grenzen nur eine einzige im SCIE gelistete Fachzeitschrift. Das bedeutet: Fast jede Arbeit, die für eine Beförderung zählt, muss die Sprachhürde bei einer Zeitschrift nehmen, die irgendwo anders sitzt, und auf Englisch publiziert. Ein KI-Texthumanizer für sri-lankische Forschende existiert aus einem sehr realen Grund: Sorgfältiges, korrektes Englisch als Zweitsprache wird inzwischen fälschlich als maschinelles Schreiben gelesen, und das kostet echte Menschen echte Publikationen.
Das Problem lässt sich einfach so zusammenfassen: Sri Lanka hat insgesamt einen Wert von 486 im EF English Proficiency Index. Damit liegt das Land eindeutig im Bereich „Low Proficiency“. Etwa 10% der Bevölkerung sprechen fließend Englisch. Die Fehlerquote bei Sprechenden des Sinhalesischen, wenn sie akademische Texte auf Englisch schreiben, liegt bei 54%. Für Sprechende des Tamil ist es nicht besser, die typischen Muster dieser Sprache führen zu ähnlichen Schwierigkeiten. In vielen Fällen ist es schlicht gute Wissenschaft. Die Englischsprache stolpert über die Einreichungen.
Nun kommt die zusätzliche Belastung durch KI-Detektoren hinzu. Wenn Sie in dem einfachen, standardisierten, vorhersehbaren Englisch schreiben, auf das eine zweisprachige Schreibperson beim Lernen gezielt hinarbeitet, kann ein Detektor Ihre tatsächlich menschlichen Absätze als maschinell generiert markieren. Dieser Leitfaden erklärt, warum das passiert, wie es sich auf Sinhalesisch und Tamil übertragen lässt, und wie Sie Ihren eigenen KI-gestützten Entwurf „humanisieren“, ohne etwas zu verbergen.
ශ්රී ලාංකික පර්යේෂකයන් සඳහා AI පෙළ මානවකරණය
KI-Texthumanizer helfen sri-lankischen Forschenden dabei, ihre Forschung auf Englisch zu veröffentlichen.
In plain English: Unser Text Humanizer hilft Forschenden in ganz Sri Lanka, sorgfältige, von Sinhalesisch beeinflusste oder von Tamil beeinflusste, akademische Prosa in natürliches Englisch zu überführen, ohne Ihre Ergebnisse, Ihre Begriffe oder Ihre Zitate zu verändern. Der Rhythmus und die Wortwahl unterscheiden sich, sodass sorgfältiges nicht-muttersprachliches Schreiben weniger wahrscheinlich als maschinelle Ausgabe fehlgelesen wird.
Das ist für Forschende mit Tamil als Unterrichts- bzw. Muttersprache in gleicher Weise relevant, insbesondere an der University of Jaffna, wo der Schritt von Tamil in die Veröffentlichung auf Englisch erfolgt. Beide Communities stoßen auf dieselbe Wand, und beide profitieren von demselben Workflow: Schreiben, Korrekturlesen, den eigenen Entwurf humanisieren und anschließend offenlegen.
Entwurf auf Sinhala oder Tamil? Der Humanizer erkennt und verarbeitet das
Nicht jeder Entwurf beginnt auf Englisch, und der Humanizer setzt es auch nicht voraus. Fügen Sie sinhalesischen Text ein, und ProofreaderPro erkennt die Schrift automatisch. Anschließend leitet es ihn über ein sprachsensitives Modell weiter, das Ihre Terminologie und Zitate exakt so beibehält, wie Sie sie geschrieben haben. Als AI පෙළ මානවකරණය schreibt es Ihre sinhalesische Prosa direkt um, damit können Sie humanisieren, bevor Sie übersetzen, statt danach. Die gleiche Erkennung gilt für mehr als sechzig Sprachen. Ein tamilischer Entwurf wird daher ebenso zuverlässig erkannt und humanisiert.
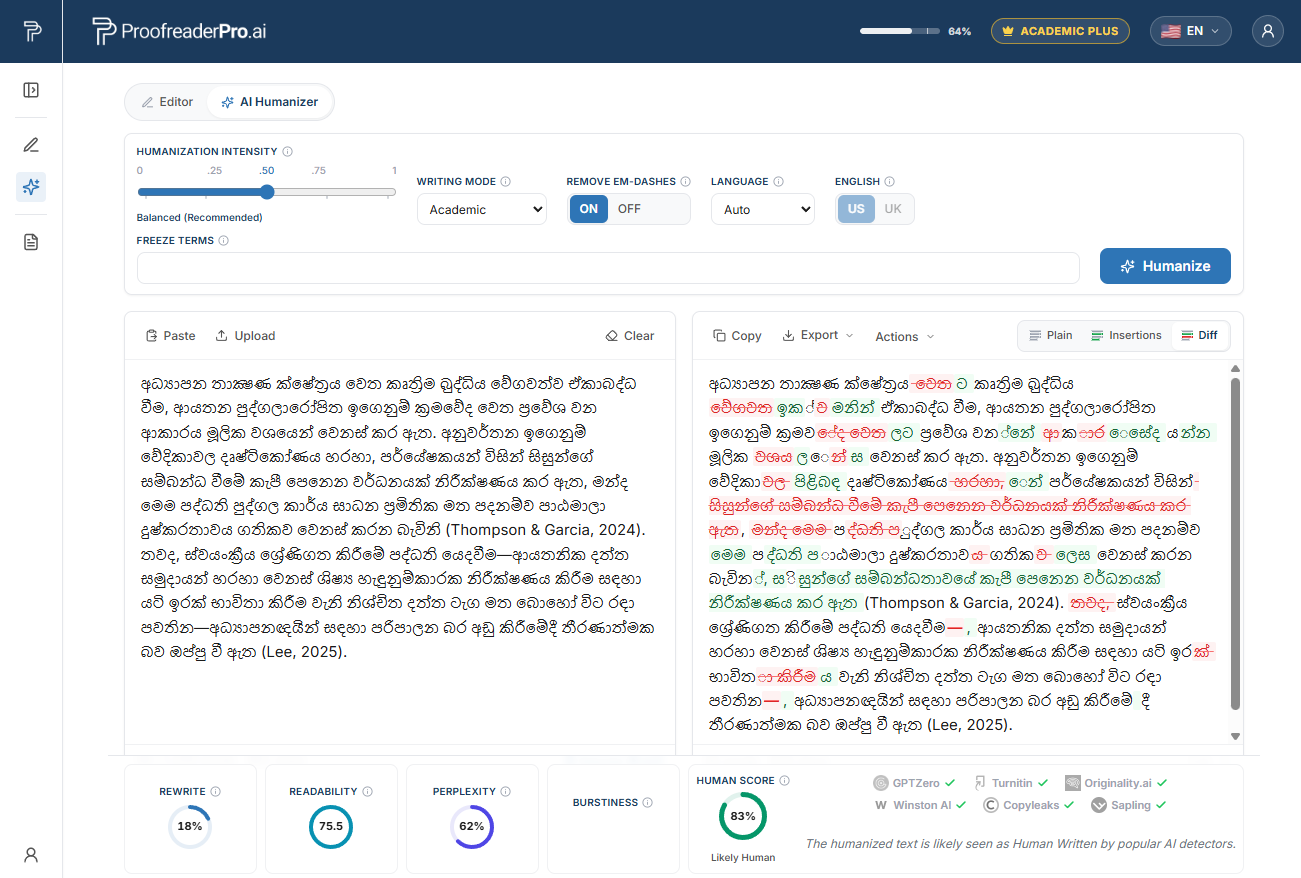
Der ProofreaderPro AI Humanizer schreibt sinhalesischen akademischen Text um. Die Differenz „vorher/nachher“ erhält Ihre Bedeutung und Ihre Zitate, und die Detektor-Checks bestätigen, dass eine natürliche, menschliche Lektüre vorliegt.
Warum sri-lankische Forschende von KI-Detektoren als Auffälligkeit markiert werden
Im Jahr 2023 veröffentlichte ein Team an der Stanford University unter Leitung von Liang und Kolleginnen und Kollegen eine Studie in der Cell-Press-Fachzeitschrift Patterns mit dem Titel „GPT detectors are biased against non-native English writers“. Die Forschenden ließen von Menschen geschriebene TOEFL-Aufsätze in sieben weit verbreitete KI-Detektoren laufen. Im Durchschnitt wurden etwa 61% der nicht-muttersprachlichen Essays als KI markiert, gegenüber etwa 5% bei muttersprachlichen englischen Schreibenden. Rund einer von fünf nicht-muttersprachlichen Essays (etwa 19,8%) wurde von jedem Detektor einstimmig markiert. Jeder einzelne Aufsatz wurde von Menschen verfasst.
Der Mechanismus erklärt die Ungerechtigkeit. Viele Detektoren bewerten „Perplexity“, also ein Maß dafür, wie überraschend jede Wortwahl für ein Sprachmodell ist. Sorgfältige Schreibende mit Englisch als Zweitsprache greifen auf gängige Wörter und standardisierte, vorhersehbare Formulierungen zurück. Das führt zu niedriger Perplexity, die der Detektor als maschinellen Text interpretiert. Die Gewohnheiten, die sri-lankische akademische Prosa klar und korrekt machen, sind exakt jene Gewohnheiten, die diese Tools daraufhin trainiert wurden zu bestrafen.
Sie können den vollständigen Mechanismus in unserem Erklärbeitrag zu warum KI-Detektoren nicht-muttersprachliche Schreibende markieren nachlesen. Die kurze Version: Ein Flag für Ihren Text ist oft eine Aussage über Ihre Englischkenntnisse, und nicht darüber, ob eine Maschine ihn geschrieben hat.
Die Muster aus Sinhalesisch und Tamil als Muttersprache hinter falschen Flags
Die Merkmale, durch die Zweitsprachen-Englisch als geringe Perplexity wirkt, sind keine Fehler. Es sind korrekte, sorgfältige, standardisierte Konstruktionen. Je gewissenhafter Sie sie glätten, desto konventioneller wird Ihre Prosa, und Konventionalität ist genau das, was ein Detektor auf Basis von Perplexity als verdächtig einstuft.
Auslassung von Artikeln. Weder Sinhalesisch noch Tamil haben ein artikelsystematisches Äquivalent zu Englisch. Es gibt keine direkte Entsprechung zu „the“, „a“ oder „an“ in beiden Sprachen, und das Weglassen von Artikeln macht etwa 51% aller artikelbezogenen Fehler in der akademischen Schreibpraxis in Sri Lanka aus. Eine Person, die „Result showed that method was effective“ zu „The result showed that the method was effective“ korrigiert, hat damit einen fehlerfreien, völlig standardisierten Satz erzeugt. Genau diese Standardhaftigkeit ist es, die als niedrige Perplexity bewertet wird.
Weglassen von Kopula und Verb „to be“. Beide Sprachen lassen die Kopula routinemäßig weg. Im Sinhalesischen bedeutet „Oya lassanai“ „She is beautiful“, ohne ein „is“. Im Tamil bedeutet „Avan periyavan“ „He is big“, ohne „is“. In der schriftlichen Darstellung taucht das dann als „The result significant at p < 0.05.“ auf. Sobald es zu „The result was significant at p < 0.05“ korrigiert wird, ist der Satz textbook-konventionelles Englisch, also genau die Art, die Detektoren von einem Modell erwarten.
Zeitformen aus einfacheren Systemen. Tamil arbeitet mit drei Zeitformen gegenüber den zwölf Zeit-Aspekt-Kombinationen im Englischen, und das Sinhalesische besitzt zwar reichere Strukturen, weist jedoch ebenfalls keine englischen Formen für den Perfekt- und den Progressive Aspekt auf. So wird aus „We collected samples since 2019“ die korrigierte Form „We have collected samples since 2019“. Sorgfältige, zeitschriftenübliche Verwendung von Zeitformen ist äußerst vorhersagbar, und vorhersehbare Prosa wird entsprechend markiert.
Präpositionen aus Postpositionen. Sinhalesisch und Tamil platzieren Markierungen nach dem Nomen. Sinhalesisch „mese uda“ bedeutet wörtlich „table on“, und tamilisch „mesei mel“ macht dasselbe. Das führt zu „in the table“, wo das Englische eigentlich „on the table“ möchte. Wenn Sie die korrekten Präpositionen lernen und konsistent anwenden, erzeugen Sie einige der standardisiertesten möglichen englischen Fassungen, erneut mit niedriger Perplexity.
Pronomen- und Registermuster. Sinhalesisch wählt Pronomen nach sozialem Register, nicht nach dem strikten he-, she-, it-System. Tamil verwendet ein geschlechtsneutral formelles Pronomen („avar“) neben geschlechtsspezifischen Formen. Wenn Sie diese zu konsistenten englischen Pronomen korrigieren, entsteht eine flüssige, konventionelle Prosa. Dabei handelt es sich um keinen Trick. Es ist geschicktes Schreiben in der Zweitsprache, das ein Detektor nicht von einer maschinellen Ausgabe unterscheiden kann.
KI-Detektion in Sri Lanka und der Kontext von Turnitin
Thesen und Zeitschriftseinreichungen in Sri Lanka werden häufig mithilfe von Turnitin oder iThenticate auf Textähnlichkeit geprüft, und diese Tools weisen inzwischen KI-Indikatoren zusätzlich zum Ähnlichkeitswert aus. Unter den UGC-Beförderungskriterien sind Karrieren an gelistete Publikationen gekoppelt. Eine einzige falsch interpretierte Markierung kann daher ein Manuskript zum Stillstand bringen, an dem ein sri-lankischer Forschender seit Monaten gearbeitet hat.
Es hilft zu wissen, dass die Tools selbst umstritten sind. Vanderbilt deaktivierte den KI-Detektor von Turnitin im Jahr 2023 und verwies dabei auf False Positives und eine Verzerrung gegen nicht-muttersprachliche Schreibende. Ähnliche Schritte unternahmen Michigan State, UT Austin, Northwestern, Pittsburgh, SMU und Waterloo. Turnitin unterdrückt Werte im Bereich von 1 bis 19%, zeigt also ein Sternchen statt einer Zahl und warnt, dass der Score nicht allein zur Entscheidung über einen Integritätsfall herangezogen werden sollte.
Die wichtigste Erkenntnis ist praxisnah: Ein Detektor-Score ist eine Behauptung, die Sie anfechten können, kein Urteil, das Sie akzeptieren müssen. Zeitschriften und Förderinstitutionen verlangen zunehmend eine Offenlegung der KI-Nutzung, und die richtige Antwort besteht darin, die Nutzung schlicht zu beschreiben und klar offenzulegen, nicht die Tools zu verbergen, die Sie verwendet haben.
Schützen Sie Ihr sorgfältiges Englisch vor einem falschen Flag
Machen Sie Ihren eigenen KI-gestützten Entwurf in von Sinhala beeinflusstem oder von Tamil beeinflusstem Englisch menschlicher. Bewahren Sie Ihre Bedeutung, Ihre Fachbegriffe und Ihre Zitate, und legen Sie Ihre KI-Nutzung so offen, wie es Ihr Journal verlangt.
Testen Sie den Humanizer kostenlosTop-Universitäten in Sri Lanka und wo KI-Checks auftauchen
Sämtliche 17 nationalen Universitäten Sri Lankas arbeiten unter UGC-Beförderungskriterien, die eine gelistete Veröffentlichung verlangen. Alle prüfen zudem Thesen und Manuskripte auf Ähnlichkeit und KI-Indikatoren, bevor sie eingereicht werden:
- University of Colombo, Colombo. Die führende Universität nach den meisten Kennzahlen und der größte Produzent an Scopus-gelisteten Publikationen im Land.
- University of Peradeniya, Peradeniya, Kandy. Der größte Campus in Sri Lanka, stark in Landwirtschaft, Naturwissenschaften, Ingenieurwesen und Veterinärmedizin.
- University of Moratuwa, Moratuwa. Die führende Ingenieuruniversität mit Schwerpunkt auf Bauingenieurwesen, Informatik und Architektur.
- University of Kelaniya, Kelaniya. Starke Ausrichtung auf Geisteswissenschaften, Sozialwissenschaften, Naturwissenschaften und Handel, mit wachsendem Output in den Gesundheitswissenschaften.
- University of Jaffna, Jaffna. Die führende Universität in der Northen Province und besonders bedeutend für tamilsprachige Forschende, die in die Veröffentlichung auf Englisch wechseln.
- University of Sri Jayewardenepura, Nugegoda. Starke Ausrichtung auf Management, angewandte Wissenschaften und medizinische Wissenschaften.
- University of Ruhuna, Matara. Die führende Universität in der Southern Province, stark in Landwirtschaft, Fischerei, Ingenieurwesen und Medizin.
- University of Rajarata, Mihintale. Fokus auf Landwirtschaft, Sozialwissenschaften und Technologie, mit wachsendem Forschungsanteil in Kultur- und Umweltstudien.
- Sabaragamuwa University of Sri Lanka, Belihuloya. Starke Ausrichtung auf Lebensmittelforschung, Landwirtschaft und Geomatik.
- Wayamba University of Sri Lanka, Makandura und Kuliyapitiya. Spezialisierung auf Landwirtschaft und Technologie; besonders relevant in Food Technology und Biotechnologie.
- Uva Wellassa University, Badulla. Schwerpunkt auf Naturwissenschaften und Technologie, mit wachsender Forschung in Tierwissenschaften und im Bereich Computing.
- Open University of Sri Lanka, Nawala. Die Einrichtung für Fernstudium des Landes, die Berufstätige unterstützt, die Forschungs- bzw. Wissenschaftskarrieren verfolgen.
Bei nur 6.064 aktiven Forschenden landesweit ist der Bedarf an sprachlicher Unterstützung hoch, und praktisch alle müssen sorgfältige nicht-muttersprachliche Prosa davor schützen, markiert zu werden.
So funktioniert der KI-Texthumanizer für sri-lankische Forschende
Hier ist der Workflow: Formulieren Sie Ihre Argumentation zuerst, optional auf Sinhala oder Tamil, dort, wo das Denken am natürlichsten fließt, und übersetzen Sie sie anschließend ins Englische. Korrigieren Sie die Grammatik, sodass die oben genannten Muster für Artikel, Kopula, Zeitformen und Präpositionen behoben werden. Führen Sie danach Ihren eigenen KI-gestützten Entwurf über unseren Text Humanizer, sodass die sorgfältig standardisierte Prosa ihren natürlichen menschlichen Rhythmus zurückgewinnt und weniger wahrscheinlich falsch als maschinelle Ausgabe gelesen wird. Bedeutung, Terminologie und Zitate bleiben unverändert.
Wir sind konkret, was die Ergebnisse betrifft, weil Sie Ehrlichkeit verdienen, keinen Hype. Getestet gegen die wichtigsten Detektoren, schreibt der Humanizer KI-Text in eine natürlichere menschliche Form um. Das senkt das KI-Signal und verbessert die Chancen gegenüber anspruchsvollen Detektoren, während die Grammatikgenauigkeit in wissenschaftlichen Texten hoch bleibt. Das sind Resultate aus Tests, keine Garantien. Detektoren werden alle paar Monate neu trainiert, daher kann kein seriöses Tool versprechen, zu 100% unentdeckbar zu sein oder einen Check dauerhaft zu umgehen.
Dann kommt der Schritt, der Sie absichert: die Offenlegung. Geben Sie Ihre KI-Nutzung im Format an, das Ihre Institution und Ihr Zieljournal verlangen. Den eigenen Text zu humanisieren, um ihn vor einem falschen Flag zu schützen, und dann offenzulegen, dass Sie KI-Unterstützung verwendet haben, ist das Gegenteil von Verbergen. Es ist Fairness für reale Arbeit. Wenn Sie außerdem zuerst Grammatik und Struktur fixieren müssen, zeigt Ihnen unser begleitender Leitfaden zur academic editing für sri-lankische Forschende genau diesen Aspekt, und dieser Beitrag ist in unserem mehrsprachigen KI-Texthumanizer-Hub eingebettet, dort decken wir denselben Workflow sprachübergreifend ab.
Lokale Förderstellen, Zeitschriften und Erwartungen an die KI-Offenlegung
Die wichtigsten Geldgeber in Sri Lanka knüpfen Finanzierung an veröffentlichte Ergebnisse. Die National Science Foundation (NSF) finanziert Competitive Research Grants und bewertet Verlängerungen anhand von Publikationen in international anerkannten Zeitschriften. Der National Research Council (NRC) bietet Förderungen von bis zu 50 Millionen Rs über 5 Jahre, mit anteiligen Publikationserwartungen. Die University Grants Commission (UGC) verlangt für eine Beförderung mindestens 12 Punkte aus Journalartikeln, wobei 5 herausragende Arbeiten für Senior-Positionen vorgesehen sind. Die höchsten Punkte erhalten SCIE-, SSCI- und Scopus-gelistete Zeitschriften.
Das Zeitschriftenumfeld im Inland ist klein. Die Journal of the National Science Foundation of Sri Lanka (JNSF) ist die einzige SCIE-gelistete Zeitschrift des Landes und hält diese Listung seit 14 aufeinanderfolgenden Jahren. Daneben bestehen unter anderem das Ceylon Journal of Science, eine der ältesten wissenschaftlichen Zeitschriften in Südasien; das Ceylon Medical Journal, herausgegeben von der Sri Lanka Medical Association seit 1887; die Sri Lanka Journal of Social Sciences; das Journal of the Rubber Research Institute of Sri Lanka; sowie Tropical Agricultural Research vom Postgraduate Institute of Agriculture in Peradeniya. SLJOL (Sri Lanka Journals Online) stellt 172 nationale Zeitschriften für Open Access bereit.
Da nahezu alle stark gewichteten Journals auf Englisch publizieren und außerhalb des Landes ansässig sind, hängt die Mehrzahl der Karrieren von einer internationalen Einreichung ab. Dort erwarten Herausgebende zunehmend eine Erklärung zur AI-Nutzung. Schreiben Sie Ihre Offenlegung schlicht, halten Sie sie korrekt, und behandeln Sie ein KI-Flag, falls es jemals ungerechtfertigt gegen Sie verwendet wird, als eine Behauptung, auf die Sie antworten können, nicht als Urteil, das Sie akzeptieren müssen. Unsere Ratgeber zum Verfassen einer KI-Offenlegungserklärung und dazu, wie man ein falsches KI-Detektions-Flag anfechten kann, decken beide Fälle ab.
Häufig gestellte Fragen
F: Ist ein KI-Texthumanizer für sri-lankische Forschende eine Möglichkeit, Turnitin zu betrügen?
Nein. Die richtige Anwendung besteht darin, Ihren eigenen KI-gestützten Entwurf zu humanisieren, sodass sorgfältig geschriebenes Englisch, das von Sinhala oder Tamil beeinflusst ist, nicht als maschineller Text fehlgelesen wird, während Ihre Bedeutung und Ihre Zitate genau so erhalten bleiben, wie Sie sie formuliert haben. Anschließend legen Sie Ihre KI-Nutzung im Format offen, das Ihr Journal verlangt. So bleiben Sie innerhalb der Integritätsregeln. Das ist das Gegenteil davon, irgendetwas zu verbergen.
F: Warum markieren KI-Detektoren meinen Text, obwohl ich jedes einzelne Wort selbst geschrieben habe?
Weil viele Detektoren „Perplexity“ bewerten, also wie vorhersehbar Ihre Wortwahl ist. Sorgfältige Schreibende mit Englisch als Zweitsprache verwenden gängige Wörter und standardisierte Formulierungen. Das erzeugt niedrige Perplexity, die als maschinelle Ausgabe gelesen wird. Eine Studie von 2023 an der Stanford University fand etwa 61% als KI markierte nicht-muttersprachliche Essays, die von Menschen verfasst wurden, gegenüber etwa 5% bei muttersprachlichen Schreibenden, damit ist das Muster dokumentiert und nicht Ihre Schuld.
F: Funktioniert der Humanizer für von Sinhala und Tamil beeinflusstes Englisch?
Ja. Er ist sprachsensitiv und unterstützt mehr als 60 Sprachen. Dadurch erkennt er die Muster der Auslassung von Artikeln, das Weglassen der Kopula, die Vereinfachung von Zeitformen sowie die präpositionsbezogenen Muster, die durch Postpositionen geprägt sind, also genau die Dinge, die Sprechende von Sinhala und Tamil in das Englische mitbringen. Der Rhythmus und die Wortwahl verändern sich, während Ihre technischen Begriffe, Ergebnisse und Referenzen erhalten bleiben.
F: Können Sie garantieren, dass mein Paper bei jedem KI-Detektor besteht?
Nein, und Sie sollten jedem Tool misstrauen, das das verspricht. Getestet gegen die wichtigsten Detektoren, schreibt unser Humanizer KI-Text in eine natürlichere menschliche Form um. Das senkt das KI-Signal und verbessert die Chancen gegenüber anspruchsvollen Detektoren, während die Grammatikgenauigkeit hoch bleibt. Das sind Resultate aus Tests, keine Garantien, weil Detektoren alle paar Monate neu trainiert werden.
F: Wird durch das Humanisieren meine Zitierweise oder meine Ergebnisse verändert?
Nein. Der Humanizer bewahrt Ihre Bedeutung, Ihre fachliche Terminologie und Ihre Zitate in APA, MLA, Chicago oder IEEE. Er passt Rhythmus und Formulierungen an und entfernt repetitive Kadenzen sowie einzelne Gedankenstriche, sodass die von Ihnen berichtete Wissenschaft identisch bleibt, während die Prosa natürlich lesbar wird.
Ein KI-Text-Humanizer mit Sprachbewusstsein für Forschende in Sri Lanka. Bewahren Sie Bedeutung, Fachbegriffe und Zitate, während sorgfältig von Sinhala und Tamil beeinflusstes Englisch natürlich und fair gelesen wird.

Moe ist ein NLP-Ingenieur mit einem PhD in der Verarbeitung natürlicher Sprache. Seine Forschung umfasst Computerlinguistik, Textanalyse und maschinelles Lernen und floss direkt in die Bearbeitungs- und Humanisierungsmodelle hinter ProofreaderPro ein. Er schreibt über den Teil des Prozesses, den die meisten Menschen nie sehen: wie ein Sprachmodell einen Satz liest, ihn bewertet und entscheidet, was geändert werden soll.


