上个月一位同事分享了一张截图,展示了一个Claude对话。她在对话中完成了头脑风暴、列提纲、撰写并修改了一整篇期刊文章的引言,耗时不到一小时。上一周同一部分在她那里花了三天。
她在写作流程的正确阶段使用了合适的AI工具。
我们花了数月时间将Claude整合到学术写作工作流程中:包括我们自己的,以及我们的用户的。该模型在研究写作方面确实有真实优势,但也存在清晰的局限性。知道该在什么地方使用它,以及何时切换到其他工具,才是区分“普通的AI实验”和“真正的效率提升”的关键。
Claude 适合学术写作和研究论文吗?
是的,当 Claude 基于你的自有笔记、数据和来源来工作时,它适合学术写作以及研究论文写作。它很适合作为起草与修改的辅助工具,但它并不是参考文献或结果的来源。论文中的每一条引文和每一个数字都必须来自你。
在研究论文中,Claude 最能帮助你的是那些你可以先提供要点的部分。这意味着,你的文献综述来自你的阅读笔记,你的方法来自你的方案或研究流程,你的讨论来自你的结果。研究问题、分析以及结论仍然由你来完成。
对于科学写作,Anthropic 从 Pro 起提供付费方案,包含 Claude Science,这是一款面向科学家的测试版应用。它允许你把结果写在生成它们的分析旁边,并支持 Markdown 和 LaTeX 预览。后台审核员会标记不正确的引文、无法追溯的数字,以及与其代码不一致的图表。
为什么Claude对学术写作很有效
与我们测试过的多数语言模型相比,Claude对细微差别的处理更出色,包括ChatGPT、Gemini、Grok和Deepseek等。这一点之所以重要,是因为学术写作几乎完全取决于细微差别。
当你让Claude帮你撰写讨论部分时,它往往会保留你的措辞保留(hedging)。它说“研究结果表明”,而不是“研究结果证明”。在我们进行的并排测试中,它对语体和语气的遵循比GPT更稳定。而且它不太可能在不确定的情况下编造出过度自信的表述。
我们观察到三个具体优势:
长上下文处理。 Claude可以处理非常长的文档,当前版本最高可达200K个tokens。这意味着你可以粘贴整份文献综述、完整的方法部分,甚至是一份草稿手稿,然后让模型围绕内容提问。它会在全文范围内保持连贯性,而不是在几千个词之后就丢失重点。
指令遵循。 当你告诉Claude“使用过去时、被动语态、正式语体,并且不要解读结果”,它确实会照做。并且是持续性的。较小的模型,甚至一些竞争的大模型,在输出更长时往往会偏离这些具体指令。
坦诚的不确定性。 Claude更可能说“我不确定”或“我没有足够的信息”,而不是编造答案。对于学术工作而言,一次自信却错误的幻觉可能会毁掉你的可信度,因此这点极其关键。
以上并不意味着Claude会替你写论文。它的意思是,在你正确引导的情况下,它是一个真正有用的助手。
工作流程1:头脑风暴与思路生成
我们建议从Claude开始的就是这一部分。在你写论文的第一个字之前。
打开一个对话,用通俗语言说明你的研究。不要担心学术化的措辞。告诉Claude你研究了什么、你得到了什么结论、以及你认为这意味着什么。然后让它帮助你找出论文最有力的切入角度。
这是我们使用的一套提示词框架:
I'm writing a paper about [topic]. My main finding is [finding].
The existing literature says [brief summary]. I think my contribution
is [your interpretation].

Help me think through: What's the strongest framing for this paper?
What counterarguments should I address? What's the most interesting
aspect of my findings that I might be underemphasizing?
用你自己的内容替换每一个[方括号占位符],在这里以及下面每一个提示中也同样如此。这些约束线用于区分可用输出与一般性的散文,所以请保留它们。
当你希望得到结构化答案而不是开放式讨论时,收紧提问:
I'm writing a paper about [topic] for [target journal]. My main finding is
[finding]. The closest prior work is [paper A] and [paper B], which concluded
[their conclusion]. State three candidate framings for my contribution, rank
them by novelty and defensibility, and name the strongest counterargument
against each.
Claude 在这方面表现出色,因为它更像思考伙伴,而不是写作机器。模型会对薄弱的表述提出反驳,给出你可能没想到的切入角度,并帮助你更清晰地阐明自己的贡献。
我们把它用在一位为混合方法研究而苦于定框架的博士后身上。仅用 20 分钟,她就发现自己的定性研究结果与一套被广泛引用的框架相互矛盾。这个重新定框架的思路,成了她论文的亮点。初次投稿即被接收。
工作流程 2:文献综述与研究空白识别
Claude 无法读取论文。我们需要把这一点说清楚:模型不能访问数据库,如果你要求它提供引用,它会编造引用。但是它可以对你提供的信息进行整合与归纳。
工作流程:
- 自己阅读你的来源。针对关键发现、方法和结论做笔记。
- 把这些笔记粘贴到 Claude。按主题或时间顺序整理。
- 让 Claude 在你的笔记中识别模式、矛盾和空白。
Here are my notes on 12 papers about [topic]:
[paste organized notes]

Synthesize these into 3-4 thematic paragraphs for a literature review.
Identify where authors disagree, where methods differ, and what questions
remain unanswered. Use (Author, Year) citation format. Do not add any
sources I haven't provided.
最后一条指令至关重要。没有它,Claude有时会插入听起来合理但完全虚构的参考文献。输出中的每条引文都必须是你在输入中提供过的。
我们发现,这套工作流程可以将文献综述的起草时间大约缩短50%。思考过程仍然是你的,也就是:该纳入哪些论文、哪些主题会浮现、空白在哪里。Claude会把你的思路组织成文字。
想获取为论文每个部分设计的更多提示,请查看我们的 经验证的学术写作 AI 提示 收藏。
工作流 3:起草并组织各章节
这就是 Claude 以传统意义上成为写作助手的地方。你有你的想法、你的数据、你的论点结构。你需要帮助把要点转换成段落。
我们建议采用逐章节的方法,而不是一次性要求 Claude 起草整篇论文。当你在单次回复中要求超过 800 到 1,000 个词时,质量会显著下降。
我们首选的流程:
- 提供一个大纲。 将你的章节结构发给 Claude,并在每个标题下用项目符号列出要点。
- 明确约束条件。 字数、时态、语态、文体(措辞风格)、引用格式。
- 一次只起草一节。 在进入下一节之前先审阅每一节。
- 在对话中反复迭代。 让 Claude 调整特定段落。把这一段压缩得更紧凑,把那一段扩写一下,让这个过渡衔接得更自然。
关键洞见在于,把 Claude 当成一名需要充分通报的代笔作者。"Write my discussion section" 会生成通用内容。"Write a 300-word paragraph comparing my finding X with Smith (2023) and Chen (2024), noting the methodological difference that explains the discrepancy" 则能产出真正有用的内容。
三个模板足以覆盖大多数写作会话。先在起草前为某一章节列出大纲:
Build a paragraph-level outline for the [introduction/discussion] of a paper
on [topic]. Audience: [field] researchers. The section must move from
[opening premise] to [closing claim] in no more than [N] paragraphs. For
each paragraph give a one-line purpose and the evidence it should cite from
my notes: [paste notes].
撰写一段方法段落,让它保持在你实际做过的范围之内:
Draft a [word count]-word methods paragraph describing [procedure]. Past
tense, passive voice, formal register, [citation style]. Include these
details exactly as given: [sample size, instruments, parameters]. Do not
add any procedure or measurement I have not listed.
并将结果转化为成文段落,同时不让模型对其进行理解。
Turn these results into two paragraphs of formal prose: [paste table or
bullet results]. Report every statistic exactly as written. Describe
patterns without interpreting them; interpretation belongs in the
discussion section.
工作流 4:修改与自我校对
写完初稿之后 无论是手写的 借助 Claude 的帮助 还是两者结合 Claude 都会成为一个强大的修订工具。
粘贴一段内容并提出有针对性的问题:
Review this paragraph for logical flow. Does the argument progress
clearly from premise to evidence to conclusion? Identify any gaps
in reasoning.
Reduce this paragraph from [current] to [target] words without losing any
claim, number, or citation: [paste paragraph]. Keep the academic register
and my terminology.
Read this section as a hostile reviewer for [journal]: [paste section].
List the five weakest points in order of severity, quote the exact sentence
each weakness lives in, and say what evidence or rewording would fix it.
上一条提示正是我们的最爱。Claude的“敌对审稿人”人格能够抓出逻辑断点、缺乏支撑的论断以及结构性薄弱之处,尤其是在你多次修改之后容易忽视的那些问题。它不可能覆盖所有真实审稿人会发现的点,但确实能抓住足够多的关键问题,值得你花五分钟。
我们也用Claude在提交前检查各部分之间的一致性:
Here are my abstract and conclusion: [paste both]. List every claim in the
abstract that the conclusion does not support, and every conclusion claim
missing from the abstract. Then check that every number appearing in both
matches exactly.
各部分之间的衔接不一致是修订阶段最常见的问题之一,而且当你在论文里浸泡了数周之后就很难察觉。
何时停止使用Claude并切换到其他工具
Claude是通用型工具。它能胜任许多任务,并且在某些方面表现出色。但在学术写作流程的特定环节,专用工具往往更强。
**用于校对:**切换到我们的AI 校对器。Claude可以发现语法错误,但它不会提供带跟踪的修改,也无法按句子进行系统性的逐条审阅。专用校对工具在提交级别的润色上更快也更彻底。
**用于摘要:**我们的AI 摘要生成器能以更系统的方式处理学术文本的压缩,也就是在保留关键发现、统计细节和引文信息方面更可靠,而Claude有时会遗漏这些内容。
**用于人性化AI辅助文本:**专用的人性化工具能够处理被检测器标记的特定模式。Claude无法有效“去模式化”自己的输出。即便被要求写得“更自然”,它仍会复现相同的统计特征。
**用于引文格式化:**使用Zotero、Mendeley或你的文献管理器。Claude会把引文格式化得看起来正确,但可能包含难以察觉的错误,例如日期格式不对、风格不一致,甚至偶尔编造出DOIs。
理想的工作流程是先用Claude用于思考与起草,然后再切换到专用工具进行打磨与最终定稿。专业写作就是这样运作的。
工作流程5:回应同行评审意见
审稿回复的结构与语气控制非常关键,而这正是语言模型擅长起草的内容。请粘贴审稿决定信以及逐条意见:让Claude将每一条独立批评提取成编号列表,为每一点起草一份中性的回复提纲,并标注哪些点需要新的分析而不是简单改写。请你自己掌握科学实质:论文改了什么、你捍卫什么、以及审稿人在哪些方面事实错误。模型的贡献是第一轮就能读起来平静、结构清晰的回应文件。一个提示就能把整体结构搭起来:
Here is the decision letter for my manuscript: [paste letter]. Extract every
distinct criticism into a numbered list. For each point, draft a two-sentence
neutral response skeleton and label it: revise, defend, or needs new analysis.
Do not invent any changes I have not described.我们的学术写作提示词集合包含更多现成可直接使用的审稿回复提示。
用于研究论文写作的三个 Claude 提示词
适用于研究论文写作的一个好 Claude 提示词,应当把你的自有材料交给模型,并明确一个清晰的任务,同时说明模型必须不要添加什么。使用以下三个提示词分别完成方法、文献综述与讨论,并把每个方括号占位符替换为你自己的文本。
- 方法:用于帮助你找到读者需要复现实验的方法内容:"把我的方法部分当作一位想要重复这项研究的研究者来读:[粘贴方法]。按部分顺序列出所有缺失或不清楚的步骤、设置、材料或分析选择。逐条引用每一项对应应出现的句子,并且不要重写这一整段。"
- 文献综述:用于了解每篇论文做了什么,以及差距在哪里:"基于我的阅读笔记建立一份文献矩阵:[粘贴笔记]。为每篇论文各给出一行,包含作者和年份、研究设计、样本、主要发现与主要局限。然后再写三句话说明这些论文留下的空白,并且只引用我笔记里的论文。"
- 讨论:用于根据你的发现起草局限性与启示:"我的主要发现是[粘贴发现],来自一个针对[样本与情境]的[研究设计]研究。起草一段局限性,逐条命名每一项局限,并说明它可能如何影响这些发现。接着为[受众]起草一段简短的启示。保留诸如“may”和“suggests”这类措辞,不要对我的发现并未显示的内容作出任何宣称。"
每个提示词都让 Claude 承担更窄的任务,并把关于你研究的关键决定留给你。在把 Claude 的回复纳入论文之前,请把它的每一条引文与每一个数字都与你的笔记逐一核对。
Claude、Cowork或Claude Code:哪个更适合科研工作?
Anthropic现在以三种主要形式提供Claude,选对哪一种取决于你的任务会产出什么。
**Claude(网页与桌面聊天)**是本指南中每一种工作流的正确工具:用于头脑风暴、基于你的笔记进行整合、起草各部分,以及进行修订。它是对话式的,能立即开始,并包含网页搜索。
用于知识工作的代理式选项是 Claude Cowork。这个代理内置在Claude桌面应用中。不需要任何设置。多步骤任务会由它自行处理(例如整理一份阅读笔记文件夹、基于十几篇论文制作对比表,或组装一份初版的带注释书目)。它在隔离环境中运行。这意味着它是处理敏感草稿时更安全的代理。当任务产出的结果是文档而不是对话时,Cowork通常会比聊天更占优势。
Claude Code在终端中运行,适合编写软件的人群。对研究者而言,它也同样有其位置,特别是在分析工作中:清洗数据、运行统计脚本、生成可复现实验图、在项目代码仓库中完成任务。如果你从不使用命令行,就跳过它;Cowork在无需额外设置的情况下,能够覆盖代理式的主要工作。
在检测器读取之前先把你的 Claude 草稿 Humanize
可确保引用安全的 Humanize,它能让你的学术语气、术语和含义保持不变。在使用 Claude 辅助草稿与正式提交之间的那一步。
试用 AI humanizer 免费版研究者应该选择哪款Claude模型?
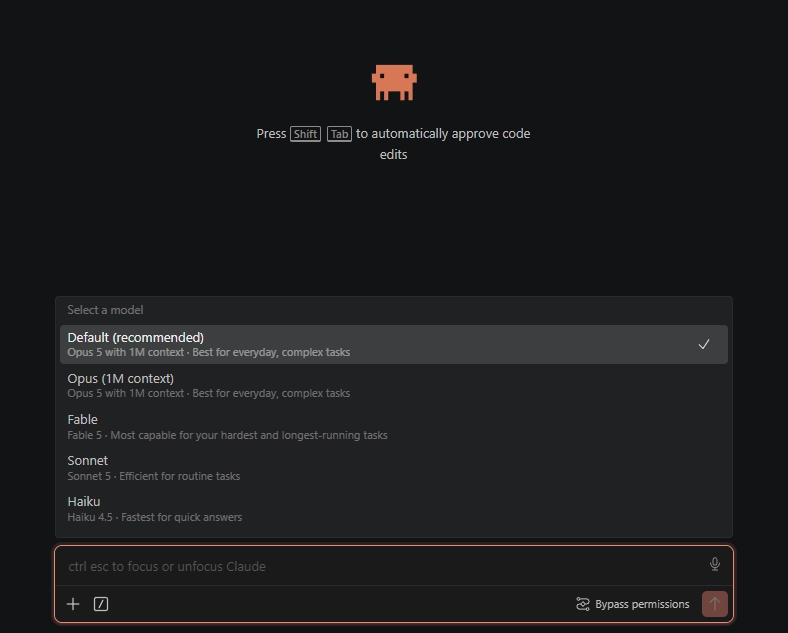
撰写本文时,该阵容的排序为:先是Fable 5,其次是Opus 5、Sonnet 5,以及快速且更便宜的Haiku 4.5。
Sonnet 5是日常写作工作的明智默认选择:列提纲、起草段落、生成修订提示。它速度快,而且质量上限覆盖了大多数论文的大多数部分。
当推理是最难的部分时,应选择 Fable 5:在文献中调和相互矛盾的研究结论、对方法论论证进行压力测试,或在通篇稿件保持上下文的同时检查内部一致性。它会更快消耗计划限制,所以请把它当作专门工具,用于那些值得它回答的问题。
Opus 5位于两者之间。它在长推理方面比Sonnet更强,而且全天运行的成本也比Fable更低。如果你的计划对最高模型的配额控制得很紧,Opus就是性能与成本的折中主力。
Haiku 4.5适合快速的机械性需求:重新排版、给出定义、修正时态。不要将它用于任何你需要引用或提交的内容。
2026年10月最适合学术写作的Claude模型
多数学术写作的最佳Claude模型是Claude Opus 5.5。它在Anthropic的模型指南中现在被推荐为大多数工作的起点。最新模型包括Fable 5.1、Opus 5.5和Sonnet 5.5。Anthropic建议在需要强推理和长时间运行任务时使用Claude Fable 5.1,或者当把Opus 5.5设置为更高的工作强度也仍无法得到足够好的结果时使用。
Anthropic将Claude Sonnet 5.5描述为速度与智能的最佳组合,这很适合常规列提纲与起草。Claude Haiku 4.5是最快的模型,用于快速格式调整和定义也完全没问题。
| 模型 | Anthropic的描述 | 上下文窗口 | 可靠的知识截止时间 | API 每百万输出令牌的价格 |
|---|---|---|---|---|
| Claude Fable 5.1 | 对复杂推理与长周期自主代理工作的高要求 | 1M 令牌 | 2026年6月 | US$50 |
| Claude Opus 5.5 | 持续运行的自主代理式编码与知识工作 | 1M 令牌 | 2026年6月 | US$20 |
| Claude Sonnet 5.5 | 速度与智能的最佳平衡 | 1M 令牌 | 2026年6月 | US$10 |
| Claude Haiku 4.5 | 最快的模型,接近前沿的智能 | 200K 令牌 | 2025年2月 | US$5 |
知识截止时间很重要。Haiku 4.5 的可靠截止时间是 2025年2月,因此不要依赖它来查阅你领域中较新的文献。其余三个模型的截止时间是 2026年6月,你仍应将它们提到的每一处资料都与论文原文逐一核对。
要在多来源之间进行文献综合,或对一整篇稿件做一致性核查,Fable 5.1 是最强的选择。日常起草时,Opus 5.5 或 Sonnet 5.5 就足够了。我们对按写作部分划分的学术写作最佳 AI 模型 的对比也同样覆盖了 ChatGPT 和 Gemini。
哪个 Claude 模型最适合用于研究论文写作?
Claude Opus 5.5 是最适合撰写研究论文的 Claude 模型。Anthropic 也建议你在大多数工作中以它作为起点。当任务需要在多种来源之间进行最困难的推理时,请使用 Fable 5.1;当任务范围界定得很清晰时,则用 Sonnet 5.5,它的价格是 Opus 的一半。
按研究论文任务划分的模型,并给出 Anthropic 的 API 输入价格(截至 2026 年 11 月):
| 研究论文任务 | Claude 模型 | API 输入价格(每百万 tokens) |
|---|---|---|
| 根据阅读笔记撰写文献综述 | Opus 5.5,或使用 Fable 5.1 来回顾多种来源 | US$4,或 Fable 5.1 为 US$10 |
| 方法与结果撰写 | Sonnet 5.5 | US$2 |
| 讨论与局限性 | Opus 5.5 | US$4 |
| 全文一致性检查 | Fable 5.1 | US$10 |
| 重排格式、提取细节与简短摘要 | Haiku 5.5 | US$0.10(适用于最多 100,000 tokens 的提示) |
在 Claude 应用中,Free 计划包含 Sonnet 和 Haiku,而 Opus 需要 Pro 或更高。Fable 通过 Pro 里的用量额度付费,更高的计划会把它包含在内,覆盖最多到每周上限的一半。
工作量等级:模型应该想得有多努力?
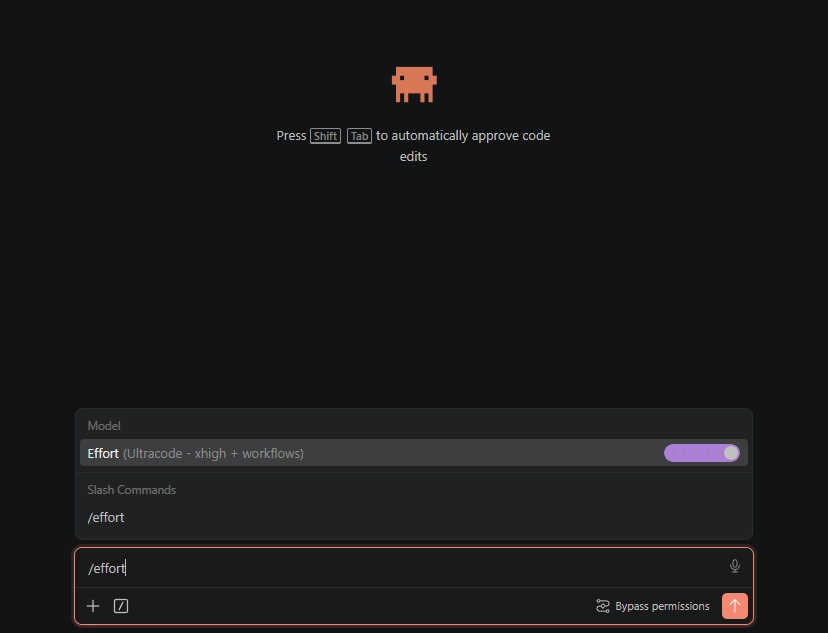
Claude 的自主代理工具提供了一个工作量设置,用于控制模型在回答前会投入多少推理:低、中、高、xhigh,以及仅限会话的上限。此外还有按提示的增强:在请求中包含单词 "ultrathink",那么这一轮会获得更深入的推理,而不会改变当前会话设置。
将工作量等级匹配到问题的权重即可。中等级足以完成机械式的整理。高等级适用于普通起草以及修订会话。将 xhigh 和上限留给真正需要承担较重分析的提问:例如将三十个来源进行综合、作出统计设计决策、对整篇稿件进行一致性核查。工作量越高,会消耗更多令牌并增加每次回答所需时间,因此把每个会话都固定在上限只会拖慢你的日常流程,并且不会带来收益。只有在进行必须高度准确的实际研究时才使用它。
何时压缩你的会话
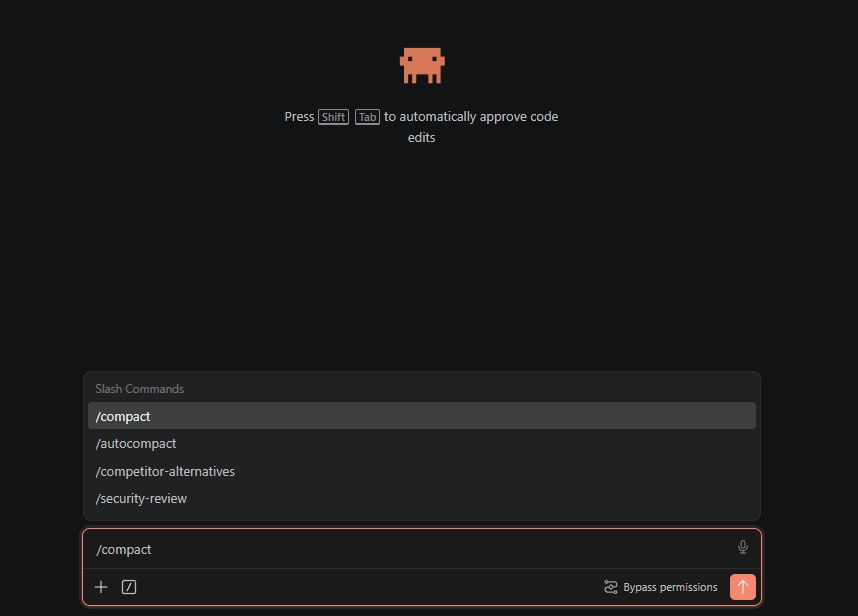
长对话会变差。每一条消息都会携带整个对话内容,因此一开始很敏锐的会话会越来越慢,并且当上下文窗口被填满后更早开始丢弃指令。研究者会把这体会为疲劳:处理你最初三条提示都非常精确的模型,到了第十五条就开始输出含糊的内容。
修复方法是“压缩”:把到目前为止的对话内容折叠成一份摘要,由模型在后续继续携带。有两条经验法则效果很好。每完成一项任务就进行压缩,放在文献部分结束、方法即将开始的自然衔接点。或者关注 token 计量器,大约在上下文用量的 25% 处就压缩,而不是等到工具被迫接近上限才处理。Anthropic 的官方建议也说同样的话:在任务边界主动压缩,而不是在质量已经下降之后才压缩。放在清晰边界处的压缩几乎不耗费成本;在任务中途被迫压缩会丢失你想保留的细节。
对研究人员来说,Claude Max 套餐是否值得?
Claude Pro 每月 US$20。Max 以 US$100 的档位推出,是 Pro 用量的 5 倍;US$200 的档位是 Pro 用量的 20 倍。若只是偶尔使用,每天只聊几次,Pro 已足够,Max 的富余空间就会被浪费。
如果是为了可靠、强度较高的研究工作,Max 当然值得。长文档的文献综述提炼、整部手稿的一致性检查,以及在 Cowork 或 Claude Code 中进行的代理式(agentic)会话都会很快消耗用量,而 Pro 的限制会在最关键的时刻打断这些会话。US$100 档通常能解决大多数个人研究者的日用上限。US$200 档则面向那些整天都在使用这些工具的人。若你在提交截止前一晚就因为卡住而付出的用量成本超过 US$100,那么算术自然就明白了。
针对学术研究人员,有没有免费的 Claude 套餐?
有。Anthropic 的Claude Team 给科学家的团队计划让经过验证的研究团队在开始阶段无需付费即可使用 Claude。获得资格的对象包括获认证的大学中的首席研究员(PI)以及非营利研究机构。该项目覆盖自然科学、数学、计算机科学、工程及相关领域,面向全球 10,000 名科学家开放。
经过验证的 PI 会获得一个 Claude Team 计划,并可免费为其团队在 Standard 座席中添加成员,或在 Premium 座席中添加成员,每月 US$15。Standard 座席通常为每月 US$20,Premium 座席为每月 US$100;促销价格从报名开始持续 12 个月。按年计费的成本为:US$0 或每席每年 US$180。Anthropic 表示名额有限,最终价格会在验证后确认。
| 座席 | 12 个月的价格 | 常规价格 | 包含内容 |
|---|---|---|---|
| Standard | 每月 US$0 | 每月 US$20 | Claude Science、Claude Code 和 Cowork、研究数据库连接器、共享项目、单点登录 |
| Premium | 每月 US$15 | 每月 US$100 | 包含 Standard 的所有内容,另加更多用量以及用于长分析的更高限制(使用量为 5 倍) |
团队座席数为 1 到 25 人,更大的团队可以联系 Anthropic。对大多数申请,验证需要 5 到 7 个工作日。当某个项目所需用量超出其座席允许的范围时,该团队可以通过 Anthropic 的 AI for Science 资助项目申请额外的额度。
如果你不在这些领域工作,或是独自使用,Claude Pro 每月 US$20,按年计费则为每月 US$17。无论你选择哪个计划,在提交前请先在我们的AI校对器里做一轮编辑校对。
为什么是 Claude,而不是 ChatGPT 或 Gemini?
就科研工作而言,Claude 目前已被证明在三款前沿助手中最可靠。到 2026 年,独立的准确度追踪机构将 Claude 的幻觉率估计在约 3%。而旗舰级的 GPT 与 Gemini 模型则接近其两倍。重要的不仅是表现出来的结果,还包括在不确定性下的行为方式:Claude 会更愿意承认“不知道”,而不是直接编造答案。自信地捏造是最会损害学术工作的失效模式。
两个前提。所有模型都会编造引用。一次 同行评审的 2026 对比 发现,三位助手都无法生成可核验的参考文献列表。这意味着模型所引用的任何内容,如果不经过核查,都不会凭空出现在你的论文里。如果你只是做一些基础的机械性工作,比如重新排列表格、快速转换内容,这三者之间差别不大。但在需要持续推理的情况下,差别就会显现,而你的推理要建立在你自己的来源之上。
Claude适合写论文吗?
是的,当你把Claude用于规划、获取反馈并在自己撰写论文的同时进行修改时,它很适合写论文。它可以根据一个提示生成一篇流畅的论文,但这类文章往往显得比较通用,而且大多数大学不接受将AI生成内容当作“你自己完成的作业”提交。把Claude用于论文写作,最适合作为导师和编辑工具。
四种用法很适合用于论文:
- 测试你的论题陈述:要求它给出最有力的反驳以及你需要的证据来回应它。
- 获取对你写的段落的反馈:让它就清晰度、证据与逻辑给出意见,但不要改写。
- 检查结构:把你的提纲粘贴进去,询问论证哪里跳过了某一步。
- 精炼措辞:让Claude标出草稿中冗长的句子,然后由你自己完成编辑。
Anthropic给学生的示例提示遵循同样的思路:"我正在写一篇论文。每写完一个段落后,我会对它进行分析:1)清晰度,2)证据质量,3)逻辑。"
在你开始之前,先查看你课程的AI政策,并在它要求时披露AI使用情况。最后再做一次检查,我们免费的essay checker会修正语法、拼写和标点,并一次给出250词的结构、清晰度与学术语气方面的简短反馈。
使用 Claude 且避免被 AI 检测
Claude 起草的文本会呈现 AI 检测器所寻找的统计特征,而越来越多的高校会将投稿通过 Turnitin 的 AI 指示器进行检测。下面三条做法能让你更安全。把 Claude 用在思考类工作上(例如搭建结构、提出批评、总结来源),并在政策要求你这样做时自行撰写最终正文。按你的期刊或机构要求披露 AI 协助;我们的 AI 披露声明指南 提供模板。并且在政策允许 AI 辅助起草时,你需要把输出修改成你自己的表达方式,或通过 an 学术文本 humanizer 处理,同时保留引用与术语。然后在投稿前再把结果与检测器核对一次。你不应该做的是提交原始模型输出:它被检测到的失败率很高,而且对于熟悉你写作风格的考官来说,读起来就是通用的“套话”。
Claude 在学术写作中常见的错误
透明度很重要。下面是我们看到 Claude 失败的具体环节:
引用。 Claude 会生成看似合理的作者姓名、期刊名称以及并不存在的发表年份。绝不要让 Claude 提供你未核验的参考文献。或者,你可以让它真正去核验该引用是否存在,并提供对应的 DOI,这样你后续可以逐条访问 DOI 来确认每一条引用确实存在。
领域特定的规范。 Claude 可能会忽略你所在学科的专门惯例。你对本领域的规范比 Claude 更了解,应该以你的专业判断优先于模型输出。
定量表述。 Claude 有时会引入你原始数据中并不存在的统计性说法。如果出现了你并未提供的数字,请务必核查。
语气校准。 Claude 的文字写得不错,但它不会写出“像你一样”的文风。你需要始终进行一次语气调整,也就是把通用的表述替换成你自己的表达习惯。你的导师会定期阅读你的写作。它应该听起来像你。
这些并不是让你避开 Claude 的理由。它们只是提醒你要在监督之下使用。
常见问题
Q: 在学术写作中使用 Claude 是否被高校接受?
这取决于你所在机构的政策。大多数高校会区分把 AI 作为写作工具使用(通常在披露前提下可接受)与将 AI 生成内容直接当作自己的成果提交(通常不被接受)。例如用 Claude 做头脑风暴、列大纲、起草,然后再修改并加入你的个人表达,这属于工具使用范畴。务必查看你的准则,并在需要时进行披露。
Q: Claude 在科研写作方面如何与 ChatGPT 相比?
Claude 更擅长处理长文档和更具细微差别的指令。它在遵守格式要求方面更可靠,也不太容易编造不实说法。ChatGPT 往往在诸如表格重排这类机械性任务上更擅长。对于核心写作任务,我们更看重 Claude 的优势,但两者都能用。查看我们的 AI 提示用于学术写作,获取跨模型同样有效的提示。
Q: Claude 能写完整的一篇研究论文吗?
从技术上说可以。可是否应该这样做呢?不建议。一口气生成的整篇论文质量,通常明显低于在每个阶段都由研究者参与输入、按章节逐步开发完成的论文。你的数据解读、理论框架和论证构建都需要由你来完成。当你指挥思想内容时,Claude 最有价值的是负责写作的机械部分,例如结构安排、措辞优化、用词精炼程度。
Q: 我用 Claude 起草的文本会被 AI 检测器标记吗?
大概率会,尤其是在你不加编辑就直接提交原始输出时。Claude 的写作模式可以被 Turnitin 和 GPTZero 等工具识别。解决办法是将 将 Claude 起草内容人性化,让它符合你的表达方式,也就是加入你的声音,变化句式结构,并进行一轮人性化处理。经过充分编辑、个性化并复核后的 Claude 草稿,通常能在检测阈值以下获得较好成绩。
Q: 高校能检测出用 Claude 写的文本吗?
检测器无法判断是哪个模型写出了某段文字,但 Claude 的原始输出与其他模型的输出一样,带有相同的统计规律,而 Turnitin-grade 检测器往往会以较高比例将其标记。检测风险取决于提交时保留下了多少未编辑的模型文本,而且它对每个模型同样适用。因此,在任何需要提交之前,最好对 Claude 的原始输出进行人工精修。
Q: 哪个 Claude 模型最适合学术研究?
日常起草与修改选 Sonnet 5,当推理真的很难时选 Fable 5,例如跨来源综合、方法批判,或把整篇手稿放在同一语境中把握。Opus 5 适合在分段且有节奏的计划中进行较长的会话,而 Haiku 4.5 只适合快速的机械性任务。无论选择哪个模型,都要在内容进入你的手稿之前核对每一条引文与每一个数字。
Q: 你应该多久压缩一次长时间的 Claude 会话?
在每个已完成的任务边界压缩一次,或当上下文使用量达到约 25% 时压缩,以先到为准。将对话压缩成模型可继续携带的摘要,以保持回答更精准,并防止长会话造成的逐步遗忘指令。等到工具被迫逼近上下文上限时通常意味着质量已在下降,而你关心的细节也会随之减少。
Q: 有面向学术研究者的 Claude 免费方案吗?
有。Anthropic 的 Claude Team 面向科学家的团队方案允许经过验证的首席研究员无需付费启动 Team 计划。他们的团队可以加入免费的 Standard 席位,或以 US$15 的 Premium 席位加入,且 Premium 价格相较 US$20 的常规定价和每月 US$100 的价格有折扣,优惠持续 12 个月。该方案适用于获得认证的大学以及科学、数学、计算机科学与工程领域的非营利研究机构。
Q: 今天哪个 Claude 模型最适合学术写作?
对大多数学术写作来说,Claude Opus 5.5 是最好的起步选择,它也是 Anthropic 为大多数工作推荐的模型。如需更深入的推理,例如同时协调多份资料,可以使用 Claude Fable 5.1。Sonnet 5.5 适合常规的提纲整理与起草,而 Haiku 4.5 只适用于快速格式调整。
Q: Claude Pro 对学术研究来说够用吗?
Claude Pro 足以满足大多数个人研究者的写作与修改需求。它的费用是每月 US$20,按年计费则为每月 US$17。若你在理工科带领研究团队,按照 Anthropic 的说法,科学家项目中的免费 Standard 席位在使用量上通常比 Pro 更划算。
Q: Claude Haiku 4.5 了解近期研究吗?
不,Claude Haiku 4.5 的可靠知识截止时间是 2025 年 2 月,因此对近期研究掌握得不够好。Opus 5.5、Sonnet 5.5 与 Fable 5.1 的知识截止时间是 2026 年 6 月。用 Haiku 做快速编辑,并将任何关于近期文献的内容与您自己的资料逐一核对。
可安全处理引用的人类化表达,能保持你的学术语气。让你的 Claude 辅助草稿和任何 AI 检测之间存在一道步骤。
Moe 是一名 NLP 工程师,拥有自然语言处理领域的 PhD 学位。 他的研究涵盖计算语言学、文本分析和机器学习,并直接反馈到 ProofreaderPro 背后的编辑和人性化模型中。 他写了大多数人从未见过的过程的一部分:语言模型如何读取句子、对其进行评分并决定更改哪些内容。