
面向阿根廷研究者的英文AI人类化写作工具
面向阿根廷研究者的AI人类化工具。降低受西班牙语影响的英文所触发的误报型AI检测标记,保留原意与引用,并如实披露。

阿根廷每年发表的Scopus收录论文数量在18,000到22,000篇之间,全球排名约在第40到45位,且在拉丁美洲仅次于巴西和墨西哥。如今,这项工作中的许多内容都从某个环节开始借助AI助手:由ChatGPT勾勒出初稿轮廓,由Claude润色并收紧段落、从西班牙语翻译并打磨出更顺畅的表达。这很常见,而且大多数期刊在你进行披露时是允许的。
麻烦通常出现在之后。之所以需要一款面向阿根廷研究者的AI人类化工具,是因为AI检测器往往会把经过认真打磨的二语英文误读为机器写作;而阿根廷作者则需要为那些仅仅“干净、规范、正确”的文句付费。
阿根廷在EF英语能力指数上的得分为562,是拉丁美洲最高。高英语能力并不能在这里保护你。恰恰相反,经过多年正式学习所形成、精炼且符合课本规范的英文,往往正是检测器最可能进行标记的写作类型。
面向阿根廷研究者的AI文本人类化(Humanizador de texto de IA)
我们的AI文本人类化工具帮助阿根廷研究者以更高的安全性用英语发表。重写你自己经过AI协助的初稿,使你细致的英语不被误认为是自动生成文本,同时保留你的含义、技术术语和引用。
通俗地说:科学内容由你来写,你保留原意;文本人类化工具会调整节奏与措辞,使那些受西班牙语影响的、经过认真打磨的英语,看起来就像它本来就是人类所写。它支持超过60种语言,并让非英语文本通过一个具备语言感知能力的模型进行处理,从而保留句子结构。
这并不是为了隐瞒任何东西。关键在于:在你将稿件提交之前,先让真实的工作得到公平的阅读;并按照你的机构与期刊所要求的方式,如实披露你的AI使用情况。
用西班牙语写作?会被自动识别并直接人类化
阿根廷许多研究者在用英语成稿之前,往往会先用西班牙语起草;而该人类化工具能够直接支持这一流程。你只需粘贴西班牙语文本,ProofreaderPro会自动识别语言,然后通过一个“西班牙语感知”的模型进行处理:把你的术语、重音与引用完全按原样保留下来。借助AI文本人类化(humanizador de texto de IA),你的西班牙语初稿可以像英文一样被人类化,不会先被翻译。相同的检测覆盖超过六十种语言,并且每一种语言都会以其自身的表达方式被改写。
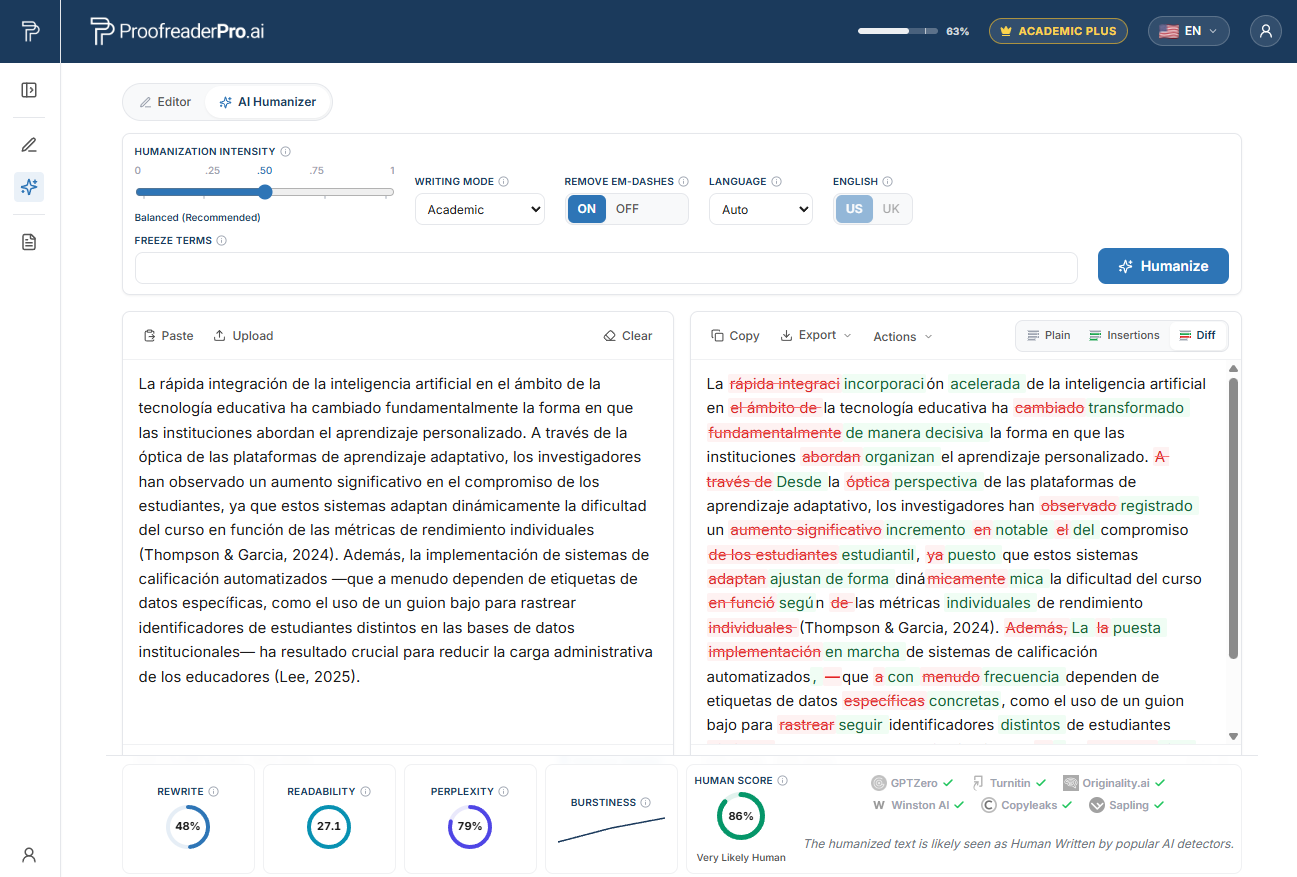
ProofreaderPro AI Humanizer对西班牙语学术文本的改写示例。处理前后差异保持了你的含义与引用;检测检查结果确认读起来更像自然的人类表达。
为什么阿根廷研究者会被AI检测器标记
在2023年,斯坦福团队(由Liang及其同事牵头)在Cell Press旗下期刊Patterns发表了一项研究,题为“GPT detectors are biased against non-native English writers.” 他们将人工撰写的TOEFL作文输入到七种被广泛使用的检测器中。结果显示:平均而言,非母语作者的作文约有61%被标记为AI;而母语作者的作文约为5%。几乎五分之一的非母语作文会被每一种检测器同时标记。所有作文均由真实写作者完成。
其机制是“困惑度(perplexity)”。许多检测器会根据语言模型,对每一种词汇选择的“出人意料程度”进行打分。谨慎的二语写作者往往会使用常见词汇与标准、可预测的措辞,从而产生较低的困惑度,这会让文本读起来像机器生成内容。那些让阿根廷学术文风清晰且稳妥的写作习惯,恰恰也是这些工具被训练用来“不信任”的习惯。
我们在为什么AI检测器会标记非母语作者中对这一失效模式做了深入解释。简而言之:检测器的“标记”是对词语模式的统计性猜测,而不是关于你的论文究竟如何写成的证据。
西班牙语母语者背后的“误报触发”模式
阿根廷的英语能力水平意味着这些标记并非来自明显的错误。真正问题在于:熟练作者为了保持正确性而做出的谨慎、标准化选择;而“标准化程度”本身正是降低困惑度的关键。下面是一些会把阿根廷英语推向“机器式”特征的模式。
最安全的冠词使用规则:适用于各处。 西班牙语在使用抽象名词时使用确定冠词的频率远高于英语(“la investigacion demuestra que la desigualdad afecta la educacion”)。阿根廷作者学习到:在概括性表述中要去掉这些冠词,然后再把纠正后的规则在所有句子中一体化地应用。结果是非常“教科书式”、几乎没有变化的名词短语;而这正是模型所期望、也最容易与机器文本特征相匹配的结构。
典型的形容词排序。 西班牙语把形容词放在名词之后;英语则把形容词放在名词之前并进行堆叠。经过训练的作者会把“un analisis estadistico multivariado robusto”固定译为“a robust multivariate statistical analysis”,并在每一次写作中都遵循相同的顺序。由此带来的“僵化正确性”从构造上就低于“惊讶度”。
每个“假朋友(false friend)”最稳妥的同义词。 为了躲避falsos amigos(如“actual,” “realizar,” “eventualmente,” “sensible,” “pretender”),谨慎的作者会选择最常见、最不容易引起歧义的英文词。反复选择“最高概率”的同义词,会把词汇多样性压平,从而让检测器把它更倾向于判读为人类写作。
每次只用一个“字典正确”的介词。 了解西班牙语迁移会产生“consist in,” “depend of,” “interested on,” “different to”之后,作者会把用法固定为“consist of,” “depend on,” “interested in,” “different from”。始终只选择同一个标准搭配,而不是选择任何可能更“出人意料”的表达。
机械化的时态选择。 里奥普拉塔(Rioplatense)西班牙语更倾向于使用一般过去时,因此阿根廷作者会在方法与结果部分有意识地套用英语的现在完成时与一般过去时规则。只要这种“有规则可依、刻意使用”的时态策略保持一致与可预测,就会被读作低困惑度文本。
最大程度的正式化。 阿根廷学术文体通常更偏正式,因此作者会使用最标准、最保守的措辞。最“安全”的句子也往往是最“符合预期”的句子;而符合预期的文风,正是检测器会判定为机器生成的风格。
阿根廷的AI检测与Turnitin语境
在阿根廷,论文答辩、职业发展材料以及期刊投稿通常会使用Turnitin或iThenticate进行筛查,既关注相似度,也关注AI相关指标。CONICET的评估委员会、大学的终身教职流程以及国际期刊,都在某个环节嵌入这一“流水线”,因此一名研究生与一名资深研究者可能会遇到同一种检测器。
了解供应商如何描述他们自己的工具也很有帮助。Turnitin会把1到19%范围内的AI得分“压低”,显示的是星号而不是具体数值,并警告说:该分数不应单独用于诚信决策。一些高校走得更远:例如Vanderbilt在2023年因误报与对非母语作者存在偏差而禁用了Turnitin的AI检测功能;密歇根州立大学、UT Austin、Northwestern、Pittsburgh、SMU以及Waterloo也采取了类似措施。
对这段历史更公平的解读并不是“检测器毫无意义”,而是:一个分数是一项可以提出争议的主张,而不是裁决结论。同时,资助方与期刊越来越要求你披露AI协助。两者指向同一个方向:避免细致写作被误读,并对你使用的工具保持透明。
顶尖阿根廷高校及AI检查出现的位置
阿根廷的公立大学体系规模大,本科阶段免费;研究通常集中在国家层面的大学与CONICET研究机构,且这些机构常常与校园共址。这些学校是该国领先的研究产出主体,并且各自都会对论文答辩与稿件进行相似度与AI相关指标筛查。
- Universidad de Buenos Aires (UBA),布宜诺斯艾利斯,毫无疑问是最大的产出者,占全国约40%的产出。
- Universidad Nacional de Cordoba (UNC),科尔多瓦,1613年创立,是美洲最古老的高校之一;在天文学、物理学和化学方面优势突出。
- Universidad Nacional de La Plata (UNLP),拉普拉塔,在基础与自然科学领域是重要中心,拥有多个CONICET研究单位。
- Universidad Nacional de Rosario (UNR),罗萨里奥,在医学、生物化学与农业科学方面表现突出。
- Universidad Nacional del Litoral (UNL),圣菲,在化学工程、食品技术与生物技术方面实力强。
- Universidad Nacional de Cuyo (UNCuyo),门多萨,西阿根廷的主要研究型大学。
- Universidad Tecnologica Nacional (UTN),多校区办学,是该国按在校人数计算最大的院校,聚焦工程与技术。
- Universidad Austral,布宜诺斯艾利斯周边地区,一所实力强的私立大学,在医学与生物医学工程方面表现突出。
- Universidad Nacional del Sur (UNS),巴伊亚布兰卡,在化学、化学工程与地球科学方面较强。
- Universidad Nacional de San Martin (UNSAM),布宜诺斯艾利斯省,生物技术与纳米技术发展迅速。
- Instituto Balseiro,巴里洛切,阿根廷顶尖的物理与核工程研究所,小而精,但产出异常高。
- Instituto Tecnologico de Buenos Aires (ITBA),布宜诺斯艾利斯,一所私立工程学院,在计算机与数据科学方面优势突出。
在上述每一所机构中,CONICET的职业晋升与ANPCyT的资助竞争都使英语语言的发表成为一种职业必需品;这意味着每年会有更多稿件经过更多检测器。
面向阿根廷研究者的AI人类化工具如何工作
面向阿根廷研究者的AI人类化工具是工作流程中的最后一步,而不是绕开单一环节的捷径。下面是我们建议的步骤顺序。
首先,起草。许多阿根廷研究者用西班牙语进行思考更自然,因此可以先用西班牙语列出论证框架,再翻译成英语(我们的AI翻译器会保留引用)。其次,校对语法,确保上文提到的“文章/介词/假朋友”等模式确实是正确的。第三,把你自己经过AI协助的英文文本交给文本人类化工具,让那些谨慎、低困惑度的写作更不容易被误读为机器生成输出。
该人类化工具会保留你的含义、技术术语和引用。它会调整节奏与用词,打断反复的节律,并去除AI初稿容易遗漏的破折号(em dashes)。
在测试方面,我们给出的是具体结果而不是承诺。与主要检测器进行测试时,我们的人类化工具会把AI文本改写成更自然的人类表达,从而降低AI信号,并提高其面对严苛检测器的成功几率;同时确保学术文本中的语法准确性保持较高。以上是测试结果而非保证,而且检测器每隔几个月就会重新训练,所以没有任何可信工具能够承诺你永远不会被检测到。
随后,进行披露。按照你的机构与目标期刊所要求的格式说明你的AI使用情况。谨慎写作在免于“误报标记”的同时完成完整披露,这正是让你始终处于学术诚信规则之内的关键。如果你想把这一做法与“由真人主导的修改”进行对比,见面向阿根廷研究者的学术编辑;如需了解覆盖整个国家群体的完整方案,请访问multilingual AI humanizer hub。
本地资助机构、期刊与AI披露的预期
正是有两类机构的“发表压力”把阿根廷研究者推向检测器。**CONICET(Consejo Nacional de Investigaciones Cientificas y Tecnicas)**在一个五层职业体系中雇用了超过11,000名研究人员,且晋升取决于在Scopus与Web of Science收录期刊上的持续发表。**ANPCyT(Agencia Nacional de Promocion de la Investigacion, el Desarrollo Tecnologico y la Innovacion)**管理竞争性资助项目,其中最引人注目的是PICT(Proyectos de Investigacion Cientifica y Tecnologica)项目;在每一次评估中,它都非常重视国际发表。
阿根廷也拥有深厚的期刊传统,其中许多期刊收录于SciELO Argentina,并且越来越多地进入Scopus与Web of Science。阿根廷作者熟知的期刊包括:
- Medicina (Buenos Aires),拉丁美洲最受尊敬的医学期刊之一,收录于PubMed与Scopus。
- Ecologia Austral,来自阿根廷生态学协会。
- Latin American Applied Research,由Universidad Nacional del Sur与CONICET出版。
- Revista de la Union Matematica Argentina,该地区历史最悠久的数学期刊之一。
- Ameghiniana,聚焦古生物学与地质科学。
- Electronic Journal of Biotechnology,以拉丁美洲为重点方向。
随着这些期刊寻求或维持Scopus收录,它们越来越偏好英文;同时,和国际同行一样,它们越来越要求你提供AI协助声明。请用清晰直接的方式写明披露内容,点名你使用的工具,并描述它们做了什么。如果你在十分谨慎的情况下,某个检测器仍对真实工作做出标记,那么对“误报型AI检测标记”提出申诉的流程会指导你如何整理证据,以及在与委员会沟通时采取怎样的语气。
常见问题
Q:面向阿根廷研究者的AI人类化工具能帮助我作弊Turnitin吗?
不可以。它用于你的“自己完成的AI协助初稿”;其目的,是避免把经过认真打磨的二语英语误读为机器文本。你仍需要保留你的含义与引用,并且仍需向你的机构与期刊披露你的AI使用情况。用“避免误报”来保护真实工作,并不等同于“伪装”真实工作。
Q:人类化会改变我的含义、技术术语或引用吗?
不会。该人类化工具会在保留你含义、技术术语以及参考文献的同时,调整节奏与措辞。它的设计目标是平滑那些会让检测器“踩雷”的统计模式,而不是改写你的科学内容,也不是移动你的引用。
Q:它实际通过AI检测器的效果如何?
与主要检测器相比,我们的人类化工具会把AI文本改写成更自然的人类表达,从而降低AI信号,并提高其在面对严苛检测器时的成功概率,同时保持较高的语法准确性。这些是测试结果而非保证。由于检测器经常重新训练,所以任何严肃工具都无法承诺你永远不会被标记。
Q:我的英语本来就很强。为什么还会被检测器标记?
强且规范的英文本身就是问题的一部分。检测器会对困惑度进行评分;而谨慎、可预测、符合课本规范的措辞往往会被判定为低困惑度文本,于是它们会把这种写作风格与机器写作关联起来。阿根廷的高英语能力可能会让你的文风更为一致,而不是降低被标记的可能性。
Q:如果我对初稿进行了人类化处理,还需要披露AI使用吗?
需要,而且必须。披露与人类化解决的是两个不同问题。人类化保护细致写作免于被误读;披露则让你对资助方、委员会与期刊保持责任。每一次都要两者都做。
面向阿根廷研究人员,使用英语投稿:在保留含义、术语和引文完整的前提下,降低您AI辅助工作中的错误AI标记,然后自信地按要求披露。

Moe 是一名 NLP 工程师,拥有自然语言处理领域的 PhD 学位。 他的研究涵盖计算语言学、文本分析和机器学习,并直接反馈到 ProofreaderPro 背后的编辑和人性化模型中。 他写了大多数人从未见过的过程的一部分:语言模型如何读取句子、对其进行评分并决定更改哪些内容。


