
AI Humanizer cho các nhà nghiên cứu Hy Lạp viết bằng tiếng Anh
AI humanizer cho các nhà nghiên cứu Hy Lạp. Giảm các cảnh báo phát hiện AI sai trên tiếng Anh chịu ảnh hưởng của tiếng Hy Lạp, giữ nguyên ý nghĩa và trích dẫn, đồng thời công bố một cách trung thực.

Một nhà vật lý tại Đại học Kỹ thuật Quốc gia Athens soạn phần phương pháp bằng tiếng Anh, kiểm tra từng bài báo và từng thì hai lần, rồi nộp cho một tạp chí được lập chỉ mục trong Scopus. Vài tuần sau, một đồng tác giả chuyển tiếp ghi chú của biên tập viên: một bộ phát hiện AI tự động đã gắn cờ một phần bản thảo là “được viết bằng máy”. Cô đã tự viết từng câu.
Tình huống này giờ đã khá phổ biến, đến mức nó định hình cảm giác thận trọng của nhiều nhà nghiên cứu trước khi nộp bài. Một AI humanizer cho các nhà nghiên cứu Hy Lạp tồn tại để giải quyết vấn đề đó, và lý do nó cần thiết lại nói nhiều hơn về các bộ phát hiện so với chất lượng chữ viết.
Nghiên cứu Hy Lạp mạnh ở kỹ thuật, khoa học máy tính, vật lý, y học và các ngành kinh điển, và nhiều công trình tiếp cận thế giới bằng tiếng Anh trong khi việc tư duy và các bản nháp đầu tiên diễn ra bằng tiếng Hy Lạp. Tiến độ và đánh giá đơn vị đề cao các công bố trên Web of Science và Scopus, nên áp lực phải viết tiếng Anh rõ ràng không bao giờ giảm. “Mấu chốt” là: tiếng Anh thứ hai rõ ràng, chuẩn mực chính là đúng kiểu văn bản mà các công cụ này thường xuyên hiểu nhầm nhất.
Humanising AI text cho các nhà nghiên cứu Hy Lạp (εξανθρωπισμός κειμένου AI)
AI humanizer của chúng tôi giúp các học giả Hy Lạp xuất bản bằng tiếng Anh mà không bị hiểu nhầm là văn phong “mô phỏng máy” dù là văn viết cẩn thận, chịu ảnh hưởng bởi người bản ngữ. Nó hoạt động trên bản nháp có hỗ trợ AI của bạn, giữ nguyên ý nghĩa và trích dẫn, đồng thời thay đổi nhịp điệu câu và cách chọn từ, những thứ mà các bộ phát hiện hay “soi” vào. Bạn có thể thử trên text humanizer với bất kỳ đoạn văn nào đã bị gắn cờ không công bằng.
Hướng dẫn này là một “nút” trong một cụm trung tâm AI humanizer đa ngôn ngữ bao phủ cùng vấn đề trên hơn sáu mươi ngôn ngữ, bởi mô-típ gắn cờ sai lại lặp đi lặp lại ở bất cứ nơi nào người ta viết tiếng Anh học thuật như một ngôn ngữ thứ hai.
Soạn thảo bằng tiếng Hy Lạp? Bộ humanizer cũng phát hiện và xử lý được
Không phải bản thảo nào cũng bắt đầu bằng tiếng Anh, và AI humanizer cũng không yêu cầu như vậy. Dán văn bản tiếng Hy Lạp và ProofreaderPro sẽ tự động nhận diện bảng chữ cái Hy Lạp, rồi chuyển qua một mô hình nhận biết ngôn ngữ để giữ nguyên như đã viết các thuật ngữ, dấu trọng âm và trích dẫn của bạn. Với tư cách là εξανθρωπισμός κειμένου AI, nó viết lại trực tiếp văn xuôi tiếng Hy Lạp của bạn, để bạn có thể “humanize” trước khi dịch. Cơ chế phát hiện tương tự cũng áp dụng cho hơn sáu mươi ngôn ngữ, mỗi ngôn ngữ được viết lại như chính nó.
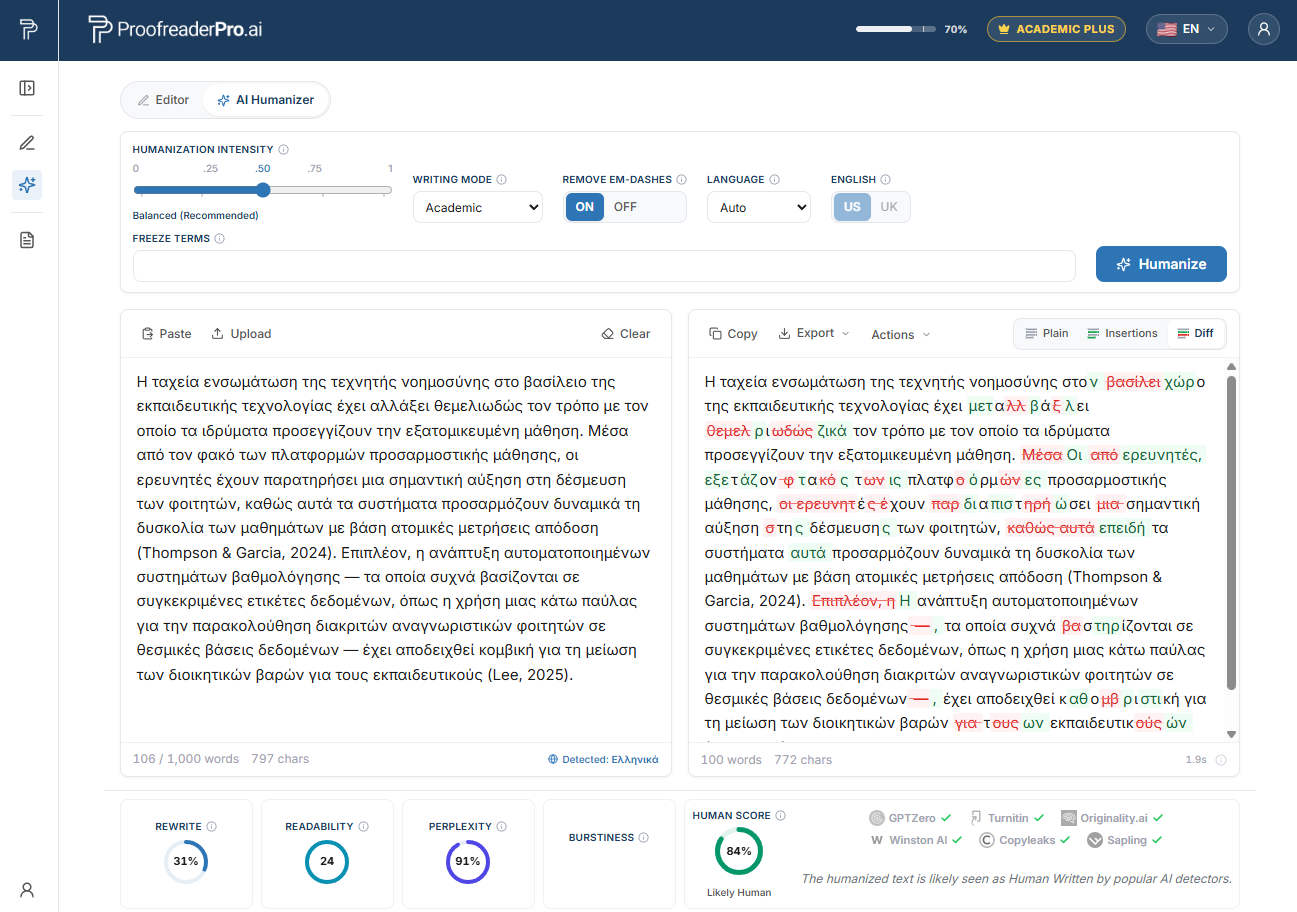
ProofreaderPro AI Humanizer viết lại văn bản học thuật tiếng Hy Lạp. Phần chênh lệch trước và sau giữ nguyên ý nghĩa và trích dẫn, còn các kiểm tra của bộ phát hiện xác nhận rằng bản đọc lên nghe tự nhiên như con người.
Vì sao các nhà nghiên cứu Hy Lạp bị các bộ phát hiện AI gắn cờ
Hãy bắt đầu từ nghiên cứu đã lượng hóa vấn đề này. Năm 2023, một nhóm tại Stanford do Weixin Liang dẫn dắt đã công bố “GPT detectors are biased against non-native English writers” trên tạp chí Patterns của Cell Press. Họ lấy các bài luận TOEFL do người viết và sau đó chạy qua bảy bộ phát hiện AI phổ biến.
Kết quả bị lệch rõ rệt. Trung bình, khoảng 61% các bài của người không phải người bản ngữ bị gắn cờ là AI, so với xấp xỉ 5% với người viết tiếng Anh bản ngữ. Gần một phần năm bài của người không phải người bản ngữ, khoảng 19,8%, bị mọi bộ phát hiện trong tập dữ liệu gắn cờ đồng nhất. Tất cả những bài luận đó đều có tác giả là con người.
Cơ chế này được gọi là perplexity (độ “ngạc nhiên” của chuỗi từ). Nhiều bộ phát hiện chấm điểm xem từ tiếp theo trong câu “gây bất ngờ” đến mức nào theo mô hình ngôn ngữ, và văn bản được xây dựng từ các từ phổ biến theo trật tự dự đoán sẽ có điểm perplexity thấp. Perplexity thấp được đọc như văn bản do máy tạo. Một nhà nghiên cứu Hy Lạp cẩn thận chọn từ vựng chuẩn mực và các mẫu câu an toàn đang tạo ra chính kiểu văn phong mà bộ phát hiện được huấn luyện để không tin tưởng. Chúng tôi đi sâu hơn về cơ chế thất bại này trong why AI detectors flag non-native writers.
Các mô-típ ngôn ngữ tiếng mẹ đẻ của Hy Lạp đứng sau cảnh báo sai
Không có thói quen nào dưới đây là lỗi. Chúng là các cấu trúc đúng chuẩn và thông dụng, chính vì vậy mà chúng làm giảm perplexity và khiến bộ phát hiện gắn cờ.
Các mạo từ là ví dụ rõ nhất. Tiếng Hy Lạp dùng mạo từ xác định với danh từ trừu tượng, tên riêng và các danh từ chỉ loại, nên tiếng Anh do người nói Hy Lạp viết sẽ điền tự nhiên mạo từ “the”: “the science shows”, “the Professor Papadopoulos argued”, “the nature of the problem”. Mỗi cụm đều đúng ngữ pháp, và việc chúng xuất hiện dày đặc theo thời gian lại rất đều đặn.
Thì và khía cạnh tạo ra tín hiệu thứ hai. Tiếng Hy Lạp đánh dấu khía cạnh theo những cách mà tiếng Anh không làm, vì vậy lựa chọn giữa hiện tại hoàn thành và quá khứ đơn, hoặc giữa các dạng đơn và liên tục, có thể “ra” khá đều và dự đoán được xuyên suốt một đoạn. Bộ phát hiện đọc sự đều đặn đó như một mô-típ thay vì như dấu hiệu của một người đang đưa ra lựa chọn.
Độ dài câu cũng quan trọng. Phong cách học thuật tiếng Hy Lạp ưu tiên các câu dài, liên kết chặt bằng những liên từ nặng, vì thế “moreover”, “furthermore” và “in addition” chồng lên nhau ở các “mối nối” của một lập luận. Những liên từ đó cũng nằm trong nhóm từ có xác suất cao mà mô hình kỳ vọng sẽ thấy ngay tiếp theo, khiến perplexity tiếp tục giảm sâu hơn.
Thêm hai hiệu ứng chuyển dịch hoàn thiện bức tranh. Trật tự từ mang theo từ một ngôn ngữ có trật tự từ linh hoạt hơn, tạo ra các câu được “đưa lên” theo chủ đề (topicalised) nhưng đúng về hình thức lại đồng dạng. Và các lựa chọn chuyển tự (transliteration), khi tên riêng và thuật ngữ kỹ thuật chuyển ra khỏi bảng chữ cái Hy Lạp, lại bổ sung thêm một lớp tính quy chuẩn. Gộp lại, những đặc điểm này làm cho tiếng Hy Lạp-Anh “thật lòng” trông, theo góc nhìn của bộ phát hiện, quá trơn tru một cách đáng ngờ.
Bối cảnh phát hiện AI và Turnitin của Hy Lạp
Luận văn và bài nộp tạp chí từ các cơ sở giáo dục của Hy Lạp thường xuyên được sàng lọc. Việc kiểm tra tương đồng với Turnitin hoặc iThenticate là thực hành tiêu chuẩn cho luận văn và bản thảo, và các nền tảng tương tự nay cũng hiển thị các chỉ báo viết bằng AI bên cạnh điểm số tương đồng.
Nhiều trường đại học trên khắp Hy Lạp đã ban hành hướng dẫn riêng về AI tạo sinh, và chiều hướng cho thấy việc công bố hơn là cấm đoán. Các bên tài trợ và tạp chí ngày càng yêu cầu tác giả nêu rõ họ đã dùng công cụ AI ở đâu và như thế nào. Không có điều nào trong số này khiến hỗ trợ AI bị “cấm”. Điều đó tạo ra kỳ vọng rằng phải trung thực về việc dùng, một điều rất khác với việc che giấu.
Điểm cần nhớ là: một điểm số từ bộ phát hiện không phải là phán quyết. Bản thân Turnitin có thể ẩn các điểm AI thấp và cảnh báo rằng con số đó không nên là cơ sở duy nhất cho quyết định về tính liêm chính. Một số trường đại học khác đã đi xa hơn và tắt các bộ phát hiện AI của họ, đúng như sự thiên lệch được mô tả ở trên. Gắn cờ là một tuyên bố mà bạn được quyền phản biện, chứ không phải là kết luận có tội.
Ngăn chặn một bộ phát hiện thiên vị tự nói thay cho nghiên cứu của Quý vị
Dán một đoạn văn đã bị gắn cờ và xem việc làm cho tự nhiên giữ nguyên ý nghĩa, thuật ngữ và trích dẫn của Quý vị, đồng thời làm thay đổi nhịp điệu để bộ dò hiểu nhầm ít hơn.
Thử Humanizer miễn phíCác trường đại học Hy Lạp hàng đầu và nơi xuất hiện các lần kiểm tra AI
Các cơ sở dưới đây sàng lọc luận văn và bản thảo về mức độ tương đồng, đồng thời ngày càng cân nhắc các chỉ báo AI. Nếu bạn nộp bài tại bất kỳ nơi nào trong số đó, hãy kỳ vọng luận văn hoặc bản thảo của bạn sẽ đi qua một trong các hệ thống này.
- Εθνικό και Καποδιστριακό Πανεπιστήμιο Αθηνών (National and Kapodistrian University of Athens, NKUA), tại Athens
- Αριστοτέλειο Πανεπιστήμιο Θεσσαλονίκης (Aristotle University of Thessaloniki, AUTH), tại Thessaloniki
- Εθνικό Μετσόβιο Πολυτεχνείο (National Technical University of Athens, NTUA), tại Athens
- Πανεπιστήμιο Πατρών (University of Patras), tại Patras
- Πανεπιστήμιο Κρήτης (University of Crete), tại Heraklion và Rethymno
- Πανεπιστήμιο Ιωαννίνων (University of Ioannina), tại Ioannina
- Πανεπιστήμιο Θεσσαλίας (University of Thessaly), tại Volos
- Οικονομικό Πανεπιστήμιο Αθηνών (Athens University of Economics and Business, AUEB), tại Athens
- Δημοκρίτειο Πανεπιστήμιο Θράκης (Democritus University of Thrace), tại Komotini
Danh sách này không bao quát toàn bộ giáo dục đại học của Hy Lạp, nhưng nó bao phủ nơi diễn ra phần lớn việc viết nghiên cứu bằng tiếng Anh và nơi công việc sàng lọc thực tế đang diễn ra.
Cách AI humanizer cho các nhà nghiên cứu Hy Lạp hoạt động
Quy trình là trung thực và rõ ràng, đồng thời giúp bạn nằm trong các quy tắc.
Soạn thảo trước. Viết bằng tiếng Hy Lạp nếu đó là nơi bạn tư duy rõ nhất, rồi dịch; hoặc soạn thảo trực tiếp bằng tiếng Anh với bất kỳ hỗ trợ nào bạn sử dụng. Hoàn thiện lập luận và bằng chứng trước khi lo về việc câu chữ đó trông như thế nào.
Chỉnh sửa ngữ pháp tiếp theo. Sửa tình trạng lạm dụng mạo từ, ổn định thì, và kiểm tra thuật ngữ để ý nghĩa đúng hoàn toàn như bạn dự định. text humanizer của chúng tôi không phải là thay thế cho bước này, vì đầu vào sạch sẽ tạo ra đầu ra tốt hơn.
Sau đó, humanize chính phần văn bản do AI hỗ trợ mà bạn đã viết. Công cụ thay đổi nhịp điệu câu và cách chọn từ, tách bớt nhịp “đều đều” vốn tạo cảm giác perplexity thấp, và làm sạch các dấu vết nhận diện điển hình như các liên từ lặp lại và các dấu gạch ngang em dashes rơi rớt—đồng thời vẫn giữ nguyên ý nghĩa, thuật ngữ kỹ thuật và mọi trích dẫn của bạn. Văn bản không phải tiếng Anh sẽ đi qua một mô hình nhận biết ngôn ngữ, nên đoạn tiếng Hy Lạp giữ cấu trúc của nó thay vì bị “dẹt” đi.
Chúng ta có thể nói thật gì về kết quả? Trong quá trình thử nghiệm của riêng mình, việc humanize giúp giảm đáng kể mức độ mà tiếng Anh không phải người bản ngữ, chuẩn mực và cẩn thận bị các bộ phát hiện lớn như Turnitin, Originality.ai và GPTZero hiểu nhầm, trong khi vẫn giữ nguyên nội dung học thuật. Chúng tôi sẽ không đưa ra một con số cụ thể. Bộ phát hiện được huấn luyện lại vài tháng một lần, và không công cụ trung thực nào có thể hứa hẹn rằng sẽ không bị phát hiện 100%. Bất kỳ ai đảm bảo điều đó đều đang bán cho bạn một thứ gì đó.
Cuối cùng, công bố. Nêu việc sử dụng AI theo định dạng mà giảng viên hướng dẫn của bạn, đơn vị của bạn và tạp chí mục tiêu yêu cầu. Humanizing bảo vệ cách viết cẩn thận khỏi một “cờ” thiên lệch; còn việc công bố giúp bạn trung thực về sự hỗ trợ mà bạn đã dùng. Hai điều này đi cùng với nhau. Đối với hỗ trợ biên tập vượt ra ngoài humanizing, global academic editing hub của chúng tôi tập hợp các tài nguyên hỗ trợ ngôn ngữ ở một nơi.
Các cơ quan tài trợ địa phương, tạp chí và kỳ vọng về công bố AI
Nguồn tiền tài trợ nghiên cứu cạnh tranh tại Hy Lạp phần lớn đi qua HFRI, Quỹ Hellenic Foundation for Research and Innovation (ΕΛΙΔΕΚ), đơn vị tài trợ các dự án do chính nhà nghiên cứu dẫn dắt; trong khi GSRI, Tổng thư ký Nghiên cứu và Đổi mới, thiết lập chính sách nghiên cứu cấp quốc gia. Nhiều nhóm Hy Lạp cũng nắm giữ các khoản tài trợ của European Research Council (ERC). Mỗi bên lại có văn hóa báo cáo riêng, và việc công bố sử dụng AI đang dần trở thành một phần của văn hóa đó.
Ở phía xuất bản, các nhà nghiên cứu Hy Lạp hướng tới các tạp chí được lập chỉ mục trong Web of Science và Scopus, còn Trung tâm Tài liệu Quốc gia (EKT) duy trì các kho lưu trữ quốc gia và thống kê nghiên cứu. Hầu hết các tạp chí quốc tế hiện nay đều có điều khoản công bố AI trong hướng dẫn cho tác giả. Thói quen an toàn là đọc điều khoản đó trước khi nộp bài, và viết một đoạn tuyên bố ngắn mô tả các công cụ của bạn, thay vì để quy trình của bạn bị suy đoán.
Giữ trọng tâm vào lập luận. Humanizing bản nháp của chính bạn không phải là cách đi vòng qua bất kỳ điều nào trong số này. Nó bảo vệ tiếng Hy Lạp-Anh rõ ràng khỏi một thiên lệch của bộ phát hiện đã được ghi nhận, và việc công bố giúp giữ hồ sơ luôn đúng sự thật. Công việc thực sự, được đối xử công bằng.
Câu hỏi thường gặp
Q: AI humanizer có giúp ích nếu bài của tôi bị gắn cờ dù tôi tự viết không?
Có. Đây đúng là trường hợp mà công cụ này được thiết kế cho. Tiếng Anh cẩn thận nhưng không phải người bản ngữ có điểm perplexity thấp và bị hiểu nhầm là văn bản do máy tạo; humanizing thay đổi nhịp điệu và cách chọn từ, những yếu tố kích hoạt cờ, trong khi vẫn giữ nguyên ý nghĩa của bạn. Nó không thể xóa đi thực tế rằng bộ phát hiện chưa hoàn hảo, nhưng nó loại bỏ các đặc điểm cụ thể mà chúng “đánh trọng số” quá mức.
Q: Humanising AI text có thay đổi trích dẫn hoặc thuật ngữ kỹ thuật của tôi không?
Không. AI humanizer giữ nguyên trích dẫn, tài liệu tham khảo và thuật ngữ chuyên ngành, vì việc thay đổi chúng sẽ làm hỏng bài viết. Nó tác động đến nhịp điệu và cách diễn đạt, chứ không tác động đến bằng chứng hay vốn từ chuyên môn của bạn.
Q: Dùng AI humanizer cho các nhà nghiên cứu Hy Lạp có được coi là gian lận không?
Không, miễn là bạn sử dụng một cách trung thực. Bạn humanize bản nháp do AI hỗ trợ mà chính bạn đã viết, giữ nguyên ý nghĩa và trích dẫn, rồi công bố việc sử dụng AI theo cách mà đơn vị và tạp chí của bạn yêu cầu. Mục tiêu là sự công bằng cho chữ viết thật, chứ không phải ngụy trang cho việc tạo tác phẩm.
Q: Có công cụ nào đảm bảo văn bản của tôi vượt qua mọi bộ phát hiện AI không?
Không, và bạn nên không tin ai nói ngược lại. Các bộ phát hiện thay đổi mô hình thường xuyên, vì vậy không công cụ nào có thể hứa hẹn rằng sẽ không bị phát hiện 100%. Điều mà một humanizer tốt có thể làm là giảm tần suất mà văn bản tiếng Anh do không phải người bản ngữ viết một cách trung thực bị gắn cờ nhầm, đó là điều chúng tôi quan sát được trong thử nghiệm.
Q: Tôi đã soạn bằng tiếng Hy Lạp rồi dịch. Việc đó có làm tăng khả năng bị gắn cờ không?
Có thể, vì văn phong học thuật được dịch thường rất chuẩn mực và đều đặn, và chính điều đó trông giống perplexity thấp. Humanizing bản thảo sau dịch, rồi công bố quy trình của bạn, là một cách hợp lý để tránh việc chữ viết rõ ràng bị phạt vì sự rõ ràng đó.
Được thiết kế cho các học giả không phải người bản ngữ: giảm các cảnh báo AI sai trên tiếng Hy Lạp-Anh cẩn trọng, đồng thời vẫn giữ nguyên trích dẫn, thuật ngữ và lập luận.

Moe là một kỹ sư NLP với PhD trong xử lý ngôn ngữ tự nhiên. Nghiên cứu của ông bao gồm ngôn ngữ học tính toán, phân tích văn bản và học máy, đồng thời được đưa trực tiếp vào các mô hình chỉnh sửa và nhân bản hóa đằng sau ProofreaderPro. Anh ấy viết về một phần của quá trình mà hầu hết mọi người không bao giờ thấy: cách một mô hình ngôn ngữ đọc một câu, chấm điểm và quyết định những gì cần thay đổi.


