
Công cụ AI Humanizer cho các nhà nghiên cứu Argentina viết bằng tiếng Anh
AI humanizer cho các nhà nghiên cứu Argentina. Giảm các cảnh báo phát hiện AI sai lệch trên tiếng Anh chịu ảnh hưởng của tiếng Tây Ban Nha, vẫn giữ nguyên ý nghĩa và trích dẫn, đồng thời khai báo một cách trung thực.

Argentina công bố khoảng từ 18.000 đến 22.000 bài báo được lập chỉ mục Scopus mỗi năm, xếp hạng vào khoảng thứ 40 đến 45 trên thế giới và đứng thứ hai ở châu Mỹ Latinh, chỉ sau Brazil và Mexico. Phần lớn công trình này hiện nay bắt đầu với một trợ lý AI ở đâu đó trong quy trình: bản nháp đầu tiên được phác thảo bằng ChatGPT, một đoạn văn được tinh chỉnh chặt chẽ bởi Claude, và bản dịch được làm trơn từ tiếng Tây Ban Nha. Điều này là bình thường, và đa số tạp chí cho phép khi bạn khai báo.
Vấn đề bắt đầu ở giai đoạn sau đó. AI humanizer dành cho các nhà nghiên cứu Argentina tồn tại vì các bộ phát hiện AI thường đọc nhầm tiếng Anh cẩn thận của người học ngôn ngữ thứ hai như một văn bản do máy tạo, và các tác giả Argentina phải trả tiền cho những câu chữ chỉ đơn giản là sạch, chuẩn mực và đúng.
Argentina đạt 562 điểm trên EF English Proficiency Index, cao nhất ở châu Mỹ Latinh. Mức độ thành thạo cao đó không bảo vệ bạn ở đây. Nếu có thì chính thứ tiếng Anh được mài giũa, đúng chuẩn như sách giáo khoa, kết quả của nhiều năm học tập chính quy, lại là loại văn viết mà bộ phát hiện có khả năng gắn cờ nhất.
Humanizador de texto de IA cho các nhà nghiên cứu Argentina
AI humanizer của chúng tôi giúp các nhà nghiên cứu Argentina xuất bản bằng tiếng Anh một cách an toàn hơn. Viết lại chính bản nháp do AI hỗ trợ của bạn để tiếng Anh cẩn trọng của bạn không bị nhầm với văn bản tự động, đồng thời vẫn giữ nguyên ý nghĩa, thuật ngữ kỹ thuật và các trích dẫn của bạn.
Nói một cách đơn giản: bạn viết khoa học, bạn giữ nguyên ý nghĩa, và text humanizer thay đổi nhịp điệu cũng như cách chọn từ để tiếng Anh cẩn thận chịu ảnh hưởng của tiếng Tây Ban Nha trông giống như công việc của con người mà nó vốn đã là. Công cụ hỗ trợ hơn 60 ngôn ngữ; văn bản không phải tiếng Anh được xử lý qua một mô hình biết ngôn ngữ, bảo toàn cấu trúc câu.
Đây không phải là chuyện che giấu điều gì. Đây là việc mang lại một sự đọc công bằng cho phần công việc thật của bạn trước khi gửi đi, và khai báo trung thực việc bạn sử dụng AI theo đúng những gì cơ sở của bạn và tạp chí yêu cầu.
Viết bằng tiếng Tây Ban Nha? Nó được tự động phát hiện và humanized trực tiếp
Nhiều nhà nghiên cứu ở Argentina soạn bản thảo bằng tiếng Tây Ban Nha trước khi viết bằng tiếng Anh, và công cụ humanizer hỗ trợ điều đó trực tiếp. Dán văn bản tiếng Tây Ban Nha và ProofreaderPro tự nhận diện ngôn ngữ, sau đó xử lý qua một mô hình hiểu ngôn ngữ tiếng Tây Ban Nha, giữ nguyên thuật ngữ, dấu trọng âm và trích dẫn của bạn đúng như cách bạn viết. Thông qua humanizador de texto de IA, bản thảo tiếng Tây Ban Nha của bạn được humanized dễ dàng như với tiếng Anh, không cần dịch trước. Phạm vi phát hiện tương tự cũng áp dụng cho hơn sáu mươi ngôn ngữ, mỗi ngôn ngữ được viết lại bằng đúng “giọng” của nó.
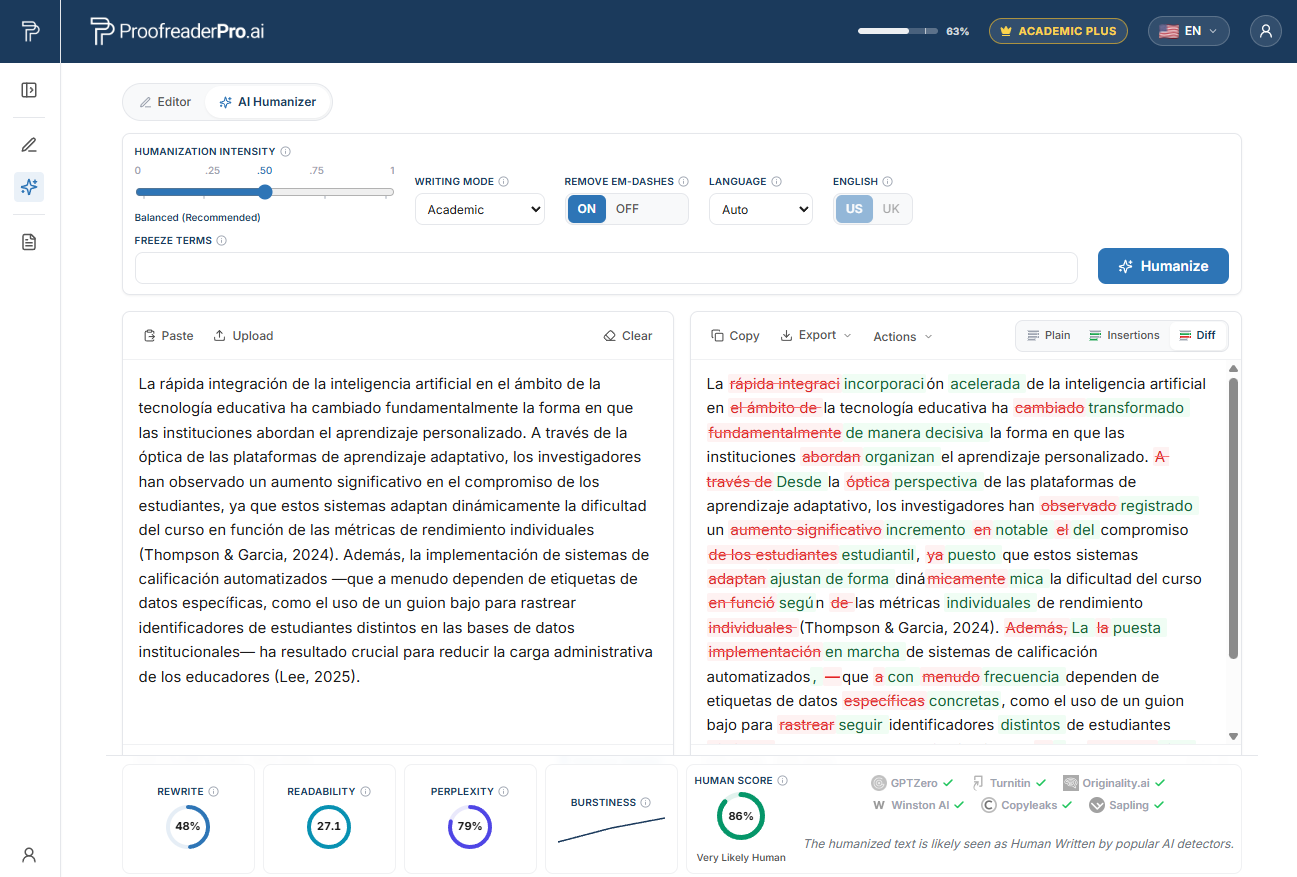
ProofreaderPro AI Humanizer viết lại văn bản học thuật tiếng Tây Ban Nha. Phần diff trước và sau giữ nguyên ý nghĩa và trích dẫn, còn các kiểm tra của bộ phát hiện xác nhận rằng bản đọc tự nhiên, giống con người.
Vì sao các nhà nghiên cứu Argentina bị gắn cờ bởi các bộ phát hiện AI
Năm 2023, một nhóm của Stanford do Liang và các cộng sự dẫn đầu đã công bố một nghiên cứu trên tạp chí Cell Press Patterns với tiêu đề "GPT detectors are biased against non-native English writers." Nhóm đã đưa các bài luận TOEFL do con người viết vào bảy bộ phát hiện đang được sử dụng rộng rãi. Trung bình, khoảng 61% các bài viết của người không phải người bản ngữ bị gắn cờ là AI, so với khoảng 5% ở các bài của người bản ngữ. Gần 1 trên 5 bài luận của người không phải người bản ngữ bị gắn cờ bởi tất cả các bộ phát hiện cùng lúc. Mọi bài luận đều do một người viết.
Cơ chế nằm ở độ “perplexity” (độ khó đoán). Nhiều bộ phát hiện chấm điểm mức độ “gây bất ngờ” của từng lựa chọn từ đối với một mô hình ngôn ngữ. Người viết là người học ngôn ngữ thứ hai thường chọn những từ phổ biến và cụm diễn đạt chuẩn mực, dễ dự đoán, từ đó tạo ra perplexity thấp, và điều này đọc như văn bản máy. Những thói quen giúp văn phong học thuật của Argentina trở nên rõ ràng và an toàn chính là những thói quen mà các công cụ này được huấn luyện để nghi ngờ.
Chúng tôi giải thích cơ chế thất bại này một cách sâu hơn trong vì sao các bộ phát hiện AI gắn cờ người viết không phải người bản ngữ. Bản tóm tắt ngắn gọn: một “cờ” từ bộ phát hiện là một phỏng đoán thống kê về các mẫu từ, chứ không phải bằng chứng về cách bạn viết bài báo.
Các mẫu tiếng Tây Ban Nha là ngôn ngữ mẹ đẻ đứng sau các cờ sai
Mức độ thông thạo của Argentina có nghĩa là các dấu hiệu không phải là những lỗi nghiêm trọng. Đó là những lựa chọn cẩn trọng, chuẩn mực mà các tác giả viết tốt thường dùng để luôn đúng, và chính tính “chuẩn mực” đó lại làm perplexity giảm xuống. Dưới đây là các mẫu đẩy tiếng Anh của Argentina về phía một “dấu ấn” giống máy.
Quy tắc mạo từ an toàn nhất, áp dụng ở mọi nơi. Tiếng Tây Ban Nha dùng mạo từ xác định với các danh từ trừu tượng tự do hơn nhiều so với tiếng Anh ("la investigacion demuestra que la desigualdad afecta la educacion"). Các tác giả Argentina học cách bỏ các mạo từ đó trong các câu phát biểu chung, rồi áp dụng quy tắc đã hiệu chỉnh một cách đồng loạt. Kết quả là các cụm danh từ “đúng theo sách”, hầu như không có biến thiên, điều mà mô hình lại đúng là mong đợi.
Thứ tự tính từ chuẩn mực. Tiếng Tây Ban Nha đặt tính từ sau danh từ; tiếng Anh lại xếp chúng trước. Những người viết đã “luyện” theo quy ước tiếng Anh sẽ diễn đạt "un analisis estadistico multivariado robusto" thành "a robust multivariate statistical analysis" và theo đúng thứ tự đó mỗi lần. Tính đúng đắn cứng nhắc vốn dĩ ít “gây bất ngờ”.
Từ đồng nghĩa “an toàn” nhất cho mọi false friend (bạn giả). Để né falsos amigos ("actual," "realizar," "eventualmente," "sensible," "pretender"), các tác giả cẩn trọng chọn từ tiếng Anh phổ biến và không mơ hồ nhất. Việc lặp đi lặp lại cách chọn đồng nghĩa có xác suất cao nhất sẽ làm phẳng sự đa dạng từ vựng mà một bộ phát hiện đọc như “đầu bút con người”.
Một giới từ đúng theo từ điển cho mỗi lần sử dụng. Sau khi học rằng chuyển dịch từ tiếng Tây Ban Nha tạo ra "consist in," "depend of," "interested on," và "different to," các nhà văn sẽ “chốt” lại "consist of," "depend on," "interested in," và "different from." Luôn là cụm kết hợp (collocation) chuẩn một cách điển hình, không bao giờ là cách kết hợp gây bất ngờ.
Chọn thì một cách cơ học. Tiếng Tây Ban Nha Rioplatense nghiêng về quá khứ đơn, vì vậy các tác giả Argentina sẽ áp dụng các quy tắc hiện tại hoàn thành và quá khứ đơn một cách có chủ ý trong các phần phương pháp và kết quả. Việc dùng thì theo quy tắc, có kiểm soát sẽ nhất quán và dễ dự đoán, đọc như perplexity thấp.
Tính trang trọng tối đa. Văn phong học thuật của Argentina thường hướng về sự trang trọng, nên các tác giả sẽ chọn cụm diễn đạt chuẩn nhất và thận trọng nhất trong các lựa chọn có sẵn. Câu an toàn nhất cũng là câu dễ được mong đợi nhất, và văn phong “được mong đợi” chính là thứ mà các bộ phát hiện cho điểm là văn bản do máy tạo.
Bối cảnh phát hiện AI tại Argentina và Turnitin
Luận văn, báo cáo về sự nghiệp và bài nộp tạp chí tại Argentina thường được sàng lọc bằng Turnitin hoặc iThenticate nhằm cả hai yếu tố: mức độ tương đồng và các chỉ báo AI. Các ủy ban đánh giá của CONICET, quy trình lên biên chế/tenure tại đại học, và tạp chí quốc tế đều nằm đâu đó trong “đường ống” đó, vì vậy một nghiên cứu sinh và một nhà nghiên cứu cấp cao có thể gặp cùng một bộ phát hiện.
Hiểu cách các nhà cung cấp nói về công cụ của họ cũng hữu ích. Turnitin điều chỉnh (suppress) điểm AI trong dải 1 đến 19%, hiển thị một dấu sao thay vì một con số, và cảnh báo rằng điểm số của họ không nên được dùng đơn độc cho các quyết định về tính liêm chính. Một số trường đại học còn làm mạnh tay hơn: Vanderbilt đã tắt bộ phát hiện AI của Turnitin vào năm 2023 vì lo ngại dương tính giả và thiên vị đối với người viết không phải người bản ngữ; đồng thời Michigan State, UT Austin, Northwestern, Pittsburgh, SMU và Waterloo cũng thực hiện các bước tương tự.
Cách đọc “công bằng” về lịch sử này không phải là các bộ phát hiện vô nghĩa, mà là một điểm số là một tuyên bố để có thể phản biện, chứ không phải là kết luận cuối cùng. Đồng thời, các nhà tài trợ và tạp chí ngày càng yêu cầu bạn khai báo hỗ trợ từ AI. Hai sự thật đó cùng dẫn đến một hướng: bảo vệ phần viết cẩn trọng khỏi bị đọc nhầm, và minh bạch về các công cụ bạn đã dùng.
Cho bản tiếng Anh của quý vị được chấm đọc công bằng
Làm cho bản thảo do AI hỗ trợ của quý vị trở nên tự nhiên, để phần viết chịu ảnh hưởng tiếng Tây Ban Nha được cẩn trọng không bị hiểu nhầm là văn bản do máy tạo. Giữ nguyên ý nghĩa, thuật ngữ và trích dẫn. Sau đó công bố một cách tự tin.
Thử Humanizer miễn phíCác trường đại học hàng đầu của Argentina và nơi xuất hiện các kiểm tra AI
Hệ thống đại học công của Argentina lớn và miễn phí ở bậc đại học, với nghiên cứu tập trung ở các trường đại học quốc gia và các viện CONICET thường đặt chung khuôn viên. Đây là những đơn vị sản xuất nghiên cứu hàng đầu của đất nước, và mỗi đơn vị đều sàng lọc luận văn cũng như bản thảo để tìm các chỉ báo về mức độ tương đồng và AI.
- Universidad de Buenos Aires (UBA), Buenos Aires, là đơn vị sản xuất lớn nhất, chiếm khoảng 40% tổng đầu ra quốc gia.
- Universidad Nacional de Cordoba (UNC), Cordoba, được thành lập năm 1613 và là một trong những trường lâu đời nhất ở châu Mỹ, mạnh về thiên văn học, vật lý và hóa học.
- Universidad Nacional de La Plata (UNLP), La Plata, là một trung tâm lớn trong các ngành khoa học chính xác và khoa học tự nhiên, với nhiều đơn vị nghiên cứu CONICET.
- Universidad Nacional de Rosario (UNR), Rosario, nổi bật về y học, hóa sinh và khoa học nông nghiệp.
- Universidad Nacional del Litoral (UNL), Santa Fe, mạnh về kỹ thuật hóa học, công nghệ thực phẩm và công nghệ sinh học.
- Universidad Nacional de Cuyo (UNCuyo), Mendoza, trường đại học nghiên cứu chính của miền tây Argentina.
- Universidad Tecnologica Nacional (UTN), đa cơ sở, là trường có quy mô sinh viên lớn nhất của cả nước, tập trung vào kỹ thuật và công nghệ.
- Universidad Austral, khu vực Buenos Aires, là một trường tư hàng đầu mạnh về y học và kỹ thuật y sinh.
- Universidad Nacional del Sur (UNS), Bahia Blanca, mạnh về hóa học, kỹ thuật hóa học và khoa học địa chất.
- Universidad Nacional de San Martin (UNSAM), tỉnh Buenos Aires, phát triển nhanh trong công nghệ sinh học và công nghệ nano.
- Instituto Balseiro, Bariloche, là viện vật lý và kỹ thuật hạt nhân hàng đầu của Argentina; quy mô nhỏ nhưng tạo ra năng suất đặc biệt cao.
- Instituto Tecnologico de Buenos Aires (ITBA), Buenos Aires, một tổ chức kỹ thuật tư thục mạnh về khoa học máy tính và khoa học dữ liệu.
Tại mỗi cơ sở trong số này, việc thăng tiến nghề nghiệp của CONICET và cạnh tranh tài trợ của ANPCyT khiến việc xuất bản bằng tiếng Anh trở thành một nhu cầu nghề nghiệp, nghĩa là nhiều bản thảo sẽ đi qua nhiều bộ phát hiện hơn mỗi năm.
Cách AI humanizer cho các nhà nghiên cứu Argentina hoạt động
AI humanizer cho các nhà nghiên cứu Argentina là bước cuối cùng trong một quy trình, không phải lối tắt tránh một chặng nào đó. Đây là trình tự mà chúng tôi khuyến nghị.
Đầu tiên, hãy phác thảo. Nhiều nhà nghiên cứu Argentina suy nghĩ tự nhiên hơn bằng tiếng Tây Ban Nha, vì vậy hãy phác lập lập luận của bạn bằng tiếng Tây Ban Nha, sau đó dịch sang tiếng Anh (bộ AI translator của chúng tôi giữ nguyên các trích dẫn). Thứ hai, hãy rà soát ngữ pháp, để các mẫu về bài viết, giới từ và các false-friend ở trên thực sự đúng. Thứ ba, hãy chạy phần văn do AI hỗ trợ của chính bạn qua text humanizer để văn viết cẩn trọng, perplexity thấp ít có khả năng bị đọc nhầm thành đầu ra của máy.
Humanizer giữ nguyên ý nghĩa, thuật ngữ kỹ thuật và các trích dẫn của bạn. Nó thay đổi nhịp điệu và cách chọn từ, làm gián đoạn nhịp điệu lặp lại, và loại bỏ những dấu gạch dài—em dash—rơi rớt mà các bản nháp do AI thường để lại.
Trong quá trình thử nghiệm, chúng tôi cụ thể thay vì hứa hẹn. Được kiểm thử với các bộ phát hiện lớn, humanizer của chúng tôi viết lại văn bản do AI thành một dạng con người tự nhiên hơn, từ đó giảm tín hiệu AI và cải thiện cơ hội đối đầu với các bộ phát hiện khó, đồng thời vẫn giữ độ chính xác về ngữ pháp cao đối với văn bản học thuật. Đây là kết quả từ thử nghiệm, không phải cam kết; các bộ phát hiện cũng được huấn luyện lại mỗi vài tháng, vì vậy không có công cụ nào đáng tin có thể hứa rằng bạn sẽ không bị phát hiện.
Sau đó, hãy khai báo. Trình bày việc bạn sử dụng AI theo đúng định dạng mà cơ sở của bạn và tạp chí mục tiêu yêu cầu. Tổ hợp đó, viết cẩn trọng được bảo vệ khỏi các cờ sai kèm với khai báo đầy đủ, là thứ giúp bạn nằm trong các quy định về tính liêm chính. Nếu bạn muốn so sánh với việc sửa bài do con người thực hiện, hãy xem biên tập học thuật cho các nhà nghiên cứu Argentina; còn để xem toàn bộ cụm quốc gia, hãy truy cập multilingual AI humanizer hub.
Các tổ chức tài trợ địa phương, các tạp chí và kỳ vọng về khai báo AI
Hai tổ chức tạo ra áp lực công bố khiến các nhà nghiên cứu Argentina bị đưa vào các bộ phát hiện ngay từ đầu. CONICET (Consejo Nacional de Investigaciones Cientificas y Tecnicas) sử dụng hơn 11.000 nhà nghiên cứu trong một hệ thống nghề nghiệp 5 tầng, và việc thăng tiến phụ thuộc vào việc công bố bền vững trên các tạp chí được lập chỉ mục Scopus và Web of Science. ANPCyT (Agencia Nacional de Promocion de la Investigacion, el Desarrollo Tecnologico y la Innovacion) quản lý các khoản tài trợ cạnh tranh, đáng chú ý nhất là chương trình PICT (Proyectos de Investigacion Cientifica y Tecnologica), trong mọi đánh giá đều coi trọng mạnh mẽ công bố quốc tế.
Argentina cũng có truyền thống tạp chí vững, nhiều tạp chí trong số đó được lập chỉ mục SciELO Argentina và ngày càng nhiều tạp chí được lập chỉ mục Scopus và Web of Science. Các đầu đề mà tác giả Argentina thường biết đến bao gồm:
- Medicina (Buenos Aires), một trong các tạp chí y khoa được tôn trọng nhất ở châu Mỹ Latinh, được lập chỉ mục trên PubMed và Scopus.
- Ecologia Austral, thuộc Hiệp hội Sinh thái Argentina.
- Latin American Applied Research, do Universidad Nacional del Sur và CONICET xuất bản.
- Revista de la Union Matematica Argentina, một trong những tạp chí toán học lâu đời nhất trong khu vực.
- Ameghiniana, về cổ sinh vật học và khoa học địa chất.
- Electronic Journal of Biotechnology, với định hướng tập trung vào châu Mỹ Latinh.
Khi các tạp chí này tìm kiếm hoặc duy trì việc được lập chỉ mục Scopus, họ ngày càng ưu tiên tiếng Anh và, giống như các đối tác quốc tế, ngày càng yêu cầu có một tuyên bố về hỗ trợ từ AI. Hãy viết phần khai báo một cách rõ ràng, nêu tên các công cụ và mô tả chúng đã làm gì. Nếu một bộ phát hiện từng gắn cờ vào một công trình thật dù bạn đã cẩn trọng, thì bộ hướng dẫn appeal a false AI-detection flag sẽ giúp bạn thu thập bằng chứng như thế nào và nên trao đổi với ủy ban theo giọng điệu ra sao.
Câu hỏi thường gặp
Q: Công cụ AI humanizer cho các nhà nghiên cứu Argentina có giúp tôi gian lận Turnitin không?
Không. Công cụ này dành cho chính bản nháp do AI hỗ trợ của bạn, và nhiệm vụ của nó là ngăn tiếng Anh cẩn trọng của người học ngôn ngữ thứ hai bị đọc nhầm thành văn bản do máy tạo. Bạn vẫn giữ nguyên ý nghĩa và các trích dẫn của mình, đồng thời bạn vẫn phải khai báo việc sử dụng AI với cơ sở của bạn và tạp chí. Bảo vệ một công trình thật khỏi “cờ sai” không giống với việc che giấu nó.
Q: Việc humanize có thay đổi ý nghĩa, thuật ngữ kỹ thuật hay trích dẫn của tôi không?
Không. Humanizer giữ nguyên ý nghĩa, thuật ngữ kỹ thuật và các tài liệu tham khảo của bạn, đồng thời thay đổi nhịp điệu và cách chọn từ. Nó được thiết kế để làm mượt các mẫu thống kê làm cho bộ phát hiện bị “vấp”, chứ không phải để viết lại khoa học của bạn hay chuyển các trích dẫn của bạn.
Q: Thực tế thì nó vượt qua các bộ phát hiện AI tốt đến mức nào?
Đã được kiểm thử với các bộ phát hiện lớn, công cụ này viết lại văn bản do AI thành một dạng con người tự nhiên hơn, từ đó giảm tín hiệu AI và tăng cơ hội trước các bộ phát hiện khó, đồng thời vẫn giữ độ chính xác ngữ pháp cao. Đây là kết quả thử nghiệm, không phải cam kết. Các bộ phát hiện được huấn luyện lại thường xuyên, vì vậy không có công cụ nghiêm túc nào có thể cam kết rằng bạn sẽ không bao giờ bị gắn cờ.
Q: Tiếng Anh của tôi đã vững rồi. Vì sao bộ phát hiện lại gắn cờ tôi?
Tiếng Anh vững, chuẩn mực lại là một phần của vấn đề. Các bộ phát hiện chấm điểm perplexity, và những câu chữ cẩn trọng, dễ dự đoán, đúng chuẩn như sách giáo khoa đọc như perplexity thấp, điều này khiến chúng liên hệ với văn bản do máy tạo. Mức độ thành thạo cao của Argentina có thể làm văn bạn đồng đều hơn, chứ không phải khiến bạn ít có khả năng bị gắn cờ hơn.
Q: Tôi có cần vẫn khai báo việc sử dụng AI nếu tôi humanize bản thảo của mình không?
Có, luôn luôn. Khai báo và humanize giải quyết hai vấn đề khác nhau. Humanizing bảo vệ bài viết cẩn trọng khỏi bị đọc nhầm, và khai báo giúp bạn chịu trách nhiệm trước nhà tài trợ, ủy ban và tạp chí. Hãy làm cả hai, lần nào cũng vậy.
Dành cho các nhà nghiên cứu Argentina xuất bản bằng tiếng Anh, giảm các cờ AI sai trên chính công trình do AI hỗ trợ của quý vị trong khi vẫn giữ nguyên ý nghĩa, thuật ngữ và trích dẫn, sau đó công bố một cách tự tin.

Moe là một kỹ sư NLP với PhD trong xử lý ngôn ngữ tự nhiên. Nghiên cứu của ông bao gồm ngôn ngữ học tính toán, phân tích văn bản và học máy, đồng thời được đưa trực tiếp vào các mô hình chỉnh sửa và nhân bản hóa đằng sau ProofreaderPro. Anh ấy viết về một phần của quá trình mà hầu hết mọi người không bao giờ thấy: cách một mô hình ngôn ngữ đọc một câu, chấm điểm và quyết định những gì cần thay đổi.


